Nếu bạn đã từng dùng Cursor để viết code và quan sát nó tìm kiếm codebase, chỉnh sửa nhiều file, và chạy lại các bài kiểm tra cho đến khi đạt, thì bạn đã sử dụng một AI Agent. Điều tương đúng nếu bạn đã dùng Deep Research để nghiên cứu một chủ đề thông qua việc tìm kiếm và đọc lặp đi lặp lại, hoặc để Manus điều khiển trình duyệt để hoàn thành các tác vụ trực tuyến, hoặc nhờ trợ lý điện thoại Doubao đặt vé hay gửi tin nhắn, hoặc gửi Pine AI để thương lượng giảm hóa đơn viễn thông.
Các sản phẩm này có nhiều hình thức khác nhau, nhưng chúng có một đặc điểm chung: chúng không còn là các cuộc trò chuyện thụ động "bạn hỏi, nó trả lời". Chúng tự lập kế hoạch các bước thực thi, gọi các công cụ mà mỗi tác vụ yêu cầu, và điều chỉnh chiến lược khi kết quả trả về. AI Agent đang trở thành một cách mới để tương tác với máy tính.
Chương này bắt đầu từ các ví dụ thực tế và quay ngược lại các thành phần cốt lõi của một AI Agent: người đọc sẽ trực tiếp trải nghiệm những gì các Agent hiện đại có thể làm, hiểu kiến trúc đằng sau chúng, và học các mẫu thiết kế cũng như phương pháp hay nhất để xây dựng hệ thống Agent.
Mẹo đọc: Chương này là bản đồ khái niệm cho toàn bộ sách: một chuyến tham quan ngắn gọn về công thức cốt lõi, vòng lặp vận hành, khung kỹ thuật và các mẫu thiết kế Agent. Nó thiết lập từ vựng chung và các điểm tham chiếu được sử dụng xuyên suốt các chương sau. Đừng cố ghi nhớ mọi khái niệm trong lần đọc đầu tiên; hãy hướng tới bức tranh toàn cảnh. Mỗi chương sau mở rộng một khía cạnh được giới thiệu ở đây, và bạn có thể quay lại chương này bất cứ khi nào cần định hướng lại.
Agent hiện đại = LLM + Context + Tools
Bản chất của một hệ thống Agent hiện đại nằm gọn trong một công thức ngắn gọn: Agent = LLM (Large Language Model) + Context + Tools. Công thức đơn giản và thực tiễn—miễn là mỗi thuật ngữ được hiểu theo nghĩa rộng:
LLM là bộ máy suy luận của Agent: Nó không chỉ là một tập hợp các tham số mô hình; nó là cốt lõi ra quyết định của Agent, chịu trách nhiệm hiểu ý định, suy luận, lập kế hoạch và đánh giá. Khả năng của một LLM đến từ kiến thức thế giới và năng lực ngôn ngữ có được trong giai đoạn pre-training, cùng với các chiến lược ra quyết định được mã hóa thông qua post-training (các kỹ thuật như supervised fine-tuning và reinforcement learning sẽ được trình bày trong Chương 7).
Context là bộ thông tin làm việc của Agent: Không chỉ là văn bản được đưa vào mô hình, mà là tập thông tin làm việc sẵn có cho Agent tại mỗi điểm ra quyết định—môi trường, bộ nhớ người dùng, kiến thức chuyên môn, trạng thái của chính nó và tiến trình tác vụ. Giống như một người ra quyết định cần đánh giá tình hình, nhớ lại kinh nghiệm liên quan và tham khảo tài liệu, cửa sổ context của Agent chứa thông tin nó có thể sử dụng tại thời điểm đó.
Tools là các giao diện hành động của Agent: Không phải là một vài hàm API có thể gọi được, mà là toàn bộ các cách Agent có thể hành động—từ các lệnh gọi công cụ được định trước đến các Skills được tải theo yêu cầu, từ tạo code để tạo khả năng mới tức thời đến giao phó công việc cho các sub-agent, từ liên lạc với người dùng đến phản hồi các sự kiện bên ngoài.
Diễn đạt trực quan hơn: Agent = Reasoning Engine + Working Context + Action Interfaces. Mô hình suy luận và quyết định, context cung cấp bộ thông tin làm việc mà các quyết định đó phụ thuộc vào, và tools cung cấp các giao diện thông qua đó các quyết định tác động đến thế giới bên ngoài.
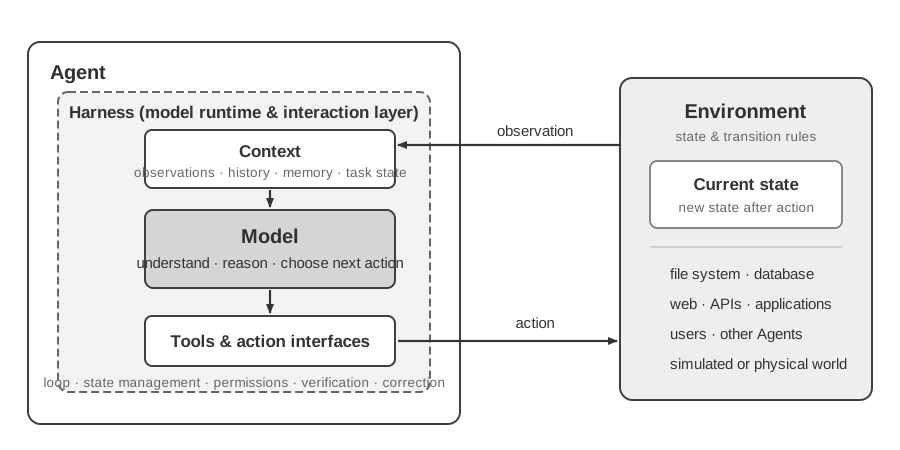
Từ góc nhìn kinh điển của reinforcement learning và lý thuyết điều khiển, Agent và Environment là hai mặt của một tương tác vòng kín, không phải là các thành phần của nhau. Environment trả về một observation, Agent sử dụng context của nó để chọn hành động tiếp theo, và hành động đó thay đổi trạng thái của Environment, tạo ra observation tiếp theo.
Hình 1-1: Vòng lặp tương tác Agent–Environment và cấu trúc Model–Harness bên trong Agent
Hình 1-1 cho thấy hai mức độ trừu tượng. Mức bên ngoài là tương tác giữa Agent và Environment: Environment bao gồm hệ thống file, cơ sở dữ liệu, trang web, người dùng, các Agent khác, và thế giới vật lý hoặc mô phỏng. Mức bên trong là cấu trúc Model–Harness bên trong Agent: Model đưa ra các quyết định chính sách; Harness là lớp thời gian chạy và quản trị bên trong ranh giới Agent, xây dựng context, cung cấp giao diện tool, duy trì vòng lặp và trạng thái, và áp dụng quyền, xác minh và sửa chữa. Một Harness có thể tạo, cách ly hoặc ủy quyền một môi trường mà không chứa trạng thái hoặc quy tắc chuyển đổi của Environment.
Công thức kỹ thuật do đó có thể được mở rộng như sau: LLM là Model, trong khi Context + Tools tạo thành Harness tối thiểu; các hệ thống sản phẩm thêm các ràng buộc, xác minh và sửa chữa bên trong ranh giới đó. Phần còn lại của chương này theo ranh giới này.
Ba thành phần này tương ứng chính xác với ba khái niệm cốt lõi trong RL (reinforcement learning; xem Chương 7), nhưng chúng không phải là các tương đương một-một nghiêm ngặt: context là biểu diễn nội bộ của Agent về observations và lịch sử, trong khi tools định nghĩa các giao diện observation/action mà các đối tượng cơ bản vẫn nằm trong Environment.
Trực giác
Thành phần Agent
Khái niệm RL
Vai trò
Reasoning Engine
LLM
Policy
Logic ra quyết định xác định "làm gì tiếp theo"—dựa trên thông tin hiện tại, chọn hành động phù hợp nhất từ tất cả các lựa chọn có sẵn
Working Context
Context construction
Observations and history
Tổ chức các observations từ Environment và lịch sử hiện có thành thông tin cần thiết cho quyết định hiện tại
Action Interfaces
Tool interfaces
Observation/action interfaces
Xác định Agent có thể đọc những observations nào, có thể phát hành những hành động nào, và định dạng của các giao diện đó
Observation và Action Spaces: Giao diện giữa Model và Thế giới
Observation space và action space cùng nhau tạo thành giao diện giữa LLM và môi trường bên ngoài của nó. Observation space chuyển đổi thông tin trong môi trường thành context mà mô hình có thể xử lý; action space chuyển đổi các quyết định của mô hình thành các thao tác trên thế giới bên ngoài. Thông tin nằm ngoài observation space thực tế không tồn tại đối với mô hình. Một thao tác nằm ngoài action space vẫn là điều mà mô hình chỉ có thể đề xuất bằng lời, ngay cả khi nó biết chính xác điều gì nên được thực hiện.
Do đó, khi mô hình cơ bản được giữ nguyên, đòn bẩy kỹ thuật hệ thống chính để cải thiện hiệu suất Agent thường là định nghĩa lại hoặc mở rộng observation và action spaces của nó. Theo thuật ngữ của cuốn sách này, điều đó có nghĩa là mở rộng context và tools. Nhiều vấn đề dường như yêu cầu "mô hình thông minh hơn" thực ra là các vấn đề về giao diện: đưa dữ liệu liên quan đến tác vụ vào context hoặc expose thao tác cần thiết dưới dạng tool, và một tác vụ trước đó không thể giải quyết có thể trở nên có thể giải quyết được.
Manus: hợp nhất các không gian từng bị tách biệt. Trước khi Manus xuất hiện, các Agent sản phẩm chủ yếu theo ba hướng riêng biệt: Deep Research, Coding, và Computer Use. Manus là Agent sản phẩm có ảnh hưởng rộng rãi đầu tiên kết hợp cả ba trong một hệ thống. Trình duyệt ảo của nó mở rộng observation space, trong khi hệ thống file, thực thi code và thực thi lệnh mở rộng action space. Manus không trở thành Agent chung chỉ bằng cách thay thế một mô hình mạnh hơn. Nó đã lấy hợp của observation và action spaces của ba loại Agent, cho phép một Agent vượt qua ranh giới sản phẩm trước đó.
OpenClaw: mở rộng giao diện vào cuộc sống số của người dùng. OpenClaw đẩy cả hai không gian ra xa hơn nữa. Nó nhận các tác vụ và trả kết quả thông qua các kênh nhắn tin mà người dùng đã sử dụng—WhatsApp, Telegram, Slack, Discord, iMessage, và nhiều kênh khác—vì vậy Agent có thể được tiếp cận từ hầu như bất cứ đâu. Gateway cục bộ của nó kết nối các ứng dụng đám mây như Google Drive và Notion cũng như hệ thống file cục bộ. Các file phân tán trên nhiều tài khoản và thiết bị, với sự cho phép rõ ràng của người dùng, có thể đi vào observation space của một Agent và được các tools của nó tác động. So với hình thức ban đầu lấy trung tâm là cloud sandbox của Manus, nơi các file thường phải được tải lên hoặc một connector được cấu hình riêng, OpenClaw ưu tiên cục bộ trải rộng ranh giới dữ liệu rộng hơn. Sau đó Manus đã thêm Google Drive Connector riêng và khả năng truy cập desktop vào file cục bộ, điều này chỉ củng cố luận điểm: tiến hóa sản phẩm thường bao gồm chính xác việc mở rộng observation và action spaces[^ch1-agent-products].
Hiểu mỗi thành phần làm gì, và chúng kết hợp với nhau như thế nào, là nền tảng để xây dựng các hệ thống Agent hiệu quả. Chúng ta sẽ bắt đầu với phần cụ thể nhất trong ba phần—tools, các giao diện hành động—và đi sâu vào trong đến LLM và context. Trước tiên, đây là cách các loại Agent khác nhau so sánh trên ba chiều này:
Hiểu ý định + điều khiển App: hiểu nhu cầu người dùng → định vị ứng dụng mục tiêu → thực hiện hành động → xác nhận hoàn thành
Personal Task Agents (ví dụ: Pine AI)
Thông tin tài khoản người dùng, hóa đơn lịch sử, cơ sở kiến thức nhà cung cấp dịch vụ
Mở (suy luận nội bộ, gọi điện, gửi email, điền biểu mẫu, xác nhận với người dùng)
Thực thi tác vụ đa bước: thu thập thông tin → xây dựng chiến lược thương lượng → liên hệ nhà cung cấp → thương lượng → báo cáo kết quả
Các hệ thống này chia sẻ ba đặc điểm: một action space mở—không chọn từ một tập hợp cố định các nút mà tạo ngôn ngữ tự nhiên và code tùy ý; suy luận nội bộ—lập kế hoạch trước khi hành động; và tương tác liên tục—điều chỉnh chiến lược dựa trên phản hồi môi trường. Các khả năng này đến chính từ sự tương tác giữa reasoning engine, working context, và action interfaces—tức là LLM, context, và tools.
Tools: Các giao diện hành động của Agent
Tools là cầu nối của Agent với thế giới bên ngoài. Chúng biến Agent từ một người quan sát thụ động thành một hệ thống chủ động có thể tìm kiếm, ghi file, chạy code, gọi API, gửi tin nhắn, hoặc vận hành giao diện. Nếu không có tools, Agent bị giới hạn ở việc tạo văn bản; với chúng, nó có thể tác động đến các hệ thống bên ngoài.
Để thảo luận một cách có hệ thống về tools, chúng ta có thể phân loại chúng thành năm loại theo hướng tương tác của Agent với thế giới. Ở giai đoạn này, một cái nhìn tổng quan ngắn gọn về các kịch bản tiêu biểu của mỗi loại là đủ để thiết lập bức tranh toàn cảnh; các chương sau sẽ trình bày chi tiết từng loại.
Perception Tools cho phép Agent truy cập thông tin: công cụ tìm kiếm cung cấp dữ liệu web thời gian thực, hệ thống file đọc tài liệu cục bộ, và API cùng cơ sở dữ liệu kết nối với các dịch vụ bên ngoài và dữ liệu cốt lõi của doanh nghiệp.
Execution Tools cho phép Agent tác động đến các hệ thống bên ngoài: thực thi code, thao tác file, lệnh hệ thống và gọi API bên ngoài biến các quyết định thành hành động cụ thể.
Collaboration Tools cho phép Agent phân chia công việc với các Agent khác: giao phó các tác vụ chuyên biệt cho sub-agent, yêu cầu xác nhận của con người tại các điểm ra quyết định quan trọng, hoặc điều phối hành động trong hệ thống đa agent.
Event Trigger Tools được gọi theo cách hoàn toàn khác với ba loại đầu tiên: Agent không gọi chúng; chúng đến dưới dạng đầu vào bên ngoài kích hoạt Agent bắt đầu công việc. Một email mới đến, một thời gian đã định đến, hoặc một hệ thống khác gọi Webhook callback; sự kiện kích hoạt Agent và khởi động suy luận và hành động. Agent không bao giờ tự gọi những công cụ này, nhưng chúng vẫn là một kênh thông qua đó nó tương tác với thế giới bên ngoài, vì vậy chúng ta tính chúng vào hệ thống tool rộng rãi.
User Communication Tools là các kênh thông qua đó Agent giao tiếp với người dùng. Trong khi execution tools thay đổi thế giới bên ngoài, communication tools mang thông tin—truyền tải tiến trình của Agent, hoặc một lần kiểm tra chủ động, bằng tin nhắn văn bản, cuộc gọi thoại, email, và nhiều hình thức khác.
Chương 4 trình bày đầy đủ phân loại và nguyên tắc thiết kế cho năm loại này. Chất lượng của thiết kế tool trực tiếp xác định những gì Agent có thể hoàn thành một cách đáng tin cậy: định nghĩa giao diện mơ hồ và mô hình sẽ sử dụng sai; xử lý lỗi kém và một tool bị lỗi đơn lẻ có thể khiến Agent bị mắc kẹt; phạm vi quyền quá rộng và một lỗi Agent có thể trở nên không thể khắc phục. Khi tiêu chuẩn MCP (Model Context Protocol) lan rộng, việc tích hợp tools đang trở nên dễ dàng hơn.
Tool Calling (còn được gọi là Function Calling) là khả năng cốt lõi của các LLM Agent hiện đại: nó cho phép mô hình gọi các công cụ bên ngoài theo cách có cấu trúc, biến LLM từ một trình tạo văn bản thuần túy thành một hệ thống thông minh có thể hành động thông qua các giao diện bên ngoài. Cuốn sách này sử dụng thuật ngữ "tool calling" xuyên suốt.
Tool calling diễn ra trong bốn bước: đầu tiên, context cho mô hình biết những công cụ nào có sẵn (tên, mục đích, tham số); sau đó mô hình tự quyết định có gọi tool hay không, gọi tool nào, và với đối số gì; tiếp theo, khi tool đã chạy, kết quả của nó được thêm vào context; cuối cùng, mô hình quyết định bước tiếp theo dựa trên kết quả đó. Vòng lặp này là nền tảng của ReAct, được giới thiệu sau trong chương.
Đối với một truy vấn thời tiết, biểu diễn đơn giản hóa của quy trình bốn bước ở cấp độ API như sau:
Bước 1: Khai báo tools                    Bước 2: Model quyết định gọi
tools: [{                               assistant: {
  name: "get_weather",                    tool_calls: [{
  parameters: {                             function: "get_weather",
    city: "string"                          arguments: {city: "Beijing"}
  }                                        }]
}]                                      }

Bước 3: Kết quả thêm vào context        Bước 4: Model trả lời dựa trên kết quả
tool: {                                 assistant: {
  tool_call_id: "call_1",                 content: "Hôm nay ở Beijing: 28°C, nắng."
  content: '{"temp":28,"sky":"clear"}'   }
}                                       }
Nhà phát triển chỉ định nghĩa các tools và thực thi các lệnh gọi; chính mô hình quyết định có gọi hay không, gọi tool nào, và đối số gì. Chương 2 sẽ kiểm tra chi tiết cấu trúc API này.
Khi thiết kế tools cho Agent, hãy bắt đầu với khả năng hẹp nhất mà tác vụ yêu cầu, sau đó mở rộng dần khi tác vụ trở nên phức tạp hơn. Nếu tác vụ chỉ yêu cầu phép tính cơ bản, một máy tính với các tham số được định nghĩa rõ ràng là đủ; khi nó phát triển đến đọc bảng tính, xử lý giá trị thiếu, tính toán thống kê và vẽ biểu đồ, một trình giải thích Python bị giới hạn dễ kết hợp và khám phá hơn một bộ sưu tập ngày càng lớn các công cụ chuyên biệt. Nhưng tính tổng quát cũng làm tăng nguy cơ lỗi và mở rộng bề mặt tấn công: code phải chạy trong một sandbox cách ly, với quyền truy cập mạng bị tắt theo mặc định, không có quyền truy cập vào các file ngoài thư mục làm việc được ủy quyền, và giới hạn thời gian thực thi, CPU, bộ nhớ và kích thước đầu ra.
Tương tự, một công cụ ghi log đơn lẻ phù hợp để ghi lại một lần thực thi; đối với các tác vụ chạy lâu kéo dài hàng giờ hoặc thậm chí hàng ngày, một thư mục làm việc ảo được kiểm soát có thể lưu giữ kế hoạch, kết quả trung gian, nhật ký thực thi và các sản phẩm cuối cùng để Agent có thể tiếp tục qua nhiều lần chạy. Thư mục này cũng nên giới hạn các đường dẫn có thể đọc và ghi, dung lượng lưu trữ và loại file, và ngăn chặn đường dẫn traversal thay vì expose toàn bộ hệ thống file máy chủ cho Agent.
Các công cụ đa năng không phải lúc nào cũng tốt hơn các công cụ chuyên biệt. Các thao tác có nguy cơ cao hoặc chịu ràng buộc kinh doanh nghiêm ngặt—chẳng hạn như thanh toán, xóa dữ liệu, gửi email và triển khai sản phẩm—vẫn nên được expose dưới dạng các công cụ chuyên dụng với tham số rõ ràng, quyền bị giới hạn và khả năng kiểm tra đầu cuối, với bản xem trước và xác nhận của con người được thêm vào khi cần. Nguyên tắc cốt lõi của thiết kế tool do đó là: sử dụng các khả năng nền tảng đa năng để kết hợp và khám phá; sử dụng các công cụ chuyên biệt để ràng buộc các thao tác có nguy cơ cao và thực thi các quy tắc kinh doanh nghiêm ngặt.
LLM: Reasoning Engine của Agent
Large Language Model (LLM) là cốt lõi ra quyết định của Agent. Khi nhận được yêu cầu từ người dùng, trước tiên nó phải suy luận ý định thực sự (những gì người dùng nói thường không phải là những gì họ thực sự muốn), sau đó chia một tác vụ mơ hồ hoặc phức tạp thành các bước có thể thực thi. Trong suốt quá trình thực thi, nó liên tục ra quyết định: làm gì tiếp theo, có gọi tool hay không, gọi tool nào, và với đối số gì. Khả năng hiểu–lập kế hoạch–thực thi này đến từ kiến thức tích lũy trong quá trình pre-training, và nó là nền tảng mà cả workflow và autonomous Agent đều phụ thuộc vào.
Một khả năng đặc biệt của LLM Agent là suy luận nội bộ—trước khi hành động, Agent có thể lập kế hoạch và suy luận về tác vụ. Điều này không thay đổi môi trường bên ngoài, nhưng nó cải thiện đáng kể các hành động tiếp theo. Khả năng này đến từ pre-training (quá trình đào tạo ban đầu trên lượng lớn văn bản internet, qua đó mô hình học các mẫu ngôn ngữ và kiến thức thế giới): mô hình dựa trên các mẫu suy luận được mã hóa trong kiến thức nhân loại, bao gồm các định luật toán học, mối quan hệ nhân quả và chiến lược phân giải vấn đề. Do đó, không giống như các Agent reinforcement learning truyền thống, các Agent dựa trên LLM ngày nay không khám phá thông qua thử và sai mù quáng; chúng suy luận trên một cơ thể kiến thức có cấu trúc.
Model as Agent: Khi chính Model trở thành sản phẩm
Paradigm "Model as Agent" là hướng đi mới nhất trong phát triển AI Agent. Các mô hình tiên tiến internalize tool calling như một khả năng gốc thông qua post-training (đặc biệt là reinforcement learning): khi nào gọi tool, gọi tool nào, với đối số gì—mô hình quyết định tất cả, không cần orchestration thủ công. Điều đó không làm cho lớp framework kém quan trọng hơn. Ngược lại: mô hình càng mạnh, Harness xung quanh càng quan trọng. Từ Harness ban đầu chỉ dây cương và trang bị được gắn cho ngựa—không phải để hạn chế khả năng chạy, mà để điều khiển sức mạnh đó một cách phù hợp. Trong ngữ cảnh Agent, mô hình là con ngựa mạnh mẽ nhưng khó dự đoán, trong khi Harness là cơ sở hạ tầng kỹ thuật hướng khả năng của nó vào thực thi tác vụ đáng tin cậy. Nó bao gồm quản lý context, giao diện tool, các ràng buộc an toàn, và cơ chế xác minh và sửa chữa (xem phần cuối cùng của chương này).
Mô hình có càng nhiều quyền ra quyết định, tác động của một quyết định sai càng lớn—điều này đòi hỏi ràng buộc, xác minh và sửa chữa chi tiết hơn để giữ cho nó đáng tin cậy. Ưu thế thực sự của các nhà cung cấp mô hình không phải là "làm cho framework mỏng hơn" mà là khả năng đồng tối ưu hóa mô hình và Harness xung quanh, liên tục cải tiến.
Nhưng một câu hỏi sâu hơn theo sau: nếu mô hình tiếp tục mạnh hơn, Harness ngày nay cuối cùng có bị hấp thụ vào mô hình không? Trong "The Bitter Lesson," Rich Sutton đã nhìn lại một mô hình lặp lại xuyên suốt bảy mươi năm nghiên cứu AI[^ch1-1]: các nhà nghiên cứu liên tục mã hóa hiểu biết của họ về một lĩnh vực vào hệ thống, đạt được lợi ích ngắn hạn nhưng cuối cùng thua các phương pháp tổng quát—search và learning—mở rộng cùng với tính toán và dữ liệu. Nhìn qua lăng kính này, bao nhiêu phần của ràng buộc, xác minh và sửa chữa trong Harness là "prior con người" mà mô hình destined sẽ internalize? Lập trường của cuốn sách này là: ủng hộ hướng đi, giữ thái độ thực dụng về tốc độ. Về mặt định hướng, chúng tôi không nghi ngờ rằng mô hình sẽ tiếp tục hấp thụ các phần của Harness—tool calling và lập kế hoạch dài hạn từng phụ thuộc vào orchestration bên ngoài nhưng giờ là khả năng gốc của mô hình. Tuy nhiên, trong thực tế, quá trình hấp thụ này chậm hơn nhiều so với trực giác gợi ý: đào tạo diễn ra trên thang thời gian tháng, và không mô hình nào có thể internalize tất cả các ràng buộc và sở thích của doanh nghiệp thực trong một lần. Giới hạn khả năng hiện tại của mô hình chính là nơi Harness tạo ra giá trị. Kỹ thuật Harness do đó không phải là sự kháng cự lại Bitter Lesson, mà là thực hành nó trên thang thời gian kỹ thuật: bất cứ khi mô hình chưa thể làm đáng tin cậy, Harness che phủ trước; bất cứ khi mô hình internalize thêm một lớp, Harness loại bỏ lớp đó và chuyển sang hỗ trợ biên khả năng tiếp theo.
[^ch1-1]: Sutton, Rich. "The Bitter Lesson", 2019. http://www.incompleteideas.net/IncIdeas/BitterLesson.html
Cơ chế học tập của Agent: Từ thích ứng ngữ cảnh đến cập nhật bền vững
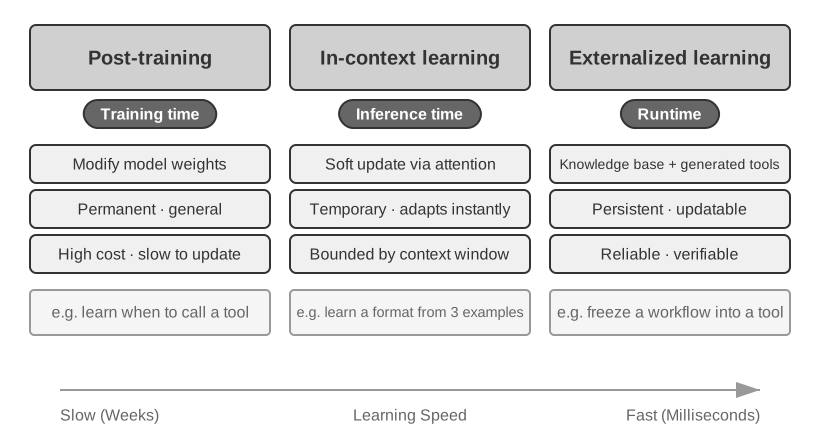
Cuộc thảo luận trước đã lưu ý rằng một mô hình có thể internalize các chính sách sử dụng tool như khả năng gốc thông qua reinforcement learning. Nhưng sự thay đổi trong hành vi của Agent không chỉ xảy ra trong quá trình đào tạo. Dựa trên vị trí cập nhật xảy ra và thời gian nó tồn tại, những thay đổi này có thể được hiểu là ba con đường bổ sung (Hình 1-2): thích ứng ngữ cảnh trong tác vụ, cập nhật các sản phẩm bên ngoài xuyên tác vụ, và cập nhật tham số trong chu kỳ đào tạo.
Hình 1-2: Ba cấp độ cập nhật khả năng Agent
Thích ứng ngữ cảnh xảy ra trong tác vụ hiện tại. Khi các ví dụ, trạng thái và kết quả retrieval đi vào context, mô hình có thể điều chỉnh hành vi ngay lập tức, nhưng điều này không thay đổi trạng thái bền vững của phiên tiếp theo. Ưu điểm của nó là tốc độ và chi phí thấp; hạn chế phát sinh từ cửa sổ context và cách thông tin được tổ chức. Chương 2 giải thích chi tiết cách thức thích ứng này hoạt động.
Để các thay đổi tồn tại xuyên tác vụ, hệ thống có thể cập nhật các sản phẩm bên ngoài: sự thật và kinh nghiệm có thể được tổ chức thành tài liệu kiến thức, các chiến lược có thể diễn đạt bằng ngôn ngữ có thể được viết vào Prompt hoặc Skill, và các quy trình xác định và ràng buộc có thể được mã hóa trong chương trình và Harness. Các sản phẩm này có thể kiểm tra và sửa đổi, nhưng Agent vẫn phải truy cập chúng tại thời điểm thực thi thông qua context hoặc giao diện tool. Các chương 3 đến 5 thiết lập nền tảng cho kiến thức và chương trình, trong khi Chương 8 thảo luận cách các cập nhật như vậy có thể được tạo ra từ các quỹ đạo vận hành đã được đánh giá.
Khi mục tiêu là một khả năng chiều cao—chẳng hạn như hiểu hình ảnh y tế, phong cách ngôn ngữ tự nhiên, hoặc một chính sách quyết định ngầm—mà các quy tắc bên ngoài không thể biểu đạt đầy đủ, các tham số mô hình phải được cập nhật thông qua post-training. Cập nhật tham số mang chi phí triển khai cao hơn nhưng có thể tạo ra sự tổng quát hóa tự nhiên và rộng rãi; Chương 7 trình bày các phương pháp một cách có hệ thống. Ba con đường do đó không phải là các danh loại loại trừ lẫn nhau mà là các cơ chế phối hợp hoạt động trên các thang thời gian khác nhau: context hỗ trợ thích ứng tức thì, các sản phẩm bên ngoài hỗ trợ tích lũy có kiểm soát, và tham số internalize các khả năng khó biểu đạt rõ ràng.
Context: Bộ thông tin làm việc của Agent
Context là bộ thông tin làm việc sẵn có cho Agent tại mỗi điểm ra quyết định. Giống như một người ra quyết định cần đúng tài liệu trên bàn—hướng dẫn tác vụ, sổ tay tham khảo, thư từ trước đó, dữ liệu mới nhất—cửa sổ context của Agent là thông tin nó có thể sử dụng. Từ góc nhìn API (được trình bày chi tiết trong Chương 2), context của mỗi lệnh gọi LLM bao gồm năm phần:
System Prompt: Không giống như các prompt người dùng nhập trong cuộc trò chuyện, system prompt được viết bởi nhà phát triển và giữ nguyên trong toàn bộ cuộc trò chuyện. Đó là "mô tả công việc" của Agent—xác định danh tính, quyền và quy tắc hành vi. Thiết kế prompt cẩn thận của system prompt là cách chúng ta định hình hành vi vận hành của Agent. System prompt cũng mang user memory tồn tại xuyên phiên (thông tin cá nhân hóa như sở thích, hành vi trước đó và cài đặt nền; xem Chương 3), cùng với trạng thái môi trường được tiêm động.
Tool Definitions: Khai báo tên, mô tả chức năng và định dạng tham số của các công cụ sẵn có cho Agent. Nếu không có tool definitions, Agent không thể nhận biết hoặc gọi bất kỳ công cụ nào—một ablation study (Thí nghiệm 1-1) sẽ xác minh điều này. Tool definitions, cùng với system prompt, tạo thành static prefix giữ nguyên trong suốt cuộc trò chuyện. (Đây là mẫu nền tảng; từ năm 2026, các framework sản phẩm cũng có thể tải đầy đủ tool schemas theo yêu cầu ở cuối context mà không phá vỡ prefix—xem phần tool definitions của Chương 2 và Chương 4.)
User Messages: Đầu vào từ người dùng. User messages cũng có thể chứa external knowledge được truy xuất động thông qua RAG (Retrieval-Augmented Generation, xem Chương 3 để biết chi tiết)—bao gồm thông tin ngoài cutoff dữ liệu đào tạo hoặc kiến thức chuyên môn riêng tư.
Assistant Messages: Các phản hồi trước đó được tạo bởi mô hình, có thể chứa tối đa ba phần—reasoning (chuỗi suy nghĩ nội bộ, duy trì tính mạch lạc và khả năng diễn giải quyết định), content (phản hồi cho người dùng), và tool_calls (cách Agent thực hiện hành động). Trong một phản hồi cụ thể, ba phần này có thể không xuất hiện đồng thời: ví dụ, khi Agent quyết định gọi tool, nó thường chỉ có reasoning + tool_calls; khi đưa ra câu trả lời cuối cùng, nó thường chỉ có reasoning + content.
Tool Results: Đầu ra được trả về sau khi framework Agent thực thi một tool. Những kết quả này là cơ sở trực tiếp cho bước suy luận tiếp theo của Agent—và là thứ cho phép nó học từ kết quả thay vì lặp lại lỗi.
Hai mục đầu tiên (system prompt + tool definitions) tạo thành static prefix; ba mục cuối (user messages + assistant messages + tool results) tạo thành dynamic message history phát triển với mỗi tương tác. Cùng nhau, năm phần này tạo nên context của mỗi lần suy luận LLM.
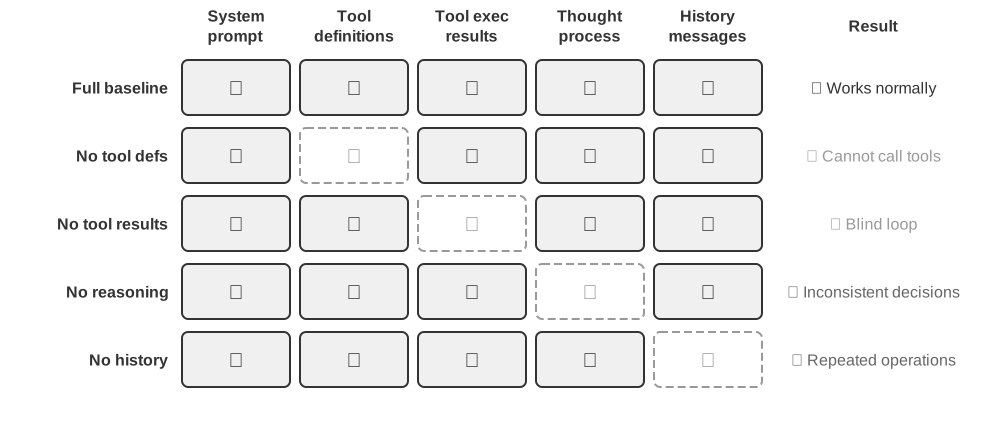
Mỗi thành phần có thực sự không thể thiếu không? Cách trực tiếp nhất để tìm ra là một ablation study—phương pháp chẩn đoán loại trừ nguyên nhân từng cái một: loại bỏ thành phần A và xem hệ thống có còn hoạt động không, sau đó thành phần B, và cứ tiếp tục, cho đến khi đóng góp của mỗi thành phần rõ ràng. Thí nghiệm 1-1 áp dụng chính xác phương pháp này cho năm thành phần trên. Kết quả rõ ràng: nếu không có tool definitions, Agent hoàn toàn không có khả năng hành động; nếu không có tool results, nó không nhận được phản hồi từ bước trước, vì vậy nó gọi cùng một tool lặp đi lặp lại, bị mắc kẹt trong vòng lặp vô hạn; nếu không có reasoning trong assistant messages, các quyết định liên tiếp bắt đầu mâu thuẫn với nhau; nếu không có message history, Agent mất tính liên tục của tác vụ và bắt đầu lại toàn bộ tác vụ từ đầu, lặp lại các bước đã thực hiện.
Thí nghiệm 1-1 ★★: Vai trò quan trọng của Context
Chúng tôi đã thăm dò cách mỗi thành phần context định hình hành vi Agent bằng một ablation study có hệ thống. Trong năm thành phần trên, bốn được kiểm tra—system prompt, với tư cách là định nghĩa danh tính cơ bản của Agent, được miễn: nếu không có nó, Agent hoàn toàn không có nhận thức về vai trò, và bài kiểm tra sẽ vô nghĩa. Như Hình 1-3 cho thấy, thí nghiệm chạy năm nhóm kiểm soát: một đường cơ sở đầy đủ giữ lại mọi thành phần, cộng với bốn nhóm mỗi nhóm thiếu một, để quan sát hiệu ứng của mỗi thành phần lên hiệu suất Agent.
Hình 1-3: Thí nghiệm 1-1—Thiết kế ablation study về Context
Kết quả thí nghiệm cho thấy vai trò không thể thay thế của mỗi thành phần context. Tool Definitions (một phần của static prefix) là nền tảng cho khả năng hành động của Agent; nếu không có chúng, Agent không thể nhận biết hoặc gọi bất kỳ công cụ nào. Tool Results là chìa khóa cho điều khiển vòng kín; sự vắng mặt của chúng tước đi phản hồi thực thi của Agent và khiến nó rơi vào vòng lặp vô hạn. Quá trình suy luận (phần reasoning của assistant messages) bảo toàn lý do cho các quyết định trước đó của Agent, làm cho toàn bộ quá trình suy luận mạch lạc hơn và ngăn các quyết định mâu thuẫn. Message history (user messages, assistant messages và tool results từ các vòng trước) ngăn các thao tác dư thừa, duy trì tính mạch lạc thực thi tác vụ và tránh lặp lại cùng lỗi.
Insight cốt lõi của thí nghiệm: context xác định thông tin Agent có tại thời điểm ra quyết định, và Agent chỉ có thể quyết định dựa trên thông tin đó. Giống như một người thiếu tài liệu quan trọng không thể đưa ra phán đoán đúng, một Agent thiếu bất kỳ thành phần context nào phải chịu sự mất mát nghiêm trọng về khả năng ra quyết định—nếu không có tool definitions, nó không biết có những công cụ nào; nếu không có kết quả thực thi trước đó, nó không biết những gì đã được thực hiện.
Vòng lặp ReAct
Với ba thành phần trong tay, một câu hỏi tự nhiên theo sau: chúng hoạt động cùng nhau như thế nào? Vòng lặp ReAct là cơ chế cốt lõi kết nối LLM, context và tools thành một hệ thống thống nhất. Chúng ta có thể kiểm tra từng bước.
Mẫu cốt lõi mà Agent thực thi tác vụ được gọi là ReAct (Reasoning + Acting). Tên chỉ đề cập đến suy luận và hành động, nhưng vòng lặp thực tế có ba giai đoạn: mô hình trước tiên suy luận về việc làm gì tiếp theo, sau đó gọi tool để hành động, rồi quan sát kết quả của tool và suy luận về bước tiếp theo. Vòng lặp "suy luận → hành động → quan sát → suy luận → hành động → quan sát" này lặp lại cho đến khi tác vụ hoàn thành.
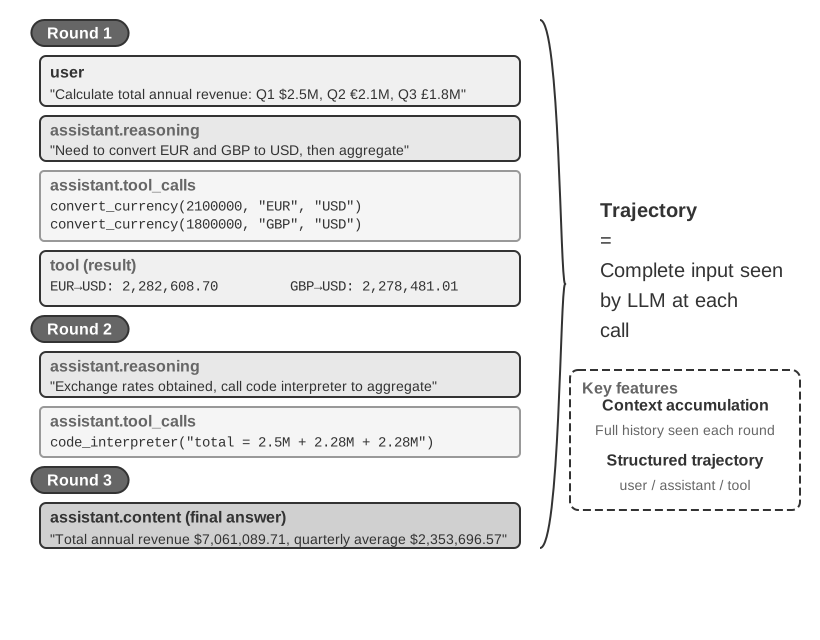
Xem xét một ví dụ cụ thể—tổng hợp doanh thu qua nhiều loại tiền tệ—để hiểu trajectory của Agent: lịch sử tin nhắn tích lũy khi Agent làm việc, bao gồm user messages, assistant messages (với reasoning và tool calls), và tool results. Trong mỗi lần gọi LLM, context đầy đủ mà mô hình nhận được là static prefix (system prompt + tool definitions) cộng với trajectory (dynamic message history) (Hình 1-4). Điều này cho thấy một sự thật quan trọng: Agent context = static prefix + trajectory. Cụ thể, static prefix là hai thành phần đầu tiên trong năm thành phần trên (system prompt + tool definitions); trajectory là ba thành phần cuối (user messages + assistant messages + tool results, phát triển với mỗi tương tác). Từ context đầy đủ này, LLM tạo phản hồi tiếp theo, sau đó được thêm vào trajectory cho lần gọi tiếp theo.
Hình 1-4: Agent trajectory—Vòng lặp ReAct cho tác vụ tổng hợp đa tiền tệ
Đây là cấu trúc của một trajectory, dưới dạng pseudocode:
trajectory = [
  {role: "user", content: "Dựa trên doanh thu quý của công ty: Q1 2.5M USD, Q2 2.1M EUR, Q3 1.8M GBP, Q4 380M JPY, tính tổng doanh thu hàng năm và doanh thu trung bình mỗi quý của công ty"},

  # Lần lặp đầu tiên - LLM nhận trajectory trên và tạo phản hồi
  {role: "assistant",
   reasoning: "Cần chuyển đổi tất cả tiền tệ sang USD...",
   content: "",  # Không trả lời trực tiếp cho người dùng
   tool_calls: [
     {name: "convert_currency", args: {amount: 2100000, from: "EUR", to: "USD"}},
     {name: "convert_currency", args: {amount: 1800000, from: "GBP", to: "USD"}},
     {name: "convert_currency", args: {amount: 380000000, from: "JPY", to: "USD"}}
   ]},

  # Agent framework thực thi tools, thêm kết quả vào trajectory
  {role: "tool", content: "EUR->USD: 2282608.7"},
  {role: "tool", content: "GBP->USD: 2278481.01"},
  {role: "tool", content: "JPY->USD: 2541806.02"},

  # Lần lặp thứ hai - LLM nhận trajectory đầy đủ, bao gồm tool results
  {role: "assistant",
   reasoning: "Đã có kết quả chuyển đổi, giờ cần tổng hợp và tính toán...",
   content: "",
   tool_calls: [
     {name: "code_interpreter", args: {code: "total = 2500000 + 2282608.7 + ..."}}
   ]},

  {role: "tool", content: "Tổng: $9,602,895.73, Trung bình: $2,400,723.93..."},

  # Lần lặp thứ ba - LLM nhận trajectory đầy đủ và tạo câu trả lời cuối cùng
  {role: "assistant",
   reasoning: "Tất cả tính toán đã hoàn tất, tổng hợp kết quả...",
   content: "CÂU TRẢ LỜI CUỐI CÙNG: Tổng doanh thu $9,602,895.73..."}
]
Lưu ý rằng system prompt và tool definitions không được hiển thị trong trajectory—chúng phục vụ như static prefix và được tự động thêm vào trước trajectory trước mỗi lần gọi LLM.
Trong thí nghiệm của chúng tôi, vòng lặp này hiển hiện rõ ràng. Ở vòng đầu tiên, Agent phân tích tác vụ và gọi ba công cụ chuyển đổi tiền tệ song song; ở vòng thứ hai, nó đưa kết quả chuyển đổi cho trình giải thích code để thực hiện phép tính chuyên sâu hơn; ở vòng thứ ba, sau khi xác nhận tất cả tính toán đã hoàn tất, nó tạo câu trả lời cuối cùng. Một tác vụ đa bước phức tạp được hoàn thành trong 3 lần lặp và 4 lần gọi tool.
Trong thiết kế cơ bản nhất này, context mà LLM nhìn thấy liên tục được thêm vào. Mỗi lần gọi LLM nhận được trajectory đầy đủ, vì vậy mô hình biết nó đang ở giai đoạn nào của tác vụ, những gì đã được thử trước đó, và kết quả là gì. Giống như con người liên tục xem xét và tóm tắt trong khi giải quyết vấn đề, Agent duy trì cái nhìn toàn cục về tác vụ thông qua trajectory. Và bởi vì trajectory có cấu trúc—user messages, assistant messages (reasoning + tool calls), và tool results đều được tách biệt rõ ràng—hệ thống có khả năng diễn giải và gỡ lỗi cao.
Trajectory không chỉ là bản ghi thực thi; nó là bằng chứng về khả năng của Agent. Phân tích trajectory ở quy mô lớn cho thấy các mẫu hành vi, các con đường quyết định tốt hơn, và các thiết kế tool tốt hơn. Dữ liệu trajectory thậm chí có thể được chưng cất thành cơ sở kiến thức, hoặc được sử dụng để đào tạo các mô hình Agent mạnh hơn thông qua reinforcement learning—đóng vòng lặp học hỏi từ kinh nghiệm.
Bây giờ chúng ta hiểu vòng lặp vận hành của Agent, chúng ta sẽ kiểm tra hai thí nghiệm để xem các mô hình khác nhau驱动 nó như thế nào.
Thí nghiệm 1-2 ★: Khả năng Agent gốc của Kimi K3
Thí nghiệm này trình bày khả năng Agent gốc của Kimi K3, một ví dụ của paradigm "Model as Agent". Kimi K3 là mô hình Mixture of Experts (MoE) với khoảng 2.8 nghìn tỷ tham số. MoE có thể được xem như một nhóm chuyên gia: đối với mỗi loại vấn đề, hệ thống chỉ kích hoạt vài chuyên gia phù hợp nhất thay vì toàn bộ mô hình, bảo toàn khả năng mà không trả toàn bộ chi phí hiệu suất. Kimi K3 có cửa sổ context 1 triệu token, khả năng hiểu thị giác gốc, và "chế độ suy luận" luôn bật. Thông qua reinforcement learning, nó đã internalize chính sách quyết định tool-calling như một khả năng gốc: khi nào gọi tool, gọi tool nào, và đối số gì truyền đều do mô hình quyết định, cho phép nó thực hiện các tác vụ như tìm kiếm web một cách tự chủ. Chính xác hơn, điều được internalize là quyết định khi nào và cách gọi; chính các tools, chẳng hạn như web_search và code_runner, vẫn thực thi ở phía server như các công cụ tích hợp cấp API. Kimi chạy các công cụ chính thức này thông qua một script engine phía server gọi là Formula.
Các quan sát quan trọng là mô hình quyết định khi nào tìm kiếm và tìm kiếm gì, cho thấy sự tự chủ thực sự; nó điều chỉnh chiến lược khi kết quả tìm kiếm đến và đánh giá liệu nó có đủ thông tin hay không. Một hiểu lầm phổ biến cần được làm rõ: reinforcement learning cho mô hình chính sách quyết định, không phải bản thân các công cụ. Nó dạy khi nào gọi tool, chọn tool nào, đối số gì truyền, có tiếp tục sau khi nhận kết quả hay không, và cách liên kết hàng chục hoặc hàng trăm lệnh gọi thành suy luận mạch lạc; những phán đoán liệu-và-cách-sử-dụng này là những gì được ghi vào trọng số mô hình. Các công cụ và thực thi của chúng được cung cấp bởi Agent framework hoặc API tích hợp: các triển khai của web_search và code_runner, sandbox code, và cơ sở hạ tầng phát hành lệnh gọi và trả kết quả đều nằm ngoài mô hình. RL tối ưu hóa chính sách quyết định; nó không nhúng công cụ tìm kiếm hoặc sandbox code vào trọng số mô hình. Do đó, vòng lặp orchestration không biến mất; nó di chuyển từ client sang server, trong khi ra quyết định di chuyển vào mô hình[^ch1-2].
[^ch1-2]: Cảm ơn độc giả asdlem đã chỉ ra và làm rõ, thông qua GitHub Issue #30, sự phân biệt rằng RL internalize là chính sách quyết định tool-calling, không phải cơ chế thực thi tool. Xem https://github.com/bojieli/ai-agent-book/issues/30
Ưu điểm đáng chú ý của Kimi K3 trong các tác vụ Agent là sự ổn định của các chuỗi tool calls dài—nó có thể duy trì 200–300 tool calls liên tiếp với suy luận mạch lạc xuyên suốt, vượt xa vài chục lệnh gọi mà hầu hết các mô hình bắt đầu suy giảm. K3 được tối ưu cho lập trình tầm xa và workloads Agent, và được phát hành trong hai biến thể: K3 Max (cho đối thoại và tác vụ Agent) và K3 Swarm Max (cho xử lý song song quy mô lớn). Là một mô hình open-source, nó sánh ngang các hệ thống closed-source hàng đầu trên các benchmark kỹ thuật phần mềm và Agent—bằng chứng rằng reinforcement learning có thể trang bị cho mô hình khả năng Agent gốc.
Thí nghiệm 1-3 ★: Khả năng Deep Research gốc của GPT-5.6
Thí nghiệm thứ hai sử dụng OpenAI GPT-5.6 để cho thấy một mô hình tiên tiến, được hỗ trợ bởi các công cụ tích hợp cấp API, đóng vòng lặp orchestration "tìm kiếm—đọc—phân tích" ở phía server cho Deep Research. Một tính năng tiện lợi của GPT-5.6 là Freeform Tool Calling. Theo truyền thống, một mô hình gọi tool phải tuần tự hóa mọi tham số thành JSON nghiêm ngặt (định dạng dữ liệu có cấu trúc), giống như điền biểu mẫu với các quy tắc định dạng cứng nhắc. Freeform tool calling (được khai báo trong API thông qua tool có type: "custom") cho phép mô hình gửi văn bản thô trực tiếp đến tool (một đoạn code Python, truy vấn SQL), tránh hoàn toàn việc escape JSON. Cần nhấn mạnh rằng đây là sự tiến hóa của định dạng tham số API, không phải đổi mới kiến trúc mô hình—vòng lặp tool-calling của client (phát hiện tool_calls → thực thi → trả kết quả) vẫn giữ nguyên; chỉ có đối số thay đổi từ chuỗi JSON sang văn bản thô.
GPT-5.6, kết hợp với các công cụ tích hợp web search và code interpreter của Responses API, cung cấp cơ chế cốt lõi của Deep Research: mô hình có thể tự chủ tìm kiếm web để lấy thông tin thời gian thực và viết code để phân tích chuyên sâu, cho phép quy trình nghiên cứu lặp lại "tìm kiếm -> đọc -> phân tích -> tìm kiếm lại." Ví dụ, khi đối mặt với câu hỏi như "Khoảng cách ngắn nhất giữa các thủ đô của 10 quốc gia ASEAN là gì?", GPT-5.6 tự động tìm kiếm tọa độ địa lý của mỗi thủ đô, sau đó viết code Python để tính khoảng cách đường tròn lớn giữa tất cả các cặp thủ đô, cuối cùng xác định cặp gần nhất. Tương tự, trong tác vụ "Tìm xu hướng Bitcoin trong tháng qua và thực hiện phân tích kỹ thuật," nó có thể lấy dữ liệu giá thời gian thực từ nhiều nguồn dữ liệu tài chính, sử dụng các thư viện phân tích kỹ thuật chuyên nghiệp để tính moving averages, RSI, MACD và các chỉ báo kỹ thuật khác, tạo biểu đồ trực quan, và cung cấp khuyến nghị giao dịch.
Quan trọng hơn, GPT-5.6 internalize triết lý thiết kế của sản phẩm OpenAI Deep Research ở cấp độ mô hình, giới thiệu một quy trình làm rõ ý định. Khi nhận được yêu cầu nghiên cứu, GPT-5.6 không bắt đầu thực thi ngay; trước tiên nó làm rõ ý định thực sự của người dùng thông qua một loạt câu hỏi. Đối với "Tìm xu hướng Bitcoin trong tháng qua và thực hiện phân tích kỹ thuật," nó sẽ hỏi trước: "Bạn muốn nguồn dữ liệu nào? Chỉ báo kỹ thuật nào bạn muốn phân tích?" Sự làm rõ tương tác này cho phép GPT-5.6 tạo ra các báo cáo nghiên cứu chính xác hơn và phù hợp hơn với nhu cầu thực tế của người dùng.
GPT-5.6 là một ví dụ trưởng thành của "Model as Agent"—web search, code interpreter và các công cụ tích hợp khác của Responses API thực thi trong vòng kín ở phía server; vòng lặp orchestration di chuyển từ client sang API server, đơn giản hóa triển khai client. Khía cạnh đáng chú ý nhất là cơ chế làm rõ ý định: thay vì thực thi tác vụ ngay lập tức, mô hình trước tiên xác nhận người dùng thực sự cần gì, sau đó xây dựng chiến lược nghiên cứu. Khoảng cách giữa "những gì người dùng nói" và "những gì người dùng thực sự muốn" được giải quyết trước khi bắt đầu thực thi.
Điều quan trọng cần lưu ý là thí nghiệm này không gắn với bất kỳ nhà cung cấp cụ thể nào. Người đọc không có tín dụng OpenAI có thể tái tạo nó với các nhà cung cấp cung cấp các công cụ được quản lý tương đương. Ví dụ, Alibaba Cloud Bailian's qwen3.7-plus Responses API cũng bao gồm web_search và code_interpreter tích hợp; Formula-managed search và code_runner của Kimi K3 cung cấp cùng loại khả năng.
Hình 1-5 minh họa kiến trúc đầy đủ của tool calling gốc dưới paradigm "Model as Agent", cùng với quy trình thực thi ReAct của Kimi K3 và GPT-5.6 trong các tác vụ thực tế.
Hình 1-5: Kiến trúc "Model as Agent"—Tool Calling gốc
Harness Engineering: Năng lực cạnh tranh vượt ra ngoài Model
Đến giờ bạn đã hiểu cách Agent hoạt động ở cốt lõi: một LLM chạy vòng lặp ReAct, được hướng dẫn bởi context, sử dụng tools để hoàn thành tác vụ. Các thí nghiệm trên cho thấy cơ chế cơ bản hoạt động—và cũng expose sự mong manh của nó. Mô hình có thể hallucinate (tạo ra các công cụ hoặc tham số không tồn tại), chọn sai tool, hoặc không thể phục hồi sau lỗi. Giữa một demo hoạt động và một sản phẩm đáng tin cậy tồn tại một khoảng cách đáng kể, và những sự mong manh đó chính là lý do Harness Engineering tồn tại. Nửa đầu của chương này trả lời Agent là gì; nửa sau trả lời cách Agent vận hành đáng tin cậy trong sản phẩm.
Các phần trước đã thiết lập công thức cốt lõi: Agent = LLM + Context + Tools. Nó mô tả thành phần nội bộ của Agent: reasoning engine, working context, và action interfaces. Harness Engineering thêm một cái nhìn thứ hai, ở cấp triển khai, về cùng hệ thống: coi LLM như một thành phần cốt lõi (Model), và gọi tất cả code hỗ trợ xây dựng xung quanh nó là Harness. Hai cái nhìn không phải đối thủ; chúng mô tả cùng một hệ thống ở các mức trừu tượng khác nhau. Chúng ta chuyển sang từ "Model" tổng quát hơn vì các nguyên tắc của Harness Engineering áp dụng cho bất kỳ mô hình nào có thể suy luận và gọi tools, không phải một loại cụ thể. Cốt lõi của Harness là "Context + Tools" của công thức ban đầu, cộng với ba lớp bảo vệ: Constrain (Agent được phép và không được phép làm gì), Verify (nó có làm đúng hay không), và Correct (cách phục hồi khi nó không làm đúng).
Mở rộng dưới dạng phương trình, thành phần cấp sản phẩm đầy đủ là:
Một Agent hoạt động tối thiểu chạy trên LLM, context và tools. Để tiếp tục vận hành đáng tin cậy trong các workload sản phẩm chạy lâu, nó cần ba lớp kỹ thuật bên ngoài—constrain để ngăn chặn vượt quá, verify để phát hiện lỗi, correct để phục hồi từ thất bại. Nói cách khác: công thức tối thiểu là cái nhìn demo, và công thức mở rộng là cái nhìn sản phẩm—cái sau chứa hoàn toàn cái trước và thêm lưới an toàn xung quanh nó.
Một ví dụ làm rõ ranh giới: nhúng chính sách hoàn tiền vào context thuộc về Context, trong khi kiểm tra số tiền hoàn không vượt quá tổng đơn hàng thuộc về Constrain. Thực thi một lệnh gọi API thuộc về Tools, trong khi tự động thử lại sau khi API hết thời gian thuộc về Correct. Mô hình cung cấp hiểu biết và suy luận cơ bản; Harness hướng dẫn, ràng buộc và khuếch đại những khả năng đó thành thực thi tác vụ đáng tin cậy. Thực hành kỹ thuật thiết kế và tối ưu hóa cơ sở hạ tầng này bên ngoài mô hình là Harness Engineering.
Một ví dụ cụ thể cho thấy giá trị của Harness. Giả sử bạn yêu cầu Agent hoàn tiền đơn hàng của người dùng được đặt 3 ngày trước. Không có Harness: mô hình không nhận được chính sách hoàn tiền (không context), không biết gọi API nào (không tools), tạo kết quả hoàn tiền giả cho người dùng (không verify), và người dùng phát hiện hoàn tiền chưa bao giờ xảy ra (không correct). Có Harness: system prompt chỉ định chính sách hoàn tiền 7 ngày (context), Agent gọi các công cụ query_order và process_refund để thực hiện thao tác (tools), framework kiểm tra rằng khoản hoàn không vượt quá tổng đơn hàng (constrain), xác nhận từ cơ sở dữ liệu rằng hoàn tiền đã được xử lý (verify), và tự động thử lại nếu lệnh gọi API hết thời gian (correct). Cùng mô hình, kết quả khác biệt đáng kể.
Tóm lại, một mô hình không có Harness có thể có năng lực cao, nhưng nó thiếu các kiểm soát xung quanh cần thiết để hoàn thành tác vụ đáng tin cậy.
Chính xác hơn, Harness không phải mọi thứ bên ngoài mô hình: nó là lớp thời gian chạy và quản trị bên trong ranh giới Agent và bên ngoài Model. Nó điều phối tương tác Model–Environment nhưng không bao gồm chính Environment. Tool definitions, call adapters, quyền sandbox và cơ chế reset thuộc về Harness; các file và process thay đổi bên trong sandbox, cơ sở dữ liệu bên ngoài, trang web, người dùng và thế giới vật lý thuộc về Environment. Vị trí triển khai không thay đổi ranh giới khái niệm này. Cốt lõi của Harness là quản lý context và giao diện tools, xung quanh đó ba loại bảo vệ kỹ thuật được xây dựng:
Chức năng
Trách nhiệm một câu
Mối quan hệ với Context/Tools
Context
Cung cấp thông tin liên quan cho mô hình
Khả năng cốt lõi
Tools
Cung cấp giao diện hành động cho mô hình
Khả năng cốt lõi
Constrain
Đặt ranh giới hành vi—được phép và không được phép
Ranh giới an toàn xây dựng xung quanh context và tools
Verify
Tự động đánh giá tính đúng đắn của kết quả thực thi tool
Cơ chế kiểm tra xây dựng xung quanh kết quả thực thi tool
Correct
Tự động phục hồi hoặc rollback khi phát hiện vấn đề
Cơ chế phục hồi xây dựng xung quanh thất bại tool call
Context và Tools cho phép Agent hoàn thành tác vụ—hiểu tác vụ và hành động trên nó. Constrain, Verify và Correct đảm bảo nó làm điều đó một cách đáng tin cậy và an toàn—không phải như thứ gì đó tách biệt khỏi Context và Tools, mà là kỹ thuật giữ cho chúng hoạt động đáng tin cậy trong sản phẩm. Dọc theo đường cong trưởng thành của các sản phẩm Agent, trọng tâm giữa hai nhóm này dịch chuyển.
Các Agent framework ban đầu tập trung vào Context và Tools: cho mô hình tools, cho nó context, và để nó hoàn thành tác vụ. Các hệ thống cấp sản phẩm đã chuyển trọng tâm sang Constrain, Verify và Correct: đảm bảo tool calls an toàn, context được quản lý, và lỗi có thể phục hồi.
Lấy Claude Code. Phần lớn code Harness của nó là Constrain, Verify và Correct, không phải Context và Tools—bản thân các tools (đọc/ghi file, thực thi lệnh, tìm kiếm) chỉ là một phần nhỏ; các cơ chế bảo vệ xây dựng xung quanh chúng mới là cốt lõi thực sự. Các cơ chế này bao gồm:
Quản lý trạng thái quy trình: Theo dõi Agent đang thực thi bước nào
Nén Context đa lớp: Tự động cắt bỏ thông tin khi có quá nhiều
Phân loại quyền: Kiểm soát thao tác nào yêu cầu xác nhận người dùng
Circuit Breaker: Tự động dừng thử lại sau nhiều lỗi liên tiếp để một thao tác thất bại không cascade toàn bộ hệ thống
Cơ chế phục hồi lỗi: Bắt ngoại lệ, rollback về trạng thái ổn định cuối cùng, thử lại, hoặc chuyển giao cho con người
Ngành công nghiệp đang chuyển từ hoàn thành tác vụ sang hoàn thành tác vụ đáng tin cậy, biến Harness Engineering thành năng lực cạnh tranh cốt lõi của hệ thống Agent.
Từ Prompt Engineering đến Loop Engineering: Sự tiến hóa của paradigm kỹ thuật
Nhìn lại sự phát triển của kỹ thuật ứng dụng AI, một vòng cung tiến hóa rõ ràng xuất hiện:
Prompt Engineering là làn sóng đổi mới đầu tiên—cải thiện chất lượng đầu ra bằng cách tinh chỉnh các hướng dẫn ngôn ngữ tự nhiên được đưa vào mô hình.
Context Engineering là làn sóng thứ hai—nhận ra rằng chỉ tối ưu hóa prompt là chưa đủ: tất cả thông tin mô hình có thể nhìn thấy (hướng dẫn hệ thống, tool definitions, lịch sử hội thoại, kiến thức bên ngoài) phải được quản lý một cách có hệ thống.
Harness Engineering là làn sóng thứ ba—nó mở rộng cái nhìn từ "thông tin mô hình nhận được" sang "loại hệ thống mô hình chạy trong đó," bao gồm tất cả cơ sở hạ tầng bên ngoài mô hình: cơ chế ràng buộc, phương pháp xác minh, vòng lặp phản hồi, phục hồi lỗi.
Loop Engineering đến sau, mở rộng cái nhìn từ một lần chạy sang vận hành tự chủ bền vững xuyên các lần chạy: ai phát hiện công việc tiếp theo, khi nào xác minh, và khi nào tác vụ được coi là thực sự hoàn thành (Chương 10 phát triển điều này cùng với hệ thống cộng tác đa agent).
Vào tháng 7 năm 2026, ngành bắt đầu sử dụng Graph Engineering cho góc nhìn orchestration cấp cao hơn: tổ chức các Agent loops, deterministic programs và phê duyệt của con người thành một execution graph rõ ràng, trong đó các nodes cung cấp khả năng, các edges định nghĩa routing và dependencies, và trạng thái có cấu trúc di chuyển dọc theo các edges đó và được lưu trữ tại các biên giới quan trọng[^ch1-graph-engineering].
[^ch1-graph-engineering]: Josh C. Simmons đã sử dụng tên này một cách rõ ràng trong bài viết ngày 4 tháng 7 năm 2026 We Are Entering the Graph Engineering Phase, tóm tắt nó theo các nodes, typed edges và checkpointed state. Vào ngày 18 tháng 7, câu hỏi của Peter Steinberger về liệu cuộc thảo luận đã chuyển từ loops sang graphs đã giúp tên này lan rộng hơn. Các thực hành có trước nhãn: tài liệu chính thức của LangGraph, Microsoft Agent Framework và Google ADK mô tả chúng là graph orchestration hoặc graph-based workflows. Xem https://www.drjoshcsimmons.com/writing/we-are-entering-the-graph-engineering-phase, https://x.com/steipete/status/2078277297791189132, https://docs.langchain.com/oss/python/langgraph/overview, https://learn.microsoft.com/en-us/agent-framework/workflows/, và https://adk.dev/workflows/.
Năm giai đoạn này không phải là sự thay thế mà là các lớp lồng nhau: Prompt Engineering là một tập con của Context Engineering, là một tập con của Harness Engineering, là một tập con của Loop Engineering. Mỗi lớp mở rộng phạm vi quan tâm và ảnh hưởng của kỹ sư ra ngoài lớp trước. Khi các mô hình hội tụ về khả năng và không còn là yếu tố phân biệt quyết định, lợi thế cạnh tranh chuyển sang kỹ thuật bên ngoài mô hình.
Các thực hành kỹ thuật gần đây ủng hộ quan điểm này. Công việc của LangChain trên Terminal Bench 2.0 (một benchmark đánh giá khả năng hoàn thành tác vụ phức tạp trong môi trường terminal của Agent) là một ví dụ nổi bật: Coding Agent của họ cải thiện từ 52.8% lên 66.5% (nhảy từ ngoài top 30 vào top 5 trên bảng xếp hạng). Điều thay đổi không phải mô hình mà là Harness—cho phép Agent tự kiểm tra kết quả thực thi, phát hiện khi bị mắc kẹt trong vòng lặp lặp lại, và tinh chỉnh chiến lược suy luận.
Nguyên tắc cốt lõi của năm chức năng Harness
Bảng trước liệt kê năm chức năng của Harness. Bảng dưới đây thêm nguyên tắc thiết kế cốt lõi của mỗi chức năng và nơi cuốn sách này trình bày, ánh xạ khái niệm sang thực hành:
Chức năng
Nguyên tắc cốt lõi
Ví dụ thực tiễn
Xem chương
Context
Đầy đủ thông tin: Đảm bảo Agent ra quyết định dựa trên thông tin đầy đủ tại mỗi điểm ra quyết định
System prompts, cơ sở kiến thức, thanh trạng thái Agent, Sidecar bypass queries
Chương 2 & 3
Tools
Giao diện rõ ràng: Tên tool trực quan, tham số có ví dụ, ranh giới được giải thích
MCP tools, code interpreter, search tools
Chương 4
Constrain
Fail-Safe Defaults: Tất cả khả năng bị tắt theo mặc định và phải được bật rõ ràng (tương tự quản lý quyền ứng dụng di động)
Trong Claude Code, mỗi tool yêu cầu ủy quyền người dùng theo mặc định trước khi thực thi
Chương 4
Verify
Cách ly đầu vào: Kiểm tra bảo mật chỉ xem dữ liệu có cấu trúc (ví dụ: các trường JSON trả về từ tools), không phải văn bản tự do do mô hình tạo (vì kẻ tấn công có thể thao túng đầu ra mô hình thông qua prompt injection)
Kiểm tra linter, hệ thống kiểu, xác thực kết quả tool call
Chương 5 & 6
Correct
Không expose trạng thái trung gian cho đến khi thất bại được xác nhận là không thể phục hồi (ví dụ: thử lại im lặng một tool call thất bại thay vì hiển thị cho người dùng kết quả chưa hoàn thành)
Thử lại im lặng, tạo tiếp, chuyển sang phán đoán của con người khi thất bại liên tiếp (cơ chế circuit breaker)
Chương 2 & 5
Năm chức năng tạo thành một vòng kín: Context và Tools hỗ trợ ra quyết định, Constrain ngăn lỗi, Verify phát hiện sai lệch, và Correct đóng vòng lặp. Nếu bất kỳ mắt xích nào thiếu, hệ thống phát triển khoảng trống đáng tin cậy. Trước khi kiểm tra các mẫu orchestration cụ thể và thiết kế guardrails, trước tiên chúng tôi trình bày các nguyên tắc cốt lõi để xây dựng Agent hiệu quả và để chọn mô hình—nền tảng cho mọi quyết định thiết kế theo sau.
Nguyên tắc cốt lõi để xây dựng Agent hiệu quả
Dựa trên kinh nghiệm của Anthropic, các hệ thống Agent thành công tuân theo ba nguyên tắc cốt lõi.
Giữ đơn giản. Bắt đầu với giải pháp đơn giản nhất và thêm độ phức tạp chỉ khi thực sự cần thiết. Gọi API trực tiếp ưu tiên hơn framework phức tạp; code rõ ràng ưu tiên hơn abstraction thông minh—mỗi lớp abstraction bổ sung là một điểm mù mới khi gỡ lỗi.
Giữ minh bạch. Hiển thị các bước lập kế hoạch, nhật ký thực thi và quỹ đạo quyết định của Agent một cách rõ ràng. Đây không chỉ là tiện lợi gỡ lỗi; đó là điều kiện tiên quyết cho niềm tin của người dùng—một lỗi bên trong hộp đen rất khó xác định hoặc sửa chữa từ bên ngoài.
Thiết kế giao diện tool có cấu trúc tốt (ACI, Agent-Computer Interface). ACI có nghĩa là thiết kế giao diện từ góc nhìn của Agent—dễ hiểu và dễ sử dụng cho Agent—thay vì từ góc nhìn của lập trình viên, như trong API truyền thống. Tên và tham số của tool nên trực quan, và ở bất kỳ đâu có khả năng sử dụng sai, thiết kế nên khiến lỗi đó không thể xảy ra từ đầu: góc khía của thẻ SIM cho phép nó trượt vào khay chỉ theo một hướng, và lò vi sóng từ chối hâm nóng khi cửa đang mở. Sản xuất gọi triết lý "thiết kế loại bỏ lỗi" này là Poka-yoke, một thuật ngữ từ Hệ thống Sản xuất Toyota. Một tool thiết kế kém có thể khiến ngay cả mô hình mạnh nhất thất bại lặp đi lặp lại: giao diện là kênh duy nhất giữa mô hình và tool, và một giao diện mơ hồ được khuếch đại thành lỗi hệ thống.
Ba phần tiếp theo đề cập đến ba chủ đề độc lập nhưng quan trọng trong kỹ thuật Harness: lựa chọn mô hình, mẫu orchestration, và guardrails cùng an toàn. Không thuộc năm yếu tố Harness chính, nhưng tất cả đều không thể tránh trong thực hành kỹ thuật.
Cách chọn Model
Trước khi thảo luận về mẫu orchestration, trước tiên chúng ta cần trả lời một câu hỏi thực tiễn: loại mô hình nào nên drive Agent của bạn?
Mô hình là nền tảng cho trí thông minh của Agent, và chọn đúng mô hình thường quan trọng hơn bất kỳ lượng tinh chỉnh prompt nào. Các bản phát hành mô hình di chuyển quá nhanh để các khuyến nghị phiên bản cụ thể còn hữu dụng, vì vậy phần này cung cấp hướng dẫn thay thế.
Models Closed-Source. Hai nhà cung cấp model closed-source được sử dụng phổ biến nhất trong phát triển Agent hiện tại là OpenAI (GPT/o series) và Anthropic (Claude series). Các model closed-source thường dẫn đầu về khả năng nhưng đắt hơn và bị giới hạn bởi chính sách API của nhà cung cấp. Khi chọn model, đừng chỉ dựa vào bảng xếp hạng; hãy đánh giá trên chính tác vụ của bạn (xem Chương 6).
Models Open-Source. Tại thời điểm viết, các model open-source tụt hậu không quá sáu tháng so với model closed-source, trong khi chi phí thấp hơn đáng kể. Nếu kịch bản kinh doanh của bạn không yêu cầu khả năng model cao nhất, một model open-source là lựa chọn thực dụng. Các model open-source có chi phí thấp, hỗ trợ triển khai riêng tư và cho phép fine-tuning tùy chỉnh, phù hợp cho các kịch bản nhạy cảm chi phí hoặc có yêu cầu tuân thủ dữ liệu. DeepSeek, Kimi và GLM nằm trong số các model mạnh hơn của Trung Quốc cho khả năng Agent. Lưu ý rằng các model khác nhau rộng rãi về khả năng tool-calling, vì vậy hãy chắc chắn kiểm tra trong kịch bản cụ thể trước khi cam kết.
Ngoài khả năng, hãy xem xét ranh giới chính sách của model. Một model có thể có khả năng kỹ thuật để thực hiện tác vụ mà không có sản phẩm host cho phép người dùng kích hoạt khả năng đó. Các nhà cung cấp vẽ ranh giới chính sách khác nhau xung quanh bảo mật mạng, chưng cất model, trích xuất model, dữ liệu riêng tư và thao tác có nguy cơ cao; cùng một tác vụ cũng có thể tạo ra kết quả khác nhau trong sản phẩm chat, Coding Agent và API. Lựa chọn model do đó không thể chỉ so sánh độ chính xác, giá và tốc độ. Hãy kiểm tra trên các tác vụ thực tế liệu model có sẵn sàng tiến hành, giao diện có expose khả năng cần thiết hay không, và điều khoản dịch vụ có cho phép sử dụng dự định hay không. Đối với các tác vụ quan trọng, chuẩn bị chuyển giao cho con người hoặc một model tuân thủ khác làm phương án dự phòng.
Hầu hết các Agent cần Model hỗ trợ Reasoning. Agent đưa ra các quyết định phức tạp—suy luận đa bước, lựa chọn tool—và các model không có reasoning thường hoạt động kém trên chúng. Ngoại lệ rất ít: một bước đơn giản, hoặc thao tác GUI Computer Use tương đương nhấp vào vị trí cố định, nơi một model không reasoning có thể đủ. Khi suy luận đa bước hoặc ra quyết định động bước vào, một model reasoning là thiết yếu.
Xem xét tốc độ đầu ra và khả năng đa phương thức. Ngoài chi phí, hai chiều dễ bị bỏ qua. Một là tốc độ output token: Agent thường chạy nhiều vòng suy luận, và mỗi vòng phải hoàn thành trước khi vòng tiếp theo bắt đầu, vì vậy tốc độ đầu ra trực tiếp xác định độ trễ đầu-cuối—một tác vụ Agent 20 vòng chạy chậm hơn 2 giây mỗi vòng có nghĩa là thêm 40 giây chờ đợi. Chiều còn lại là hỗ trợ đa phương thức: nếu Agent của bạn cần hiểu hình ảnh, âm thanh hoặc video, khả năng đa phương thức là yêu cầu bắt buộc, và các model khác nhau rộng rãi ở đây.
Mẫu Orchestration: Workflow vs. Autonomous
Các mẫu orchestration là cách Harness tổ chức lớp "context và tools"—chúng xác định cách context chảy giữa các lần gọi LLM, cách tools được lên lịch, và liệu đường dẫn thực thi của Agent được xác định trước hay được tạo động. Orchestration Agent đã tiến hóa từ đơn giản đến phức tạp, và mỗi mẫu có các trường hợp sử dụng phù hợp và đánh đổi. Theo kinh nghiệm của Anthropic làm việc với hàng chục đội xây dựng LLM Agent, các triển khai thành công nhất hiếm khi sử dụng framework phức tạp; chúng sử dụng các mẫu đơn giản, có thể kết hợp.
Khi xây dựng ứng dụng LLM, tiến từ đơn giản đến phức tạp. Bắt đầu với một lần gọi LLM—nếu prompt tốt hơn và in-context examples giải quyết vấn đề, đừng xây dựng hệ thống Agent. Khi cần nhiều bước và tác vụ phân giải rõ ràng thành các sub-tasks cố định, sử dụng workflow. Sử dụng autonomous Agent chỉ khi bạn cần ra quyết định động và đường dẫn thực thi linh hoạt. Và hãy nhớ: các hệ thống Agent thường đánh đổi độ trễ và chi phí để có hiệu suất tác vụ tốt hơn—hãy đánh giá cẩn thận liệu đánh đổi đó có xứng đáng không.
Mẫu Workflow: Orchestration xác định
Một workflow là hệ thống orchestrate LLM và tools thông qua các đường dẫn code được xác định trước. Đường dẫn thực thi của nó là xác định và được thiết kế trước bởi nhà phát triển—hành vi của mỗi bước và chuyển tiếp được định nghĩa trong code; LLM chỉ xử lý việc hiểu và tạo bên trong mỗi node.
Ví dụ, một Agent đặt vé máy bay có thể sử dụng workflow với bốn node cố định:
Xác minh danh tính người dùng—Gọi API xác minh danh tính để xác nhận người dùng là ai.
Tìm kiếm chuyến bay có sẵn—Truy vấn cơ sở dữ liệu chuyến bay dựa trên yêu cầu người dùng.
Hoàn thành thanh toán—Gọi giao diện thanh toán để trừ số tiền.
Xác nhận đặt vé—Gọi API đặt vé để khóa ghế và gửi xác nhận cho người dùng.
LLM có thể được sử dụng trong mỗi node (ví dụ: sử dụng ngôn ngữ tự nhiên để hiểu nhu cầu du lịch của người dùng), nhưng trình tự giữa các node được cố định bởi code—hệ thống sẽ không đặt ghế trước khi thanh toán hoàn tất, cũng sẽ không bắt đầu tìm kiếm chuyến bay trước khi xác minh danh tính.
Mẫu workflow có hai ưu điểm cốt lõi. Thứ nhất, kiểm soát quy trình nghiêm ngặt: nhà phát triển có thể đảm bảo các bước quan trọng không bao giờ bị bỏ qua hoặc chạy sai thứ tự—các quy tắc kinh doanh như "không đặt vé trước thanh toán" được thực thi bởi code, không được để lại cho phán đoán của LLM. Thứ hai, an ninh: bởi vì đường dẫn thực thi là xác định, prompt injection hoặc lỗi mô hình chỉ có thể ảnh hưởng đến xử lý bên trong node hiện tại; nó không thể khiến Agent nhảy đến nhánh mà nó không nên đạt tới. Bề mặt tấn công bị giới hạn trong một node đơn lẻ.
Hạn chế chính của workflow là sự thiếu linh hoạt. Khi một sự kiện không lường trước xảy ra—ví dụ: người dùng thay đổi đặt vé trong quá trình thanh toán, hoặc một chuyến bay bị hủy và hệ thống cần đề xuất phương án thay thế—đường dẫn cố định không thể tự thích ứng; nó chỉ có thể theo một nhánh ngoại lệ được đặt trước hoặc chuyển quyền kiểm soát lại cho con người.
Agent Tự chủ: Ra quyết định tại thời gian chạy
Khi đường dẫn cố định của workflow là không đủ, chúng ta cần một autonomous Agent. Sự khác biệt cốt lõi giữa autonomous Agent và workflow là đường dẫn thực thi không được xác định trước mà được xác định tại thời gian chạy bởi Agent dựa trên phản hồi môi trường.
Quay lại ví dụ chuyến bay, autonomous Agent không cần bốn node được xác định trước. Người dùng nói, "Đặt cho tôi chuyến bay đến Thượng Hải thứ Tư tuần sau," và Agent xác định trình tự động: nó tìm kiếm chuyến bay, phát hiện rằng cần đăng nhập, xác minh danh tính, và tiếp tục tìm kiếm. Nếu chuyến bay rẻ nhất có quá cảnh, nó có thể hỏi liệu điều đó có chấp nhận được không; nếu người dùng nói không, nó điều chỉnh tiêu chí tìm kiếm.
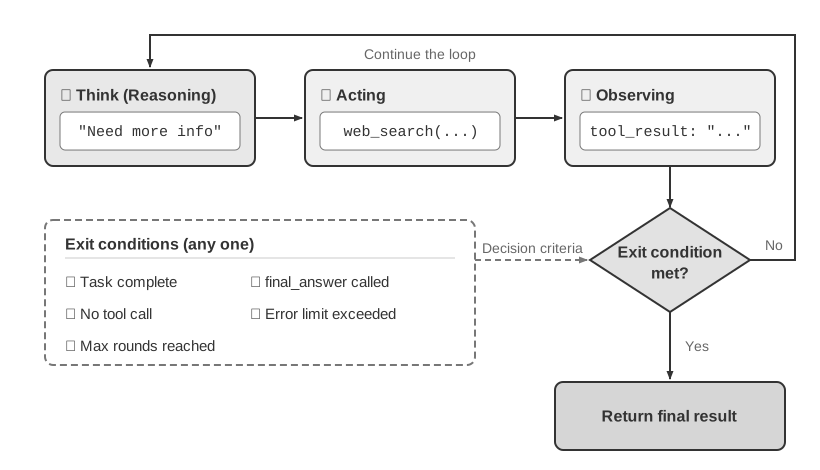
Autonomous Agent do đó phải tự lập kế hoạch—chọn các bước thực thi của riêng mình—và nhận ra thất bại và thay đổi chiến lược thay vì đơn giản dừng lại khi gặp lỗi. Nhưng tự chủ không phải là không giới hạn: các điều kiện dừng rõ ràng phải được thiết kế (tác vụ hoàn thành, số lần lặp tối đa đạt tới, lỗi không thể phục hồi), nếu không Agent có thể rơi vào vòng lặp vô hạn hoặc tiếp tục thực thi sau khi tác vụ đã hoàn thành.
Từ góc nhìn triển khai, autonomous Agent về cơ bản là LLM sử dụng tools trong vòng lặp, liên tục thu thập phản hồi môi trường để tiến bộ trên tác vụ—đây là vòng lặp ReAct được giới thiệu trước đó. Các điều kiện thoát phổ biến bao gồm: gọi tool đầu ra cuối cùng, mô hình trả về phản hồi mà không có tool calls, hoặc gặp lỗi hoặc đạt số vòng tối đa.
Hình 1-6: Vòng lặp thực thi của autonomous Agent
Autonomous Agent phù hợp với các vấn đề mở—những vấn đề khó dự đoán số bước yêu cầu. Các trường hợp sử dụng điển hình bao gồm: Coding Agent giải quyết các tác vụ SWE-bench (Software Engineering Benchmark, benchmark đánh giá khả năng tự động sửa lỗi GitHub thực tế của Agent), Agent "Computer Use" vận hành giao diện máy tính như con người, và các tác vụ nghiên cứu yêu cầu tìm kiếm và phân tích lặp lại.
Tự chủ cũng tốn kém hơn và để lỗi tích lũy. Triển khai autonomous Agent do đó đòi hỏi kiểm tra kỹ lưỡng trong sandbox, guardrails và giám sát phù hợp, và các checkpoint có con người tham gia tại các điểm ra quyết định quan trọng.
Lựa chọn và kết hợp hai mẫu
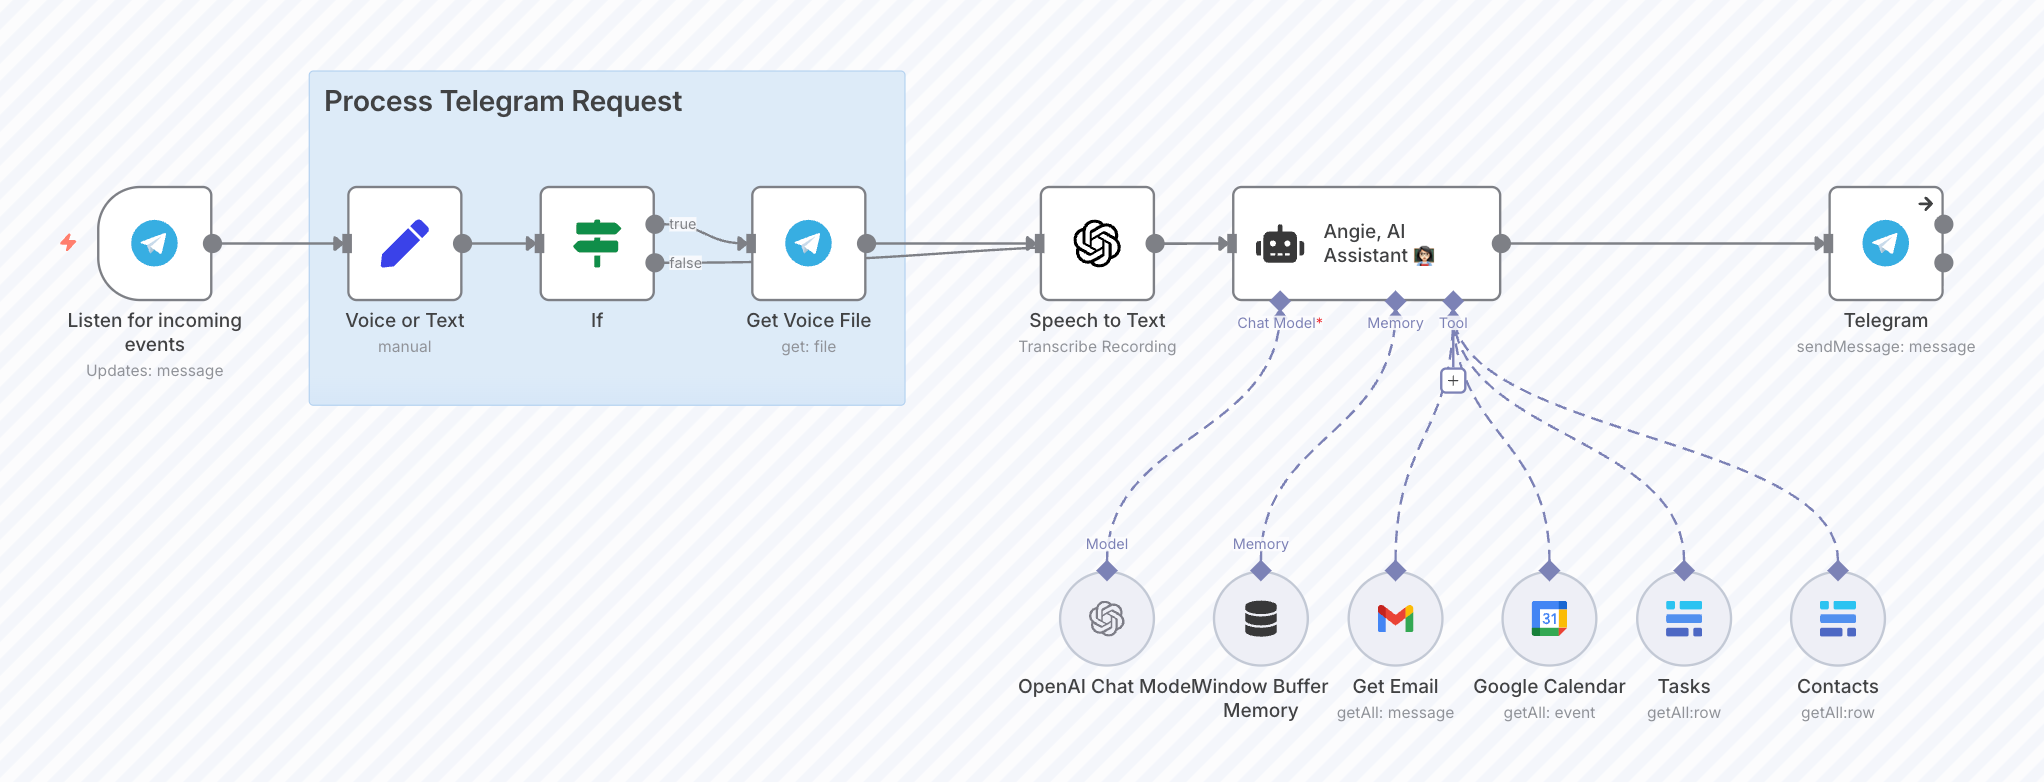
Trong thực tế, workflow và autonomous Agent không loại trừ lẫn nhau—nhiều hệ thống kết hợp cả hai: các quy trình quan trọng với yêu cầu tuân thủ nghiêm ngặt chạy dưới dạng workflow để đảm bảo độ tin cậy, trong khi các phần cần linh hoạt chuyển sang chế độ tự chủ. Ví dụ, n8n là một framework tự động hóa workflow open-source trưởng thành, trong đó các nhà phát triển xây dựng Agent bằng cách sắp xếp các thành phần chức năng trên canvas trực quan—và các node workflow và node autonomous Agent có thể cùng tồn tại trong một hệ thống.
Hình 1-7: Giao diện trình chỉnh sửa workflow n8n
So sánh ngắn gọn các Agent Framework phổ biến
Bảng dưới đây tóm tắt các Agent framework và nền tảng được sử dụng rộng rãi để giúp người đọc xác định đúng cho kịch bản của mình:
Trọng tâm Harness
Chương tương ứng
Nội dung cốt lõi
Mối quan ngại bảo mật
Thiết kế Context
Chương 2 (Context Engineering)
Prompt Engineering, thanh trạng thái Agent, nén Context, Agent Skills
Prompt Injection và rò rỉ thông tin
Mở rộng Context (lưu trữ kiến thức)
Chương 3 (Knowledge Bases)
User memory, RAG, structured indexes, Agentic RAG
Lộ thông tin nhạy cảm, bảo vệ quyền riêng tư
Thiết kế Tool và ràng buộc bảo mật
Chương 4 (Tool Design)
Phân loại tool, kiểm soát quyền, tiêu chuẩn MCP, kiến trúc bất đồng bộ
Thao tác sai, truy cập trái phép, thao tác không thể đảo ngược
Xác minh và sửa chữa Tool
Chương 5 (Code Generation)
Harness của Coding Agent, test-driven development, quy tắc mã hóa
Mạo danh, phân bổ trách nhiệm
Xác minh cấp hệ thống
Chương 6 (Evaluation)
Môi trường đánh giá, bộ dữ liệu, đánh giá tự động, observability
—
Sửa chữa cấp Model
Chương 7 (Post-training)
SFT (Supervised Fine-Tuning), reinforcement learning—ghi các tín hiệu phản hồi tích lũy trong Harness vào tham số model, là phần mở rộng của Harness engineering
Sai lệch mục tiêu, alignment và robustness
Sửa chữa liên tục dựa trên kinh nghiệm
Chương 8 (Continuous Evolution)
Tín hiệu học từ trajectory; cập nhật kiến thức/hướng dẫn/chương trình/tham số; tự sửa đổi; xác minh và rollback
Đầu độc bộ nhớ, tự sửa đổi không an toàn, trôi khả năng
Context và Tools đa phương thức
Chương 9 (Multimodality and Real-Time Interaction)
Voice Agents, Computer Use, robotic manipulation
Lọc bảo mật đầu vào đa phương thức, kiểm soát quyền trong tương tác thời gian thực
Ràng buộc và sửa chữa giữa nhiều Agent
Chương 10 (Multi-Agent Collaboration)
Kiến trúc cộng tác, chế độ thất bại, xã hội Agent
Vi phạm ranh giới tin cậy giữa các Agent, xung đột tài nguyên chia sẻ
Khi xu hướng "Model as Agent" sâu hơn, giá trị cốt lõi của framework không còn nằm ở "orchestrate LLM calls"—các mô hình ngày càng tự quyết định. Điều trở nên quan trọng hơn là kỹ thuật Harness xung quanh mô hình: quản lý context, hệ sinh thái tool, ràng buộc bảo mật, phục hồi lỗi. Khi chọn framework, câu hỏi không phải là framework tinh vi đến đâu, mà là liệu nó cho phép bạn tập trung vào logic kinh doanh thông qua lớp abstraction mỏng nhất có thể.
Các mẫu orchestration giải quyết tổ chức context và tools bên trong Harness—cách các LLM calls, tools và data flows kết nối. Nhưng hoàn thành tác vụ là chưa đủ; tác vụ cũng phải được hoàn thành đúng và an toàn. Do đó chúng ta chuyển sang cách chính mà constrain, verify và correct được triển khai trong thực hành: guardrails.
Guardrails và An toàn
Phần này cung cấp cái nhìn tổng quan cấp cao về guardrails để thiết lập bức tranh toàn cảnh. Chi tiết triển khai và thực hành theo sau trong Chương 2 (bảo vệ prompt injection), Chương 4 (kiểm soát quyền tool), và Chương 5 (bảo mật thực thi code); người đọc lần đầu không cần theo dõi mọi chi tiết.
Guardrails là cách lớp "constrain, verify và correct" của Harness được triển khai chính—một hệ thống phòng thủ nhiều lớp giữ cho hành vi Agent an toàn và có thể kiểm soát. Guardrails được thiết kế tốt giúp quản lý rủi ro quyền riêng tư dữ liệu (ví dụ: ngăn chặn rò rỉ system prompt) và rủi ro danh tiếng (ví dụ: giữ cho hành vi model nhất quán với thương hiệu). Bắt đầu với guardrails cho các rủi ro bạn đã xác định, sau đó thêm mới khi lỗ hổng mới lộ diện.
Hãy coi guardrails là phòng thủ chiều sâu. Không một guardrails đơn lẻ nào có thể đủ tự nó, nhưng nhiều guardrails chuyên biệt kết hợp tạo ra hệ thống Agent kiên cường hơn nhiều.
Guardrails cũng có một chế độ thất bại khác: từ chối sai. Để giảm cơ hội cho phép các yêu cầu nguy hiểm, model cũng có thể từ chối các công việc hợp pháp nhưng có vẻ nhạy cảm, chẳng hạn như kiểm thử bảo mật được ủy quyền hoặc nghiên cứu chưng cất model. Đánh giá guardrails do đó không chỉ kiểm tra liệu các yêu cầu bị cấm có bị chặn không, mà còn liệu các yêu cầu rõ ràng được phép có thể hoàn thành không.
Các loại Guardrails
Dựa trên vị trí trong luồng thực thi, guardrails chia thành ba loại: phía đầu vào, phía thực thi và phía đầu ra.
Phía đầu vào chặn các yêu cầu trước khi chúng đến Agent, thường thông qua bốn cơ chế. Phân loại liên quan đánh dấu các truy vấn ngoài chủ đề—ví dụ: trợ lý code bị hỏi "Tòa nhà Empire State Building cao bao nhiêu?" Phân loại an toàn phát hiện jailbreaks (khiến model bỏ qua giới hạn an toàn) và prompt injections (chèn lệnh độc hại vào đầu vào). Sự khác biệt quan trọng: trong jailbreak, người dùng cố gắng trực tiếp bỏ qua giới hạn model; trong prompt injection, kẻ tấn công gián tiếp thao túng hành vi model thông qua dữ liệu bên ngoài (nội dung web, tài liệu). Kiểm duyệt nội dung đánh dấu đầu vào có hại hoặc không phù hợp, chẳng hạn như nội dung bạo lực hoặc phân biệt đối xử. Bảo vệ dựa trên quy tắc áp dụng các biện pháp xác định—danh sách đen, giới hạn độ dài đầu vào, bộ lọc biểu thức chính quy—chống lại các mối đe dọa đã biết như SQL injection.
Phía thực thi xác thực tool calls. Cốt lõi là đánh giá rủi ro tool: dựa trên liệu thao tác có thể đảo ngược, cấp độ quyền và tác động tài chính, mỗi tool được gán một mức rủi ro (thấp/trung bình/cao). Các thao tác có nguy cơ cao yêu cầu đánh giá bổ sung hoặc xác nhận con người.
Phía đầu ra kiểm tra phản hồi trước khi nó được trả về cho người dùng. Bộ lọc PII kiểm tra đầu ra có chứa thông tin nhận dạng cá nhân (ví dụ: số CMND, số điện thoại) để ngăn chặn lộ không cần thiết; xác thực đầu ra đảm bảo phản hồi phù hợp với giá trị thương hiệu thông qua kiểm tra nội dung.
Lưu ý rằng một số cơ chế (ví dụ: lọc regex dựa trên quy tắc) có thể được sử dụng ở cả phía đầu vào và đầu ra; phân loại trên theo vị trí triển khai phổ biến nhất.
Một thực hành công nghiệp tiêu biểu của guardrails dựa trên phân loại là Constitutional Classifiers của Anthropic[^ch1-3]. Thiết kế của nó có ba yếu tố quan trọng. Thứ nhất, đào tạo dựa trên quy tắc: một "hiến pháp" được viết bằng ngôn ngữ tự nhiên—nêu rõ những gì được phép và không được phép—được sử dụng để tạo dữ liệu đào tạo tổng hợp cho các phân loại đầu vào và đầu ra. Thứ hai, phán đoán ngữ cảnh chung: thế hệ mới kiểm tra câu hỏi của người dùng và câu trả lời của model cùng nhau, vì một số câu trả lời trông hoàn toàn ổn khi đứng riêng (ví dụ: "cách sử dụng hương liệu thực phẩm"), và chỉ khi đặt cạnh câu hỏi mới rõ rằng "hương liệu thực phẩm" là mã cho thuốc thử hóa học. Thứ ba, sàng lọc hai giai đoạn: một probe cực nhẹ—đọc các activations nội bộ của model với chi phí gần bằng không—kiểm tra mọi cuộc trò chuyện trước, và bất kỳ điều gì đáng ngờ được chuyển lên một classifier mạnh hơn để xem xét thay vì bị từ chối ngay. Bằng cách này giai đoạn đầu có thể dung nạp nhiều false positive hơn mà không ảnh hưởng trải nghiệm người dùng, và tổng chi phí giảm đáng kể.
[^ch1-3]: Anthropic. "Next-generation Constitutional Classifiers: More efficient protection against universal jailbreaks", 2026. https://www.anthropic.com/research/next-generation-constitutional-classifiers; paper: Cunningham et al., "Constitutional Classifiers++: Efficient Production-Grade Defenses against Universal Jailbreaks", arXiv:2601.04603
Can thiệp của con người
Human-in-the-loop là biện pháp bảo vệ quan trọng: nó cho phép Agent cải thiện hiệu suất thế giới thực mà không làm giảm trải nghiệm người dùng. Nó quan trọng nhất trong giai đoạn triển khai ban đầu, khi nó giúp xác định chế độ thất bại, expose các trường hợp biên và thiết lập chu kỳ đánh giá mạnh mẽ.
Với cơ chế human-in-the-loop, Agent không thể hoàn thành tác vụ có thể chuyển giao quyền kiểm soát một cách duyên dáng. Trong dịch vụ khách hàng, điều này có nghĩa là chuyển lên đại diện con người; đối với Coding Agent, nó có nghĩa là chuyển quyền kiểm soát lại cho nhà phát triển.
Thường có hai tình huống chính kích hoạt can thiệp con người:
Vượt ngưỡng thất bại
Đặt giới hạn trên số lần thử lại và thao tác của Agent. Nếu Agent vượt quá những giới hạn đó, chuyển lên con người.
Thao tác có nguy cơ cao
Các thao tác nhạy cảm, không thể đảo ngược hoặc có nguy cơ cao nên kích hoạt giám sát con người—ít nhất cho đến khi đội đã xây dựng đủ niềm tin vào độ tin cậy của Agent. Các ví dụ điển hình bao gồm ủy quyền hoàn tiền lớn hoặc xử lý thanh toán.
Với năm yếu tố Harness trong đầu, phần còn lại của cuốn sách theo cấu trúc này.
Cuốn sách này như một hướng dẫn thực hành về Harness Engineering
Nhìn qua lăng kính của kỹ thuật Harness, mỗi chương của cuốn sách này xây dựng có hệ thống một thành phần của Harness. Bảo mật, trong khi đó, không thuộc về một chương riêng lẻ; nó là mối quan tâm xuyên suốt toàn bộ sách (một mối quan tâm xuyên suốt chạm vào nhiều phần của hệ thống cùng một lúc—cách ghi log, trong kỹ thuật phần mềm, phải đi qua mọi module). Bảng dưới đây trình bày các chức năng Harness, khía cạnh bảo mật và các chương tương ứng trong một cái nhìn duy nhất:
Trọng tâm Harness
Chương tương ứng
Nội dung cốt lõi
Mối quan ngại bảo mật
Thiết kế Context
Chương 2 (Context Engineering)
Prompt engineering, thanh trạng thái Agent, nén context, Agent Skills
Prompt injection và rò rỉ thông tin
Mở rộng Context (lưu trữ kiến thức)
Chương 3 (Knowledge Base)
User memory, RAG, structured indexing, agentic RAG
Lộ thông tin nhạy cảm, bảo vệ quyền riêng tư
Thiết kế Tool và ràng buộc bảo mật
Chương 4 (Tool Design)
Phân loại tool, kiểm soát quyền, tiêu chuẩn MCP, kiến trúc bất đồng bộ
Thao tác sai, truy cập trái phép, thao tác không thể đảo ngược
Xác minh và sửa chữa Tool
Chương 5 (Code Generation)
Harness của Coding Agent, test-driven development, quy tắc mã hóa
Mạo danh, phân bổ trách nhiệm
Xác minh cấp hệ thống
Chương 6 (Evaluation)
Môi trường đánh giá, bộ dữ liệu, đánh giá tự động, observability
—
Sửa chữa cấp Model
Chương 7 (Post-Training)
SFT (Supervised Fine-Tuning), Reinforcement Learning—mã hóa tín hiệu phản hồi tích lũy bởi Harness vào tham số model, như phần mở rộng của Harness engineering
Sai lệch mục tiêu, alignment và robustness
Sửa chữa cấp hệ thống
Chương 8 (Self-Evolution)
Học bên ngoài, tạo tool, tích lũy kinh nghiệm
—
Context và Tools đa phương thức
Chương 9 (Multimodal and Real-Time Interaction)
Voice Agent, Computer Use, robotic operation
Lọc bảo mật đầu vào đa phương thức, kiểm soát quyền trong tương tác thời gian thực
Ràng buộc và sửa chữa giữa nhiều Agent
Chương 10 (Multi-Agent Collaboration)
Kiến trúc cộng tác, chế độ thất bại, xã hội Agent
Vi phạm ranh giới tin cậy giữa các Agent, xung đột tài nguyên chia sẻ
Kinh nghiệm của Anthropic trong xây dựng các Agent chạy lâu cho thấy thiết kế Harness có thể giải quyết các vấn đề mà bản thân model không thể. Họ chia các tác vụ phức tạp giữa "Initialization Agent" (thiết lập môi trường, phân giải danh sách tác vụ) và "Execution Agent" (tiến bộ tăng dần mỗi phiên và để lại các sản phẩm bàn giao rõ ràng), sử dụng Harness có cấu trúc để giải quyết hai chế độ thất bại của tác vụ dài: hết context và tuyên bố tác vụ hoàn thành sớm. Các chương tiếp theo đi qua từng thành phần Harness—Chương 2 bắt đầu với thành phần trung tâm nhất, context engineering, và Chương 5 trình bày đầy đủ thực hành Harness Engineering trong Coding Agent.
Tóm tắt chương
Chương này đã xây dựng một framework lấy thực hành làm trọng tâm để hiểu và xây dựng AI Agent.
Agent = Reasoning Engine + Working Context + Action Interfaces: LLM cung cấp suy luận và ra quyết định, context cung cấp bộ thông tin làm việc sẵn có tại thời điểm ra quyết định, và tools cung cấp các giao diện hành động. Không thành phần nào trong ba thành phần có thể bỏ qua.
Mở rộng Context và Tools là đòn bẩy khả năng chính: Khi model được cố định, định nghĩa lại hoặc mở rộng observation và action spaces—tức là mở rộng context và tools—thường có thể biến một tác vụ không thể giải quyết thành có thể giải quyết trực tiếp. Sự tiến hóa từ Manus đến OpenClaw cho thấy phần lớn tính tổng quát đến từ việc mở rộng ranh giới giao diện; sự mở rộng đó phải theo yêu cầu và đi kèm với quyền và xác minh.
Context là yếu tố quyết định: Context bao gồm static prefix (system prompt + tool definitions) và dynamic trajectory (message history). Ablation cho thấy loại bỏ bất kỳ thành phần nào đều làm suy giảm hệ thống đáng kể. Bản chất của vòng lặp ReAct là thêm vào trajectory, lặp đi lặp lại, để model liên tục thúc đẩy tác vụ.
Harness là lợi thế cạnh tranh: Khả năng model đang được hàng hóa hóa; yếu tố phân biệt thực sự là Harness—các cơ chế constrain, verify và correct xây dựng xung quanh context và tools cho phép hoàn thành tác vụ đáng tin cậy. Trong hệ thống Agent cấp sản phẩm, phần lớn code Harness đi vào các biện pháp bảo vệ này, không chỉ context và tools.
Từ Workflow đến Autonomous Agent: Prompts trước, sau đó workflows, autonomous Agents cuối cùng—thứ tự đó là cách thực tế nhất để giảm hành vi không mong muốn. Mỗi mẫu orchestration có tình huống phù hợp; không mẫu nào tốt nhất ở mọi nơi.
Bảo mật là vấn đề kiến trúc: Guardrails, can thiệp human-in-the-loop, alignment (giữ cho hành vi model nhất quán với ý định con người)—bảo mật phải được thiết kế ngay từ dòng code đầu tiên, không phải vá trước khi ra mắt. Nó trải rộng năm cấp độ: model, context, tools, cộng tác và xã hội.
Chương tiếp theo kiểm tra sâu thành phần trung tâm nhất của Harness: context engineering. Chương 7 trình bày nguồn gốc học thuật của khái niệm Agent trong reinforcement learning và so sánh RL truyền thống với các LLM Agent hiện đại.
Các câu hỏi tư duy dưới đây được thiết kế để đưa các khái niệm cốt lõi của chương sâu hơn một cấp; chúng không có câu trả lời tiêu chuẩn.
Câu hỏi tư duy
★★ Nếu bạn chỉ có thể thêm một khả năng vào hệ thống Agent—một model mạnh hơn, context phong phú hơn, hoặc nhiều tools hơn—bạn sẽ chọn gì? Trong những điều kiện nào lựa chọn của bạn sẽ thay đổi?
★★★ Trong vòng lặp ReAct, các lần đọc cache tích lũy tăng khoảng bậc hai theo số vòng. Làm thế nào có thể giảm tốc tăng trưởng này?
★★ Paradigm "Model as Agent" có nghĩa là các model ngày càng tự chủ hơn trong quyết định tool-calling. Tuy nhiên, chương này lập luận rằng tầm quan trọng của Harness Engineering thực sự đang tăng. Hai xu hướng này có thể cùng tồn tại như thế nào? Giá trị cốt lõi tương lai của Agent frameworks nằm ở đâu?
★★ Trong thí nghiệm ablation, sự vắng mặt của "phản hồi kết quả tool" khiến Agent rơi vào vòng lặp vô hạn. Trong môi trường sản phẩm, ngoài thiếu kết quả tool, những tình huống nào có thể khiến Agent bị lặp? Bạn sẽ thiết kế cơ chế phát hiện và chấm dứt nào?
★ Chương này đã phân tích năm sản phẩm Agent theo ba chiều: working context, action interfaces và chiến lược. Chọn một sản phẩm AI bạn sử dụng hàng ngày, phân tích theo cùng ba chiều, và đánh giá liệu kiến trúc của nó có phù hợp không. Nếu bạn thiết kế, bạn sẽ cải thiện gì?
★★ Nếu bạn thiết kế hệ thống dịch vụ khách hàng chuyên đặt vé máy bay, bạn sẽ chọn mẫu workflow hay autonomous Agent? Có thể kết hợp cả hai mẫu trong cùng một hệ thống không?
★★★ Phần guardrails đề cập đến đánh giá rủi ro tool. Nếu một tool thường có nguy cơ thấp nhưng trở thành nguy cơ cao với tổ hợp tham số cụ thể (ví dụ: delete_file xóa file bình thường vs. xóa file hệ thống), bạn sẽ thiết kế đánh giá rủi ro động như thế nào?
★★ Trong bảng sản phẩm Agent trong chương này, tất cả Agent có action space "mở". Trong những kịch bản nào một action space bị giới hạn (ví dụ: chỉ có thể chọn từ các tùy chọn được xác định trước) sẽ tốt hơn một action space mở?
★★ Cơ chế can thiệp human-in-the-loop yêu cầu Agent "chuyển giao quyền kiểm soát duyên dáng." Tuy nhiên, trong thực tế, người dùng có thể offline, phản hồi chậm, hoặc đưa hướng dẫn mơ hồ. Agent nên làm gì trong những trường hợp như vậy?
★★★ Giới thiệu nói rằng "nguyên tắc thiết kế tốt nên vượt qua các chu kỳ lặp lại model," nhưng các phương pháp kỹ thuật cụ thể được sử dụng để triển khai những nguyên tắc đó có thể trở nên lỗi thời khi khả năng model cải thiện. Hãy cho một ví dụ về phương pháp kỹ thuật Agent như vậy và giải thích tại sao.