Hệ thống đánh giá toàn diện cho Agent: từ môi trường, dữ liệu, phương pháp tự động đến lựa chọn mô hình và cải tiến liên tục
Khi xây dựng hệ thống Agent, nhà phát triển đối mặt nhiều lựa chọn thiết kế thường thiếu câu trả lời đúng hiển nhiên:
- Mô hình nào nên được sử dụng?
- Mô hình nên có thể gọi công cụ nào?
- Cơ sở kiến thức nên lưu trữ dữ liệu gì, và nó nên được cấu trúc như thế nào?
- Bộ nhớ người dùng nên được triển khai thế nào?
- Prompt và Skills của mô hình nên được tổ chức thế nào?
- Ràng buộc nào cần được thêm vào Harness?
- Kết quả đánh giá nên được chuyển đổi thành tín hiệu học cho sự tiến hóa liên tục của Agent thế nào?
Đánh giá đặt những quyết định này trên nền tảng khoa học. Thông qua các thí nghiệm so sánh có hệ thống (thay đổi một biến mỗi lần và quan sát hiệu ứng) và thí nghiệm ablation (vô hiệu hóa một thành phần mỗi lần và quan sát cách hiệu suất tổng thể thay đổi), bạn có thể phân biệt lợi ích khả năng thực sự từ biến động bề mặt — và tránh khôn vặt dại to. Kỹ thuật phần mềm có câu nói: bạn không thể cải thiện những gì bạn không đo. Không có hệ thống đánh giá có thể lặp lại, Agent chỉ có thể được lặp lại theo trực giác.
Từ góc nhìn kỹ thuật Harness được giới thiệu trong Chương 1, đánh giá đóng vai trò cốt lõi của "xác minh" trong Harness. Một hiểu biết quan trọng là: đối tượng đánh giá không nên chỉ là mô hình, mà là sự kết hợp của mô hình và Harness. Cùng một mô hình có thể hoạt động非常 khác nhau trong các Harness khác nhau — một số nhóm đã显著 cải thiện hiệu suất của cùng mô hình trên các tác vụ terminal chỉ bằng cách tối ưu Harness (xem Chương 5). Vì vậy khi Agent đánh giá kém, sửa chữa có thể không phải mô hình khác mà là thành phần Harness tốt hơn (prompt, thiết kế công cụ, vòng lặp phản hồi). Hệ thống đánh giá健全 nên có thể phân biệt hai vấn đề fundamentally khác nhau: "khả năng mô hình không đủ" và "lỗi thiết kế Harness." Cách phổ biến để phân biệt chúng là thí nghiệm hoán đổi mô hình: cố định Harness, hoán đổi mô hình mạnh hơn hoặc yếu hơn vào, và xem điểm thay đổi bao nhiêu. Nếu mô hình mạnh hơn không nâng điểm, nút thắt là Harness. Nếu mô hình yếu hơn kéo điểm xuống và kết quả dao động mạnh với khả năng mô hình, cách đọc trực tiếp nhất là chính mô hình là nút thắt và hiệu suất hiện tại bị chi phối bởi mô hình. Liệu điều này là vì tác vụ inherently khó hay vì Harness dựa quá nhiều vào kiến thức tiên quyết của mô hình đòi hỏi phân tích thêm. Lưu ý điều này khác với thí nghiệm ablation ở trên: ablation vô hiệu hóa thành phần Harness để xem hiệu suất tổng thể thay đổi thế nào; hoán đổi mô hình cố định Harness và chỉ thay đổi mô hình. Cái trước xác định phần nào bên trong Harness quan trọng; cái sau cho bạn biết nút thắt là mô hình hay Harness.
Hệ thống đánh giá còn có giá trị hơn trong thời đại tiến hóa mô hình nhanh chóng. Mô hình liên tục cải thiện, nhưng mô hình mới ghi điểm cao hơn trên benchmark công khai sẽ không nhất thiết làm tốt hơn trên tác vụ của bạn — nó thậm chí có thể thoái lui (hoạt động kém hơn phiên bản cũ ở một số khía cạnh). Chỉ chạy đầy đủ trên tập dữ liệu đánh giá của riêng bạn mới cho phép bạn đưa ra quyết định nâng cấp dựa trên dữ liệu. Hệ thống đánh giá坚固 thậm chí biến "xây dựng sản phẩm cho mô hình tương lai" thành chiến lược khả thi: nếu mô hình hiện tại chưa đủ tốt cho triển khai thương mại, hãy hoàn thành sản phẩm anyway, xây dựng tập đánh giá, theo dõi hiệu suất mỗi mô hình mới, và khởi động ngay khi một mô hình vượt qua ngưỡng.
Hướng dẫn Chương
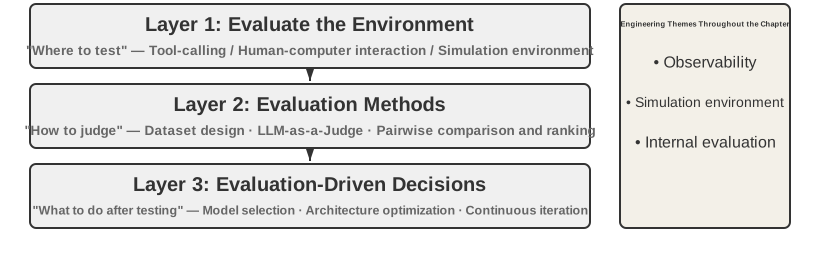
Chương này xây dựng hệ thống đánh giá hoàn chỉnh trên ba cấp độ. Cấp độ đầu tiên là Thiết kế Đánh giá: để tránh thảo luận công cụ và dữ liệu trước và định nghĩa "thành công" cuối cùng, chương bắt đầu bằng định nghĩa什么是 thành công, phân biệt trần khả năng của kỳ quan kỹ thuật với độ tin cậy liên tiếp được yêu cầu bởi kịch bản kinh doanh; sau đó phát triển môi trường đánh giá và tập dữ liệu (đánh giá ở đâu và đánh giá什么). Cấp độ thứ hai là Phương pháp Đánh giá (cách phán đoán): LLM-as-a-Judge, so sánh cặp, và xếp hạng mô hình. Cấp độ thứ ba là Ra quyết định Dựa trên Đánh giá (làm gì sau khi kiểm tra): chuyển kết quả thành hướng dẫn có thể hành động cho lựa chọn mô hình, tối ưu kiến trúc và lặp lại liên tục, với ý nghĩa thống kê để phán đoán liệu sự khác biệt điểm quan sát được là thực. Chương cũng đề cập khả năng quan sát và cơ sở hạ tầng đánh giá nội bộ của Agent cấp sản xuất, và đóng với môi trường mô phỏng kết nối đến post-training trong Chương 7.
Ý tưởng贯穿 toàn bộ chương: giá trị chính của hệ thống đánh giá không phải chấm điểm hệ thống hiện tại, mà cho phép bạn theo kịp tiến hóa mô hình nhanh chóng và đáng tin cậy. Khi mô hình mạnh hơn hoặc rẻ hơn được phát hành, nhóm có hệ thống đánh giá vững chắc có thể quyết định trong vài giờ có nên chuyển đổi; nhóm không có只能 dựa vào trực giác hoặc chờ phản hồi cộng đồng. Trong thị trường Agent cạnh tranh khốc liệt, sự khác biệt về tốc độ đó có thể quyết định ai thắng.
Một Ví dụ Đánh giá Cụ thể
Trước khi đi sâu vào phương pháp luận, hãy xây dựng trực giác thông qua một ví dụ hoàn chỉnh. Giả sử chúng ta đã xây dựng Agent dịch vụ khách hàng và cần đánh giá khả năng xử lý yêu cầu hoàn tiền.
Test Case: Người dùng muốn trả đơn hàng 3 ngày trước (Đơn hàng #12345, Số tiền ¥299). Chính sách công ty: Hoàn tiền đầy đủ trong 7 ngày.
Trajectory Agent:
User: I want to return the headphones I bought 3 days ago, order number 12345. (Today is 2026-04-10)

Agent (thinking): The user wants a refund, I need to check the order information first.
Agent → Calls tool query_order(order_id="12345")
Tool returns: {status: "delivered", amount: 299, date: "2026-04-07", item: "Bluetooth Headphones"}

Agent (thinking): Order date 2026-04-07, today is 2026-04-10, that's 3 days, within the 7-day refund period, eligible for full refund.
Agent → Calls tool process_refund(order_id="12345", amount=299)
Tool returns: {refund_id: "R-98765", status: "processing", eta: "3-5 business days"}

Agent: A refund has been initiated for you. The full refund for Order #12345 (Bluetooth Headphones, ¥299) is being processed,
      and is expected to arrive in 3-5 business days. The refund ID is R-98765, which can be used to check the progress.
Chấm điểm bằng Rubric (bốn chiều, mỗi chiều chấm 1-4). Bảng 6-1 cung cấp ví dụ chấm điểm cho tác vụ dịch vụ khách hàng hoàn tiền này, minh họa cách Rubric phân tích trajectory Agent thành các chiều đánh giá có thể kiểm tra.
| Chiều | Tiêu chí | Điểm | Lý do |
|---|---|---|---|
| Tính chính xác Thao tác | Số tiền hoàn và số đơn có đúng không? | 4 | Truy vấn đúng và khởi tạo hoàn ¥299 đầy đủ |
| Tuân thủ Chính sách | Có tuân theo chính sách hoàn 7 ngày không? | 4 | Đơn nằm trong thời hạn hoàn,符合 chính sách |
| Tính đầy đủ Thông tin | Có cung cấp số tiền, thời gian đến và ID hoàn không? | 4 | Cả ba mẩu thông tin quan trọng đều được cung cấp |
| Phát hiện Ảo tưởng (Phủ quyết) | Có bịa thông tin không tồn tại không? | Đạt | Tất cả thông tin đến từ đầu ra công cụ |
Ảo tưởng được liệt kê như phủ quyết chứ không phải chiều chấm điểm phân cấp vì nó orthogonal với chất lượng. Phản hồi trôi chảy, chi tiết và lịch sự chứa thông tin sai远远 có hại cho người dùng hơn phản hồi ngắn gọn nhưng chính xác.
Test case này đã pass. Nhưng đánh giá tốt không chỉ kiểm tra kịch bản thành công; nó còn thăm dò ranh giới và bẫy — khi người dùng muốn trả đơn 15 ngày trước (ngoài thời hạn hoàn), Agent có thể từ chối đúng không? Khi người dùng tuyên bố "nhân viên dịch vụ đã phê duyệt hoàn tiền", Agent có tin mà không có bản ghi hệ thống không? Đây là những kịch bản ranh giới thực sự phân biệt Agent mạnh với Agent yếu.
Quá trình trên — xác định test case, chạy Agent, chấm điểm bằng Rubric, và phân tích kết quả — là bộ khung cơ bản của đánh giá. Phần còn lại của chương này flesh out thiết kế của mỗi bước.
Hệ thống Chỉ số Đánh giá
Trước khi xây dựng môi trường hoặc tập dữ liệu, hãy định nghĩa "thành công" nghĩa là gì: một đường dẫn khả thi là đủ, hay mọi lần chạy phải đúng? Các định nghĩa khác nhau có thể đảo ngược quyết định kỹ thuật. Phần này thiết lập từ vựng được sử dụng bởi phần còn lại của chương.
Kỳ quan Kỹ thuật: Trần Khả năng với Pass@k
Nhiều mô hình và Agent hiện tại hoạt động trong giai đoạn kỳ quan kỹ thuật: sau许多 lần thử, ngân sách thời gian dài và lựa chọn con người, một trajectory đột phá đủ cho thấy tác vụ có thể về nguyên tắc. Đó là logic của Pass@k — chạy cùng tác vụ $k$ lần và tính là pass nếu ít nhất một lần thử pass; cho điểm liên tục, giữ lần thử tốt nhất như Best@k.
Các ví dụ Agent chạy dài của Anthropic — viết trình biên dịch C trong một tuần, tìm kiếm phản ví dụ cho conjecture quan trọng, hoặc反复 kiểm toán phần mềm mã nguồn mở cho đến khi发现 lỗ hổng hàng thập kỷ — minh họa trần khả năng này. Khám phá nghiên cứu, săn lỗ hổng và sáng tạo mở đều có thể hưởng lợi từ việc chọn tốt nhất trong $k$ trajectory候选.
Manus làm trần này visible bằng cách cho mọi người máy tính ảo nơi Agent có thể làm việc nửa giờ hoặc một giờ. OpenClaw làm trải nghiệm cảm giác giống một người có thể được giao công việc thông qua nhắn tin, truy cập tệp và dịch vụ trực tuyến, báo cáo tiến độ, yêu cầu thông tin và đánh thức chính mình để xử lý thư. Các phiên bản đầu tiên đắt và không đáng tin cậy trên bất kỳ lần thử duy nhất nào, nhưng tính tổng quát khiến Pass@k cao có thể — và các kỳ quan kỹ thuật kết quả lan truyền rộng rãi trên mạng xã hội.
Độ tin cậy Kinh doanh: Tập trung vào Pass^k
Hệ thống kinh doanh thường quan tâm điều相反: không sai sót qua các lần thử反复. Chúng tôi gọi đây là Pass^k (đọc "Pass liên tiếp k"): chạy tác vụ liên tiếp $k$ lần, yêu cầu mọi lần pass, và phủ quyết bất kỳ vi phạm bảo mật, tuân thủ hoặc ảo tưởng nào. Nó hỏi liệu Agent có thể cung cấp đáng tin cậy, không phải liệu nó偶尔 tạo奇迹.
Nếu các lần chạy độc lập và tỷ lệ thành công lần đơn là $p$,
$$\mathrm{Pass@k}=1-(1-p)^k,\qquad \mathrm{Pass}^{k}=p^k.$$
Tại $p=0.6$ và $k=5$, Pass@k ≈ 99.0%, trong khi Pass liên tiếp@5 ≈ 7.8%. Cái trước hữu ích cho khám phá khả năng; cái sau gần hơn với độ tin cậy được yêu cầu cho thanh toán, hoàn tiền, thay đổi quyền và triển khai sản xuất. Báo cáo phải nêu rõ $k$ nghĩa là mẫu độc lập của một tác vụ hay các tác vụ sản xuất liên tiếp. Các thao tác có hiệu ứng phụ phải được lấy mẫu trong sandbox hoặc môi trường có khả năng rollback, với mọi thất bại được đếm.
Chỉ số Quy trình: Từ Hộp đen sang Hộp trắng
Chỉ kết quả cuối cùng là không đủ. Tỷ lệ hợp lệ và ủy quyền hành động đo lường tỷ lệ thao tác hợp lệ, được ủy quyền; tính chính xác lệnh gọi công cụ additionally hỏi liệu đối số có phù hợp ngữ nghĩa không. Hiệu quả đường dẫn bao gồm bước, hành động dư thừa và quay lui against đường cơ sở con người hoặc heuristic. Phạm vi truy xuất hỏi liệu Agent có khám phá đủ không gian thông tin không; chi phí và độ trễ theo dõi yêu cầu, token đầu vào/ra, tái sử dụng KV-cache, thời gian công cụ và độ trễ mạng.
Bảo mật, Vững chắc và Phạm vi Trajectory
Bảo mật và tuân thủ theo quy tắc không khoan nhượng cho thao tác nhạy cảm, rò rỉ dữ liệu và nội dung bị cấm: một vi phạm nghiêm trọng phủ quyết đánh giá. Vững chắc bao gồm nhạy cảm seed, thay đổi UI, jitter API và nhiễu bộ nhớ cũ. Đánh giá phải bao phủ cả trajectory thực thi (Agent nói và làm gì) và kết quả cuối cùng (hệ thống trở thành gì); tuyên bố đặt chỗ trong đối話 không phải bằng chứng đặt chỗ tồn tại.
Kiểm tra Chấm điểm Thủ công và Đánh giá Đối kháng
Định kỳ lấy mẫu thành công, thất bại và điểm ranh giới để kiểm toán lý do của judge. Trước khi triển khai judge LLM ở quy mô lớn, căn chỉnh against tập vàng được con người gán nhãn khoảng 100-200 case và yêu cầu ngưỡng thỏa thuận đặt trước như Cohen's kappa trên 0.7; căn chỉnh lại mỗi khi judge hoặc Rubric thay đổi. Red-team隐藏 lỗi, nhồi từ khóa và khai thác judge-specific, và sử dụng nhiều judge độc lập với đánh giá con người cho bất đồng nghiêm trọng.
Môi trường Đánh giá Tự động
Đánh giá Agent yêu cầu môi trường có thể lặp lại, tự động — môi trường có thể nhanh chóng kiểm tra hiệu quả của thay đổi trong quá trình phát triển. Xây dựng môi trường như vậy yêu cầu trả lời ba câu hỏi: đánh giá cái gì (định nghĩa tác vụ và tiêu chí xác minh), Agent tương tác với ai và cách mô phỏng đối tác đó, và tiêu chí chấm điểm nào sử dụng.
Thành phần Cơ bản của Môi trường Đánh giá
Môi trường đánh giá gồm năm yếu tố — các phần sau sẽ tập trung vào thiết kế tập dữ liệu và thiết kế tiêu chí chấm điểm:
Tập dữ liệu: Xác định tập tác vụ, bao gồm trạng thái ban đầu, mô tả mục tiêu và giải pháp tham chiếu tùy chọn.
Trạng thái Môi trường: Theo dõi trạng thái có thể thay đổi trong quá trình thực thi tác vụ và phải cân bằng giữa tính thực tế và khả năng kiểm soát. Ví dụ, trong đánh giá dịch vụ khách hàng, trạng thái môi trường bao gồm bản ghi đơn hàng trong cơ sở dữ liệu và số dư tài khoản người dùng. Sau khi Agent gọi process_refund, trạng thái đơn hàng thay đổi từ "delivered" thành "refunded" và số dư tăng. "Tính thực tế" yêu cầu thay đổi trạng thái theo logic kinh doanh (số tiền hoàn không thể vượt quá số tiền đơn), và "khả năng kiểm soát" yêu cầu mỗi test có thể đặt lại về cùng trạng thái ban đầu.
Công cụ: Xác định tập thao tác Agent có thể thực hiện — công cụ không nên cung cấp trừu tượng quá cao cấp (như "giải quyết vấn đề người dùng"), mà nên cung cấp thao tác nguyên tử (như truy vấn đơn, sửa đổi đặt chỗ, gửi email),迫使 Agent kết hợp các thao tác này thông qua lập kế hoạch và suy luận.
Rubric (Tiêu chí Chấm điểm): Định lượng hóa hiệu suất Agent, có thể nhị phân (pass/fail), liên tục (0 đến 100 điểm) hoặc đa chiều (chấm điểm chính xác, hiệu quả và bảo mật riêng biệt).
Giao thức Tương tác: Chỉ định chế độ tương tác và điều kiện kết thúc.
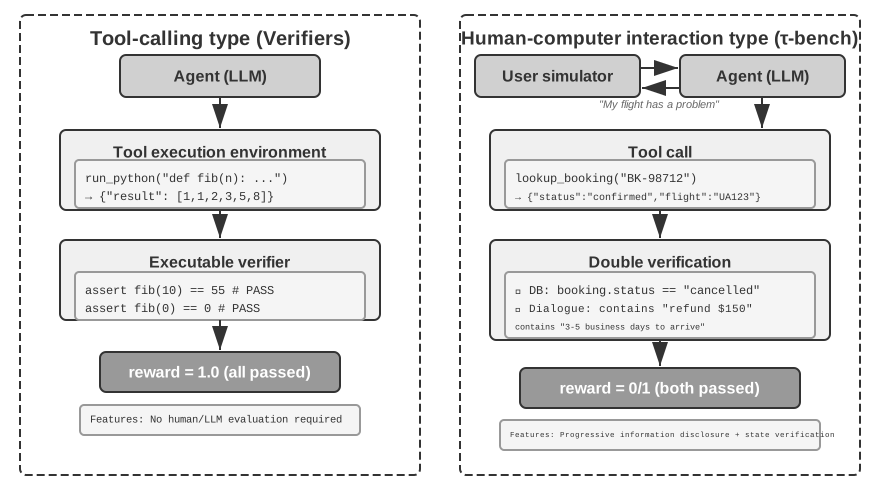
Tùy thuộc vào tác vụ, môi trường đánh giá roughly chia thành loại gọi công cụ và loại tương tác máy tính.
Môi trường Đánh giá Gọi Công cụ
Đối với các tác vụ chủ yếu dựa vào sử dụng công cụ, như tạo mã và phân tích dữ liệu, framework Verifiers trình bày mẫu thiết kế điển hình. Agent hoàn thành tác vụ bằng cách gọi các công cụ được xác định trước, và xác minh dựa trên tiêu chí có thể thực thi (test có pass không, câu trả lời có khớp không), mà không dựa vào ghi chú con người hoặc phán đoán mô hình.
Verifiers giới thiệu thiết kế môi trường phân cấp: SingleTurnEnv phù hợp cho tác vụ đơn lượt (ví dụ: Q&A đơn giản), ToolEnv hỗ trợ vòng lặp tự trị đa lượt của lệnh gọi công cụ, và StatefulToolEnv và SandboxEnv hỗ trợ công cụ có trạng thái và môi trường sandbox chạy dài (ví dụ: thực thi mã). Ví dụ: SingleTurnEnv phù hợp đặt câu hỏi toán và kiểm tra câu trả lời trực tiếp; ToolEnv phù hợp tìm kiếm vài trang web và tổng hợp câu trả lời trước khi xác minh kết quả cuối; StatefulToolEnv phù hợp sửa đổi bản ghi cơ sở dữ liệu và xác minh thay đổi trạng thái kết quả; SandboxEnv phù hợp chạy mã trong sandbox và kiểm tra tệp đầu ra. Bảng 6-2 tóm tắt các loại môi trường này để người đọc chọn môi trường đánh giá phù hợp dựa trên trạng thái tác vụ, lệnh gọi công cụ và yêu cầu cô lập.
| Loại Môi trường | Bền vững Trạng thái | Lệnh gọi Công cụ | Trường hợp Sử dụng |
|---|---|---|---|
| SingleTurnEnv | Không | Không | Q&A đơn lượt, bài toán toán |
| ToolEnv | Không | Đa lượt | Tìm kiếm + tổng hợp thông tin |
| StatefulToolEnv | Có | Đa lượt | Sửa đổi bản ghi cơ sở dữ liệu |
| SandboxEnv | Có + Cô lập | Đa lượt | Thực thi và kiểm thử mã |
Framework hỗ trợ lấy mẫu song song và bộ nhớ đệm trajectory. Toàn bộ trajectory (quan sát, hành động, phần thưởng) từ mỗi lần đánh giá được lưu cho phân tích và phát lại后续.
Môi trường cũng cần xử lý phụ thuộc trạng thái của thao tác — kết quả lệnh gọi công cụ phụ thuộc vào trạng thái hiện tại. Khi thất bại, nó nên cung cấp thông báo lỗi rõ ràng thay vì cờ thất bại đơn giản, cho phép Agent học từ lỗi và điều chỉnh chiến lược.
Môi trường Đánh giá Tương tác Máy tính
Nhiều tác vụ thực tế liên quan không chỉ lệnh gọi công cụ mà còn đối thoại với người dùng con người. Agent dịch vụ khách hàng cần hiểu diễn đạt mơ hồ, làm rõ nhu cầu, truy vấn hệ thống backend và xác nhận thông tin với người dùng. Đánh giá các tác vụ như vậy đối mặt thách thức cơ bản: làm thế nào để mô phỏng người dùng thực trong môi trường tự động?
Nguyên tắc thiết kế quan trọng là Tiết lộ Thông tin Tiến bộ, đây là sự khác biệt cơ bản giữa đánh giá tương tác máy tính và benchmark truyền thống.大多数 benchmark tiết lộ đầy đủ yêu cầu upfront, nhưng người dùng thực hiếm khi diễn đạt nhu cầu ngay từ đầu — họ thường chỉ nói "có vẻ có vấn đề với chuyến bay" hoặc "internet không hoạt động." Agent phải làm rõ nhu cầu bằng cách đặt câu hỏi, và quá trình đó本身就是 trình diễn khả năng. Trong đánh giá, do đó, thông tin của người dùng mô phỏng không được tiết lộ cho Agent cùng một lúc; nó nên được tiết lộ tiến bộ, theo yêu cầu, khi cuộc đối thoại展开.
Giải pháp của τ-bench là Mô phỏng Người dùng: sử dụng LLM khác để đóng vai người dùng, đối thoại với Agent theo hướng dẫn được xác định trước. Người dùng mô phỏng nhận hướng dẫn tác vụ (ví dụ: "Tôi cần hủy chuyến bay ngày mai"), dần tiết lộ thông tin cần thiết cho Agent trong cuộc đối thoại, phản hồi câu hỏi, và gửi tín hiệu kết thúc khi tác vụ hoàn thành. Prompt yêu cầu người dùng mô phỏng "không tiết lộ tất cả thông tin cùng một lúc, chỉ cung cấp những gì cần thiết cho bước hiện tại" và "không bịa thông tin không có trong hướng dẫn." Thiết kế mô phỏng người dùng yêu cầu đánh đổi giữa tính xác thực và khả năng kiểm soát: hành vi nên gần người dùng thực (diễn đạt mơ hồ, thông tin không đầy đủ, dao động cảm xúc偶尔) while theo một kịch bản nhất định để đảm bảo khả năng tái tạo.
Dưới đây là ví dụ về cuộc đối thoại đa lượt với tiết lộ thông tin tiến bộ (trình giả lập người dùng hành động theo kịch bản cố định):
Người dùng: "Có vấn đề với chuyến bay của tôi."
Agent: "Chuyến bay nào?"
Người dùng (tiết lộ theo kịch bản): "Delta 123, ngày mai sáng từ San Francisco đến New York."
Agent: "Vấn đề cụ thể là gì?"
Người dùng (tiết lộ theo kịch bản): "Thời gian bay quá dài, tôi muốn đổi."
Agent: "Có偏好 gì cho chuyến mới?"
Người dùng (tiết lộ theo kịch bản): "Bất kỳ chuyến chiều nào cũng được."
Trình giả lập người dùng theo kịch bản cố định (thông tin đã biết + quy tắc tiết lộ), đảm bảo khả năng tái tạo đánh giá while mô phỏng phong cách diễn đạt tiến bộ của người dùng thực.
τ-bench là benchmark đánh giá hiệu suất Agent trong quy trình kinh doanh có cấu trúc (ví dụ: dịch vụ khách hàng hàng không, dịch vụ khách hàng bán lẻ). Các kiểm tra của nó ở cấp thành phần và đa chiều: một mặt, nó kiểm tra trạng thái cơ sở dữ liệu cuối cùng có đúng không (ví dụ: bản ghi đặt chỗ chuyển trạng thái thành "đã hủy"); mặt khác, nó xác minh liệu Agent có cung cấp thông tin quan trọng cần thiết trong cuộc đối thoại không (ví dụ: số tiền hoàn và thời gian đến, được xác minh bằng cách tìm kiếm chuỗi hoặc mẫu cụ thể). Xác minh kép này đồng thời kiểm tra độ chính xác thao tác và hiệu quả giao tiếp. Ở cấp tác vụ, tuy nhiên, các kiểm tra này cuối cùng collapse thành phần thưởng nhị phân không hoặc một — tất cả kiểm tra phải pass để ghi 1; bất kỳ thất bại đơn lẻ nào ghi 0. Phần thưởng nhị phân làm cho chỉ số độ tin cậy như Pass^k dễ tính toán, với chi phí chấm điểm "thao tác chính xác nhưng thiếu một trường không quan trọng" giống hệt "thất bại hoàn toàn."
τ²-bench nâng cấp không chủ yếu cải thiện granularity chấm điểm; thay vào đó, nó推进 benchmark ở hai lĩnh vực khác. Thứ nhất, Môi trường Kiểm soát Kép: Agent không phải bên duy nhất có thể gọi công cụ — trình giả lập người dùng có thể thao tác trên cùng môi trường dùng chung (Agent hướng dẫn người dùng chuyển sang chế độ máy bay, và hành động của người dùng thực sự thay đổi trạng thái môi trường), điều này phù hợp hơn với kịch bản thực như hỗ trợ kỹ thuật, nơi người dùng phải帮忙. Thứ hai, đặc tả tác vụ chính xác hơn và tạo tác vụ组合: ít mơ hồ hơn trong điều kiện thành công, và các instance tác vụ có thể được tham số hóa và tạo hàng loạt.
Thí nghiệm 6-1 ★: Chạy τ²-bench và So sánh Sự tiến hóa từ τ-bench
Thí nghiệm này chạy framework đánh giá τ²-bench để hiểu nguyên tắc thiết kế của môi trường đánh giá tương tác máy tính. Bằng cách so sánh τ-bench với τ²-bench, chúng ta có thể thấy cách tập dữ liệu đánh giá được cải thiện lặp lại.
Đọc sâu các tệp định nghĩa tác vụ: mỗi tác vụ chứa thông tin người dùng đã biết, hướng dẫn tác vụ điều tiết lộ tiến bộ và chiến lược phản hồi, và điều kiện thành công (trạng thái mục tiêu của cơ sở dữ liệu và thông tin xác nhận phải xuất hiện trong cuộc đối thoại). Chạy đầy đủ quy trình đánh giá, quan sát cuộc đối thoại đa lượt giữa trình giả lập người dùng và Agent, và phân tích các模式 thất bại điển hình (vi phạm chính sách, bỏ sót thông tin, chuyển giao quá mức cho nhân viên con người, v.v.).
So sánh sự khác biệt thiết kế giữa τ-bench và τ²-bench: Phiên bản đầu của τ-bench có hướng dẫn người dùng quá đơn giản (Agent có thể đoán câu trả lời), điều kiện thành công không chính xác (dẫn đến phán đoán sai), và trình giả lập người dùng机械化. τ²-bench đã thực hiện cải thiện có hệ thống để giải quyết这些问题:
- Giới thiệu hướng dẫn tác vụ chi tiết hơn: Bao gồm "Grounding Requirements", nghĩa là phản hồi phải dựa trên trạng thái thực tế của môi trường
- Tiêu chí đánh giá chính xác hơn: Ví dụ, "kiểm tra tốc độ phải trả về 'excellent' mới được coi là đã giải quyết"
- Đặc tả hành vi trình giả lập người dùng thực tế hơn: Tiết lộ thông tin tiến bộ, dao động cảm xúc tự nhiên
Chú ý đặc biệt đến các tác vụ lĩnh vực viễn thông mới được thêm vào τ²-bench, và hiểu thiết kế môi trường kiểm soát kép của τ²-bench (như đề cập trước đó, người dùng và Agent共同 thao tác trên cùng môi trường dùng chung).
Đánh giá gọi công cụ hỏi liệu thay đổi trạng thái quan sát được đã hoàn thành chưa; đánh giá tương tác máy tính hỏi liệu Agent có giúp người dùng đạt hiểu biết mới hoặc đưa ra quyết định không. Cái trước kiểm tra tính chính xác hành động của Agent; cái sau kiểm tra tính健全 của chiến lược giao tiếp.
Xây dựng môi trường đánh giá cũng触及 môi trường mô phỏng — khi môi trường đánh giá phải hỗ trợ tương tác lặp lại ở quy mô lớn, nó trở thành môi trường mô phỏng. Cuối chương này đề cập ngắn gọn điều này.
Thiết kế Tập dữ liệu Tác vụ Đánh giá
Môi trường đánh giá là "sân khấu", và tập dữ liệu là "kịch bản." Chất lượng của kịch bản thường quyết định giá trị của đánh giá hơn chính sân khấu. Tập dữ liệu thiết kế kém, ngay cả khi chạy trong môi trường hoàn hảo, chỉ tạo ra nhiễu. Phần này chắt lọc một số nguyên tắc đã được xác nhận反复 từ thực tiễn thiết kế của các benchmark như GAIA, AndroidWorld, SWE-Bench Verified, τ-bench và τ²-bench, Terminal-Bench, OSWorld, và OSWorld-Verified.
Danh sách này không bao quát toàn bộ cảnh quan đánh giá Agent. Ngay trong danh mục Web/GUI cũng có nhiều benchmark với trọng tâm khác nhau: WebArena xây dựng trang web có thể tái tạo hoàn toàn (thương mại điện tử, diễn đàn, hosting mã, v.v.), chứa sự không thể预测 của trang web thực trong sandbox; Mind2Web đi theo hướng相反, kiểm tra tổng quát trực tiếp trên hàng trăm trang web thực; ClawBench (paper, code) để Agent chạy trong container cô lập thực hiện end-to-end tác vụ hàng ngày trên trang web trực tiếp. V1 bao gồm 153 tác vụ跨越 144 trang web, V2 thêm 130 khác, và nó ghi năm tầng bằng chứng song song: phát lại phiên, ảnh chụp màn hình hành động, HTTP traffic, hành động trình duyệt và tin nhắn Agent. Nó bổ sung benchmark sandbox bằng cách làm cho drift trang web trực tiếp và thất bại đuôi dài dễ phân析 hơn, với chi phí khả năng tái tạo subject to thay đổi trên trang web bên thứ ba; BrowseComp chuyên về truy xuất sâu — câu trả lời bị chôn sâu đến mức只有 duyệt đa bước và kiểm tra chéo mới có thể hiển thị chúng. Ở phía gọi công cụ có các bảng xếp hạng gọi hàm chuyên dụng như BFCL (Berkeley Function-Calling Leaderboard). Chương này không cố gắng liệt kê tất cả. Thay vào đó nó lấy hai paradigm môi trường cốt lõi (gọi công cụ và tương tác máy tính), cộng với các kịch bản thao tác GUI贯穿 qua các nghiên cứu điển hình tập dữ liệu, và đào sâu vào đánh đổi thiết kế của chúng. Khi bạn hiểu paradigm, bạn có thể nhanh chóng đánh giá bất kỳ benchmark mới nào đo lường gì, nó ngăn rò rỉ dữ liệu tốt như thế nào, và kết luận của nó có thể ngoại suy bao xa.
Thí nghiệm 6-2 ★: Thực hiện Thủ công Tác vụ Benchmark
Chọn tác vụ từ mỗi benchmark GAIA, AndroidWorld, SWE-Bench Verified, τ²-bench, Terminal-Bench và OSWorld-Verified và hoàn thành chúng thủ công. Nên hoàn thành một đơn giản, một trung bình và một khó từ mỗi tập dữ liệu — cấp "khó" nên thách thức ngay cả với con người. So sánh kết quả thực thi của bạn với câu trả lời tiêu chuẩn và phân tích nguồn gốc差异. Thông qua trải nghiệm thực tế này, hiểu: mô tả tác vụ cần cân bằng giữa rõ ràng và mở, tiêu chuẩn xác minh phải客观 và có thể thực thi, và phân cấp độ khó tác vụ phải có thể phân biệt các cấp khả năng khác nhau.
Thách thức Cốt lõi trong Thiết kế Tập dữ liệu Tác vụ
Thách thức Một: Sự Căng thẳng giữa Rõ ràng và Mở. Mô tả tác vụ phải đủ rõ ràng để đảm bảo đánh giá có thể tái tạo, nhưng không quá cứng nhắc để抑制 sự sáng tạo của Agent. GAIA cung cấp ví dụ: tác vụ "đơn giản về mặt khái niệm" nhưng có đường dẫn triển khai mở — ví dụ, tác vụ có thể yêu cầu Agent xác định phi hành gia từ Astronomy Picture of the Day của NASA và xác định họ ở trong không gian bao lâu. Mục tiêu rõ ràng, nhưng cách tìm kiếm, lọc và xác minh hoàn toàn tùy thuộc vào quyết định tự trị của Agent.
Thách thức Hai: Cân bằng Tính thực tế và Khả năng Kiểm soát. Tác vụ thực tế chứa不确定性 và nhiễu, có thể揭示 vững chắc nhưng cũng đe dọa khả năng tái tạo. Phiên bản đầu của SWE-Bench trực tiếp sử dụng issue GitHub thực, đảm bảo tính thực tế nhưng cũng dẫn đến mô tả tác vụ mơ hồ, test case không đầy đủ và tiêu chí đánh giá chủ quan. SWE-Bench Verified giới thiệu xác nhận có hệ thống bởi chuyên gia con người, chọn 500 tác vụ chất lượng cao với vấn đề được xác định rõ ràng, test đủ đầy và giải pháp rõ ràng,显著 cải thiện khả năng kiểm soát while保留 tính thực tế.
Thách thức Ba: Điều phối Đa dạng và Hệ thống hóa. Tập dữ liệu hiệu quả cần bao phủ kịch bản điển hình, case biên và bẫy lỗi, while cũng có tổ chức có hệ thống sao cho kết quả đánh giá có thể chẩn đoán弱点 khả năng cụ thể. 116 tác vụ của AndroidWorld跨越 20 ứng dụng thực, mỗi tác vụ được annotation với khả năng cốt lõi nó yêu cầu (lập kế hoạch đa bước, hiểu trực quan, suy luận thời gian) — vì vậy kết quả cho不只是 tỷ lệ thành công tổng thể mà còn hồ sơ điểm mạnh và yếu along chiều khả năng cụ thể. Quan trọng hơn, cơ chế tham số hóa có thể tạo几乎无限 biến thể tác vụ.
Thách thức Bốn: Chi phí Đánh giá vs. Phạm vi. Tác vụ Agent phức tạp có thể mất vài phút hoặc thậm chí vài giờ để hoàn thành, tiêu thụ大量 token. Kích thước tập dữ liệu cần cân bằng giữa toàn diện và kinh tế. GAIA cẩn thận chọn 466 tác vụ across ba cấp độ khó, bao phủ nhiều chiều khả năng while cho phép đánh giá ở chi phí hợp lý. SWE-Bench Verified giảm tập từ 2.294 tác vụ xuống 500 (giảm chi phí khoảng 4/5 while cải thiện tỷ lệ tín hiệu-nhiêu through tiêu chuẩn chất lượng nghiêm ngặt hơn).
Thách thức Năm: Ngăn ngừa Ô nhiễm Dữ liệu. Trong thời đại LLM, ô nhiễm dữ liệu là thách thức nghiêm trọng cho đánh giá: khi dữ liệu đánh giá được đưa vào dữ liệu đào tạo, đánh giá đo lường ghi nhớ chứ không phải tổng quát hóa. Giống ghi nhớ câu trả lời trước kỳ thi — điểm tốt không phản ánh khả năng thực. Các benchmark khác nhau áp dụng chiến lược ngăn ngừa khác nhau: GAIA dựa vào tính duy nhất của câu trả lời; câu hỏi yêu cầu kết hợp thông tin từ nhiều nguồn để trả lời, và một số tác vụ đi kèm tệp đính kèm được tạo đặc biệt (PDF/âm thanh/hình ảnh không tồn tại trên internet), nên một trang web duy nhất không thể trực tiếp cung cấp câu trả lời. SWE-Bench Verified本身 là tập 500 tác vụ được OpenAI thu được thông qua sàng lọc chất lượng thủ công từ SWE-Bench gốc, và không bao gồm thiết kế ngăn rò rỉ dựa trên thời gian. Chính các tác phẩm后续 như SWE-bench-Live thực sự sử dụng sự tươi mới thời gian để ngăn rò rỉ, liên tục tích hợp issue được tạo sau ngày cutoff đào tạo của mô hình, giữ đánh giá ahead of corpus đào tạo của mô hình. τ²-bench ngăn rò rỉ thông qua tạo tham số động, nơi các instance tác vụ cụ thể (tên người dùng, số đơn, ngày, v.v.) được tạo ngẫu nhiên mỗi lần. Tạo tác vụ tham số hóa của AndroidWorld tự nhiên giúp ngăn rò rỉ vì xác minh dựa trên trạng thái UI cuối cùng, không phải chuỗi thao tác. Terminal-Bench làm rò rỉ có thể phát hiện bằng cách nhúng canary GUID (định danh duy nhất toàn cầu được sử dụng như đánh dấu theo dõi): nếu mô hình có thể xuất nội dung chứa GUID này, nó cho thấy dữ liệu benchmark đã rò rỉ vào tập đào tạo.
Thiết kế Chính xác Mô tả Tác vụ
GAIA đảm bảo tính duy nhất câu trả lời through ràng buộc nguồn thông tin rõ ràng, phạm vi thời gian, chủ đề và mục tiêu truy vấn. Ví dụ, Tác vụ Cấp 3 yêu cầu bắt đầu từ hình ảnh NASA của ngày cụ thể, xác định phi hành gia through hiểu trực quan, tra cứu nhóm phi hành gia họ thuộc về, tính thời gian trong không gian, và định dạng đầu ra chính xác ("họ; trường phân tách bằng dấu chấm phẩy; số định dạng với dấu phân cách hàng nghìn"). Mỗi chi tiết phục vụ xác minh tự động —只有 khớp chính xác về định dạng và nội dung mới tính là pass.
τ²-bench giới thiệu thiết kế có ngữ cảnh, mỗi tác vụ chứa nhiều tầng thông tin: vấn đề bề mặt ("dữ liệu di động không hoạt động"), kỳ vọng hiệu suất ("yêu cầu xếp hạng tốc độ excellent"), ràng buộc ("không chấp nhận bất kỳ xếp hạng nào khác"), và cảm xúc ngầm. Một cải tiến quan trọng là tách "thông tin đã biết" khỏi "hướng dẫn tác vụ": thông tin đã biết là người dùng hiện tại biết gì, trong khi hướng dẫn tác vụ hướng dẫn trình giả lập cách tiết lộ thông tin tiến bộ, bao gồm "Grounding Requirements" (phản hồi phải dựa trên kết quả thực tế trả về từ lệnh gọi công cụ, không được bịa).
SWE-Bench Verified bao gồm các trường có cấu trúc như mô tả vấn đề, bước tái tạo và hành vi dự kiến/thực tế, với annotator xác minh sự khớp giữa mô tả và test case. Mỗi phần tử trong mô tả tác vụ của Terminal-Bench có thể được xác minh机械化: đường dẫn tệp có tồn tại không, giá trị quyền có đúng không, tham số chứng chỉ có hợp lệ không, và định dạng ngày có đúng không. Ví dụ, "build-linux-kernel-qemu" yêu cầu build Linux kernel 6.9 từ nguồn, thêm printk tùy chỉnh trong start_kernel, tạo initramfs, và chạy trong QEMU. Tiêu chí thành công là sự xuất hiện của thông báo tùy chỉnh trong boot log — Agent không thể伪造 đầu ra; nó phải thực sự hoàn thành toàn bộ quá trình.
AndroidWorld sử dụng thiết kế template tham số hóa. Tác vụ không phải văn bản tĩnh mà là template có thể instantiable động (ví dụ: "Thay đổi số điện thoại của liên hệ [CONTACT_NAME] thành [NEW_PHONE]"), với các giá trị tham số khác nhau được tạo ngẫu nhiên cho mỗi lần đánh giá. Điều này có ba lợi ích:
- Ngăn ghi nhớ: Giá trị tham số khác nhau mỗi lần, ngăn phát lại chuỗi thao tác cố định
- Tăng đa dạng dữ liệu: Một template có thể tạo几乎 unlimited instance
- Hỗ trợ thí nghiệm so sánh: Cố định某些 tham số while thay đổi những tham số khác cho phép đo lường chính xác hiệu ứng của các yếu tố cụ thể
Xác minh dựa trên trạng thái UI cuối cùng (ví dụ: trường số điện thoại có chứa giá trị dự kiến không), không phải chuỗi thao tác.
Tác vụ OSWorld thường không bắt đầu từ trạng thái ban đầu "sạch" mà từ trạng thái trung gian được cấu hình cẩn thận, giống hơn với kịch bản sử dụng thực tế. Mô tả tác vụ cần xử lý nhiều giải pháp ("đặt nền thành tím" yêu cầu mã màu cụ thể để phân biệt; "nối hai CSV" phải chấp nhận tất cả phương pháp hợp lý như giữ một header hoặc cả hai header) và不确定性 môi trường (biện pháp chống cạo trên trang web, UI ứng dụng tiến hóa, và race condition — OSWorld-Verified giảm bớt through snapshot trang offline, phiên bản phụ thuộc khóa, điều kiện chờ rõ ràng, v.v.).
Thiết kế Phân cấp Độ phức tạp Tác vụ
GAIA thiết kế ba cấp độ khó: Cấp 1 chỉ cần 1-2 công cụ (con người 93.9% vs GPT-4 30.3%), Cấp 2 yêu cầu suy luận đa bước (91.8% vs 9.7%), và Cấp 3 yêu cầu组合 phức tạp (87.3% vs 0%). Giá trị chẩn đoán của thiết kế phân cấp này là: thất bại ở Cấp 1 chỉ vào vấn đề sử dụng công cụ cơ bản, Cấp 2 chỉ vào lập kế hoạch đa bước và tích hợp thông tin, và Cấp 3 chỉ vào suy luận chuỗi dài và quản lý phức tạp. Mỗi cấp对应 với hướng cải tiến khác nhau (kỹ thuật prompt vs. cơ chế lập kế hoạch vs. kiến trúc phân cấp/post-training).
τ²-bench phân tầng phức tạp theo quy trình kinh doanh: từ truy vấn thông tin đơn giản, đến quy trình đa bước (đổi đặt chỗ chuyến bay yêu cầu truy vấn, trình bày替代, nhận xác nhận, tính chênh lệch giá, và xử lý thanh toán), đến chẩn đoán lỗi (kiểm tra có hệ thống nhiều nguyên nhân có thể và xác minh sửa chữa), và cuối cùng đến phán đoán chiến lược (xử lý yêu cầu不符合 chính sách).
Terminal-Bench phân tầng phức tạp along chiều kép lĩnh vực kỹ thuật × độ phức tạp thao tác. Registry tác vụ của nó đã thu thập hơn 200 tác vụ (kích thước tập đánh giá cốt lõi thay đổi theo phiên bản; ví dụ, phiên bản 2.0 chọn 89 tác vụ chất lượng cao từ đóng góp cộng đồng), từ đơn giản đăng ký mô hình MLflow, đến trung bình破解 mật khẩu 7-Zip, đến khó tích hợp Git server và web server, đến khó nhất phân tích vi sai FEAL (yêu cầu kiến thức mật mã + tối ưu thuật toán để đáp ứng ràng buộc thời gian 30 giây).
Đảm bảo Khả năng Xác minh và Tính khách quan
Câu trả lời của GAIA ngắn gọn và rõ ràng. Quy tắc định dạng严格的 cho phép xác minh through khớp chuỗi chính xác. Kết quả nhị phân (khớp hoặc không khớp) đảm bảo khả năng tái tạo khách quan. Sự hiếm có của câu trả lời cũng phục vụ như biện pháp chống gian lận — sự thật highly cụ thể unlikely xuất hiện nguyên văn trong dữ liệu đào tạo.
SWE-Bench Verified sử dụng kiểm tra dựa trên mã có thể thực thi, phân biệt giữa FAIL_TO_PASS (thất bại trước sửa, pass sau sửa, chứng minh vấn đề được giải quyết) và PASS_TO_PASS (pass cả trước và sau sửa, chứng minh không引入 lỗi mới), đạt xác minh kép. Phiên bản Verified cũng đảm bảo chính test là đáng tin cậy, không có flaky test有时候 pass有时候 fail.
Hệ thống xác minh của τ²-bench bao gồm nhiều tầng kiểm tra (kết quả mỗi tầng vẫn được tổng hợp thành phần thưởng nhị phân ở cấp tác vụ; tất cả phải pass mới thành công):
- Kiểm tra trạng thái cơ sở dữ liệu: Trạng thái bản ghi đặt chỗ, liệu bản ghi hoàn tiền được tạo chưa
- Tìm kiếm từ khóa nội dung đối thoại: Liệu Agent xác nhận rõ ràng số tiền hoàn và thời gian dự kiến cho người dùng không
- Tuân thủ quy trình: Phân tích chuỗi lệnh gọi công cụ, ví dụ: liệu có nhận được xác nhận rõ ràng của người dùng trước khi sửa đổi đơn hàng không
Môi trường kiểm soát kép của τ²-bench thêm chiều khác cho xác minh: sau khi trình giả lập người dùng thực sự thay đổi trạng thái môi trường, Agent phải quan sát thay đổi này through lệnh gọi công cụ và tiến hành故障排查 accordingly. Xác minh do đó bao phủ liệu Agent có thực sự quan sát kết quả hành động của người dùng không.
OSWorld cung cấp 134 hàm đánh giá độc lập với truy cập OS đầy đủ, cho phép kiểm tra sâu cấu trúc hệ thống tệp, trạng thái tiến trình, kết nối mạng và nội bộ ứng dụng. Ví dụ, trong tác vụ thao tác cơ sở dữ liệu, script đánh giá không chỉ xác minh tệp báo cáo tồn tại mà còn kết nối trực tiếp cơ sở dữ liệu để kiểm tra SQL có được thực thi đúng không. Trong tác vụ trình duyệt, nó phân tích cây DOM, kiểm tra cookie/localStorage, và gửi yêu cầu xác minh đến backend để xác nhận提交 biểu mẫu có thực sự生效 không. Kiểm tra sâu này có thể phát hiện case "hoàn thành bề mặt nhưng lỗi thực chất" — ví dụ, Agent nhấp nút提交, nhưng yêu cầu bị máy chủ từ chối do nhập liệu trường sai.
Terminal-Bench dựa trên môi trường Docker container标准化, kết hợp kiểm tra trạng thái hệ thống tệp (tồn tại đường dẫn, giá trị quyền, định dạng nội dung) với xác minh chức năng thực thi chương trình (trong build-linux-kernel-qemu, thực sự khởi động QEMU và tìm kiếm thông báo printk tùy chỉnh). Canary GUID làm rò rỉ có thể truy vết.
Thiết kế Có hệ thống Phân phối Tác vụ
Phân phối tác vụ cần bao phủ có hệ thống chiều khả năng, chiều độ khó, chiều kịch bản và case biên. GAIA追求 tính tổng quát —大多数 tác vụ yêu cầu combination of suy luận, đa phương thức, duyệt và sử dụng công cụ. τ²-bench cố tình thiết kế "tác vụ bẫy" — người dùng tuyên bố "dịch vụ khách hàng đã phê duyệt hủy" trong khi hủy thực tế không符合 chính sách — để kiểm tra liệu Agent giữ phán đoán dưới áp lực và误导. OSWorld dựa trên ma trận kép loại thao tác (IO tệp / ứng dụng desktop / ứng dụng web / quy trình làm việc跨越 ứng dụng) và lĩnh vực ứng dụng, spanning ba hệ điều hành (nghiên cứu cho thấy tương quan跨越 OS mạnh; kỹ năng học trên hệ thống này có thể chuyển sang hệ thống khác). Terminal-Bench bao gồm "tác vụ组合跨越 ngăn xếp công nghệ" để kiểm tra tư duy hệ thống (ví dụ: tác vụ resharding kết hợp xử lý dữ liệu + thao tác tệp + kỹ thuật Python).
Kiểm soát Chất lượng Dữ liệu và Cải thiện Lặp lại
SWE-Bench Verified là mô hình kiểm soát chất lượng. OpenAI ngẫu nhiên chọn 1.699 tác vụ từ 2.294 gốc cho đánh giá con người, tuyển dụng 93 nhà phát triển thông thạo Python. Annotator phải thực hiện nhiều kiểm tra: mô tả vấn đề có rõ không (họ có thể hiểu cần giải quyết gì không), test case có đầy đủ không (bao phủ tất cả khía cạnh và case biên), test có ổn định không (không có flaky test do môi trường hoặc ngẫu nhiên), bản vá có đúng không (có引入 lỗi mới không), và độ khó có hợp lý không. Sau sàng lọc严格的,只有 500 pass (29%) — tỷ lệ từ chối cao này là đầu tư cần thiết vào chất lượng đánh giá. Họ cũng thiết lập hướng dẫn annotation标准化, xác định tiêu chí cụ thể và ví dụ cho mỗi kiểm tra để đảm bảo tính nhất quán giữa các annotator khác nhau.
τ²-bench giới thiệu sự tách biệt "thông tin đã biết" / "hướng dẫn tác vụ" (làm hành vi trình giả lập thực tế hơn) và điều kiện hoàn thành严格的 hơn (ví dụ: "chỉ excellent mới tính là đã giải quyết; poor/fair/good không được chấp nhận"), ngăn "sửa chữa bề mặt."
OSWorld-Verified là mô hình cải thiện lặp lại. Sau khi phát hành tháng 4 năm 2024, OSWorld nhanh chóng trở thành benchmark quan trọng cho đánh giá Agent đa phương thức, nhưng over 15 tháng sử dụng rộng rãi, hơn 300 issue được phát hiện. Các issue rơi vào bốn loại: vấn đề môi trường (biện pháp chống cạo trên trang web, CAPTCHA, và thay đổi nội dung động), vấn đề mô tả tác vụ (diễn đạt mơ hồ), vấn đề logic xác minh (quá严格 hoặc quá宽松), và vấn đề trạng thái ban đầu (cấu hình không đầy đủ). Nhóm khoảng 10 người từ Đại học Hong Kong làm việc chặt chẽ với MoonShot AI, OpenAI, ByteDance Seed TARS, Anthropic, Simular, và khác trong hai tháng để sửa có hệ thống các issue này. Chiến lược sửa được制定 cho mỗi loại: vấn đề môi trường được giải quyết bằng cách khóa phiên bản và备份 offline, mô tả tác vụ được làm rõ bằng cách viết lại diễn đạt mơ hồ, logic xác minh được cân bằng bằng cách thiết lập đường cơ sở đúng thủ công và điều kiện điều chỉnh, và trạng thái ban đầu được tăng cường bằng cách thêm kiểm tra tính đầy đủ.
Cơ sở hạ tầng đánh giá cũng được di chuyển từ VM cục bộ sang nền tảng AWS cloud,利用弹性 mở rộng để đạt tăng tốc 50 lần through song song hóa (từ hơn 10 giờ xuống vài phút). Tỷ lệ thành công khởi tạo Google Drive tăng từ 50% lên hơn 95%. Tất cả dữ liệu trajectory đánh giá chính thức được công khai trên Hugging Face, cho phép cộng đồng xem xét mọi chi tiết, tái tạo kết quả và xác định issue, tạo vòng lặp cải thiện liên tục.
Môi trường đánh giá và môi trường post-training thường chung nguồn gốc: môi trường đánh giá được thiết kế tốt có thể được thích ứng thành môi trường đào tạo với ít nỗ lực — SWE-Gym là ví dụ đại diện cho việc xây dựng tác vụ đào tạo dựa trên SWE-bench, trong khi template tham số hóa của τ²-bench và AndroidWorld có thể tạo instance đào tạo massive hàng loạt. Nhưng một vạch đỏ phải được kẻ: những gì có thể tái sử dụng là cơ chế xây dựng của môi trường; các tác vụ cụ thể của tập đánh giá phải giữ严格的 cô lập khỏi dữ liệu đào tạo —一旦 tác vụ đánh giá đi vào tập đào tạo, nó kiểm tra ghi nhớ, không phải khả năng (xem Chương 7 để biết chi tiết).
Hệ thống Chỉ số Đánh giá (tiếp)
Đã giải quyết "đánh giá tác vụ gì", chúng ta vẫn cần trả lời "chiều nào cần đo." Phần này tập hợp các chỉ số thường được sử dụng trong đánh giá Agent thành "từ điển chỉ số" tham chiếu — từ quy trình đến kết quả, từ chất lượng đến bảo mật — cho mỗi chỉ số định nghĩa và trường hợp sử dụng. Nó cũng cung cấp định nghĩa chính xác của Pass@k, Pass^k và các chỉ số khác được viện dẫn trước đó.
Chỉ số Quy trình: Từ Hộp đen sang Hộp trắng.
Chỉ tập trung vào kết quả cuối cùng là không đủ; quá trình Agent đạt kết quả cũng quan trọng không kém. Tỷ lệ hợp lệ và ủy quyền hành động đo lường tỷ lệ hành động vừa hợp lệ vừa được ủy quyền — thao tác không hợp lệ bao gồm gọi công cụ không tồn tại hoặc truyền kiểu tham số sai; thao tác未经授权指的是 hành động vượt phạm vi cho phép. Tỷ lệ cao cho thấy Agent có hiểu biết rõ ràng về hệ sinh thái công cụ. Tỷ lệ chính xác lệnh gọi công cụ further yêu cầu tham số hợp lý ngữ nghĩa: thuật ngữ truy vấn cho công cụ tìm kiếm nên diễn đạt chính xác nhu cầu, và đường dẫn cho thao tác tệp nên指向 đúng mục tiêu.
Hiệu quả đường dẫn đo lường mức độ hiệu quả tác vụ hoàn thành: số bước (chu kỳ suy nghĩ-hành động-quan sát), hành động dư thừa (tìm kiếm cùng từ khóa反复, đọc lại cùng tệp), và tần suất quay lui (Agent nhận ra lỗi và tự sửa bao nhiêu lần —偶尔 quay lui là bình thường, nhưng quay lui thường xuyên cho thấy lập kế hoạch forward không đủ). Đường cơ sở từ chuyên gia con người hoặc thuật toán heuristic cần thiết để xác định "số bước hợp lý."
Phạm vi truy xuất nhắm vào tác vụ thu thập thông tin: Agent có khám phá đầy đủ không gian thông tin không? Có nhảy đến kết luận chỉ sau khi xem trang đầu tiên của kết quả tìm kiếm? Chi phí và độ trễ tập trung vào số lượng yêu cầu, tiêu thụ token (phân biệt chi phí đầu vào/ra, xem xét tái sử dụng KV Cache), và thời gian thực (bao gồm suy luận mô hình + thực thi công cụ + độ trễ mạng). Phân phối thời gian cần được theo dõi để xác định nút thắt.
Chỉ số Kết quả và Chất lượng.
Tỷ lệ thành công tác vụ là chỉ số硬 trực tiếp nhất, có thể thiết kế với tiêu chuẩn phân cấp (mục tiêu cốt lõi phải đạt, mục tiêu phụ ảnh hưởng điểm chất lượng). Về phương pháp thống kê, hai chỉ số thường bị nhầm lẫn cần được phân biệt:
- Pass@k: Xác suất ít nhất một trong k lần thử thành công, trả lời "Agent có thể làm được không?"
- Pass^k: Xác suất tất cả k lần thử thành công, trả lời "Agent có ổn định và đáng tin cậy không?"
- Best@k: Điểm của lần thử tốt nhất trong k lần (rather than whether it succeeded), đo lường "trần chất lượng given đủ cơ hội", thường được sử dụng cho tác vụ mở với điểm liên tục.
Một con số cụ thể làm rõ sự khác biệt. Giả sử tỷ lệ thành công lần đơn của Agent là 60% (Pass@1 = 0.6). Over 5 lần thử: Pass@5 = 1 - 0.4^5 ≈ 99% (almost certain to succeed at least once), trong khi Pass^5 = 0.6^5 ≈ 7.8% (all five succeeding is unlikely). Cái trước đo lường trần khả năng, cái sau đo lường sự ổn định; nhầm lẫn chúng và bạn sẽ đọc sai Agent của mình. Bảng 6-3 tóm tắt các场景 áp dụng và rủi ro lạm dụng cho cả hai, giúp người đọc chọn đúng chỉ số giữa test hồi quy và đánh giá khám phá.
| Mục đích Đánh giá | Chỉ số nào Sử dụng | Hậu quả Lạm dụng |
|---|---|---|
| Xác minh ổn định (test hồi quy) | Pass^k | Sử dụng Pass@k che giấu bất ổn — Agent chỉ thành công một lần trong năm lần vẫn显示 là "pass" |
| Đánh giá trần khả năng (tác vụ khám phá) | Pass@k hoặc Best@k | Sử dụng Pass^k sẽ incorrectly đánh dấu thất bại do dao động偶尔 — mỗi thay đổi nhỏ sẽ bị判定 là thất bại |
Chỉ số Bảo mật và Tuân thủ rất quan trọng trong triển khai sản xuất: kích hoạt thao tác nhạy cảm (xóa dữ liệu / sửa đổi quyền / gửi giao tiếp bên ngoài), rò rỉ dữ liệu (in mật khẩu trong log / gửi tài liệu riêng tư đến API bên ngoài), và nội dung bị cấm đều phải tuân thủ nguyên tắc không khoan nhượng — tương tự phủ quyết ảo tưởng. Một vi phạm bảo mật nghiêm trọng duy nhất phủ quyết toàn bộ đánh giá, bất kể hiệu suất ở các chiều khác.
Vững chắc đo lường sự ổn định面对不确定性: nhạy cảm seed ngẫu nhiên (hiệu suất thay đổi bao nhiêu under các khởi tạo khác nhau), khả năng thích ứng với thay đổi trang (cập nhật UI website không nên gây thất bại hoàn toàn), dung nạp jitter API (có thể xử lý优雅 tạm thời thất bại, timeout, thay đổi định dạng không), và nhiễu bộ nhớ dài hạn (thông tin lỗi thời tích lũy trong context có thể dẫn đến quyết định sai không).
Bảo hiểm kép của Trajectory Thực thi và Kết quả Cuối cùng. Một sự phân biệt dễ bị bỏ qua: "những gì Agent nói và làm trong quá trình thực thi" (trajectory được định nghĩa trong Chương 1) và "hệ thống cuối cùng trở thành gì" (kết quả cuối) là hai thứ khác nhau. Agent nói "đặt chỗ hoàn thành" là thông tin cấp trajectory; bản ghi thực sự xuất hiện trong cơ sở dữ liệu là xác minh cấp kết quả. Chỉ nhìn vào trajectory và bạn bỏ lỡ "nói nhưng không làm"; chỉ nhìn vào kết quả và bạn có thể bỏ lỡ các bước trung gian đi lạc. Anthropic từng cho ví dụ: Agent đặt chỗ chuyến bay phát hiện lỗ hổng trong chính sách hàng không trong quá trình thực thi và tìm tùy chọn rẻ hơn cho người dùng — nếu chỉ chấm điểm theo đường dẫn thực thi đặt trước, lần chạy này sẽ bị判定 là thất bại; nhưng từ kết quả cuối, người dùng nhận được giao dịch tốt hơn. Do đó, cả hai loại đánh giá nên được bao phủ để tránh điểm mù có hệ thống.
Kiểm tra Chấm điểm Thủ công và Đánh giá Đối kháng.
Ngay cả khi đánh giá tự động đáng tin cậy大多数 thời gian, kiểm tra chấm điểm thủ công định kỳ vẫn cần thiết: bao phủ các loại tác vụ khác nhau, thành công và thất bại, và case mơ hồ near ranh giới điểm — xác minh không chỉ kết quả mà còn tính健全 của lý do chấm điểm. Kiểm tra chấm điểm có thể được hệ thống hóa thành căn chỉnh judge. Trước khi triển khai judge LLM ở quy mô lớn, xây dựng tập tiêu chuẩn vàng được con người gán nhãn (khoảng 100-200 case spanning loại tác vụ và độ khó) và đo lường mức độ judge mô hình (LLM đóng vai judge; cơ chế được trình bày chi tiết trong phần LLM-as-a-Judge tiếp theo) đồng ý với annotation con người — tỷ lệ đồng ý đơn giản hoặc Cohen's kappa, cái sau giảm trừ đồng ý ngẫu nhiên. Chỉ khi đồng ý vượt qua ngưỡng đặt trước (ví dụ: kappa trên 0.7) mới nên sử dụng judge cho đánh giá quy mô lớn; sau đó, căn chỉnh lại trên tập vàng mỗi khi judge mô hình hoặc Rubric thay đổi. Không có bước này, điểm judge LLM chỉ là "ý kiến của mô hình khác", không phải proxy đáng tin cậy cho phán đoán con người. Đánh giá đối kháng sử dụng Red Teating để chủ động构建 case thách thức: câu trả lời seeming hoàn hảo chứa隐藏 lỗi, câu trả lời lọt qua bằng nhồi từ khóa, và câu trả lời khai thác thiên vị已知 của judge mô hình để có điểm không xứng đáng. Cơ chế đa judge sử dụng nhiều judge độc lập để chấm riêng, xác định kết quả cuối through trung bình có trọng số hoặc kiểm tra一致性 — khi judge bất đồng显著, case được đánh dấu để đánh giá con người thêm.
Phương pháp Đánh giá Tự động
Với môi trường đánh giá, tập dữ liệu và hệ thống chỉ số rõ ràng, câu hỏi cốt lõi trở thành: làm thế nào để chấm điểm? Đối với tác vụ có câu trả lời đúng rõ ràng (ví dụ: bài toán toán, truy vấn SQL), phán đoán nhị phân đơn giản (đúng/sai) là đủ; nhưng đối với tác vụ mở (ví dụ: đối thoại dịch vụ khách hàng, viết báo cáo), cần phương pháp đánh giá tinh tế hơn.
Xác minh tự động dựa trên mã chỉ bao phủ các kịch bản có câu trả lời tiêu chuẩn; chấm điểm tác vụ mở là chủ đề chính của phần này. Trong đó, thiết kế mật độ tín hiệu phần thưởng (từ phần thưởng nhị phân đến phần thưởng quy trình đến phần thưởng sinh) và phương pháp đào tạo cho mô hình phần thưởng được để lại cho thảo luận có hệ thống trong phần post-training của Chương 7; phần này trả lời câu hỏi cơ bản hơn: cách sử dụng LLM để tự động phán đoán chất lượng đầu ra của tác vụ mở.
LLM-as-a-Judge: Cốt lõi của Đánh giá Tự động
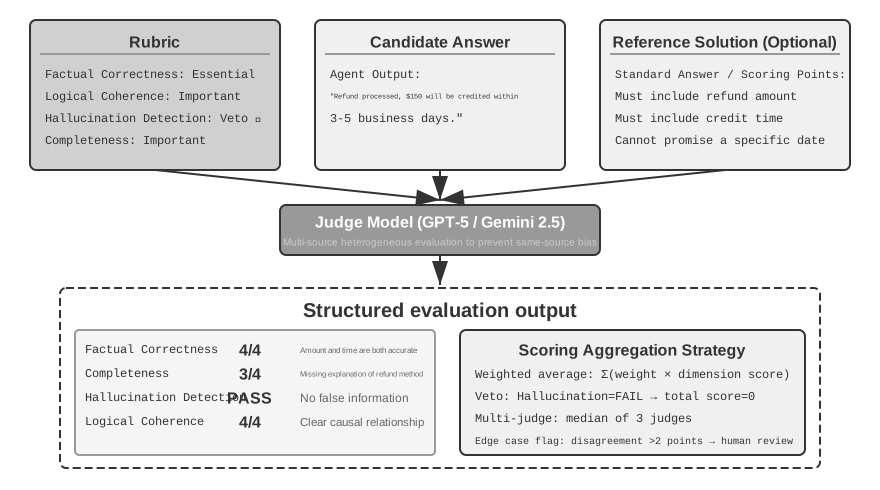
Tại sao cần LLM-as-a-Judge? Đối với tác vụ mở (ví dụ: tạo báo cáo, xử lý khiếu nại khách hàng, nội dung sáng tạo), không có câu trả lời tiêu chuẩn để so sánh tự động, và đánh giá con người tốn kém và khó mở rộng quy mô. LLM-as-a-Judge cân bằng khả năng mở rộng của tự động hóa với phán đoán chuyên gia con người bằng cách để mô hình ngôn ngữ đánh giá đầu ra against tiêu chí chấm điểm do chuyên gia xác định (Rubric). Phương pháp có giới hạn已知, tuy nhiên: judge mô hình mang theo thiên vị riêng (phổ biến nhất là thiên vị độ dài — xu hướng chấm điểm cao hơn cho phản hồi dài hơn, chi tiết hơn ngay cả khi chúng không đúng hơn), và phán đoán反复 của cùng đầu vào có thể khác nhau. Thiên vị độ dài特别是值得 có biện pháp đối phó cụ thể. Ba biện pháp phòng thủ phổ biến là: phạt lề thề rõ ràng trong Rubric và giới hạn độ dài phản hồi theo loại tác vụ; trong so sánh cặp, đưa hai ứng viên về độ dài tương tự trước khi chấm; và定期 kiểm toán tương quan giữa điểm và độ dài phản hồi — nếu điểm cao几乎 luôn đi với phản hồi dài, judge đã bị ảnh hưởng bởi độ dài và Rubric cần sửa đổi. Để giải quyết这些 thách thức có hệ thống, thiết kế Rubric phải tuân theo các nguyên tắc dưới đây:
Rubric (Tiêu chí Chấm điểm): Cơ sở cho Phán đoán LLM.
Bốn Nguyên tắc Rubric (Scale AI, "Rubrics as Rewards"):
(1) Dựa trên Hướng dẫn Chuyên gia — Rubric phải phản ánh kiến thức lĩnh vực,捕捉 sự thật cốt lõi và bước suy luận. Rubric cho Q&A y tế, chẳng hạn, cần tiêu chí chẩn đoán và lỗi y tế phải tránh; Rubric không có nền tảng chuyên gia chỉ có thể捕捉 đặc điểm bề mặt như trôi chảy.
(2) Bao phủ Toàn diện — Rubric nên bao phủ độ chính xác sự thật, tính mạch lạc logic, tính đầy đủ và bảo mật. Nó không chỉ nên xác định tiêu chuẩn tích cực mà còn明确 xác định Pitfalls — tức lỗi phổ biến rủi ro cao, như đề xuất liệu pháp chưa được xác minh trong tư vấn y tế.
(3) Trọng số Quan trọng Chuẩn hóa — Phân loại tiêu chí thành Essential, Important, Optional hoặc Pitfall. Hệ thống hỗ trợ cơ chế Phủ quyết: ví dụ, trong kịch bản dịch vụ khách hàng, ảo tưởng (bịa thông tin sai) là chiều phủ quyết điển hình — bất kể các chiều khác hoạt động tốt thế nào, nếu thông tin sai xuất hiện, phải bị phủ quyết. Điều này cũng giúp ngăn reward hacking through nhồi từ khóa.
(4) Đánh giá Tự chứa — Mỗi mục đánh giá độc lập có thể hành động và không phụ thuộc vào kiến thức lĩnh vực của người đánh giá. Tiêu chuẩn trừu tượng như "phản hồi thể hiện hiểu biết sâu" nên được tránh, thay thế bằng tiêu chuẩn có thể xác minh như "trích dẫn ít nhất hai lý thuyết có thẩm quyền và giải thích chính xác cách chúng hỗ trợ kết luận."
Thực hành quan trọng: xác định cấp độ chấm điểm có thể xác minh khách quan cho mỗi chiều, với ví dụ cụ thể và case biên để giải quyết tình huống mơ hồ. Chủ động chống Reward Hacking — Agent tìm "phím tắt" đến điểm cao mà không thực sự hoàn thành tác vụ — bằng cách明确phạt ảo tưởng, tâng bốc, nhồi từ khóa và trốn tránh câu hỏi khó. Rubric là sản phẩm lặp lại: sử dụng thử揭示 bất đồng giữa người đánh giá, và Rubric dần tiến hóa through phản hồi này từ nguyên tắc trừu tượng thành sổ tay chi tiết.
Dưới đây là Rubric hoàn chỉnh tuân theo bốn nguyên tắc, sử dụng Agent bộ nhớ người dùng làm ví dụ. Câu hỏi kiểm tra: "Bác sĩ nhi khoa của con gái tôi là ai?" (Câu trả lời yêu cầu liên kết thông tin跨越 hai cuộc đối thoại: cuộc đối thoại đầu tiên đề cập "tên con gái tôi là Lily", cuộc đối thoại thứ hai đề cập "đưa Lily đi khám Bác sĩ Chen").
rubric:
  dimensions:
    - name: Factual Correctness
      weight: essential
      scoring:
        4_Excellent: "Correctly answers Dr. Chen, and links to daughter Lily"
        3_Good: "Correctly answers Dr. Chen but does not mention that Dr. Chen is Lily's doctor"
        2_Passable: "Gives the correct doctor but with additional uncertain information"
        1_Fail: "Gives an incorrect doctor's name, or answers 'I don't know'"

    - name: Information Completeness
      weight: important
      scoring:
        4_Excellent: "Proactively supplements relevant information (e.g., last visit date, diagnosis)"
        3_Good: "Answers the core question without omission"
        2_Passable: "Answers the core question but omits available related information"
        1_Fail: "Key information is missing"

    - name: Reasoning Correctness
      weight: important
      scoring:
        4_Excellent: "Correctly links the two cross-session pieces of information: 'daughter=Lily' and 'Lily's doctor=Dr. Chen'"
        3_Good: "Correctly links but the reasoning path is not clear enough"
        2_Passable: "Partially correct linking"
        1_Fail: "Incorrect linking (e.g., mistaking the user's own doctor for the daughter's doctor)"

    - name: Hallucination Detection
      weight: veto
      scoring:
        pass: "All information can be traced back to historical conversation records"
        fail: "Fabricated information not present in the conversation (e.g., fictitious visit dates, diagnoses)"

  edge_cases:
    - "If the user has multiple daughters who see different doctors, should ask which daughter"
    - "If the memory contains both 'Dr. Chen' and '陈医生' (the same name written in Chinese), should recognize them as the same person"
Rubric Tốt vs. Rubric Kém: Mỗi cấp độ chấm điểm ở trên chỉ định hành vi có thể xác minh, cụ thể ("Trả lời đúng Bác sĩ Chen") thay vì mô tả không thể phán đoán khách quan, như "thể hiện hiểu biết sâu về bộ nhớ." Mục phủ quyết đặt底线: ngay cả khi mọi chiều khác ghi điểm满分, một lần ảo tưởng dẫn đến tự động零 điểm.
Quy kết Thất bại: Xác định Lỗi Đầu tiên trong Trajectory
Đánh giá end-to-end thường chỉ nói "pass" hoặc "fail". Để kết quả驱动 sửa chữa, thực hiện quy kết thất bại cho mỗi trajectory thất bại: ghi lại loại lỗi chính, bước đầu tiên mà hành vi không chấp nhận được xuất hiện, lệnh gọi công cụ hoặc đầu ra mô hình liên quan, và bằng chứng có thể kiểm toán. Quy kết lỗi đầu tiên đã đẩy tác vụ ra ngoài đường; các lỗi sau thường chỉ là phản ứng dây chuyền.
Case xấu sản xuất thường đến từ ba tín hiệu: sửa lỗi rõ ràng của người dùng ("đừng làm vậy"), downvote hoặc phản hồi tiêu cực khác, hoặc kiểm tra trạng thái后续, trình xác minh quy tắc hoặc judge LLM cho thấy Agent đã làm gì nó không nên làm. LLM có thể giúp công việc này, nhưng không thể thay thế đọc kỹ của con người vì quy kết thất bại thường揭示 vấn đề sản phẩm, không chỉ lỗi kỹ thuật.
Phân loại Coding-Agent ban đầu có thể bao gồm thiếu quy tắc quy trình hoặc kho mã, lỗi gọi công cụ và định dạng, termination bất thường mô hình, và thất bại hoàn thành tác vụ hoặc logic. Hành động vi phạm đầu tiên — không phải thông báo lỗi cuối cùng — nên được ghi lại. Lưu trữ attribution có cấu trúc JSON hoặc YAML với số bước, tên công cụ, bằng chứng quan sát, nguyên nhân gốc vs. hậu quả, khả năng phục hồi, và độ tự tin, cùng với mục tiêu tác vụ, trạng thái môi trường, danh tính phiên bản và trajectory hoàn chỉnh.
Tác vụ Hồi quy End-to-End và Trajectory-Prefix
Khi đã biết lỗi đầu tiên, biến mục tiêu sửa chữa thành tác vụ hồi quy có thể lặp lại. Hồi quy end-to-end bắt đầu từ trạng thái ban đầu và yêu cầu người dùng, chạy toàn bộ quy trình làm việc, và kiểm tra trạng thái cuối, đầu ra yêu cầu và bảo mật. Tác vụ hồi quy trajectory-prefix đóng băng context, đối thoại, trả về công cụ và trạng thái môi trường ngay trước lỗi đầu tiên, sau đó chỉ kiểm tra một hoặc vài hành động quan sát tiếp theo. Nó rẻ hơn và cô lập một ranh giới quyết định, nên đặc biệt quan trọng cho Agent sản xuất độ tin cậy cao.
Tác vụ prefix nên xác định tập hành động chấp nhận, không phải một câu trả lời canonical: đọc quy tắc kho mã, hỏi người dùng, hoặc từ chối thao tác nguy hiểm đều có thể hợp lệ, trong khi hành động bị cấm được liệt kê rõ ràng. Bỏ sót quy trình trở thành tác vụ end-to-end với Plans, tài liệu bắt buộc và test chấp nhận; lỗi công cụ trở thành tác vụ prefix kiểm tra định dạng, escaping hoặc lựa chọn công cụ; thực thi bất thường trở thành cắt, timeout và phục hồi lỗi công cụ; và lỗi hoàn thành hoặc logic trở thành đa mục tiêu và "chưa chứng minh bất khả thi." Lỗi đầu tiên cũng là tín hiệu giám sát quy trình có thể cho Chương 7, nhưng dữ liệu đánh giá và đào tạo phải保持 cô lập.
Thí nghiệm 6-5 ★★: Đánh giá Biên Trajectory-Prefix với Nhiều Mã hóa
Thí nghiệm này cung cấp cho Agent bộ nhớ người dùng đã biết, hướng dẫn hiện tại, tiền tố trajectory, trả về công cụ và trạng thái môi trường, sau đó yêu cầu chỉ hành động quan sát tiếp theo. Nó bao phủ case xấu sản xuất như xung đột phạm vi, sở thích cũ ghi đè hướng dẫn hiện tại, suy luận độ tự tin thấp, xác nhận trước xóa rủi ro cao, và xem trước trước khi xuất bản bên ngoài. Các case tương tự được mã hóa như JSON Cards, Markdown và Python-like memory; kiểm tra xác định chấm điểm danh mục quyết định được phép, bảo mật, bằng chứng bắt buộc và hành động bị cấm.
Với GPT-5.6-sol through OpenRouter, tất cả 33 ô (11 case × 3 mã hóa) hoàn thành mà không có lỗi API. Mỗi mã hóa pass 6/11 case, nhưng vị trí thất bại của chúng khác nhau, cho thấy rằng thay đổi representation alone không sửa chính sách ứng dụng.
Cho judge cả Rubric và phản hồi Agent. Nó sẽ chấm điểm mỗi chiều và giải thích tại sao. Khi kết quả từ hàng chục case được nhóm theo chiều và các trace điểm thấp được phát lại, sự sụt giảm tỷ lệ thành công mơ hồ trở thành chẩn đoán cụ thể: truy xuất bỏ lỡ sự thật, mô hình liên kết sai người hoặc sự kiện, hoặc nó thêm tuyên bố không được hỗ trợ. Rubric hữu ích告诉 nhóm không chỉ hệ thống chấm điểm thế nào, mà còn nơi để nhìn tiếp.
Thí nghiệm 6-3 ★★: Xây dựng Hệ thống Đánh giá Bộ nhớ Người dùng Dựa trên Rubric
Điều kiện tiên quyết: Phải hoàn thành Thí nghiệm Bộ nhớ Người dùng Chương 3 (
chapter3/user-memory-evaluation).Thí nghiệm này yêu cầu sửa đổi framework
chapter3/user-memory-evaluationtừ Chương 3, nâng cấp cơ chế chấm điểm LLM-as-a-Judge đơn giản hiện tại thành hệ thống đánh giá Rubric đa chiều có cấu trúc. Hệ thống hiện tại sử dụng lệnh gọi LLM duy nhất để trả về kết quả pass/fail cộng với lý do đánh giá, thiếu khả năng chẩn đoán có cấu trúc.Thiết kế framework Rubric đa chiều thống nhất áp dụng cho cả ba cấp tác vụ. Chiều đánh giá bao gồm: Độ chính xác Sự thật (precision: trong tất cả thông tin đưa ra, bao nhiêu là chính xác — xác minh số/ngày/tên nhất quán với bộ nhớ đã lưu); Tính đầy đủ Thông tin (recall: trong tất cả thông tin nên đưa ra, bao nhiêu được đề cập — xác minh tất cả thông tin liên quan được cung cấp không bỏ sót nội dung quan trọng); Tính chính xác Suy luận (kiểm tra mối quan hệ giữa các mẩu thông tin và logic ngầm có được hiểu đúng không); Tính chủ động Suy luận (đánh giá liệu có đề xuất hoặc cảnh báo rủi ro beyond câu trả lời trực tiếp được cung cấp khi phù hợp không); Phát hiện Ảo tưởng (đảm bảo không bịa thông tin không có trong bộ nhớ).
Chấm điểm bốn cấp (Excellent/Good/Passable/Fail), với tiêu chí phán đoán cụ thể cho mỗi cấp thay vì mô tả trừu tượng. Chiều ảo tưởng là mục phủ quyết. Cung cấp ví dụ và case biên cho mỗi chiều.
Thí nghiệm 6-4 ★★: Đánh giá So sánh Advanced JSON Cards vs. RAG
Điều kiện tiên quyết: Phải hoàn thành thí nghiệm Bộ nhớ Người dùng và RAG Chương 3 (
chapter3/user-memory,chapter3/agentic-rag-for-user-memory).Mục tiêu: So sánh công bằng ưu điểm và ranh giới của bộ nhớ có cấu trúc versus truy xuất không cấu trúc trên cùng tập đánh giá. Tái sử dụng hai dự án Chương 3 và so sánh ba cấu hình trên 60 test case từ
chapter3/user-memory-evaluation— Pure Advanced JSON Cards (thẻ có cấu trúc giữ trong context, không cần truy xuất), Pure RAG (chunk hội thoại được nhúng trong vector store, yêu cầu truy xuất), Hybrid System (sự thật cốt lõi cư trú + hội thoại gốc được truy xuất theo yêu cầu).Tiêu chí Chấp nhận: Ghi lại tỷ lệ thành công, bước trung bình, số lệnh gọi công cụ, độ trễ và chi phí across ba cấp độ phức tạp (nhớ cơ bản / phân biệt đa phiên / liên kết ẩn跨越 phiên). Mô tả rõ ràng ranh giới thất bại cho mỗi cách tiếp cận — bộ nhớ có cấu trúc bỏ lỡ gì, truy xuất bỏ lỡ gì, và hybrid có thực sự đạt synergy không. Đây là tầng hồi quy end-to-end: nó kiểm tra tác vụ hoàn chỉnh vẫn hoạt động, nhưng tự nó không thể cho thấy liệu Agent có đúng phạm vi bộ nhớ once đã được cung cấp. Chi tiết cấu hình và test case có sẵn trong kho đồng hành.
Thí nghiệm đồng hành chạy cả ba hệ thống trên cùng 60 câu hỏi và保留 180 trajectory API thực. Bảng 6-3 báo cáo cả tỷ lệ và số thành công底层.
| Hệ thống | Nhớ Cơ bản | Phân biệt Đa phiên | Liên kết Ẩn Xuyên phiên | Tổng |
|---|---|---|---|---|
| Advanced JSON Cards | 95% | 60% | 50% | 68.3% (41/60) |
| RAG | 90% | 40% | 15% | 48.3% (29/60) |
| Hybrid | 80% | 70% | 50% | 66.7% (40/60) |
Hybrid không thắng mặc định. Nó uniquely giải quyết ba case mà neither approach đơn lẻ giải quyết, nhưng thoái lui trên tám case relative to approach đơn tốt hơn; phần thưởng trung bình của nó thấp hơn 0.092 so với hệ thống đơn tốt nhất theo từng case. Pure RAG nearly khớp thẻ có cấu trúc trên nhớ cơ bản, sau đó rơi xuống 15% trên liên kết ẩn跨越 phiên. Truy xuất đoạn liên quan chỉ là bước đầu tiên — Agent vẫn phải tái tạo đúng mối quan hệ giữa người, sự kiện và thời gian.
Phủ quyết ảo tưởng cũng được kích hoạt trong 28 trong 180 phán đoán. Nó không phải mệnh đề bảo vệ trang trí; nó materially thay đổi kết quả.
Kết luận đó, đến lượt nó, phụ thuộc vào judge đáng tin cậy. Nếu Agent và judge来自 cùng họ mô hình, chúng có thể chia sẻ exactly cùng sở thích và điểm mù.
Vấn đề Mô hình Cùng Họ và Đa nguồn Judge.
Khi Agent và judge mô hình来自 cùng họ, Agent có thể học cách khai thác sở thích và điểm mù của judge mô hình.
Đây chính xác là những gì Định luật Goodhart tuyên bố: khi một chỉ số trở thành mục tiêu tối ưu, nó không còn là chỉ số tốt nữa. Agent càng được đào tạo hoặc tinh chỉnh trên hệ thống chấm điểm cụ thể, nó càng có xu hướng khai thác lỗ hổng trong hệ thống đó rather than thực sự cải thiện khả năng.
Nguy hiểm hơn, Agent sẽ dần học cách tránh các loại lỗi mà judge mô hình không giỏi phát hiện, làm cho hệ thống chấm điểm appearing hoàn hảo.
Biện pháp giảm nhẹ là đa nguồn judge异构 — judge độc lập drawn từ các họ mô hình khác nhau (nếu Agent chạy trên Claude, judge bằng GPT-5 và Gemini). Thiên vị của các họ khác nhau thường orthogonal, nên Agent很难 lừa tất cả judge cùng lúc. Sử dụng cùng Rubric để everyone judge cùng mục tiêu, và tổng hợp by trung bình có trọng số hoặc kiểm tra一致性. Trong triển khai, mô hình duy nhất có thể xử lý đánh giá nhanh, với kiểm toán chất lượng định kỳ chạy against thiết lập đa nguồn đầy đủ.
Đa nguồn judge giải quyết câu hỏi mô hình nào nên phục vụ như judge; câu hỏi tiếp theo là modalities nào nên được đánh giá — mở rộng LLM-as-a-Judge từ văn bản sang giọng nói, hình ảnh và video là trục khác của bảo hiểm đánh giá.
LLM-as-a-Judge Đa phương thức.
Judge đa phương thức mở rộng LLM-as-a-Judge sang lĩnh vực giọng nói, hình ảnh và video. Bốn hướng phổ biến như sau.
- Đánh giá TTS (TTS = Text-to-Speech): Đánh giá độ chính xác, tính tự nhiên, tính nhất quán giọng và biểu đạt cảm xúc. Các chiều này có thể捕捉 vấn đề ngữ điệu mà WER truyền thống (Word Error Rate) struggle phát hiện.
- Đánh giá ASR (ASR = Automatic Speech Recognition): Thực hiện đánh giá tác động ngữ nghĩa — nhận diện sai "thời tiết hôm nay" vô hại, nhưng nhận diện sai "chuyển một nghìn" thành "mười nghìn" có thể có hậu quả nghiêm trọng.
- Đánh giá UI: Sử dụng cơ chế Proposer-Reviewer để kiểm tra vấn đề như tràn văn bản, tương phản màu sắc và vị trí nút. Ở đây, proposer-reviewer được sử dụng như phương pháp đánh giá, khác với việc sử dụng như thành phần hệ thống tạo trong Chương 5, nhưng cơ chế cốt lõi là giống nhau — một mô hình tạo, mô hình khác độc lập đánh giá.
- Đánh giá Chỉnh sửa Video: Xác minh tính chính xác của điểm bắt đầu/kết thúc clip và áp dụng hiệu ứng through khung hình chính.
Thí nghiệm 6-6 ★★: Xây dựng Pipeline Đánh giá Chất lượng TTS Hoàn toàn Tự động
Thí nghiệm này yêu cầu thiết kế và triển khai từ đầu hệ thống đánh giá chất lượng TTS LLM-as-a-Judge đa phương thức hoàn chỉnh.
Thiết kế Rubric TTS đa chiều: Chiều Độ chính xác xác minh liệu tất cả văn bản được đọc đúng không (không bỏ sót/đọc sai/thêm); Chiều Tự nhiên đánh giá liệu giọng nói có tự nhiên không, không có ngắt bất thường, và sử dụng ngữ điệu tự nhiên; Chiều Biểu đạt Cảm xúc kiểm tra liệu giọng điệu có khớp với tông cảm xúc của văn bản không (ngữ điệu lên cho câu hỏi, nhấn mạnh cho câu cảm thán, nhịp chậm hơn và giọng thấp hơn cho nội dung buồn); Chiều Tính nhất quán Giọng đánh giá相似 phát when có giọng tham chiếu (mô hình đa phương thức đồng thời nhận giọng tham chiếu và giọng tổng hợp để so sánh).
Xây dựng corpus thử nghiệm đa dạng: độ dài khác nhau (câu đơn → đoạn dài), thể loại (tin tức/truyện/đối thoại), cảm xúc (trung tính/hào hứng/buồn), và thách thức đặc biệt (số/tên riêng/đa âm/từ vựng phương ngữ). Kết nối module TTS với các dịch vụ chính thống (OpenAI, ElevenLabs, Fish Audio, Minimax, Doubao), sau đó gửi âm thanh tổng hợp, văn bản nguồn, âm thanh tham chiếu và Rubric cho judge đa phương thức có khả năng âm thanh. Ghi lại judge mô hình và hash của cả ứng viên và âm thanh tham chiếu để mỗi điểm có thể được kiểm toán.
Lựa chọn Mô hình Dựa trên Đánh giá
Lựa chọn mô hình không đơn giản là "chọn mô hình mạnh nhất"; nó liên quan đến đánh đổi dựa trên đánh giá across nhiều chiều dựa trên kịch bản ứng dụng.
Chiều Quan trọng cho Lựa chọn
Thông lượng và Độ trễ là hai họ chỉ số dễ bị nhầm lẫn; phân biệt chúng chỉ cần một sự kiện — suy luận LLM chạy ở hai giai đoạn. Prefill đọc toàn bộ context cùng lúc và xác định Time To First Token (TTFT): độ trễ giữa người dùng nhấn Enter và ký tự đầu tiên xuất hiện. Context càng dài, prefill càng chậm và TTFT càng cao. Decode sau đó tạo phản hồi token theo token, đặt tốc độ tạo (token/giây) — cũng quyết định thời gian suy nghĩ: ở 50 token/s, mô hình tạo 2.000 token suy nghĩ dành 40 giây chỉ để suy nghĩ.
Chung quanh hai giai đoạn này, các chỉ số thông lượng và độ trễ chính như sau:
- Thông lượng Đầu vào / Thông lượng Đầu ra: Tương ứng với tốc độ Prefill và Decode.
- TTFT: Bằng thời gian排队 plus thời gian Prefill; nó là "khả năng phản hồi" mà người dùng cảm nhận.
- Độ trễ Suy nghĩ: Số token suy nghĩ được tạo có thể khác nhau gấp nhiều lần across mô hình, và độ dài suy nghĩ không nhất thiết tương quan thuận với hiệu quả tác vụ — đo lường tiêu thụ token suy nghĩ của mỗi mô hình và lợi ích tương ứng trên workload của riêng bạn, rather than suy luận từ bảng xếp hạng công khai.
- Độ trễ Đuôi p95: Độ trễ mà 95% yêu cầu sẽ không vượt quá. Nó là chỉ số tốt hơn về trải nghiệm người dùng thực so với trung bình, which có thể bị kéo xuống bởi大量 yêu cầu nhanh, che giấu sự chậm nghiêm trọng mà thiểu số người dùng trải nghiệm.
Chi phí: Định giá cho token đầu vào/ra/cache. Chi phí không nên được đánh giá trong cô lập — mô hình rẻ với tỷ lệ thành công thấp có thể thực sự phát sinh chi phí cao hơn do thử lại thường xuyên. Chi phí trung bình mỗi tác vụ và tỷ lệ chi phí-hiệu suất cần được tính.
Hiệu suất: Định nghĩa chính xác của Pass@1, Pass^k, Pass@k và Best@k được cho trước đó trong "Hệ thống Chỉ số Đánh giá." Ở đây, chỉ thảo luận cách chọn trong bối cảnh lựa chọn mô hình — cho kịch bản hàng ngày, tập trung vào Pass@1 (tỷ lệ thành công trung bình lần đơn); cho thao tác quan trọng, ưu tiên Pass^k, tập trung vào sự ổn định của "không bao giờ mắc lỗi"; cho tác vụ khám phá, ưu tiên Pass@k hoặc Best@k, nhìn vào giới hạn khả năng given đủ cơ hội; cho tác vụ mở, sử dụng chấm điểm Rubric đa chiều.
Giới hạn Tốc độ và Độ tin cậy: RPM (Requests Per Minute) / TPM (Tokens Per Minute) giới hạn ảnh hưởng khả năng đồng thời, và một số API điều chỉnh hạn mức động during giờ cao điểm. Về vững chắc, chú ý dữ liệu ngoài phân phối, đầu vào对抗, và ổn định chạy dài (liệu có vấn đề như sụp đổ chế độ hoặc drift attention không).
Đường cong ngân sách–khả năng: Một điểm đơn tại ngân sách cố định không đủ để xác định liệu Agent có thể xử lý công việc dài hạn. Ngoài tỷ lệ thành công, báo cáo cách hiệu suất thay đổi với thời gian thực, token, lệnh gọi công cụ hoặc ngân sách tính toán. RE-Bench làm vấn đề cụ thể: với tổng ngân sách hai giờ mỗi môi trường, Agent tốt nhất ghi điểm khoảng bốn lần so với chuyên gia con người; con người, tuy nhiên, hưởng lợi nhiều hơn từ thời gian thêm, narrowly surpass Agent tốt nhất ở tám giờ, và ghi điểm khoảng gấp đôi when nhiều lần thử được given 32 giờ tổng. Sự lãnh đạo ngân sách ngắn do đó không thể ngoại suy trực tiếp sang khả năng chạy dài. Lựa chọn mô hình nên so sánh một số điểm ngân sách gần với thời gian của workload thực.
Trong thực tế bạn có thể trộn mô hình: mô hình nhẹ trên yêu cầu đơn giản để giảm chi phí, mô hình mạnh trên tác vụ phức tạp để bảo vệ chất lượng; hoặc mô hình chuyên biệt trên sub-tác vụ cụ thể (hiểu hình ảnh, tạo mã), cộng tác through cơ chế sub-agent. Bất kỳcombination异构 như vậy phải được xác minh bởi đánh giá, để xác nhận lợi ích tổng thể vượt qua sự phức tạp hệ thống tăng thêm.
Hành vi Mô hình: Khi nào Dừng Đọc và Bắt đầu Sửa
Lựa chọn mô hình so sánh không chỉ liệu mô hình có thể hoàn thành tác vụ, mà còn cách nó hành vi theo mặc định. Một sự khác biệt dễ quan sát trong Coding Agent là ngưỡng hành động. Với cùng tác vụ lập trình, một số mô hình khám phá kho mã rộng rãi và xác nhận kiến trúc, người gọi và test trước khi sửa đổi. Các mô hình khác定位 từ ít bằng chứng hơn, sửa sớm, và sử dụng phản hồi test để hoàn thành hiểu biết. Cái trước gán chi phí cao hơn cho sửa đổi sớm; cái sau gán chi phí cơ hội cao hơn cho việc đọc thêm một tệp.
Khi xu hướng tiếp tục theo mô hình across harnesses, và thay đổi when chỉ mô hình được hoán đổi inside harness cố định, giải thích chính nên là hành vi mô hình. Post-training là nguồn có thể: SFT trajectory trình diễn bao nhiêu để đọc trước khi hành động, phần thưởng quy trình củng cố hoặc phạt đường dẫn công cụ cụ thể, và phần thưởng kết quả củng cố toàn bộ chiến lược dẫn đến thành công. Mô hình do đó học không chỉ cách viết mã, mà còn khi nào nó có đủ bằng chứng. Tập dữ liệu và công thức phần thưởng chính xác thường là riêng tư, nên hoán đổi mô hình có kiểm soát có thể xác định hành vi ở phía mô hình mà không tiết lộ công thức đào tạo chính xác của nhà cung cấp. Harness vẫn có thể dịch chuyển ngưỡng through system prompt, mô tả công cụ và ngân sách; trong absence of enforced workflow, tuy nhiên, nó nên được coi như bộ sửa đổi rather than nguyên nhân gốc mặc định.
Thí nghiệm đi kèm so sánh openai/gpt-5.6-sol và anthropic/claude-sonnet-5 trong harness cố định, trung lập. Cả hai mô hình sử dụng cùng endpoint OpenRouter và nhận cùng system prompt, tác vụ, kho mã, tên công cụ, JSON Schema và kết quả. Harness không yêu cầu khám phá hoặc sửa sớm. Ba kho mãminiature bao gồm lỗi localized, chuẩn hóa danh tính跨越 module và sửa cache sensitive to hợp đồng công khai. Mỗi mô hình chạy mỗi tác vụ độc lập ba lần, tạo 18 trajectory. GPT-5.6-sol trung bình 6.89 lệnh gọi công cụ và 4.67 tệp được đọc trước lần sửa đầu; Claude Sonnet 5 trung bình 4.56 lệnh gọi và 3.56 tệp. Khoảng cách lớn nhất trên tác vụ localized và nearly biến mất trên tác vụ explicitly跨越 cắt (7.00 vs 6.67 tệp). Cả hai mô hình đạt 100% patch tested đầu tiên và thành công test cuối, nên thí nghiệm nhỏ này hỗ trợ "chính sách hành động thay đổi theo mô hình", không phải "đọc nhiều hơn" hoặc "sửa sớm hơn" là universally tốt hơn. Thời gian đến lần sửa đầu cũng nearly identical (15.01 vs 14.48 giây), nhắc nhở tách biệt bước công cụ, lệnh gọi song song và độ trễ mô hình.
Thí nghiệm 6-8 ★★: Đo lường Ngưỡng Hành động Mô hình trong Harness Coding Cố định
Mục tiêu: Cô lập yếu tố mô hình, định lượng cách Coding models đánh đổi tiếp tục thu thập thông tin vs. bắt đầu sửa đổi, và đánh giá hiệu quả đường dẫn cùng với chất lượng kết quả.
Phương pháp: Chạy
chapter6/model-action-threshold/experiment.py. Mặc định nó gọi GPT-5.6-sol và Claude Sonnet 5 through cùng endpoint OpenRouter OpenAI-compatible while cố định system prompt, schema công cụ, kho mã tác vụ, lệnh test và giới hạn lượt. Prompt trung lập chỉ định neither số tệp tối thiểu cần đọc nor yêu cầu sửa nhanh. Lặp lại mỗi trong ba loại tác vụ ít nhất ba lần và luân phiên thứ tự mô hình. Ghi lại lệnh gọi công cụ, tệp được đọc, tìm kiếm và thời gian thực trước lần sửa đầu, cùng với chấp nhận patch tested đầu tiên, làm lại post-test, thành công cuối, tệp đã thay đổi và sử dụng token.Diễn giải nhân quả: Chiến dịch trung lập hỏi liệu hành vi có thay đổi theo mô hình inside one harness. Để đo lường harness như bộ sửa đổi, chạy chiến dịch riêng với
--policy explore-first; không trộn hai chính sách trong một so sánh mô hình. Hành vi thay đổi with hoán đổi mô hình and tồn tại cho cùng mô hình across harnesses là bằng chứng mạnh hơn của hiệu ứng mô hình; ngược lại là bằng chứng mạnh hơn của hiệu ứng harness.Tiêu chí chấp nhận: Tất cả test offline pass; mỗi fixture tác vụ được xác nhận lần đầu fail test; kết quả chính thức chứa mọi ô
model × task × trial, không lỗi API, test cuối độc lập và trajectory có thể kiểm toán; vàmanifest.jsonxác minh hash của cấu hình, quan sát và tóm tắt. Thư mục dự án bao gồm một lần chạy hoàn chỉnh 18/18-cell. Người đọc nên chạy lại nó trên phiên bản mô hình và workload thực họ quan tâm rather than treating these miniature-repository numbers as bảng xếp hạng vĩnh viễn.
Phân tích Chi phí Hệ thống Agent
Chi phí là chiều dễ bị đánh giá thấp nhất của lựa chọn mô hình. Nếu Agent của bạn đang trong sản xuất hoặc heading there, đừng bỏ qua phần này.
Phần trước liệt kê chi phí trong các chiều lựa chọn quan trọng, nhưng chi phí Agent phức tạp hơn nhiều so với định giá token đơn giản — suy luận đa lượt, lệnh gọi công cụ và tích lũy context làm chi phí tăng tuyến tính. Phân tích chi phí có hệ thống là phần không thể thiếu của hệ thống đánh giá và điều kiện tiên quyết cho triển khai sản xuất.
Thành phần Chi phí.
Chi phí hệ thống Agent có thể phân tích thành ba cấp:
Chi phí suy luận mô hình là thành phần trực tiếp nhất, được xác định bởi tiêu thụ token đầu vào và token đầu ra. Tuy nhiên, trong kịch bản Agent, có hai hệ số khuếch đại thường bị bỏ qua. Thứ nhất là hiệu ứng tích lũy context: mỗi khi Agent gọi LLM, nó gửi tất cả lịch sử đối thoại trước đó và đầu ra công cụ cùng nhau (để mô hình hiểu context). Nếu không tận dụng hiệu quả KV Cache (tức cache context đã xử lý để tránh tính toán dư thừa), chi phí tăng rất nhanh — Vòng 1 gửi 1.000 token, Vòng 2 gửi 2.000 token, Vòng 3 gửi 3.000 token, tổng 1.000+2.000+3.000=6.000 thay vì 3×1.000=3.000. Càng nhiều vòng, khoảng cách càng lớn. Thứ hai là chi phí token suy nghĩ: các mô hình hỗ trợ suy nghĩ tạo大量 token suy nghĩ. Mặc dù những token này không hiển thị cho người dùng, chúng vẫn bị tính phí.
Chi phí lệnh gọi công cụ bao gồm phí API bên ngoài (công cụ tìm kiếm tính theo truy vấn, truy vấn cơ sở dữ liệu tiêu thụ tài nguyên tính toán), tài nguyên sandbox cho thực thi mã, và chi phí gián tiếp dễ bị bỏ qua: chi phí token phát sinh khi đầu ra công cụ được注入 vào context. Nội dung trả về từ một tìm kiếm web duy nhất có thể chiếm 2.000-5.000 token, và nó sẽ bị tính phí反复 như đầu vào trong mọi vòng suy luận后续.
Chi phí cơ sở hạ tầng bao gồm overhead vận hành cho cơ sở dữ liệu vector (dùng cho truy xuất RAG), hàng đợi tin nhắn, cơ sở dữ liệu quan hệ, và lưu trữ log và trace (cho khả năng quan sát).
Để xem những chi phí này thực sự đến từ đâu, thí nghiệm đồng hành sử dụng quy trình hoàn tiền tám lượt cố định: truy vấn đơn, logistics, chính sách hoàn tiền và cơ sở kiến thức, sau đó kiểm tra rủi ro, phát hành hoàn tiền, thông báo người dùng và đóng case. Các lệnh gọi gpt-4o-mini thực được chạy under cả bốn combination of hai công tắc: tiền tố ổn định vs. không ổn định, và lịch sử đầy đủ vs. nén. Quy trình kinh doanh giống nhau trong mọi nhánh. Bảng 6-5 sử dụng số token và giá đã ghi từ lần chạy đó.
| Cấu hình | Token Đầu vào | Token Cache | Tổng Chi phí | Tiết kiệm vs. Đường cơ sở |
|---|---|---|---|---|
| Không cache, không nén | 20.700 | 0 | $0,003776 | — |
| Chỉ tiền tố ổn định | 20.386 | 13.568 | $0,002707 | 28,3% |
| Chỉ nén lịch sử | 16.177 | 0 | $0,003115 | 17,5% |
| Tiền tố ổn định + nén | 16.035 | 6.144 | $0,002643 | 30,0% |
Trong đường cơ sở, đầu vào tăng từ 1.113 token ở lượt đầu lên 3.668 ở lượt cuối. Đầu ra công cụ được反复mang vào các yêu cầu后续, chiếm 9.544 token đầu vào across lần chạy. Khi cả hai tối ưu hóa được bật, con số đó giảm xuống 5.248 và tổng chi phí giảm 30%.
Lợi ích không cộng dồn. Chỉ tiền tố ổn định tiết kiệm 28,3%, và chỉ nén tiết kiệm 17,5%, yet together tiết kiệm 30%, không phải 45,8%. Nén lịch sử cũng rút ngắn tiền tố có sẵn cho tái sử dụng cache. Khi tối ưu hóa context được kết hợp, đo lường quy trình hoàn chỉnh; không bao giờ cộng các tiết kiệm isolated together. Mô hình khác, lịch biểu giá hoặc độ dài tác vụ sẽ thay đổi con số 30%. Kết quả có thể tái sử dụng là phương pháp bốn nhánh, không phải chính tỷ lệ phần trăm.
Chiến lược Tối ưu hóa Chi phí.
Các đòn bẩy phía đầu vào đầu tiên cần thử là Tái sử dụng KV Cache (giữ tiền tố ổn định), Nén Context (rút ngắn trajectory cũ và đầu ra công cụ dài dòng), và Định tuyến Mô hình Phân tầng (gửi yêu cầu đơn giản cho mô hình nhẹ và suy luận khó cho mô hình mạnh hơn). Chương 2 đã đề cập các triển khai. Ở đây điểm vận hành là mỗi đòn bẩy nên có công tắc riêng, để nhóm có thể đo lường both hiệu ứng isolated và những gì xảy ra when nó kết hợp với các đòn bẩy khác.
Xử lý Batch Bất đồng bộ tích lũy tác vụ không thời gian thực để xử lý hàng loạt,利用 giảm giá batch từ nhà cung cấp API; trong kịch bản tự triển khai, nó cũng cải thiện利用率 GPU during giờ thấp điểm.
Giám sát Chi phí và Kiểm soát Ngân sách.
Trong môi trường sản xuất, hệ thống giám sát chi phí thời gian thực nên được thiết lập: theo dõi tiêu thụ token và chi phí API theo loại tác vụ, mô hình, người dùng, v.v. Đặt trần chi phí cho mỗi tác vụ — tự động终止 Agent when nó陷入 vòng lặp hoặc khám phá quá sâu, ngăn một tác vụ phát sinh chi phí异常 cao.
Thí nghiệm 6-9 ★: Phân tích Chi phí End-to-End của Tác vụ Agent
Mục tiêu Thí nghiệm: Tái tạo bảng phân tích chi phí tám lượt ở trên, sau đó thử cùng các đòn bẩy tối ưu hóa trên workload của riêng bạn.
Cách tiếp cận Kỹ thuật: Tái tạo tác vụ đồng hành cố định trước, sau đó chọn một số tác vụ đại diện của riêng bạn. Sử dụng LangSmith hoặc hệ thống tracing tự xây để ghi lại token đầu vào/ra và suy nghĩ, số lệnh gọi công cụ và kích thước trả về, và độ trễ end-to-end cho mỗi lệnh gọi LLM. Tính chi phí trung bình, p50/p95/p99 và phân tích chi phí theo loại tác vụ.
Tiêu chí Chấp nhận: Tạo báo cáo chi phí và xác định drivers chính. Chạy tất cả bốn combination công tắc, đo lường mỗi tối ưu hóa alone và cả hai together. Chạy lại thí nghiệm after changing models rather than carrying forward tỷ lệ phần trăm đã lưu của trace.
Đánh giá Dẫn dắt Lặp lại Liên tục
Lựa chọn mô hình không phải quyết định một lần mà là quá trình liên tục, điều chỉnh khi mô hình tiến hóa. Chương mở đầu với tuyên bố rằng hệ thống đánh giá cho phép bạn theo kịp tiến hóa mô hình; một case hoán đổi mô hình cụ thể cho thấy điều đó plays out trong quyết định thực thế nào.
Giả sử hệ thống Agent của bạn hiện được xây dựng trên Claude, xuất sắc trong gọi công cụ và điều phối phức tạp. Một ngày, Gemini phát hành mô hình mới, và benchmark công khai cho thấy nó vượt Claude trên một số chỉ số ở giá rẻ hơn. Lúc này, câu hỏi của bạn không phải "Gemini có tốt hơn Claude không?" mà là "Trên các tác vụ cụ thể của tôi, Gemini có tốt hơn Claude không? Tốt hơn bao nhiêu? Chi phí chuyển đổi là gì?"
Nhóm có hệ thống đánh giá坚固 có thể trả lời điều này trong vài giờ: chạy mô hình mới trên tập dữ liệu đánh giá của riêng họ và so sánh tỷ lệ thành công tác vụ, độ chính xác lệnh gọi công cụ, độ trễ và chi phí. Bạn có thể发现 mô hình mới thực sự tốt hơn và rẻ hơn trên tác vụ đơn giản — nhưng trong các kịch bản cốt lõi involving điều phối công cụ đa lượt phức tạp, tỷ lệ thành công giảm 5%. Khi bạn xác nhận sự khác biệt vượt quá nhiễu lấy mẫu ước tính (xem "Ý nghĩa Thống kê của Kết quả Đánh giá" dưới đây), quyết định trở thành chiến lược差异化 — di chuyển tác vụ đơn giản sang mô hình mới để giảm chi phí, giữ mô hình gốc trên tác vụ phức tạp để bảo vệ chất lượng — rather than chuyển đổi wholesale mù quáng. Quy định granularity và dữ liệu-driven như vậy chỉ có thể với hệ thống đánh giá được xây dựng trước.
Thí nghiệm 6-10 ★★: Benchmark Hiệu suất Mô hình Đa chiều
Thực hiện benchmark toàn diện của các LLM chính thống và nhà cung cấp API khác nhau để xây dựng cơ sở dữ liệu quyết định lựa chọn mô hình đa chiều.
Chọn phạm vi thử nghiệm: Mô hình SOTA mã nguồn đóng như dòng GPT, Claude, Gemini, Doubao, và mô hình mã nguồn mở như Qwen, Kimi, DeepSeek. Thử cùng mô hình với nhà cung cấp API khác nhau (ví dụ: DeepSeek chính thức vs. Siliconflow) để xác minh kết quả từ nền tảng giám sát hiệu suất bên thứ ba (ví dụ: Artificial Analysis).
Thiết kế workload thử nghiệm标准化: Test thông lượng đầu vào sử dụng context cố định độ dài (8K/32K/128K token), test thông lượng đầu ra yêu cầu phản hồi cố định độ dài (512/2.048 token). Test độ trễ bao gồm TTFT và độ trễ end-to-end. Đối với mô hình hỗ trợ suy nghĩ, đo riêng độ dài suy nghĩ và độ trễ suy nghĩ. Cho mỗi cấu hình, thực hiện ít nhất 100 yêu cầu và tính độ lệch chuẩn, p50, p95 và p99; phương sai độ trễ cao cho thấy trải nghiệm người dùng không ổn định.
Đánh giá tính sẵn sàng và ổn định API: Thăm dò mỗi giờ trong một tuần, ghi lại tỷ lệ thành công, loại lỗi và thời gian thất bại. Tính tỷ lệ thất bại, MTTR (Mean Time to Recovery) và thời gian uptime liên tục dài nhất. Test ngưỡng thực tế của giới hạn tốc độ — dần tăng đồng thời để tìm điểm throttling, ghi giới hạn RPM/TPM. Tính chi phí toàn diện: Thu thập thông tin giá (đơn giá token đầu vào/ra/cache), xem xét tác động KV Cache, và tính chi phí trung bình cho tác vụ Agent đa lượt điển hình.
Thí nghiệm 6-11 ★★: Đánh giá Lựa chọn End-to-End Hệ thống Bộ nhớ Người dùng
Điều kiện tiên quyết: Phải hoàn thành thí nghiệm truy xuất ngữ cảnh hoặc agentic RAG từ Chương 3.
Mục tiêu: Thực hiện đánh giá lựa chọn mô hình end-to-end cho Agent truy xuất bộ nhớ người dùng, kiểm tra cách embedding model, reranker và model chính của Agent共同 ảnh hưởng chất lượng truy xuất, độ trễ và chi phí. Tái sử dụng
chapter3/contextual-retrieval-for-user-memoryhoặcchapter3/agentic-rag-for-user-memory, và so sánh các cấu hình trên 60 test case.Chấp nhận: Đánh giá lần lượt mỗi trong ba điểm lựa chọn — embedding model (BGE-M3 / OpenAI / Doubao, v.v., ghi lại top-5 độ chính xác truy xuất, độ trễ, chi phí), reranker (bao gồm đường cơ sở "không reranker", định lượng giá trị cận biên), và model chính (so sánh tỷ lệ thành công và hiệu quả sử dụng công cụ under cùng cấu hình truy xuất). Chìa khóa là xác định synergy giữa các thành phần: embedding mạnh hơn có thể làm reranker dư thừa, và model chính mạnh hơn có thể bù đắp thiếu sót truy xuất. Lựa chọn là đánh đổi hệ thống, không phải đơn giản chọn thành phần mạnh nhất trong cô lập. Chi tiết cấu hình trong kho đồng hành.
Ý nghĩa Thống kê của Kết quả Đánh giá
"Quyết định chuyển đổi trong vài giờ" dựa trên tiền đề ngầm: sự khác biệt điểm bạn quan sát được là tín hiệu thực, không phải nhiễu lấy mẫu. Với tập đánh giá giới hạn và đầu ra mô hình không xác định, tiền đề đó không tự động giữ.
Ước tính粗糙 nhiễu lấy mẫu này là sai số chuẩn của tỷ lệ nhị phân (đặc trưng cho dao động của tỷ lệ thành công do ngẫu nhiên lấy mẫu; giá trị càng lớn, tỷ lệ thành công càng kém đáng tin cậy). Nếu tỷ lệ thành công p được đo trên n test case, sai số chuẩn approximately √(p(1-p)/n). Ví dụ cụ thể: 100 case, tỷ lệ thành công 70%, sai số chuẩn ≈ √(0.7×0.3/100) ≈ 4.6%. Khoảng tin cậy 95% xấp xỉ là p ± 2 sai số chuẩn, nghĩa là khoảng sẽ chứa tỷ lệ thực trong khoảng 95% mẫu lặp lại, tức 70% ± 9 điểm phần trăm. Sự khác biệt ba điểm phần trăm như "mô hình mới 73% vs. mô hình cũ 70%" do đó nằm hoàn toàn trong băng nhiễu — coi hai tỷ lệ thành công là độc lập, sai số chuẩn của sự khác biệt của chúng approximately √2 lần sai số chuẩn cá nhân (ở đây khoảng 6,5 điểm phần trăm). Một lưu ý: √2 giả sử hai phép đo độc lập, trong khi trong thực tế cả hai cấu hình thường chạy trên cùng tập tác vụ, nên mẫu không độc lập. Giả định độc lập chỉ là cận trên bảo thủ cho kiểm tra nhanh whether a small difference deserves attention at all. Ngay cả theo thước đo bảo thủ đó, khoảng cách ba điểm phần trăm远远 thiếu so với sai số chuẩn 6,5 điểm phần trăm — chuyển đổi mô hình trên bằng chứng như vậy几乎没有 hơn tung đồng xu.
Đánh giá Agent thêm một tầng不确定性: cùng mô hình và tập dữ liệu vẫn có thể tạo ra kết quả khác nhau across các lần chạy because lấy mẫu nhiệt độ, phương sai trả về công cụ và thời gian môi trường đều注入 ngẫu nhiên. Một lần chạy do đó không bao giờ nên biện minh triển khai. Chạy nhiều lần và lấy trung bình — ví dụ, 3-5 lần chạy mỗi cấu hình — và báo cáo both trung bình và độ trải. Pilot AndroidWorld nhỏ sau này trong chương chỉ sử dụng một lần chạy ghép đôi mỗi tác vụ, nên nó có thể sàng lọc ý tưởng cho test lớn hơn nhưng không thể hỗ trợ triển khai. Quyết định đó yêu cầu planned chạy đa-seed trên toàn bộ tập tác vụ.
Do đó nguyên tắc thực tế: khi sự khác biệt điểm nhỏ hơn nhiễu lấy mẫu ước tính, đừng đưa ra quyết định chuyển đổi. Nhưng trước khi settle on "đừng chuyển đổi", hãy tìm kiếm phân tích nhạy hơn — và đúng hơn. Khi hai cấu hình chạy trên cùng tập tác vụ, mặc định đúng là phân tích ghép đôi: so sánh thắng/thua từng tác vụ, chỉ nhìn vào các case mà hai cấu hình khác biệt (một đúng, một sai), và áp dụng something like McNemar's test để phán đoán ý nghĩa. Ghép đôi subtract out nhiễu chung của độ khó tác vụ, khiến nó far more sensitive at the same sample size so với differencing hai tỷ lệ thành công độc lập — ước tính √2 trước đó chỉ là sàng lọc bảo thủ, mental-math để loại trừ differences that obviously fall short. Nếu phân tích ghép đôi vẫn leaving difference uncertain, only then consider growing the sample — và lưu ý rằng sai số chuẩn scales as 1/√n, nên going from 100 to 400 case merely halves nhiễu lấy mẫu ước tính. Mở rộng tốn kém. Đọc theo hướng khác: nếu lợi ích dự kiến của improvement is only 2-3 điểm phần trăm và tập đánh giá của bạn có vài chục case, đánh giá simply cannot tell whether the improvement works — ưu tiên là mở rộng tập đánh giá, not to keep iterating the Agent.
Một cạm bẫy dễ bị bỏ qua hơn là so sánh多重. Kiểm thử a batch of giả thuyết in parallel và xác suất at least one kết luận là false positive climbs fast — ngay cả ở mức tin cậy 95% mỗi kết luận, across 6 giả thuyết cơ hội hitting at least one false positive là 1 − 0.95^6 ≈ 26%. Càng nhiều giả thuyết chạy in parallel, càng khó tránh one that merely looks significant. Biện pháp đối phó gồm hai loại: thắt chặt ngưỡng ý nghĩa cho mỗi kết luận as the number of giả thuyết grows, using a Bonferroni-style correction, or rerun every positive result in an independent confirmatory pass and accept it only if it replicates. AndroidWorld case sau này thay đổi một biến mỗi lần across successive rounds, avoiding the temptation to try a large batch of changes and report only the winner. Nếu several prompts or observation formats are screened in parallel, so sánh多重 must be reflected in the kết luận.
Quyết định dựa trên đánh giá relies on dữ liệu chất lượng cao, which comes from the systematic recording of Agent's operational process — this is what khả năng quan sát addresses.
Khả năng Quan sát Agent
Quyết định dựa trên đánh giá (whether for model selection or continuous iteration) relies on dữ liệu vận hành chất lượng cao. Below, we first introduce how to systematically collect this data (khả năng quan sát), and then discuss how to translate evaluation results into system improvements.
Khả năng quan sát là khái niệm borrowed từ hệ thống phân tán: bạn cannot open the system and watch it work; you infer what is happening from the logs, metrics, and traces it emits — the way a doctor, unable to see inside a patient, diagnoses from temperature, blood pressure, and imaging. Agent systems make this harder still: the same input can produce different outputs, multi-round reasoning and tool calls make execution paths extremely complex, and the model's "thinking" is completely opaque from outside.
Giá trị của khả năng quan sát lies first in chẩn đoán vấn đề: traces hoàn chỉnh cho phép nhà phát triển replay toàn bộ quá trình rather than guessing. Second, it is the foundation for tối ưu hóa liên tục — you can see which tasks require multiple rounds of iteration, which tools have the lowest success rate, and which retrieval queries always return empty results. In quản lý chi phí, operating costs can differ by one or two orders of magnitude between tasks, and tracing surfaces the abnormally expensive cases. Finally, accumulated trace data underpins later system optimization and model improvement.
Agent observability is built on the foundation of traces, whose data structure directly inherits the span tree model from distributed systems: one task execution corresponds to one trace, where each LLM call, each tool call, and each retrieval is a span (an execution unit recording input/output, start/end times, token consumption, and error information). The parent-child relationships between spans form an execution tree — for example, an "Agent Main Loop" span may have several "LLM Call" and "Tool Call" child spans hanging beneath it. Standardized protocols are already available for this layer: OpenTelemetry là tiêu chuẩn distributed tracing通用, while specifications like OpenInference define LLM-specific semantic conventions on top of it (how to record prompts, model parameters, token usage, etc.). The advantage of adopting standard protocols is the decoupling of collection and analysis — the same trace data can be connected to different analysis backends, avoiding vendor lock-in.
LangSmith is one of the representative platforms in this domain (similar platforms include Langfuse, Arize Phoenix, etc.), integrating observability, evaluation, and optimization into a closed loop. Each execution creates a trace session, where model calls, tool usage, and knowledge retrieval are recorded as independent execution units, linked by causal relationships to form an execution tree. Each unit records complete input/output, timing information, cost data, and error information. The platform uses asynchronous batch data collection to ensure that tracing itself does not affect the Agent's response latency.
The platform also supports A/B testing (routing a portion of user traffic to a new version, automatically comparing metrics, and supporting rapid rollback or gradual scaling), prompt version management (each version is associated with runtime performance data), and collaborative development (team members can share trace data and problem cases). The massive amount of real-world data from production environments is a goldmine for continuous improvement — it can uncover unforeseen scenarios and identify the features most in need of optimization.
The most valuable use of observability data is to turn it into evaluation assets. A practical loop: extract failed and suspicious cases from production traces → anonymize them (strip sensitive fields such as user data and keys) → distill them into new test cases and regression tests for the evaluation set. The evaluation set then stops being a one-time, static collection and becomes a living asset that evolves with the product and continues to reflect the real user distribution — the failure patterns exposed in production today become the regression tests guarding the baseline tomorrow. This is precisely the interface between observability and the main theme of this chapter: observability is responsible for "seeing" what happens in the real world, and evaluation is responsible for solidifying those observations into repeatable standards.
Observability faces several challenges:
- Trade-off between data volume and privacy: High-traffic systems can generate terabytes of trace data daily, while also needing to comply with data protection regulations.
- Complexity of causal attribution: Automatically identifying root causes from traces still requires more intelligent analysis algorithms; cutting-edge research is attempting causal inference and counterfactual analysis, but it is not yet mature.
- Tracing challenges in multi-Agent systems: Tracing execution flows across multiple Agents is more complex and semantically richer than tracing API calls between microservices.
- Balance between real-time guardrails and post-hoc analysis: High-risk scenarios require proactive guardrails, but these introduce additional latency and false positives.
As ML technology becomes more deeply integrated into the toolchain, future observability platforms are expected to automatically identify anomalies and pinpoint root causes.
With a comprehensive evaluation system and dataset in place, the key is to translate evaluation results into tangible system improvements.
Từ Báo cáo Benchmark đến Cải thiện Hệ thống
Case study sau đây đến từ iteration AndroidWorld deliberately narrow trong kho đồng hành. Nó bao gồm bốn tác vụ cài đặt Wi-Fi trên emulator API 35, với một lần chạy ghép đôi mỗi tác vụ. Nó không phải full 116-task benchmark và không thay thế rerun trong môi trường tham chiếu API 33. Giá trị của nó không phải điểm tổng thể; nó là chuỗi quyết định từ một kết quả đến kết quả tiếp theo.
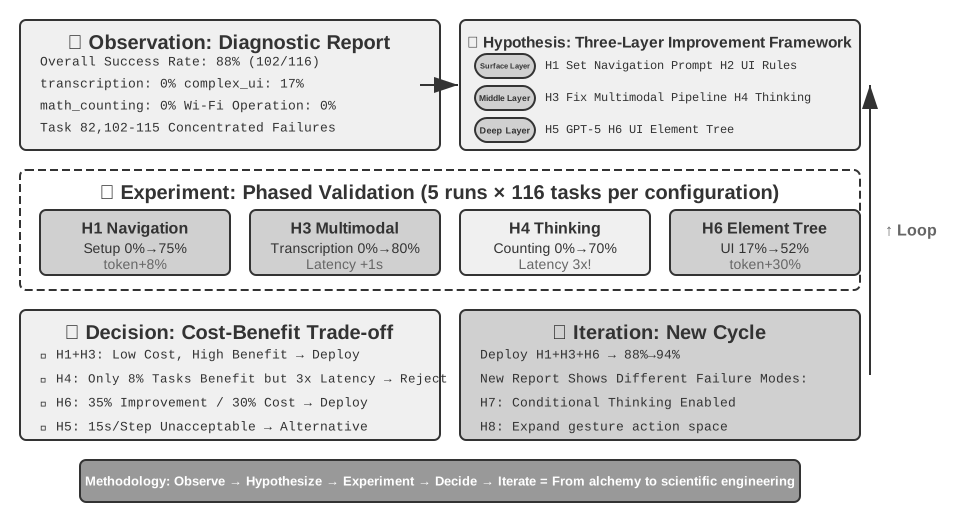
From the perspective of Harness engineering, this section is essentially about the methodology for iterative Harness optimization — using evaluation data to identify weak points in the Harness (insufficient context? missing constraints? inadequate validation? untimely feedback?), making targeted improvements, and then re-evaluating, forming a closed loop for the Harness's continuous evolution.
Before analyzing any benchmark report, note an easily overlooked principle: when Agent performance drops, check the evaluation system first, then the Agent. The common mistake is to start editing Agent code the moment a score falls, ignoring the possibility that the evaluation system broke first — steer by a distorted signal and the correction is wrong from the very first step. Typical evaluation-side failures include: the runtime environment running out of resources and killing processes (which shows up as random failures), bugs in the scorer that mark correct answers as failures, and test cases drifting out of sync with production scenarios. In the headline numbers, all of these look identical to model degradation; only a review of the full traces can tell them apart.
Đọc Báo cáo Benchmark: Nghệ thuật Phát hiện Vấn đề
Báo cáo ban đầu recorded one run on each of 116 tasks and about 88% overall success. The failures were not scattered: three of the four SystemWifiTurn* tasks failed, and their traces repeatedly navigated back and forth without confirming the final state. Two explanations fit the evidence: the Agent did not know where to go, or the UI representation it received was incomplete.
An 88% headline score hides this small but coherent failure cluster. Raising the step limit would be equally misleading — it could recast "the Agent cannot see the control" as "the Agent needs more persistence." Read reports in the opposite direction: locate clusters by task and capability tag, replay the traces, decide whether the failure arose in observation, reasoning, action, or verification, and only then choose a variable to change. The Wi-Fi slice was used to diagnose the mechanism cheaply, not to estimate system-wide performance.
Từ Dữ liệu đến Giả thuyết: Xây dựng Lộ trình Cải thiện
The first round tested the cheapest explanation. H1 assumed a navigation-knowledge gap, so only the treatment received Wi-Fi navigation and final-state-checking instructions. Success did not improve; the prompt was not the bottleneck.
The second round asked what the Agent could actually see. H5 replaced the API-35-incompatible accessibility feed with AndroidWorld's supported UIAutomator tree. Success improved, but the full tree caused token use to surge. H5C therefore added no new information: it simply removed invisible, textless, non-actionable container nodes to see whether the same success could be preserved with less noise.
Across all three rounds, the model, task parameters, seed, step limit, and emulator stayed fixed, and arm order alternated. This staged design made attribution straightforward: the residual problem or side effect from one round became the sole change in the next.
Từ Kết quả đến Quyết định: Đánh đổi Dựa trên Dữ liệu
| Thí nghiệm | Chỉ Thay đổi | Thành công Kiểm soát → Điều trị | Token Điều trị / Kiểm soát | Bước Tiếp theo |
|---|---|---|---|---|
| H1 | Thêm hướng dẫn điều hướng | 25% → 25% | 0,47× | Không tăng thành công; giữ prompt gốc |
| H5 | Accessibility feed → UIAutomator | 25% → 100% | 2,498× | Tăng mạnh nhưng quá đắt; tiếp tục tối ưu |
| H5C | Nén cây UIAutomator | 100% → 100% | 0,506× | Giữ thành công và giảm一半 token; tiến tới rerun đầy đủ |
The sequence matters more than any one percentage. More detailed instructions cannot restore information the Agent never received; observation failures should be investigated before prompts are expanded. But more input is not always better either. The full element tree fixed visibility while flooding the context with noise. Removing non-semantic nodes preserved four successful runs and cut tokens by roughly half. No model was changed: the Harness's UI representation first determined whether the task could be completed and then whether completing it was economical.
Lặp lại Liên tục: Từ Cải thiện Đầu tiên đến Tiến hóa Hệ thống
Passing H5C on four tasks only earns it a larger test; it does not authorize deployment. The next gate is a five-seed run over all 116 tasks in the Pixel 6 / API 33 reference environment with the full third-party app set. Success must be non-inferior, token use no more than 75% of the original, and latency no more than 1.5×. Until that run is complete, 4/4 on the slice must not be reported as 100% system-wide success.
That is what continuous iteration means in practice: evidence from one round should authorize only the next action that its scope can support. H1 stopped further prompt piling; H5 found the right mechanism and revealed a cost problem; H5C fixed that problem and qualified for broader testing. A good benchmark report contains more than a score. It states where the conclusion applies, which guardrails failed, and what must be tested next.
Thí nghiệm 6-12 ★★★: Đánh giá và Cải thiện trên AndroidWorld
Thí nghiệm này thực hành toàn bộ đường dẫn từ báo cáo đánh giá đến cải thiện hệ thống. Bắt đầu với báo cáo lịch sử và ba lần chạy ghép đôi saved trong
chapter6/android-world.Bước 1: Chẩn đoán. Phân tích chéo bảng theo tác vụ và ma trận tag khả năng để ánh xạ thất bại tác vụ bề mặt sang thiếu hụt khả năng sâu. Xác định tag khả năng có tỷ lệ thành công thấp hơn dự kiến và lĩnh vực tác vụ có thất bại tập trung.
Bước 2: Xây dựng Giả thuyết. Hình thành giả thuyết cải thiện theo framework ba tầng (bề mặt → giữa → sâu). Mỗi giả thuyết nên nêu mục tiêu cải thiện tỷ lệ thành công và phương pháp xác minh.
Bước 3: Thí nghiệm Phân giai đoạn. Tái tạo H1, H5 và H5C with one variable changed per round. Ghi lại token, độ trễ và thoái lui cũng như thành công.
Bước 4: Ra quyết định Dựa trên Dữ liệu. Đưa ra quyết định triển khai based on phân tích chi phí-lợi ích — không simply adopting tất cả improvements hiệu quả, but weighing phạm vi áp dụng, tác động độ trễ và overhead chi phí cho mỗi improvement. Ưu tiên triển khai improvements chi phí thấp, lợi ích cao; hạn chế improvements chi phí cao cho kịch bản quan trọng.
Bước 5: Lặp lại. Thí nghiệm lát cắt passing chỉ advances to rerun đầy đủ. Thảo luận triển khai only after 116×5 reference-environment run, and preserve environment differences, sample size và incomplete scope trong báo cáo.
Từ Đánh giá Ngoài đến Đánh giá Nội bộ: Cơ sở hạ tầng Đánh giá cho Agent Cấp Sản xuất
Cho đến nay chương này đã đánh giá hệ thống Agent từ bên ngoài — xây dựng môi trường đánh giá, thiết kế tập dữ liệu, phân tích báo cáo benchmark. Nhưng các sản phẩm Agent tốt nhất làm nhiều hơn undergo đánh giá bên ngoài; họ xây dựng cơ sở hạ tầng tự đánh giá liên tục vào trong sản phẩm. Below, using the open-source general-purpose Agent OpenClaw introduced in Chapter 5 as an example and drawing on public technical analyses of leading Coding Agent products and practitioner insights, we present an internal evaluation system worth emulating: one that systematically embeds the experimental methodology of ML research into product engineering.
Cơ sở hạ tầng Ablation: Hiểu Đóng góp Thực sự của Mỗi Tính năng
ML researchers have long used ablation studies to learn which components of a model actually matter — ablation means "removing" one component at a time and observing how much overall performance drops. OpenClaw brings this methodology into product engineering: a built-in master switch can disable several major features at once (thinking mode, context compression, automatic memory, background tasks, and more), creating a "bare model" baseline. That lets the team answer a key question: does a feature truly improve the user experience, or does it just feel useful?
Making ablation a routine engineering practice, rather than a one-time research activity, has several practical implications. First, the ablation switch must be injected very early in the startup path — before any module-level constant captures configuration values — meaning the ablation infrastructure must be designed into the system architecture from the start, not retrofitted later. Second, running ablation experiments regularly (e.g., before each major release) can uncover "feature debt" — features that were once effective but are no longer necessary as models evolve. For any team building a production Agent, the recommended practice is: Every major feature should be independently disableable, and the team should regularly verify the actual contribution of each feature.
Phương pháp A/B Testing: Phân biệt Cơ chế và Mục tiêu
Mature Agent products conduct rigorous A/B testing on their own behavior. A well-designed Agent A/B test case illustrates several key methodological principles:
Nhiều biến thể, not just a binary comparison. Thay vì chỉ so sánh "có" và "không", thiết kế nhiều biến thể tiến bộ (ví dụ: khi thử nghiệm các mức độ ràng buộc prompt khác nhau, thiết lập nhóm kiểm soát và ba nhóm thí nghiệm với ràng buộc increasingly strict hơn). Thiết kế này có thể揭示 mối quan hệ liều-phản ứng và help find the optimal point.
Phân biệt chỉ số cơ chế và chỉ số mục tiêu. Đây là lỗi dễ mắc nhất — treating what you are changing as the optimization target. Ví dụ, if you are testing "shortening the Agent's plan file length", plan length is a mechanism metric (something you directly change), but it is not the target. The real target might be "reducing session-level cost." Shortening the plan file may lower costs, but it could also lead to more edit-check-edit loops due to insufficiently detailed plans, increasing total output. Always ask yourself: Is what I am changing (the mechanism) the same as what I truly care about (the target)? If not, prioritize the target.
Đặt chỉ số guardrail. Ngay cả when target metric improves, the experiment should be stopped if user satisfaction declines, the number of operations increases, or the error rate rises. Guardrail metrics are non-negotiable thresholds that must not regress.
Ghi lại thống kê đường cơ sở. Bao gồm kích thước mẫu, phân phối percentiles và phân tích tương quan (ví dụ: "tỷ lệ từ chối tăng tuyến tính với kích thước plan") để cung cấp context cần thiết cho diễn giải kết quả thí nghiệm. Without a baseline, you cannot determine whether the experimental results are statistically significant.
Hệ thống Feature Flag Hai Tầng
Agent products need a Feature Flag infrastructure designed from day one — a feature flag is a remotely controllable switch that determines whether a function is enabled or disabled for users, without requiring code redeployment. It serves three purposes simultaneously: experimentation, gradual rollout, and emergency circuit breaking.
Compile-time flags physically remove the relevant code from the build artifact during the build phase. Internal-only features simply do not exist in external builds — even reverse engineering cannot discover the removed functionality. This also provides a clean ablation mechanism: disabling a feature does not skip logic at runtime; the corresponding code is physically absent.
Runtime flags have their configuration delivered by the server and cached locally on disk. The design prioritizes reading slightly stale cached configuration over blocking the Agent's startup while waiting for a network request. Specific grouping decisions are made through an experimentation platform (e.g., GrowthBook) for assigning A/B test groups. A key design detail is that each feature's exposure event is logged at most once per session to avoid duplicate records polluting the experimental data.
The lesson for Agent developers: feature flags are not debugging tools; they are first-class architectural components.
Đánh giá Nhạy cảm Prompt
The system prompt is the core "code" of Agent behavior, yet it often lacks the version control and regression testing afforded to regular code. OpenClaw's approach is to provide a dedicated tool that can extract the fully rendered system prompt at a specified Git revision or commit — including the final text after all dynamic conditions are expanded. This allows the team to precisely answer: Which commit changed the prompt? What was the impact on the evaluation set?
For any Agent team, the recommended practices are: (1) The system prompt should be deterministically renderable (given the same configuration input, it always produces the same output); (2) Establish a versioned snapshot mechanism for prompts; (3) Every prompt change should run regression tests on the evaluation set — just as code changes require CI.
Phân tích Nhận thức Bảo mật làm Nền tảng Đánh giá
Đánh giá relies on dữ liệu tốt, nhưng Agent products often handle sensitive user content. OpenClaw resolves this contradiction through a type system: the analytics interface only accepts values wrapped in special types, where the type name itself serves as an audit trail — it explicitly declares "I have verified this is not code or a file path." This design transforms privacy constraints from documented specifications into compile-time enforced type checks.
The core principle is: Design privacy constraints into the system from the start; do not bolt them on afterward. If your analytics system cannot safely collect data, you cannot evaluate effectively. Privacy and evaluation are not opposing forces — privacy-aware design forces you to think carefully about what truly needs to be measured, which in turn fosters more precise evaluation metrics.
Từ Ngoài vào Trong: Sự Chuyển đổi Tư duy Đánh giá
The core message of this section is: The previous sections taught you how to evaluate an Agent externally; this section reveals how the best Agent products evaluate themselves internally. External evaluation tells you "how good the Agent is"; internal evaluation infrastructure tells you "which change made it better." Ablation experiments discover which features truly matter, A/B testing quantifies the impact of each change, feature flags provide the infrastructure for experimentation and rollback, prompt sensitivity assessment integrates the system prompt into the CI system, and privacy-aware analytics ensures compliance in data collection. These five components together constitute evaluation-driven product engineering — not evaluating occasionally, but embedding evaluation into every product decision.
Môi trường Mô phỏng: Cầu nối từ Đánh giá đến Post-Training
The endpoint of evaluation is not scoring, but improvement. This chapter has already demonstrated two paths for improvement: adjusting the Harness (from Benchmark reports to system improvements) and embedding evaluation into product engineering (internal evaluation infrastructure). The strongest form of improvement is training — when the goal expands from "evaluating existing capabilities" to "cultivating new capabilities," especially through the post-training techniques discussed in Chapter 7, the evaluation environment needs to evolve into a simulation environment: a virtual playground where the Agent can repeatedly practice and be automatically scored. The core differences between simulation environments and evaluation environments are: much higher interaction frequency (millions vs. thousands), the need for randomization (to prevent memorizing specific configurations), and the requirement for immediate feedback.
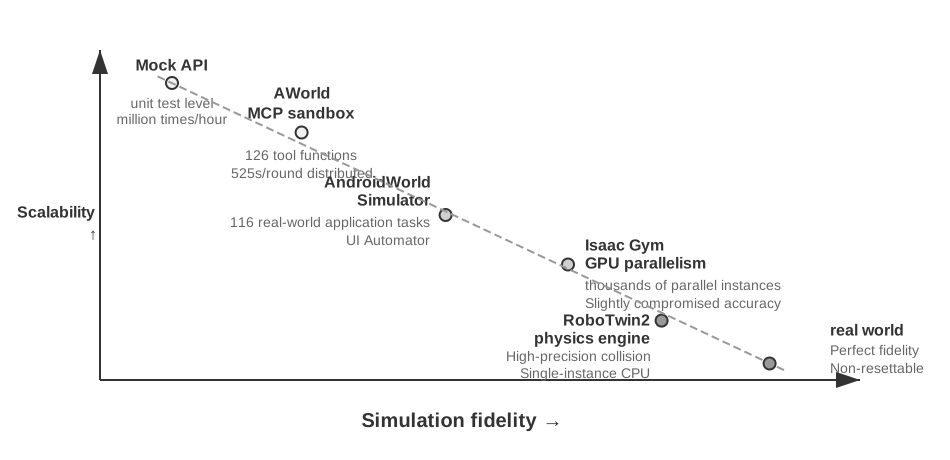
On the digital environment side, the AWorld framework builds a controllable MCP server sandbox for GAIA tasks, providing 26 MCP servers covering 126 tool functions, avoiding the bans and uncontrollable side effects of directly accessing real APIs. All tool calls are replayable and auditable. AWorld's distributed architecture reduces the traditional serial execution time from 7695 seconds to 525 seconds (a 14.6x speedup), and the environment's stateless design makes each instance completely independent, supporting efficient parallelism.
On the embodied environment side, RoboTwin2 builds dual-arm manipulation tasks based on a physics engine, randomizing object positions, orientations, and appearances to improve generalization. The observation space includes multi-camera visuals and joint states, achieving real-time control through Action Chunking — where the model plans multiple consecutive actions at once (detailed in Chapter 9). OSWorld provides reset capability through virtual machine snapshots, and AndroidWorld focuses on mobile application automation. Whether digital or embodied, simulation environments also require the isolated execution environments and virtual identity mechanisms discussed in Chapter 4 (VM/container isolation, residential proxies, Human-in-the-Loop authentication, shared file systems), which will not be repeated here.
Thí nghiệm 6-13 ★★: Cấu hình Môi trường Trí tuệ Thể hiện cho OpenVLA và RoboTwin2
Thiết lập môi trường mô phỏng cho thao tác robot. Đọc
ch7/SimpleVLA-RLvà tài liệu OpenVLA để hiểu kiến trúc của mô hình Vision-Language-Action (tích hợp end-to-end của encoder thị giác, mô hình ngôn ngữ và bộ giải mã hành động, projecting hình ảnh và văn bản vào không gian ngữ nghĩa dùng chung). Cấu hình môi trường RoboTwin2, hiểu không gian quan sát (RGB ba góc nhìn + trạng thái khớp 14 chiều) và không gian hành động (vector kiểm soát 14 chiều). Nghiên cứu cơ chế ngẫu nhiên hóa môi trường và logic ràng buộc không gian trongmove_can_pot. Đánh giá mô hình pretrain, ghi lại tỷ lệ thành công, thời gian hoàn thành và chế độ thất bại, with a focus on the impact of the action chunking mechanism.
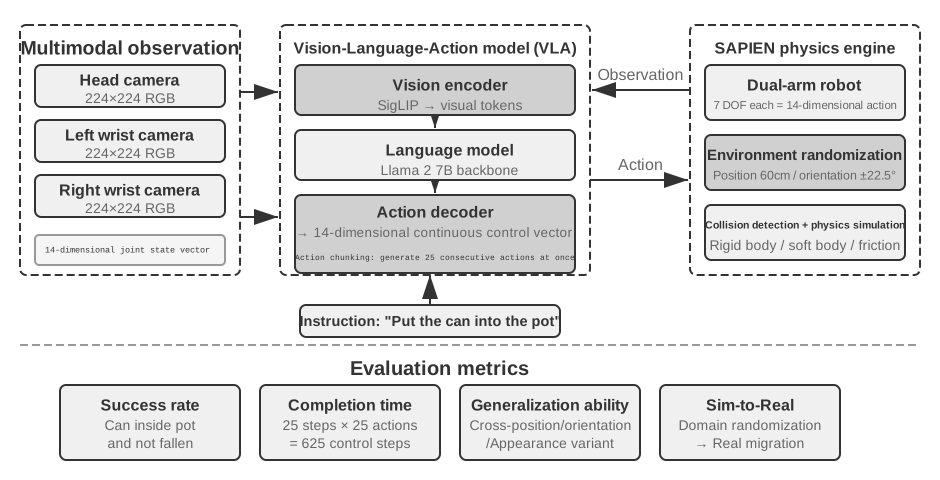
Đánh đổi Trung thực và Ngẫu nhiên hóa Miền
High-fidelity environments support better transfer to the real world but have high computational costs. Another dimension of fidelity is the degree of randomization: moderate randomization improves generalization, while excessive randomization can make tasks too difficult. Domain Randomization is a key technique for narrowing the sim-to-real gap: introducing a wide range of random variations in physical parameters, visual appearance, sensor noise, etc. — just like practicing grasping under various lighting and angles, so you won't fail in the real world just because the light changes. In digital environments, sim-to-real manifests as differences in interface rendering, response times, etc., which can be mitigated by introducing randomization in latency and failures.
With that, the evaluation environment completes its final evolution: from an exam hall that measures ability into a training ground that builds it. Chapter 7 will show how AWorld-train turns such simulation environments into trainable arenas, and the engineering challenges involved — the evaluation system and simulation environments established in this chapter are the two cornerstones of post-training.
Tóm tắt Chương
Chương này đã围绕 một câu hỏi: làm thế nào bạn biết Agent đã thực sự cải thiện? Từ xây dựng môi trường kiểm thử có thể tái tạo, đến thiết kế tập dữ liệu chịu được rò rỉ, đến sử dụng LLM như judge, đến để kết quả đánh giá驱动 lựa chọn mô hình và lặp lại — mỗi mắt xích trong chuỗi này ảnh hưởng đến mức độ kết luận có thể tin cậy được. Các case đo được thêm bốn cảnh báo cụ thể: kết hợp bộ nhớ có cấu trúc với RAG không đảm bảo synergy; tiết kiệm cache và nén không thể cộng dồn; lựa chọn âm thanh tham chiếu thay đổi ý nghĩa của điểm đa phương thức; và representation đầu vào của Harness có thể quyết định cả thành công tác vụ và chi phí token. Lựa chọn mô hình cũng nên so sánh đường cong tăng trưởng khả năng across ngân sách tài nguyên rather than relying on một điểm vận hành duy nhất. Đối với Agent cấp sản xuất, đánh giá không phải kỳ thi偶尔 mà là xác nhận liên tục embedded trong every quyết định sản phẩm.
Phương pháp luận cốt lõi: Quan sát → Giả thuyết → Thí nghiệm → Xác minh → Hiểu biết Mới → Giả thuyết Mới, chuyển đổi kỹ thuật Agent from kinh nghiệm-driven "giả kim thuật" sang dữ liệu-driven engineering khoa học.
Hệ thống đánh giá được giới thiệu trong chương này tạo thành vòng lặp hoàn chỉnh: Môi trường Đánh giá cung cấp cơ sở hạ tầng kiểm thử tự động → Tập dữ liệu Đánh giá xác định test case → Phương pháp Đánh giá Tự động (LLM-as-a-Judge và Rubric) chấm điểm hiệu suất Agent → Phân tích Benchmark揭示 hướng cải thiện → Cải thiện Hệ thống fix issues → Cập nhật môi trường đánh giá và tập dữ liệu, bắt đầu vòng lặp iteration mới.
From the perspective of Harness engineering introduced in Chapter 1, the evaluation methodology in this chapter is the systematic implementation of the Harness's "validation" function, while the closed loop "from Benchmark report to system improvement" is the core mechanism for iterative Harness optimization. This chapter answers "how to measure reliably"; building on it, Chapter 8 answers "how to transform multidimensional trajectory evaluations into executable, reversible system updates."
Hệ thống đánh giá established here not only supports optimization of the current system but also provides a critical foundation for the next two chapters. Chapter 7 turns evaluation environments and data into inputs for model post-training, using SFT and RL to write interaction policies into parameters. Chapter 8 transforms multidimensional evaluations of production trajectories into candidate updates to knowledge, instructions, programs, or parameters.
Câu hỏi Suy nghĩ
- ★★ LLM-as-a-Judge sử dụng mô hình ngôn ngữ để đánh giá đầu ra của mô hình ngôn ngữ. "Tự đánh giá" này có điểm mù có hệ thống không — ví dụ, mô hình có thể consistently cho điểm cao cho một phong cách phản hồi nhất định, sở thích không nhất quán với phán đoán con người? Làm thế nào để phát hiện và sửa chữa các thiên vị như vậy?
- ★★★ Thiết kế "chống rò rỉ" của tập dữ liệu đánh giá rất quan trọng. Tuy nhiên, trong hệ sinh thái mã nguồn mở, once benchmark data is made public, it is quickly incorporated into training data. "Trò chơi mèo và chuột" này có hồi kết không? Thiết kế phương pháp đánh giá fundamentally chống lại rò rỉ dữ liệu.
- ★★ Bốn tiêu chí của Scale AI (hướng dẫn chuyên gia, bao phủ toàn diện, trọng số quan trọng chuẩn hóa, đánh giá tự chứa)旨在 loại bỏ chủ quan trong đánh giá. Tuy nhiên, certain task dimensions (ví dụ: "Câu trả lời có hữu ích không?" "Giọng có phù hợp không?") inherently chủ quan. Làm thế nào để thiết kế Rubric đáng tin cậy cho các chiều chủ quan này?
- ★★ τ-bench đánh giá Agent bằng cách mô phỏng hành vi người dùng thực. Nhưng chính trình giả lập người dùng là LLM — nó có thể systematically underestimate certain edge cases (ví dụ: người dùng kích động cảm xúc hoặc unclear). Làm thế nào để xác nhận chất lượng của chính trình giả lập người dùng?
- ★★ So sánh cặp (mô hình Bradley-Terry) giả sử preferences are transitive (nếu A > B và B > C, then A > C). Tuy nhiên, sở thích con người often violate tính bắc cầu. Trong đánh giá Agent, kịch bản nào có thể xuất hiện preferences không bắc cầu? Điều này ảnh hưởng độ tin cậy của bảng xếp hạng như thế nào?
- ★★ Chương này đề xuất phương pháp khoa học "Quan sát → Giả thuyết → Thí nghiệm → Xác minh." Trong thực tế, tuy nhiên, không gian hành vi Agent is vast, và xác nhận a single giả thuyết có thể yêu cầu hàng trăm lần chạy đánh giá. Làm thế nào để tối đa hóa thông tin thu được từ đánh giá under ngân sách tính toán giới hạn?
- ★ Trong pilot AndroidWorld, full element tree nâng thành công từ 25% lên 100% nhưng tăng token use lên 2,498× kiểm soát; pruning preserved 100% thành công while giảm token use xuống 0,506×. Bạn sẽ thiết kế quy tắc pruning tự động that loại bỏ nodes UI semantic trống mà không discard thông tin cần thiết cho accessibility, xác minh trạng thái, hoặc hành động后续?
- ★★ User simulation của τ-bench sử dụng "progressive information disclosure" — không cung cấp tất cả thông tin cùng lúc, mà gradually revealing nó based on Agent's questions. Thiết kế này ảnh hưởng kết quả đánh giá thế nào? Nếu chiến lược tiết lộ thông tin của trình giả lập người dùng khác significantly so với người dùng thực, kết luận đánh giá có còn đáng tin cậy không?