Các Agent ngày nay đối mặt với một nghịch lý năng lực đáng chú ý: chúng có thể giải quyết các tác vụ phức tạp chưa từng thấy trước đó ở chế độ zero-shot, nhưng sau khi xử lý mười nghìn tác vụ tương tự, chúng vẫn có thể lặp lại những sai lầm của ngày đầu tiên vào ngày mai. Khả năng tự học từ kinh nghiệm đang trở nên thiết yếu để các Agent tiến bộ từ "có thể hoàn thành tác vụ" sang "có thể làm việc đáng tin cậy," và đây cũng là chủ đề nghiên cứu trọng tâm cho thế hệ mô hình tiếp theo. Tuy nhiên, các mô hình hiện tại vẫn còn rất xa khả năng tự học liên tục.
Một mô hình đã triển khai không tự động thay đổi tham số sau mỗi lần suy luận. Việc học trong ngữ cảnh (in-context learning), duy trì trạng thái và nén được thảo luận trong Chương 2 cho phép một Agent thích nghi trong phạm vi tác vụ hiện tại; tuy nhiên, khi ngữ cảnh kết thúc, những thay đổi này không tự nhiên chuyển sang tác vụ tiếp theo. Lưu trữ hội thoại trong bộ nhớ không tương đương với việc học hành vi mới. Các thô (raw trajectory) có thể dài dòng và chứa cả chiến lược hiệu quả lẫn những thành công ngẫu nhiên, phân bổ sai và đầu vào không đáng tin.
Một sự phân biệt quan trọng dễ bị bỏ lỡ ở đây: giữ lại kinh nghiệm không giống với học từ kinh nghiệm. Đặt một trăm quỹ đạo vào ngữ cảnh dài hoặc kho vector có thể giúp mô hình truy xuất một trường hợp khi cần, nhưng nó không tự động so sánh các trường hợp: bước nào lặp lại trong các quỹ đạo thành công, phương pháp nào chỉ hoạt động với giao diện cũ hơn, hay liệu một thành công đến từ chiến lược đúng đắn chứ không phải may mắn từ môi trường. Học chỉ xảy ra khi hệ thống chủ động đánh giá, so sánh, tổng quát hóa và xác minh bằng chứng — chứ không phải khi một bản ghi được ghi vào đĩa. Bộ nhớ người dùng trong Chương 3 chủ yếu nắm bắt "người dùng và thế giới như thế nào"; học kinh nghiệm trong chương này đi xa hơn, nắm bắt "nên làm gì trong điều kiện nào." Điều trước giúp Agent nhớ nhiều hơn; điều sau giúp nó trở nên thành thạo hơn chứ không chỉ đơn thuần hiểu biết hơn.
Tại sao không để mô hình tự đào tạo ngay sau mỗi tác vụ? Bởi vì môi trường sản xuất hiếm khi cung cấp tín hiệu học tập sạch. Sự hài lòng của người dùng không ngụ ý tuân thủ, và các bài kiểm tra có thể vượt qua vì các trường hợp thất bại đã bị xóa. Ngay cả một cập nhật cục bộ cũng có thể gây ra quên năng lực, trôi chính sách hoặc suy giảm an toàn. Nếu một mô hình đang chạy được phép tự sửa đổi trực tiếp dựa trên phản hồi chưa được xác minh, kinh nghiệm sai và Prompt injection có thể trở nên cố hữu và tiếp tục khuếch đại qua các tác vụ sau. Đào tạo định kỳ các mô hình nền tảng có thể cải thiện năng lực chung, nhưng nó không thể hấp thụ kịp thời các quy tắc riêng, thay đổi công cụ và kinh nghiệm địa phương mà mỗi Agent gặp phải hàng ngày.
Do đó, trong khi bản thân các mô hình chưa thể học liên tục và đáng tin cậy, "học" trước tiên phải được xây dựng như một hệ thống tự trị xung quanh mô hình: ghi lại bằng chứng vận hành, xác minh kết quả và quy trình, trích xuất các mẫu chung từ nhiều quỹ đạo, và sau đó quyết định có nên cập nhật kiến thức, hướng dẫn, chương trình hay tham số mô hình hay không. Mỗi sửa đổi trước tiên phải trở thành một phiên bản ứng viên và chỉ có thể thay đổi vòng vận hành tiếp theo sau khi kiểm thử hồi quy và kiểm tra an toàn. Điều này không thay thế khả năng học của mô hình; đúng hơn, trong các ràng buộc kỹ thuật hiện tại, đây là một con đường kỹ thuật để trao cho các Agent khả năng học liên tục.
Các chương trước đã giới thiệu các thành phần chính mà hệ thống này yêu cầu. Chương 2 đề cập đến trạng thái trong phạm vi tác vụ, Chương 3 cung cấp hạ tầng kiến thức, Chương 5 trao cho Agent siêu năng lực để tạo công cụ và sửa đổi hệ thống, Chương 6 thiết lập đánh giá và xác minh, và Chương 7 giải thích cách cập nhật tham số mô hình. Nhiệm vụ của Chương 8 là tổ chức các thành phần này thành vòng lặp evolution liên tục như minh họa trong Hình 8-1.
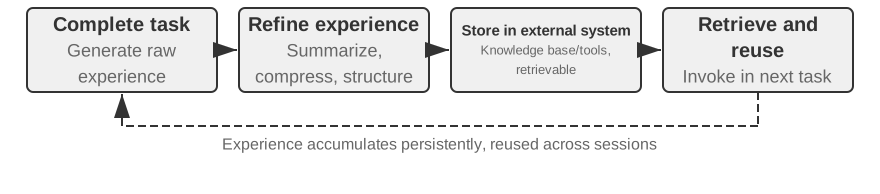
Evolution liên tục phải bắt nguồn từ kinh nghiệm vận hành có thể truy vết, thay đổi hành vi tiếp theo, và được xác minh là không gây ra suy giảm đáng kể. Chương này trước tiên thảo luận cách xác định chính xác điều gì đã diễn ra tốt hoặc sai trong một lần chạy; sau đó so sánh bốn phương pháp cập nhật và ranh giới áp dụng của chúng; cuối cùng, xem xét cách các cập nhật này được xác minh, phát hành, sửa đổi và loại bỏ trong quá trình vận hành dài hạn.
Trích xuất tín hiệu học tập từ các quỹ đạo vận hành
Điểm khởi đầu của evolution liên tục không phải là "tóm tắt," mà là "đánh giá." Nếu hệ thống không biết liệu một tác vụ đã hoàn thành hay bước nào gây ra thành công hay thất bại, các phản tư do mô hình ngôn ngữ tạo ra chỉ có thể là phỏng đoán. Khi một đánh giá sai xâm nhập vào kiến thức dài hạn, Prompt hệ thống hoặc dữ liệu đào tạo, tác động của nó có thể lan truyền qua các tác vụ tiếp theo.
Kết quả của một số tác vụ tương đối dễ xác minh. Một Coding Agent có thể chạy kiểm tra, kiểm tra kiểu và benchmark hiệu suất; một Agent xử lý hoàn tiền cho người dùng có thể truy vấn trạng thái đơn hàng và số tiền hoàn thực tế. Các tín hiệu như vậy đến từ trạng thái môi trường thực và thường đáng tin cậy hơn mô tả của mô hình về hành vi của chính nó. Tuy nhiên, một kết quả đúng không ngụ ý quy trình đúng. Xóa các trường hợp kiểm tra thất bại cũng có thể làm cho kiểm tra vượt qua, trong khi nói với người dùng "Chúng tôi sẽ hoàn tiền trong bảy ngày; vui lòng kiên nhẫn" có thể tạo ra sự hài lòng tạm thời. Đánh giá đáng tin cậy do đó phải đánh giá cả kết quả và con đường đã đi để đạt được nó.
Nhiều tác vụ khác không có một câu trả lời đúng duy nhất. Dịch vụ khách hàng có kiên nhẫn hay không, có cung cấp các phương án tuân thủ hay không, báo cáo nghiên cứu có xác định bằng chứng quan trọng hay không, và văn bản được tạo ra có tự nhiên và súc tích hay không đều yêu cầu đánh giá theo ngữ cảnh. LLM-as-a-Judge, được giới thiệu trong Chương 6, có thể được sử dụng ở đây, nhưng người đánh giá không nên chỉ gán một điểm tổng thể mơ hồ. Phương pháp hiệu quả hơn là xác định trước một Rubric và yêu cầu người xác minh chấm điểm từng mục, trích dẫn bằng chứng từ quỹ đạo, và chỉ rõ sự không chắc chắn khi bằng chứng không đủ.
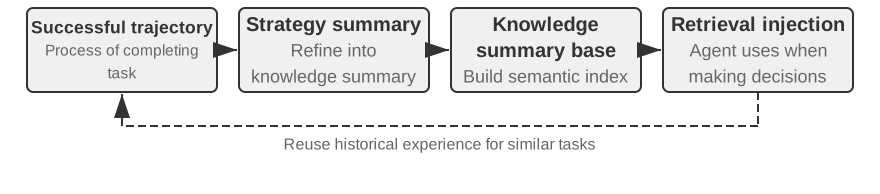
Hình 8-2 trình bày cấu trúc xác minh ba lớp. Trình xác minh kết quả ở lớp dưới đọc kết quả kiểm tra, trạng thái cơ sở dữ liệu và kết quả công cụ để trả lời "Tác vụ đã thực sự hoàn thành chưa?" Trình xác minh quy trình ở lớp giữa kiểm tra quy tắc kinh doanh, quyền và chuỗi hành động để trả lời "Nó đã được hoàn thành theo cách được phép chưa?" Trình xác minh chất lượng ở lớp trên đánh giá ngôn ngữ và chiến lược theo Rubric để trả lời "Nó đã được xử lý phù hợp chưa?" Các chỉ số cấp thấp hơn nên dựa nhiều hơn vào mã và ground truth môi trường; chỉ những khía cạnh khó hình thức hóa mới nên được ủy thác cho mô hình ngôn ngữ.
Đối với một Agent dịch vụ khách hàng, một Rubric hữu ích nên bao gồm ít nhất các chiều được liệt kê trong Bảng 8-1. Năm chiều đầu tiên chủ yếu thực thi yêu cầu cơ bản, trong khi hai chiều cuối đo lường chất lượng dịch vụ. Phân tích này hữu ích về mặt chẩn đoán hơn là hỏi liệu người dùng có hài lòng hay không: người dùng có thể hài lòng vì Agent đã hoàn tiền không tuân thủ, hoặc không hài lòng vì một hạn chế tuân thủ. Một điểm hài lòng đơn lẻ không thể phân biệt hai trường hợp.
Bảng 8-1: Các chiều đánh giá quỹ đạo cho Agent dịch vụ khách hàng
| Chiều | Câu hỏi xác minh | Bằng chứng chính |
|---|---|---|
| Kết quả tác vụ | Yêu cầu cốt lõi của người dùng đã được giải quyết chưa? | Trạng thái môi trường cuối cùng, kết quả công cụ |
| Tuân thủ quy tắc | Có chính sách, quyền hoặc quy trình bắt buộc nào bị vi phạm không? | Kho chính sách, quỹ đạo hành động |
| Ranh giới bảo mật | Có thông tin nào được tiết lộ mà lẽ ra không nên cung cấp không? | Văn bản phản hồi, bản ghi truy cập dữ liệu |
| Độ tin cậy thực tế | Các tuyên bố có được hỗ trợ bởi kiến thức hoặc kết quả công cụ không? | Nguồn được trích dẫn, kết quả công cụ |
| Nhất quán cam kết–hành động | Các hành động được tuyên bố là đã hoàn thành có thực sự xảy ra không? | So sánh phản hồi và nhật ký công cụ |
| Chất lượng diễn đạt | Ngôn ngữ có tự nhiên và súc tích, không lặp lại hoặc dùng mẫu câu không? | Toàn bộ hội thoại, Rubric ngôn ngữ |
| Phương án tuân thủ thay thế | Khi kế hoạch ban đầu không khả thi, có tìm được phương án được phép không? | Mục tiêu người dùng, chính sách và các hành động tiếp theo |
"Nhất quán cam kết–hành động" đặc biệt phù hợp với các kịch bản Agent. Đánh giá văn bản truyền thống chỉ đọc phản hồi cuối cùng và có thể dễ dàng coi "Tôi đã gửi yêu cầu hoàn tiền của bạn" là dịch vụ tốt. Đánh giá quỹ đạo thay vào đó tiếp tục kiểm tra xem công cụ hoàn tiền có thực sự được gọi không, cuộc gọi có thành công không, và trạng thái đơn hàng có thay đổi không. "Phương án tuân thủ thay thế" không khuyến khích mô hình bỏ qua quy tắc tùy tiện; nó yêu cầu mô hình hiểu mục tiêu thực sự của người dùng và, khi hoàn tiền không khả dụng, xem xét các phương án hợp pháp như đổi lịch, gia hạn hoặc bồi thường một phần.
Kết quả xác minh không nên được nén thành một giá trị vô hướng. Đánh giá quỹ đạo gần hơn với một chẩn đoán có cấu trúc: tác vụ thành công một phần và tuân thủ quy tắc đạt, nhưng có một tuyên bố không được hỗ trợ, một cam kết sai, và phản hồi lặp lại giải thích chính sách ba lần. Các tín hiệu theo chiều giữ lại cả bản chất của mỗi vấn đề và vị trí bằng chứng của nó. Chỉ khi đó các mô-đun hạ nguồn mới có thể xác định liệu một tuyên bố không được hỗ trợ phản ánh kiến thức thiếu, yêu cầu trích dẫn thiếu hay năng lực mô hình không đủ, và liệu một cam kết sai có cần sửa đổi Prompt hay kiểm tra nhất quán giữa phản hồi và trạng thái công cụ trong Harness.
Các trình xác minh LLM cũng yêu cầu hiệu chuẩn. Hệ thống sản xuất thường duy trì một tập hợp nhỏ các quỹ đạo được chuyên gia gán nhãn để kiểm tra tính nhất quán của trình xác minh trên mỗi chiều; các trường hợp rủi ro cao hoặc độ tin cậy thấp được chuyển đến mô hình thứ hai hoặc người đánh giá; và tập hiệu chuẩn được chạy lại sau khi thay đổi phiên bản mô hình. Trình xác minh nên cung cấp đánh giá và bằng chứng, trong khi một mô-đun chẩn đoán và evolution độc lập nên quyết định phần nào của Agent cần sửa đổi. Điều này ngăn cùng một mô hình vừa đóng vai trò thẩm phán vừa trực tiếp viết lại các quy tắc.
Thí nghiệm 8-1 ★★: Xây dựng trình xác minh quỹ đạo cho Agent dịch vụ khách hàng
Mục tiêu: Chuyển đổi một quỹ đạo dịch vụ khách hàng thành một chẩn đoán có cấu trúc có thể hỗ trợ học tập tiếp theo, và kiểm tra xem "kết luận đa chiều có bằng chứng" có xác định nguyên nhân gốc tốt hơn một điểm tổng thể đơn lẻ hay không.
Dữ liệu và quy trình: Chuẩn bị các quỹ đạo được chuyên gia gán nhãn bao gồm bốn loại: hoàn tiền bình thường, cam kết sai, tiết lộ bảo mật và từ chối quá mức. Lớp đầu tiên đọc trạng thái đơn hàng cuối cùng và nhật ký công cụ để xác định liệu hoàn tiền hoặc đổi lịch có thực sự xảy ra không. Lớp thứ hai kiểm tra mỗi bước so với chính sách kinh doanh, bao gồm quyền, quy trình bắt buộc, bảo mật, hỗ trợ thực tế và nhất quán cam kết–hành động. Lớp thứ ba đánh giá chất lượng ngôn ngữ và phương án tuân thủ thay thế theo Rubric trong Bảng 8-1 và giữ lại các lượt liên quan làm bằng chứng cho mỗi lỗi. Judge chất lượng mặc định sử dụng các quy tắc xác định, với Judge LLM thực cũng khả dụng. Bất kể mô hình lớp trên là gì, lớp kết quả và quy tắc không được để mô hình ngôn ngữ phỏng đoán.
Đối chứng và chỉ số: Đường cơ sở chỉ xuất điểm tổng thể; điều kiện thí nghiệm xuất
pass,failhoặcuncertaincho mỗi chiều, cùng với bằng chứng và độ tin cậy. Trong quá trình hiệu chuẩn, đo độ chính xác và độ thu hồi khi phát hiện lỗi ở mỗi chiều và báo cáo sự đồng thuận chính xác với nhãn chuyên gia. Cũng xác minh rằng các lỗi như cam kết sai chứa bằng chứng không rỗng thay vì kết luận không được hỗ trợ.Tiêu chí chấp nhận: Trình xác minh nên phát hiện đáng tin cậy các vi phạm nghiêm trọng, cam kết sai và từ chối quá mức. Điểm tổng thể cao không được che giấu lỗi bảo mật hoặc chính sách. Các trường hợp độ tin cậy thấp và rủi ro cao nên được gửi đến trình xác minh thứ hai hoặc đánh giá của con người thay vì tự động trở thành tín hiệu học tập.
Thực hiện đi kèm có sẵn tại
trajectory-verifier. Theo mặc định, nó sử dụng Judge chất lượng có thể tái tạo ngoại tuyến; sử dụng--judge llmđể chạy trình xác minh LLM thực đã triển khai.
Bốn phương pháp cho Evolution liên tục của Agent
Các tín hiệu học tập chỉ ra rằng một Agent nên thay đổi, nhưng không chỉ ra thay đổi nên xảy ra ở đâu. Cơ sở chính để chọn phương pháp cập nhật không phải là kinh nghiệm đã tồn tại bao lâu, mà là liệu năng lực đích có thể được biểu diễn tự nhiên bởi một phương tiện cụ thể hay không. Sự kiện và kinh nghiệm phù hợp với tài liệu kiến thức; chiến lược có thể được diễn đạt rõ ràng bằng ngôn ngữ thuộc về Prompt hoặc Skills; quy trình và ràng buộc có thể thực thi chính xác nên được mã hóa thành chương trình; và các năng lực chiều cao như nhận thức, phong cách ngôn ngữ và chiến lược ngầm phải đi vào tham số mô hình. Hình 8-3 minh họa bốn phương pháp này và mối quan hệ của chúng.
Bảng 8-2 cung cấp so sánh ngắn gọn. Bốn phương pháp không loại trừ lẫn nhau: một Agent hình ảnh y tế dựa vào tham số để xác định tổn thương, sử dụng cơ sở kiến thức để cung cấp hướng dẫn hiện hành, và sử dụng mã để tính toán chỉ số rủi ro. Một mô hình dịch vụ khách hàng có được giọng điệu tự nhiên từ post-training, lấy chính sách cụ thể doanh nghiệp từ kiến thức và Skills, và dựa vào mã phía máy chủ để thực thi yêu cầu tuân thủ quan trọng.
Bảng 8-2: Ranh giới áp dụng của bốn phương pháp evolution liên tục
| Phương pháp cập nhật | Nội dung phù hợp | Ưu điểm chính | Hạn chế chính |
|---|---|---|---|
| Cơ sở kiến thức kinh nghiệm | Sự kiện, mẫu kinh nghiệm, ngoại lệ và nguồn | Cập nhật nhanh, khả năng truy vết, truy xuất theo yêu cầu | Phụ thuộc vào truy xuất và ứng dụng mô hình đúng |
| Prompt và Skill | Nguyên tắc đánh giá và quy trình vận hành có thể diễn đạt bằng ngôn ngữ | Có thể giải thích, phạm vi kiểm soát | Dễ phình to, xung đột hoặc bị bỏ qua |
| Chương trình và Harness | Quy trình xác định, công cụ và ràng buộc cứng | Có thể kiểm tra, thực thi ổn định, chi phí thấp | Chi phí phát triển và bảo trì cao hơn |
| Tham số mô hình | Nhận thức chiều cao, phong cách tạo văn bản và chiến lược ngầm | Tổng quát hóa mạnh, chi phí suy luận thấp | Chi phí cập nhật và hồi quy cao |
Hợp nhất kinh nghiệm thành kiến thức
Dạng evolution nhẹ nhất là tổ chức kinh nghiệm lặp lại từ nhiều lần chạy thành tài liệu kiến thức có thể truy xuất. "Cơ sở kiến thức kinh nghiệm" được mô tả ở đây chia sẻ công nghệ lưu trữ, lập chỉ mục và truy xuất với Chương 3, nhưng khác biệt ở nguồn kiến thức và mục tiêu xác minh. Chương 3 chủ yếu trích xuất "người dùng và thế giới như thế nào" từ hội thoại người dùng, tài liệu và tập dữ liệu; chương này trích xuất "nên làm gì trong điều kiện nào" từ quỹ đạo hành động Agent và kết quả. Ví dụ, "Hãng hàng không này yêu cầu đặt bữa ăn đặc biệt trước hai mươi bốn giờ" là kiến thức lĩnh vực, trong khi "Kiểm tra thời hạn bữa ăn đặc biệt trước khi đặt vé để tránh phát hiện sau khi thanh toán rằng yêu cầu không thể được đáp ứng" là kinh nghiệm hành động.
Các quỹ đạo thô không phù hợp làm đơn vị kiến thức chính thức. Chúng dài và ồn, chứa đầu ra công cụ thô, các đường vòng ngẫu nhiên và chi tiết môi trường. Một hệ thống mạnh mẽ hơn giữ lại ba lớp dữ liệu: các quỹ đạo thô bất biến để kiểm toán; phân tích cho mỗi lần chạy ghi lại kết quả và bài học ứng viên; và so sánh, phân nhóm và quy nạp qua nhiều quỹ đạo tương tự để tạo ra tài liệu kiến thức Markdown hướng tới tương lai. Một tài liệu chính thức thường chỉ rõ kịch bản áp dụng, chiến lược được khuyến nghị, thực hành bị cấm, ngoại lệ, nguồn bằng chứng và thời gian xác minh gần nhất thay vì kể lại toàn bộ quá trình của một tác vụ duy nhất.
Thiết kế này chia sẻ cùng nguyên tắc hai giai đoạn như User-as-Code trong Chương 3. User-as-Code trước tiên nối các sự kiện hội thoại vào nhật ký bất biến và sau đó định kỳ xây dựng lại mô hình người dùng có cấu trúc. Học kinh nghiệm cũng nên bảo tồn bằng chứng trước và tạo kiến thức có thể thay đổi ngoại tuyến sau. Hình 8-4 minh họa quy trình này. Tách ghi chép khỏi tổ chức ngăn một thành công ngẫu nhiên hoặc lỗi mạng thay đổi Agent ngay lập tức, đồng thời cho phép hệ thống xác định các mẫu chung chỉ sau khi quan sát nhiều thành công và thất bại.
Tài liệu kinh nghiệm không phải là tóm tắt quỹ đạo đơn giản. Nội dung có thể chuyển nhượng xuất hiện từ so sánh: các quỹ đạo thành công cùng loại đã làm gì, các quỹ đạo thất bại thiếu gì, chiến lược hiệu quả trong phiên bản môi trường nào, và nó thất bại trong điều kiện tiên quyết nào. Chương 3 đã giới thiệu trích xuất kiến thức, phân nhóm và truy xuất, nên chương này không lặp lại các thuật toán đó. Thay vào đó, nó tập trung vào cách đánh giá quỹ đạo trở thành điều kiện cho trích xuất và liệu kiến thức được trích xuất có cải thiện hiệu suất trên các tác vụ tiếp theo hay không.
Một pipeline chưng cất kiến thức hoàn chỉnh có thể được chia thành năm bước. Đầu tiên, bảo tồn các quỹ đạo bất biến và kết quả môi trường. Tiếp theo, tạo một phân tích có cấu trúc cho mỗi lần chạy, liệt kê loại tác vụ, năng lực yêu cầu, chiến lược quan sát được, lỗi và ngoại lệ. Sau đó tổng hợp các lần chạy theo nhóm tác vụ và xây dựng bảng bằng chứng cho thấy quỹ đạo nào hỗ trợ hoặc mâu thuẫn với mỗi mẫu ứng viên. Chỉ các ứng viên đáp ứng ngưỡng hỗ trợ mới đi vào tài liệu chính thức. Cuối cùng, đánh giá khả năng chuyển giao trên các tác vụ mới không được sử dụng trong quá trình chưng cất. Giữ kiến thức chính thức tách biệt khỏi phân tích ứng viên cho phép hệ thống tổng quát hóa lại mà không thay đổi bằng chứng ban đầu và thu hồi một kết luận chính xác khi môi trường thay đổi.
Học kinh nghiệm GAIA cung cấp một ví dụ trực quan. GAIA[^gaia-2023] chứa các vấn đề đa bước kết hợp tìm kiếm, đọc web, xử lý tệp và tính toán, trong khi AWorld[^aworld-2025] cung cấp môi trường để chạy Agent, gọi các công cụ đó và ghi lại quỹ đạo: cái trước giống như bài kiểm tra, và cái sau là phòng thi và hệ thống ghi chép phòng thí nghiệm. Phương pháp đơn giản tạo tóm tắt chiến lược và ngay lập tức vector hóa nó sau một lần chạy thành công. Thực hiện nghiêm ngặt hơn trước tiên sử dụng trình xác minh câu trả lời GAIA hoặc trình xác minh môi trường khác để gán nhãn các lần chạy là thành công, thành công một phần hoặc thất bại, và sau đó so sánh nhiều đường dẫn trong cùng một nhóm tác vụ. Các quỹ đạo thành công đóng góp chiến lược ứng viên, thất bại đóng góp kiến thức loại trừ, và thành công một phần tiết lộ phần nào hoạt động và phần nào vẫn thất bại. Phản tư ngôn ngữ tự nhiên được đề xuất bởi Reflexion[^reflexion-2023] có thể giúp tạo bài học ứng viên, nhưng bản thân phản tư không phải là bằng chứng. Chỉ nội dung nhất quán với kết quả môi trường, được hỗ trợ qua các quỹ đạo, và cho thấy chuyển giao tích cực trên các tác vụ mới mới nên đi vào tài liệu kinh nghiệm chính thức.
Thí nghiệm 8-2 ★★: Chưng cất tài liệu kiến thức kinh nghiệm từ quỹ đạo GAIA
Mục tiêu: Kiểm tra xem tài liệu kiến thức liên quỹ đạo có chuyển giao tốt hơn tóm tắt của một lần thành công đơn lẻ và giảm chuyển giao tiêu cực từ thành công ngẫu nhiên và kinh nghiệm sai hay không.
Dữ liệu và quy trình:
gaia-experiencetrước tiên lưu trữ toàn bộ quỹ đạo vàenvironment_scorebên ngoài cho mỗi lần chạy, sau đó chuyển đổi chúng thành bản ghi học tập tối thiểu chứatask_family,capabilitiesyêu cầu,applies_when, chiến lược quan sát được, lỗi, ngoại lệ và ID quỹ đạo nguồn. Trình xác minh kết quả phân loại các lần chạy là thành công, thành công một phần hoặc thất bại. Mô-đun học tập so sánh các đường dẫn trong cùng một nhóm tác vụ. LLM có thể đề xuất các tổng quát hóa ứng viên, nhưng một chiến lược được khuyến nghị phải được hỗ trợ bởi ít nhất hai quỹ đạo không thất bại. Tài liệu Markdown kết quả bao gồm kịch bản áp dụng, chiến lược được khuyến nghị, cạm bẫy thường gặp, ngoại lệ, nguồn gốc và thời gian xác minh gần nhất. Trong quá trình áp dụng, chỉ những tài liệu này được truy xuất; các quỹ đạo thô dài không được chèn trực tiếp vào ngữ cảnh.Ba đối chứng: Điều kiện đầu tiên không sử dụng kinh nghiệm lịch sử; điều kiện thứ hai truy xuất tóm tắt quỹ đạo tương tự nhất với tác vụ hiện tại; điều kiện thứ ba truy xuất tài liệu kiến thức được hỗ trợ bởi nhiều quỹ đạo. Tập học tập và tập chuyển giao phải không giao nhau để câu trả lời cho cùng một câu hỏi GAIA không rò rỉ vào đánh giá dưới dạng "kinh nghiệm."
Chỉ số và chấp nhận: Báo cáo tỷ lệ thành công tác vụ chuyển giao, ký tự hoặc Token truy xuất trung bình và tỷ lệ chuyển giao tiêu cực, và xác minh rằng mỗi kết luận chính thức trích dẫn quỹ đạo nguồn của nó. Nếu tài liệu liên quan chỉ đơn giản rút ngắn ngữ cảnh mà không cải thiện hiệu suất tác vụ mới, chúng không chứng minh kinh nghiệm đã học. Thí nghiệm cũng thất bại nếu một thành công ngẫu nhiên có thể được nâng cấp trực tiếp thành kiến thức chính thức hoặc nếu tài liệu không thể truy vết về quỹ đạo ban đầu của nó.
Thực hiện đi kèm có sẵn tại
gaia-experience.demo_documents.pychạy ngoại tuyến theo mặc định; với--extractor llm, một LLM thực có thể đề xuất các ứng viên kinh nghiệm liên quỹ đạo.
[^reflexion-2023]: Shinn, N., et al. Reflexion: Language Agents with Verbal Reinforcement Learning. arXiv:2303.11366, 2023.
[^gaia-2023]: Mialon, G., et al. GAIA: a benchmark for General AI Assistants. arXiv:2311.12983, 2023.
[^aworld-2025]: Yu, C., et al. AWorld: Orchestrating the Training Recipe for Agentic AI. arXiv:2508.20404, 2025.
Mã hóa kinh nghiệm thành hướng dẫn
Cơ sở kiến thức kinh nghiệm cung cấp tài liệu tham khảo cho Agent, trong khi Prompt và Skills mang tính quy phạm hơn. Khi nhiều quỹ đạo liên tục tiết lộ cùng một lỗi chiến lược, và mẫu có thể được diễn đạt rõ ràng bằng ngôn ngữ tự nhiên, hệ thống có thể nâng cấp nó từ "kinh nghiệm tham khảo" thành "quy tắc phải tuân theo." Các quy tắc áp dụng cho gần như tất cả tác vụ phù hợp để đưa vào Prompt hệ thống; các quy trình phức tạp chỉ áp dụng cho một lĩnh vực, dự án hoặc công cụ cụ thể tốt hơn nên được viết thành Skills theo yêu cầu hoặc tệp hướng dẫn dự án.
Học Prompt phục vụ vai trò khác so với kỹ thuật Prompt được thảo luận trong Chương 2. Chương 2 giải thích cách viết Prompt rõ ràng về cấu trúc, thân thiện với cache; phần này đề cập đến phản hồi sản xuất nào đủ để kích hoạt sửa đổi Prompt và các quy tắc mới nên được xác minh trước khi triển khai như thế nào. Sửa đổi không nên có nghĩa là viết lại toàn bộ Prompt hệ thống nhiều lần. Phương pháp đáng tin cậy hơn là tạo một diff tối thiểu từ một nhóm lỗi tương tự, chỉ rõ phạm vi quy tắc, kiểm tra xung đột với các quy tắc hiện có, và đánh giá nó so với các trường hợp ranh giới đã kích hoạt lỗi và một tập giữ lại các tác vụ cũ.
Trong một bài viết dài năm 2025, Andrej Karpathy tạm thời gọi có thể là một paradigm mới này là System Prompt Learning[^karpathy-system-prompt-learning]. Tóm tắt của ông là pretraining chủ yếu học kiến thức và fine-tuning chủ yếu định hình hành vi thói quen, trong khi một loại học tập khác của con người xảy ra khi chúng ta giải quyết một vấn đề và để lại ghi chú rõ ràng cho chính mình trong tương lai: "Lần sau tôi gặp loại vấn đề này, tôi nên thử phương pháp này trước." Ông so sánh một LLM không có sổ tay như vậy với nhân vật chính trong phim Memento và nhận xét rằng System Prompt Learning và reinforcement learning đều cải thiện hành vi từ kinh nghiệm nhưng sử dụng thuật toán cập nhật khác nhau — cái trước chỉnh sửa văn bản, trong khi cái sau thay đổi tham số thông qua gradient descent. Ví dụ của ông là một chỉ dẫn trong Prompt hệ thống của Claude lúc đó dài khoảng 17.000 từ yêu cầu mô hình đánh số và đếm rõ ràng từ, chữ cái hoặc ký tự trước khi trả lời, chính xác để xử lý các câu hỏi như "Có bao nhiêu chữ r trong strawberry?"
Trong một hệ thống Agent, điều này có nghĩa là biến các bài học có thể diễn đạt bằng ngôn ngữ thành các quy tắc ứng viên mà các lần chạy trong tương lai có thể đọc trực tiếp. So với kết quả thành công/thất bại dạng vô hướng, một chẩn đoán có bằng chứng hỗ trợ có thể xác định liệu lỗi nằm ở xác minh danh tính, chọn công cụ hay ranh giới chuyển tiếp, cho phép thay đổi ứng viên có mục tiêu hơn. Quan sát của Karpathy rằng đánh giá được hướng dẫn bởi kiến thức là một kênh phản hồi chiều cao hơn so với phần thưởng vô hướng giúp giải thích hiệu quả dữ liệu tiềm năng của phương pháp. Thông tin phong phú hơn không tự động đúng: phản hồi của một người dùng có thể chỉ áp dụng cho khách hàng đó hoặc một chính sách lỗi thời, vì vậy phân nhóm, phân tích phạm vi và kiểm tra hồi quy vẫn cần thiết.
Một số cách tiếp cận đã thiết lập tự động hóa tối ưu hóa Prompt theo các cách khác nhau. DSPy[^dspy-2023] coi một chương trình gồm nhiều cuộc gọi mô hình ngôn ngữ là một đối tượng có thể tối ưu hóa và tìm kiếm hướng dẫn và ví dụ trên một tập phát triển. OPRO[^opro-2023] yêu cầu mô hình ngôn ngữ đề xuất các ứng viên mới từ lịch sử Prompt và điểm của chúng. GEPA[^gepa-2025] sử dụng phản tư ngôn ngữ tự nhiên trên các quỹ đạo thất bại để tạo và chọn các ứng viên Prompt bổ sung. Các phương pháp này chủ yếu thực hiện tối ưu hóa hàng loạt trên các tập đánh giá ngoại tuyến; các diff sản xuất tối thiểu gần hơn với bảo trì liên tục, được kích hoạt bởi các trường hợp ranh giới mới quan sát và được thiết kế cho nguồn gốc, kiểm toán và rollback nhanh. Trong thực tế, tìm kiếm ngoại tuyến có thể thiết lập một phiên bản ban đầu mạnh, tiếp theo là các bản vá theo từng trường hợp cho các quy tắc sản xuất đuôi dài.
Ví dụ, một Agent dịch vụ khách hàng hàng không có thể chuyển tiếp sang người quá sớm khi người dùng thách thức một chính sách. Đánh giá quỹ đạo cho thấy nó không vi phạm quy tắc nhưng thiếu tính linh hoạt tuân thủ. Một bản vá ứng viên có thể yêu cầu Agent giải thích chính sách trước, xác định mục tiêu thực sự của người dùng và tìm kiếm các phương án được phép, chỉ chuyển tiếp khi người dùng yêu cầu rõ ràng hoặc vấn đề thực sự vượt quá quyền hạn của Agent. Nếu quy tắc mới giảm chuyển tiếp không cần thiết nhưng khiến Agent tiếp tục xử lý các sự cố an toàn lẽ ra nên được chuyển tiếp, nó đã thất bại kiểm tra hồi quy. Giá trị của học Prompt hệ thống nằm ở việc không tự động thêm nhiều văn bản hơn, mà liên tục làm rõ phạm vi quy tắc thông qua các trường hợp ranh giới sản xuất.
Học Skill tuân theo cùng nguyên tắc, nhưng với phạm vi cục bộ hơn. Một Skill có thể được hiểu như một sổ tay vận hành theo yêu cầu cho một công việc cụ thể: nếu nhiều kinh nghiệm cùng nhau tạo thành một quy trình yêu cầu bảo hiểm hoàn chỉnh, hệ thống có thể tạo hoặc sửa đổi Skill tương ứng. Một ứng viên Skill không nên chỉ tóm tắt một cuộc hội thoại; tối thiểu, nó nên chỉ rõ thời điểm tải, điều kiện tiên quyết, các bước vận hành, cạm bẫy đã biết, phương pháp xác minh và quỹ đạo nguồn. Hệ thống trước tiên tìm kiếm thư viện Skill hiện có cho các năng lực tương tự, ưu tiên patch cục bộ khi cùng quy trình đã tồn tại và chỉ tạo thư mục mới cho một năng lực thực sự độc lập. Điều này ngăn thư viện đầy các sổ tay khác tên nhưng trùng lặp lẫn nhau. Skill Creator của Anthropic[^anthropic-skill-creator] trình bày một vòng lặp nháp–kiểm tra–đánh giá–sửa đổi. Nó giải quyết cách tạo và cải thiện một Skill; những câu hỏi khó hơn vẫn là bằng chứng vận hành nào đủ để kích hoạt tạo, cách giải quyết xung đột và liệu sửa đổi có vượt qua kiểm tra hồi quy cụ thể lĩnh vực và tác vụ cũ hay không.
Thí nghiệm 8-9 ★★: Biến phản hồi thành Skill viết
Xử lý 20 cặp trước/sau trong
data/feedback_pairs.jsonthành ba đợt. Trích xuất các quy tắc ứng viên, hợp nhất các mẫu trùng lặp, phát hiện xung đột ngưỡng và tạoSKILL.mdcó nguồn gốc và phạm vi. Kiểm tra các quy tắc xác định trong mã và hiệu chuẩn quy tắc LLM trên mười ví dụ gold.Báo cáo phát hiện trên tập ranh giới tác vụ chưa hoàn thành, dương tính giả trên tập giữ văn bản bình thường và sự tăng trưởng số lượng quy tắc cùng nhau. Lần chạy thực đầu tiên tạo ra 0/8 phát hiện và 7/8 dương tính giả; sau khi lọc bên ngoài mô hình và dự phòng xác định, nó tạo ra 8/8, 0/8 và hợp nhất 21 ứng viên thành 8 quy tắc. Thực hiện:
ai-style-skill.
Trường hợp dấu ngoặc cong cho thấy tại sao một Skill nên trở thành hợp đồng dữ liệu thay vì quy tắc thay thế toàn cầu: các ví dụ tổng hợp phải được phân tầng theo loại bài báo, phạm vi và ngôn ngữ lập trình, vượt qua các cổng code/JSON/vùng được bảo vệ và nhận kiểm toán thủ công trước SFT. Trường hợp chuỗi chính xác thêm kiểm toán tokenizer: mã hóa→giải mã vòng lặp, sao chép byte-chính xác của mô hình, tuần tự hóa Harness và khớp công cụ là các lớp hồi quy riêng biệt.
Thí nghiệm 8-3 ★★: Tối ưu hóa Prompt hệ thống từ quỹ đạo thất bại
Mục tiêu: Dạy một Agent dịch vụ khách hàng hàng không từ các quỹ đạo mà nó chuyển tiếp quá nhanh khi người dùng thách thức chính sách, đồng thời chứng minh rằng quy tắc mới không phá vỡ các kịch bản cũ thực sự yêu cầu chuyển tiếp.
Quy trình: Đầu tiên chạy tập giữ lại tác vụ cũ và tập ranh giới chuyển tiếp quá mức riêng biệt.
learning_signal.pyphân tích lỗi thành tuân thủ quy tắc, giải quyết tác vụ và tính linh hoạt tuân thủ, đồng thời giữ lại ID trường hợp nguồn. Sau đó một Coding Agent đọc Prompt hiện tại và tạo chính xác một chỉnh sửa tối thiểu có thể kiểm toánold_str → new_str: yêu cầu Agent giải thích chính sách, xác định mục tiêu thực sự và tìm kiếm các phương án tuân thủ trước khi chuyển tiếp, đồng thời giữ chuyển tiếp khi người dùng yêu cầu rõ ràng người hoặc xảy ra sự cố an toàn. Bản vá, nguồn gốc, quy tắc đích và lý do được ghi vào manifest ứng viên.Ba đối chứng: So sánh Prompt ban đầu, Prompt ứng viên được tạo tự động và Prompt được tối ưu hóa thủ công một lần. Cả ba sử dụng cùng mô hình và cùng các tác vụ giữ lại và ranh giới.
--quickchỉ giảm số lượng trường hợp; nó vẫn gọi thực đến task Agent, LLM Judge và Coding Agent và không được báo cáo như mô phỏng ngoại tuyến.Cổng phát hành và chỉ số: Một ứng viên phải vượt qua bốn điều kiện: bản vá không rỗng, nguồn gốc có thể truy vết, cải thiện có thể đo lường trên tập ranh giới và không suy giảm trên tập giữ lại. So sánh độ chính xác tác vụ ranh giới, độ chính xác tác vụ giữ lại, tăng trưởng Prompt, hồi quy được giới thiệu và thời gian từ phát hiện lỗi đến tạo ứng viên. Vượt qua cổng chỉ tạo
release_to_canary, không bao giờ ghi đè trực tiếp Prompt ổn định; thất bại bất kỳ điều kiện nào trả vềreject_candidate.Thực hiện đi kèm có sẵn tại
prompt-auto-optimization. Kiểm tra ngoại tuyến bao gồm chẩn đoán và cổng phát hành, trong khi--quickgọi thực đến task Agent, LLM Judge và Coding Agent.
[^dspy-2023]: Khattab, O., et al. DSPy: Compiling Declarative Language Model Calls into Self-Improving Pipelines. arXiv:2310.03714, 2023.
[^opro-2023]: Yang, C., et al. Large Language Models as Optimizers. arXiv:2309.03409, 2023.
[^gepa-2025]: Agrawal, L., et al. GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning. arXiv:2507.19457, 2025.
[^karpathy-system-prompt-learning]: Karpathy, A. "We're missing (at least one) major paradigm for LLM learning … system prompt learning?" X, May 11, 2025. https://x.com/karpathy/status/1921368644069765486
[^anthropic-skill-creator]: Anthropic. Skill Creator. 2026. https://github.com/anthropics/skills/blob/main/skills/skill-creator/SKILL.md
Mã hóa kinh nghiệm thành chương trình
Khi kinh nghiệm mô tả các hoạt động ổn định, lặp lại và có thể xác minh, việc để mô hình đọc lại tài liệu và suy luận qua chúng mỗi lần là không hiệu quả. Phương pháp phù hợp hơn là biên dịch kinh nghiệm thành workflow, công cụ hoặc mã Harness, biến một lần khám phá thành chương trình có thể thực thi lặp lại. Chương 5 đã giải thích cách Coding Agent đọc và ghi tệp, chạy kiểm tra và tạo hệ thống; phần này tập trung không vào tạo mã chung, mà vào cách Agent sửa đổi các phiên bản tương lai của chính nó dựa trên quỹ đạo của riêng nó.
Các đối tượng có thể sửa đổi mở rộng ra xa hơn các công cụ mới. Ở lớp vận hành, các quỹ đạo trình duyệt có thể được biên dịch thành workflow tham số hóa, hoặc adapter có thể được tạo cho API thay đổi. Ở lớp điều khiển, định tuyến công cụ, thử lại, ngắt mạch và chiến lược nén ngữ cảnh có thể được sửa đổi. Ở lớp xác minh, kiểm tra tham số, trình xác minh trạng thái và kiểm tra hồi quy có thể được thêm vào để phản ứng với lỗi sản xuất. Ở lớp kiến trúc, một Reviewer Agent có thể được thêm vào hoặc luồng thông tin giữa lập kế hoạch và thực thi có thể được thay đổi.
Các workflow trình duyệt minh họa giá trị của kinh nghiệm lập trình. Chúng tương tự với việc ghi macro bảng tính. Lần đầu tiên gửi email, một Agent đa chế độ sử dụng vòng lặp quan sát–suy luận–hành động để tìm các điều khiển soạn, người nhận, tiêu đề, nội dung và gửi. Cho một email khác, quy trình không thay đổi; chỉ người nhận và nội dung khác nhau, vì vậy không cần gọi mô hình lại để khám phá lại toàn bộ đường dẫn từ pixel và DOM. Hệ thống biên dịch quỹ đạo khám phá đầu tiên thành một chương trình nhỏ chứa tham số, kiểm tra trạng thái và thông tin phiên bản.
Trong bối cảnh trình duyệt, quy trình chưng cất kiến thức shown in Hình 8-4 trở thành một vòng đời cụ thể hơn:
- Bắt quỹ đạo: Ghi lại điều hướng, nhấp chuột, nhập văn bản và chọn thả xuống, cùng với tham số hành động, URL hiện tại và bằng chứng định vị phần tử như XPath, CSS,
id,role,aria-labelvàdata-testid. Bằng chứng định vị chỉ giúp tìm lại phần tử; nó không chứng minh rằng tác vụ đã hoàn thành. - Tham số hóa: Thay thế các literal từ lần chạy đầu tiên bằng biến mẫu — ví dụ, chuyển đổi
test@example.com, tiêu đề và nội dung thành{recipient},{subject}và{content}— đồng thời giữ nguyên các hành động ổn định. Thực hiện giảng dạy sử dụng biểu thức chính quy và thay thế mẫu; hệ thống sản xuất có thể sử dụng đầu vào tác vụ có cấu trúc hoặc mô hình trích xuất bị ràng buộc. - Xác định kiểm tra trạng thái: Thêm kiểm tra trước và sau hành động, như "nút gửi hiển thị" và "URL sau điều hướng thuộc trang đích." Thêm kiểm tra trạng thái cuối cùng cho toàn bộ workflow, như "danh sách thư đã gửi chứa tin nhắn mới" hoặc "giá trị trạng thái trang thử nghiệm thay đổi như mong đợi." Thực thi thành công một hành động không giống với hoàn thành thành công tác vụ; kiểm tra cuối cùng phải đọc trang thực hoặc trạng thái backend.
- Xác minh ứng viên: Một lần thành công đầu tiên chỉ tạo ra một
candidate. Hệ thống phải đặt lại tài khoản sandbox hoặc trang thử nghiệm về trạng thái ban đầu độc lập và phát lại ứng viên đầy đủ. Nó chỉ có thể được phát hành dưới dạngvalidatednếu tất cả kiểm tra trước hành động, sau hành động và trạng thái cuối cùng vượt qua. Nếu một tác vụ có hiệu ứng phụ như gửi mail hoặc đặt hàng không có callback đặt lại an toàn, workflow có thể được giữ lại dưới dạng ứng viên có thể kiểm toán nhưng không được xác minh bằng cách lặp lại hành động trong tài khoản sản xuất. - Khớp và phát lại: Khi một tác vụ mới đến, tìm kiếm thư viện năng lực chính thức cho workflow theo ý định và từ khóa, trích xuất tham số hiện tại và thực thi trực tiếp với Playwright. Phát lại không yêu cầu cuộc gọi LLM từng bước, nhưng nó vẫn phải đợi phần tử khả dụng và hoàn thành mọi kiểm tra trạng thái.
- Vô hiệu hóa và học lại: Nếu phần tử đích không thể tìm thấy, kiểm tra trạng thái thất bại, API Schema thay đổi hoặc trạng thái cuối cùng sai, dừng các hành động tiếp theo ngay lập tức, chuyển phiên bản cũ từ thư viện có thể tìm kiếm sang vùng
invalidvà quay lại Agent đầy đủ để khám phá mới. Giữ lại tệp cũ để kiểm toán và so sánh, nhưng không bao giờ để nó tiếp tục khớp một cách im lặng.
Đối với một workflow email, kết quả biên dịch không chỉ đơn giản là "nhấp các nút này theo thứ tự," mà là một chương trình nhỏ được tham số hóa bởi người nhận, tiêu đề và nội dung: nó kiểm tra cửa sổ soạn và các trường trước khi gửi, kiểm tra chỉ báo thành công sau đó, và cuối cùng xác nhận rằng tin nhắn tương ứng xuất hiện trong danh sách đã gửi. Trong PreAct[^preact], các chương trình như vậy mang lại tốc độ đầu-cuối nhanh hơn 8,5–13 lần trên các tác vụ lặp lại và không yêu cầu cuộc gọi mô hình ngôn ngữ từng bước trong quá trình phát lại. Quan trọng hơn, bộ nhớ quy trình cần xác minh trước hành động, xác minh sau hành động và xác minh trước lưu trữ độc lập. Nếu không, hệ thống có thể tạo ra một ảo tưởng nguy hiểm: phạm vi phát lại là 100 phần trăm và mọi nút đều được nhấp, nhưng một trường trống và tác vụ chưa bao giờ thực sự hoàn thành.
Thí nghiệm 8-4 ★★★: Tạo workflow có thể xác minh từ quỹ đạo trình duyệt
Mục tiêu: Xác định liệu một web Agent có thể biến một lần khám phá tốn kém thành workflow có thể tái sử dụng và từ chối phát lại sai khi trang thay đổi, thay vì báo cáo thành công chỉ vì mọi hành động đã chạy.
Kịch bản bốn giai đoạn: Ở giai đoạn đầu tiên, chạy "gửi tin nhắn với tiêu đề 'Test Email' đến
test@example.com" trên trang mail thử nghiệm hoặc trang nhắn tin mô phỏng. Agent đầy đủ khám phá, trong khi một wrapper bắt hành động, tham số và trạng thái trang và tạocandidate. Ở giai đoạn thứ hai, gọivalidation_resetđể khôi phục sandbox và phát lại độc lập toàn bộ workflow; ứng viên chỉ đi vào thư viện năng lực chính thức nếu tất cả kiểm tra trước hành động, sau hành động và trạng thái cuối cùng vượt qua. Ở giai đoạn thứ ba, thực hiện cùng loại tác vụ với người nhận, tiêu đề và nội dung khác. Hệ thống nên khớp workflow đã xác minh, điền tham số mới và phát lại qua Playwright mà không đi vào vòng lặp LLM từng bước. Ở giai đoạn thứ tư, thay đổi một nút định vị, văn bản trang hoặc trạng thái cuối cùng và xác minh rằng workflow cũ ngay lập tức trở thànhinvalidvà trả vềfallback_required=True.Thiết kế đối chứng: Đường cơ sở rút gọn chỉ ghi lại liệu nhấp chuột, nhập văn bản và các hành động khác có hoàn thành mà không có ngoại lệ hay không. Điều kiện thí nghiệm cũng xác minh trang trước mỗi hành động, trang sau mỗi hành động và trạng thái tác vụ cuối cùng. Cả hai điều kiện sử dụng cùng quỹ đạo và thay đổi trang. So sánh tỷ lệ dương tính giả của chúng trên các trường hợp như "nút gửi được nhấp khi một trường trống" và "Save được nhấp nhưng dữ liệu không được lưu giữ."
Chỉ số và chấp nhận: Ghi lại thời gian đầu-cuối cho khám phá ban đầu và phát lại, số cuộc gọi LLM, tỷ lệ thành công, tỷ lệ thành công giả, tỷ lệ khớp workflow, tỷ lệ phát hiện thay đổi trang và số lần quay lại học lại. Không có callback đặt lại, workflow phải ở trạng thái ứng viên; phiên bản thất bại xác minh không được có thể truy xuất; phát lại tham số hóa không được tái sử dụng người nhận hoặc nội dung của lần chạy đầu tiên; và sau khi thay đổi trang, các hành động tiếp theo nguy hiểm phải dừng. Tăng tốc chỉ quan trọng nếu tất cả điều kiện này được đáp ứng.
Thực hiện đi kèm có sẵn tại
browser-use-rpa, cung cấp cả trình diễn trạng thái xác định và đường dẫn thực thi gọi trình duyệt Agent thực.
Một Agent sửa đổi mã của chính nó không có nghĩa là quy trình đang chạy trực tiếp ghi đè lên chính nó. Hệ thống sản xuất nên tạo một nhánh ứng viên từ phiên bản ổn định hiện tại, để Coding Agent tạo bản vá tối thiểu, và sau đó chạy lần lượt kiểm tra tĩnh, kiểm tra đơn vị, quét bảo mật, phát lại quỹ đạo lỗi và kiểm tra hồi quy trên các tác vụ cũ trước khi tạo phiên bản đủ điều kiện cho triển khai canary. Điều này biến "tự sửa đổi" thành một quy trình phát hành phần mềm có thể kiểm toán và xác định ranh giới giữa Chương 8 và 5: Chương 5 cung cấp năng lực sửa đổi hệ thống, trong khi chương này cung cấp phương pháp tự sửa đổi được kích hoạt bởi kinh nghiệm và ràng buộc bởi vòng lặp xác minh.
Làm bản vá nhỏ là chưa đủ cho phân bổ đáng tin cậy. Mỗi yêu cầu sửa đổi cũng nên là một hợp đồng thay đổi có thể bác bỏ ghi lại bằng chứng lỗi, nguyên nhân gốc suy luận, thành phần Harness chịu trách nhiệm, thay đổi ứng viên, hành vi được kỳ vọng cải thiện, hành vi hiện có có thể hồi quy và kiểm tra cho cả hai. Agentic Harness Engineering mô tả điều này theo khả năng quan sát ở cấp thành phần, kinh nghiệm và quyết định: mỗi thành phần có thể chỉnh sửa có biểu diễn cấp tệp; bộ sưu tập quỹ đạo lớn được chưng cất thành bằng chứng có thể được kiểm tra ở các mức chi tiết tăng dần; và mỗi chỉnh sửa khai báo dự đoán tác động trước khi thực thi, mà kết quả vòng tiếp theo kiểm tra[^ahe-2026]. Một điểm số cao hơn sau đó có thể được kết nối với cơ chế cụ thể thay vì vẫn là một thử nghiệm không thể giải thích.
Trình tạo ứng viên không nên chỉ nhận các trường hợp thất bại. Self-Harness cũng cung cấp hành vi thành công phải được bảo tồn và bản ghi của các sửa đổi bị từ chối trước đó[^self-harness-2026]. Cái trước cho Agent biết sửa chữa không được phá vỡ điều gì; cái sau ngăn nó gửi lại cùng một ý tưởng thất bại bằng từ ngữ khác. Bằng chứng lỗi, ràng buộc thành công và các lần thử trước cùng nhau xác định một không gian ứng viên có giới hạn và hữu ích hơn việc tải không phân biệt tất cả mã nguồn và nhật ký thô vào Agent sửa đổi.
Tạo công cụ tuân theo cùng giao thức. Alita[^alita-2025] trình bày một trường hợp mà Agent phải xác định con số được đề cập ngay sau khi khủng long xuất hiện lần đầu trong video VR 360 YouTube được đọc bởi diễn viên lồng tiếng cho Gollum trong The Lord of the Rings. Sau khi nhận ra nó thiếu khả năng đọc phụ đề, Agent tìm và kiểm tra youtube-transcript-api, đóng gói nó thành công cụ phụ đề mới và trích xuất câu trả lời 100000000 từ bản ghi. Một công cụ mới chỉ đi vào thư viện năng lực sau khi quét bảo mật, kiểm tra chức năng và tái sử dụng thành công trên các tác vụ sau. Việc khám phá công cụ chủ động trong Chương 4 hỏi công cụ hiện có nào phù hợp; Chương 5 hỏi cách viết công cụ; chương này hỏi bằng chứng vận hành nào nên kích hoạt tạo và cách một công cụ mới trở thành năng lực dài hạn được xác minh.
Thí nghiệm 8-5 ★★★: Kích hoạt tự sửa đổi Agent từ quỹ đạo thất bại
Mục tiêu: Cho nhiều quỹ đạo mà lỗi được đánh dấu
retryable=falsevẫn được gọi lặp lại, xác định liệu hệ thống có thể định vị nguyên nhân gốc trong mã retry và circuit-breaker và tạo bản sửa lỗi ứng viên mà không phá vỡ phục hồi từ lỗi tạm thời hay không.Quy trình: Mô-đun chẩn đoán trước tiên tổng hợp cùng lỗi qua các tác vụ khác nhau. Nó chỉ tạo yêu cầu sửa đổi sau khi ngưỡng hỗ trợ liên quỹ đạo được đáp ứng và nhắm vào
retry_policy.pytrong phiên bản ổn định. Trình tạo ứng viên đọc chẩn đoán lỗi, hành vi phục hồi lỗi tạm thời phải được bảo tồn, các thay đổi bị từ chối trước đó và mã nguồn ổn định. Trước khi phát ra diff mã tối thiểu, nó dự đoán rằng các cuộc gọi sau lỗi không thể thử lại sẽ giảm trong khi phục hồi timeout tạm thời sẽ không giảm. Cho dù trình tạo là xác định hay Coding Agent LLM thực, nó chỉ được ghi vào thư mục ứng viên cách ly. Harness xác minh sau đó biên dịch ứng viên, phát lại các quỹ đạo lỗi ban đầu, xác minh rằng lỗi không thể thử lại dừng ngay lập tức và mở circuit breaker, và kiểm tra lại rằng timeout tạm thời vẫn thử lại theo ngưỡng ban đầu.Đối chứng chẩn đoán và chỉ số: Coi "thêm một câu vào Prompt bảo Agent không lặp lại cuộc gọi" là một ví dụ khái niệm về chọn sai lớp sửa đổi, chứng minh tại sao ràng buộc retry có thể thực thi xác định thuộc về mã. Thí nghiệm thực thi so sánh trình tạo bản vá xác định và LLM dưới cùng cổng phát hành. Ghi lại số cuộc gọi sau lỗi không thể thử lại, tỷ lệ phục hồi lỗi tạm thời, hồi quy trên tác vụ cũ, kích thước bản vá và tỷ lệ chấp nhận ứng viên.
Tiêu chí chấp nhận: Vượt qua mọi kiểm tra chỉ tạo
release_to_canary. Thất bại bất kỳ kiểm tra tĩnh nào, phát lại lỗi hoặc hồi quy tác vụ cũ trả vềreject_candidate.release_manifest.jsonphải ghi lại cụm lỗi, quỹ đạo nguồn, nguyên nhân gốc suy luận, thành phần đích và tệp, diff mã, sửa chữa được kỳ vọng, hồi quy có thể, kết quả kiểm tra, phiên bản ứng viên và phiên bản rollback. Ứng viên bị từ chối phải giữ lại lý do thất bại cho vòng thế hệ tiếp theo. Agent tạo bản vá không được sửa đổi mã ổn định, trình xác minh, nhật ký kiểm toán hoặc cổng phê duyệt phát hành của chính nó.Thực hiện đi kèm có sẵn tại
self-modifying-agent. Nó hỗ trợ either trình tạo ứng viên xác định hoặc Coding Agent LLM thực, với cả hai đường dẫn chia sẻ cùng cổng phát hành.
[^preact]: Li, Bojie. PreAct: Computer-Using Agents that Get Faster on Repeated Tasks. arXiv:2606.17929, 2026.
[^alita-2025]: Qiu, J., et al. Alita: Generalist Agent Enabling Scalable Agentic Reasoning with Minimal Predefinition and Maximal Self-Evolution. arXiv:2505.20286, 2025.
Thí nghiệm 8-8 áp dụng cùng giao thức cho lớp xác minh. Chỉ các sửa lỗi người dùng lặp lại, phiếu bầu xuống và kiểm toán chỉ vào một hoạt động rủi ro cao chưa được xác nhận tạo yêu cầu thay đổi; ứng viên được ghi vào thư mục cách ly. Phân loại các xóa nguy hiểm và git push --force từ tên công cụ và đối số, và gắn token xác nhận một lần vào hoạt động cụ thể. Ứng viên phải vượt qua kiểm tra AST/phát lại ranh giới (bao gồm token giả mạo và tái sử dụng) và phát lại giữ lại trước khi phát hành canary.
Thí nghiệm 8-8 ★★: Cổng xác nhận kích hoạt bởi phản hồi người dùng cho hoạt động rủi ro cao
Sử dụng ba loại tín hiệu và quỹ đạo đối chứng trong
failure_trajectories.json. Ứng viêngpt-4o-minithực thất bại phát lại tác vụ chưa hoàn thành, phát lại hoạt động bình thường và kiểm tra token một lần, nên cổng an toàn từ chối nó. Ứng viên xác định vượt qua tất cả kiểm tra và nhậnrelease_to_canary; ghi lại kiểm tra, quyết định phát hành và hash thư mục ổn định. Thực hiện:harness-safety-gate.
Mã hóa kinh nghiệm trong tham số
Kiến thức, hướng dẫn và chương trình đều dựa trên một tiền đề: năng lực đích có thể được biểu diễn tương đối đầy đủ thông qua các ký hiệu bên ngoài. Tuy nhiên, các năng lực như hiểu hình ảnh y tế, ngữ điệu lời nói tự nhiên, loại bỏ cảm giác "AI" công thức khỏi văn bản và lập kế hoạch tầm xa khó nén thành vài quy tắc hoặc workflow. Các năng lực như vậy phải được ghi vào tham số mô hình thông qua post-training.
Liệu một năng lực có nên được tham số hóa hay không không chỉ được xác định bởi liệu tác vụ có ổn định trong dài hạn hay không. Dịch chuyển lĩnh vực gây ra bởi thiết bị hình ảnh mới có thể vẫn yêu cầu LoRA hoặc fine-tuning liên tục; phong cách ngôn ngữ thay đổi nhanh cũng có thể được điều chỉnh thông qua preference training định kỳ. Ảnh hưởng ổn định đến tần suất cập nhật và chi phí, nhưng bản chất biểu diễn của năng lực xác định phương tiện chính của nó. Ngược lại, một quy tắc ổn định dài hạn cho phê duyệt chuyển khoản không nên chỉ dựa vào bộ nhớ tham số; mã phía máy chủ vẫn phải cung cấp bảo đảm xác định.
Chương 7 đã cung cấp thảo luận đầy đủ về SFT, chưng cất và RL, nên phần này không lặp lại. Đối với evolution liên tục, chìa khóa là biến các quỹ đạo sản xuất được đánh giá thành dữ liệu đào tạo: các demo chất lượng cao có thể được sử dụng cho SFT, sở thích rõ ràng có thể tạo dữ liệu cặp, và tương tác với phần thưởng môi trường đáng tin cậy có thể được sử dụng cho RL. Trước khi đào tạo, thông tin riêng tư vẫn phải được loại bỏ, quỹ đạo sai được lọc ra và một tập hồi quy độc lập được giữ lại. Sau khi đào tạo, hệ thống phải kiểm tra liệu năng lực chung hoặc liên kết an toàn có bị quên hay không.
Học tham số thường hoạt động kết hợp với các phương pháp bên ngoài. Một mô hình hình ảnh y tế có thể học biểu diễn thị giác qua tham số, lấy hướng dẫn mới nhất từ cơ sở kiến thức và sử dụng mã để đo tổn thương và tính toán rủi ro. Giọng điệu dịch vụ khách hàng tự nhiên có thể được định hình ở cấp phân phối thông qua preference training, trong khi Prompt chỉ rõ bản sắc thương hiệu hiện tại và bộ nhớ người dùng điều chỉnh giao tiếp theo sở thích cá nhân. Evolution liên tục không có nghĩa là chọn một câu trả lời duy nhất từ bốn phương pháp, mà đặt mỗi năng lực vào phương tiện phù hợp nhất để biểu diễn và quản lý nó.
Từ cập nhật sản phẩm đến cập nhật "phương pháp cập nhật"
Bốn phương pháp trước đó hỏi kinh nghiệm được ghi ở đâu, nhưng evolution liên tục có một trục khác, trực giao: hệ thống đang tối ưu hóa nội dung của một sản phẩm, hay phương pháp được sử dụng để tạo, quản lý và xác minh sản phẩm? Theo trục này, mục tiêu tối ưu hóa có thể mở rộng từ một quy tắc hoặc bộ nhớ riêng lẻ → ngữ cảnh có cấu trúc → workflow → mã Harness → mã trình tạo ứng viên giải pháp[^weng-harness-2026]. Đây không phải là năm phương tiện cập nhật mới mà là năm phạm vi tìm kiếm; kiến thức, Prompt, Skills và chương trình có thể xuất hiện ở một số trong số chúng.
Cấp bên trong nhất chỉ thay đổi nội dung sản phẩm — ví dụ, thêm một quy tắc cục bộ vào Prompt hệ thống sau một quỹ đạo lỗi hoặc thêm một ngoại lệ vào tài liệu kinh nghiệm. Các thay đổi như vậy có bán kính tác động nhỏ và dễ phân bổ và rollback hơn, nên chúng nên là mặc định. Tuy nhiên, việc lặp lại yêu cầu mô hình viết lại toàn toàn Prompt hoặc bộ nhớ giới thiệu một dạng suy giảm khác: các lần thử liên tiếp về sự ngắn gọn có thể dần xóa các chi tiết hiếm nhưng quan trọng, và các ràng buộc tương tác có thể bị sụp đổ thành một nguyên tắc quá tổng quát. Agentic Context Engineering (ACE) duy trì ngữ cảnh như một tập hợp các mục có định danh ổn định. Các mô-đun tạo, phản tư và tuyển chọn đề xuất cập nhật gia tăng, mà logic xác định hợp nhất và loại bỏ trùng lặp thay vì viết lại một khối văn bản ngày càng ngắn hơn mỗi vòng[^ace-2026]. Đây là một nghiên cứu cụ thể minh họa các nguyên tắc diff tối thiểu và giữ nguồn gốc đã trình bày trước đó trong chương này.
Ở cấp tiếp theo, mục tiêu tối ưu hóa không chỉ đơn giản là ngữ cảnh chứa gì mà là cách ngữ cảnh được xây dựng. Meta Context Engineering (MCE) tách hai thành vòng trong và vòng ngoài: vòng trong tối ưu hóa sản phẩm ngữ cảnh cho tác vụ hiện tại dưới một phương pháp quản lý nhất định, trong khi vòng ngoài sử dụng kết quả từ nhiều lần thực thi và xác minh để sửa đổi các thao tác ngữ cảnh — tìm kiếm, lựa chọn, lọc và định dạng[^mce-2026]. Sự phân biệt quan trọng. Chỉnh sửa quy tắc truy xuất thay đổi cơ chế quản lý nội dung; so sánh một số cơ chế truy xuất và tuyển chọn và giữ lại cái có chuyển giao tốt hơn là học cách quản lý ngữ cảnh.
Cùng ý tưởng mở rộng sang workflow và toàn bộ Harness. AFlow biểu diễn các workflow gồm nhiều cuộc gọi LLM dưới dạng đồ thị mã và tìm kiếm qua các kết hợp nút và luồng điều khiển sử dụng phản hồi thực thi[^aflow-2025]. Meta-Harness có Coding Agent kiểm tra mã nguồn Harness ứng viên, điểm và quỹ đạo để tìm kiếm mã xác định cách thông tin được lưu trữ, truy xuất và trình bày[^meta-harness-2026]. Chương 5 đã thiết lập mã như ngôn ngữ chung để biểu diễn cấu trúc hệ thống Agent. Điểm bổ sung ở đây là mã, cùng với lịch sử đánh giá của nó, có thể tự trở thành đối tượng tìm kiếm liên tục thay vì đầu ra một lần.
Cấp cao hơn không tự động tốt hơn. Tìm kiếm một quy tắc cục bộ có thể chỉ yêu cầu một vài trường hợp ranh giới, trong khi tìm kiếm toàn bộ workflow hoặc Harness đối mặt với không gian ứng viên lớn hơn nhiều, chi phí đánh giá cao hơn và phân bổ khó hơn. Một lỗi rõ ràng, lặp lại cục bộ ở một thành phần trước tiên nên nhận một bản vá cục bộ có thể kiểm toán. Chỉ khi thay đổi cục bộ liên tục thất bại trong việc giải quyết vấn đề liên thành phần, hoặc khi phương pháp quản lý hiện tại tự trở thành nút thắt cổ chai, mới đáng mở rộng ra workflow, Harness hoặc trình tối ưu hóa. Ở mọi cấp, trình đánh giá, ranh giới quyền và các thử nghiệm giữ lại phải nằm ngoài phạm vi có thể chỉnh sửa — không gian tìm kiếm càng lớn, gốc đáng tin cậy này càng quan trọng.
Thí nghiệm 8-6 ★★★: Cho Hermes cuốn sách này: Nó có thể tự nâng cấp không?
Mục tiêu: Kiểm tra xem một Agent có thể biến kiến thức bên ngoài thành cập nhật năng lực của chính nó hay không. Thí nghiệm không cung cấp tuyên bố vấn đề và không có danh sách tính năng. Hermes nhận tất cả mười chương và mã nguồn của chính nó, sau đó phải hiểu các nguyên tắc, kiểm tra triển khai và tự chọn một cải tiến đáng giá.
Thiết kế: Sách và mã nguồn là ngữ cảnh có thể đọc, trong khi phiên bản ổn định, Reviewer độc lập và kiểm tra chấp nhận nằm ngoài phạm vi có thể chỉnh sửa của Hermes. Hermes phải hoàn thành đọc → so sánh → chọn → thay đổi → xác minh. Nếu ứng viên bị từ chối, đánh giá trở thành đầu vào cho vòng học tập tiếp theo; Hermes không thể bỏ qua cổng và tuyên bố thành công.
Lần chạy thực: Sau khi đọc sách, Hermes độc lập nhận thấy rằng quỹ đạo đã lưu thiếu bằng chứng có cấu trúc mà học tập sau có thể sử dụng trực tiếp. Nó chọn biến kết quả thực thi thành tín hiệu học tập bảo thủ, sau đó chỉnh sửa mã nguồn và thêm kiểm tra. Ba đánh giá độc lập đầu tiên phát hiện sự không khớp với định dạng dữ liệu thực, đường dẫn lưu giữ và ngữ nghĩa đếm. Mỗi phát hiện quay lại phiên Hermes ban đầu cho một lần sửa chữa khác; đánh giá thứ tư chấp nhận ứng viên. Từ chối không phải là kết thúc thí nghiệm, mà là một phần của vòng cải thiện.
Ranh giới tuyên bố: Lần chạy này cho thấy Agent có thể trích xuất nguyên tắc từ kiến thức dài, ánh xạ chúng lên mã của chính nó và hoàn thành tự cập nhật dưới xác minh bên ngoài. Nó không cho thấy cập nhật đã cải thiện thành công tác vụ hạ nguồn; điều đó yêu cầu một thí nghiệm loại trừ riêng biệt. Độc giả Grace đóng góp ý tưởng thí nghiệm.
Xây dựng vòng lặp Evolution liên tục kín cho vận hành dài hạn
Bốn phương pháp cập nhật trở thành evolution liên tục thay vì tối ưu hóa một lần chỉ khi được tích hợp vào cùng một vòng lặp tự trị. Hình 8-5 trình bày kiến trúc vòng kép mạnh mẽ hơn cho hệ thống sản xuất: vòng lặp thực thi trực tuyến chỉ hoàn thành tác vụ và ghi bằng chứng, không trực tiếp viết lại Agent sản xuất; vòng lặp evolution ngoại tuyến tổng hợp quỹ đạo, chẩn đoán nguyên nhân gốc, tạo sửa đổi ứng viên và phát hành phiên bản mới chỉ sau khi vượt qua cổng xác minh. Hai vòng lặp được kết nối qua kho kinh nghiệm có phiên bản và các tập đánh giá.
Voyager[^voyager-2023] trình bày một vòng lặp evolution liên tục tương đối hoàn chỉnh. Trong Minecraft, nó chọn mục tiêu mới dựa trên năng lực hiện tại, tinh chỉnh lặp lại chương trình sử dụng phản hồi môi trường, lưu trữ mã được xác minh thành công vào thư viện kỹ năng và sau đó kết hợp các kỹ năng hiện có để giải quyết các tác vụ khó hơn. Chương trình giảng dạy tự động, kỹ năng có thể thực thi và xác minh môi trường đều không thể thiếu: có thư viện kỹ năng nhưng không có chương trình giảng dạy, Agent không biết học gì tiếp theo; có phản tư nhưng không có xác minh môi trường, thư viện kỹ năng tích lũy lỗi; có khám phá nhưng không có lưu trữ, mọi tác vụ vẫn phải bắt đầu từ đầu. Mặc dù kiến thức, Prompt, công cụ và tham số của các Agent thế giới thực phức tạp hơn, quá trình học tập cơ bản tương tự.
Cụ thể hơn, Voyager gồm ba cơ chế liên kết. Trình tạo chương trình giảng dạy tự động đề xuất mục tiêu tiếp theo phù hợp thách thức từ kho hiện tại, môi trường và kỹ năng đã có, để khám phá không trở thành lang thang ngẫu nhiên. Thư viện kỹ năng lưu trữ chương trình thành công dưới dạng mã có thể truy xuất, có thể kết hợp; một kỹ năng thu thập nâng cao, ví dụ, có thể gọi các kỹ năng di chuyển và chế tạo cơ bản. Cơ chế prompting lặp lại đưa quan sát môi trường, lỗi thực thi và kết quả tự xác minh vào vòng tạo mã tiếp theo cho đến khi tác vụ thực sự vượt qua. So với các đường cơ sở được sử dụng trong bài báo, Voyager thu được số vật phẩm độc đáo gấp 3,3 lần, đi xa gấp 2,3 lần, mở khóa các mốc cây công nghệ quan trọng nhanh hơn tới 15,3 lần và chuyển giao thư viện kỹ năng sang các thế giới Minecraft mới. Các chỉ số này đo lường năng lực tăng trưởng theo kinh nghiệm như thế nào thay vì một Agent đóng băng hoạt động trên một kỳ thi duy nhất như thế nào.
Từ chẩn đoán vấn đề đến hợp nhất kinh nghiệm
Cùng một vấn đề bề mặt có thể yêu cầu các dạng sửa đổi khác nhau. Khi một Agent dịch vụ khách hàng hallucinate sự kiện bịa đặt, nguyên nhân có thể là thông tin thiếu trong cơ sở kiến thức, hoặc Prompt có thể không yêu cầu trích dẫn. Khi một Agent cam kết sai "nó đã được hoàn thành" trước khi hoàn thành tác vụ, vấn đề có thể được sửa qua hướng dẫn hoặc bằng cách để Harness thực thi nhất quán giữa phản hồi và trạng thái công cụ. Mô-đun evolution trước tiên nên xác định nguyên nhân gốc và sau đó chọn mục tiêu sửa đổi nhỏ nhất, dễ xác minh và rollback nhất. Các thất bại rải rác với bằng chứng không đủ không nên ngay lập tức kích hoạt học tập; hệ thống nên tiếp tục thu thập ví dụ.
Sự lựa chọn này cũng có thể thay đổi khi kinh nghiệm tích lũy. Một chiến lược mới phát hiện ban đầu có thể được lưu trữ dưới dạng tài liệu kinh nghiệm để truy xuất; sau khi xác minh lặp lại qua nhiều trường hợp, nó có thể được nâng cấp thành kiến thức. Kiến thức có thể được biểu diễn theo ba cách: quy tắc có thể được mô tả rõ ràng bằng ngôn ngữ tự nhiên có thể được hợp nhất thành một Skill; quy trình ổn định không yêu cầu hiểu ngôn ngữ tự nhiên có thể được biên dịch thành mã công cụ; và năng lực thực sự phản ánh ra quyết định rộng, ngầm có thể đi vào post-training.
Xác minh, phát hành và rollback
Mỗi sửa đổi trước tiên nên tạo một năng lực ứng viên hoặc Agent ứng viên thay vì trực tiếp ghi đè phiên bản sản xuất. Tài liệu kiến thức phải được kiểm tra để xác định liệu truy xuất có cải thiện hiệu suất trên các tác vụ mới hay không; Prompt và Skills phải được kiểm tra so với các trường hợp ranh giới và hồi quy trên các tác vụ trước; chương trình phải được kiểm tra trong sandbox và môi trường đặt lại; và cập nhật tham số phải được đánh giá về quên, an toàn và hiệu suất ngoài phân phối. Ngay cả sau khi xác minh, phiên bản mới nên được phát hành dần dần và giám sát trên lưu lượng thực; nếu chỉ số quan trọng suy giảm, hệ thống nên tự động rollback về phiên bản an toàn đã biết.
Xác minh cũng phải tách hai năng lực thường bị trộn lẫn. Cập nhật Harness là khả năng tạo ra thay đổi có giá trị từ quỹ đạo; lợi ích Harness là khả năng của task Agent tìm, kích hoạt và sử dụng đúng các thay đổi đó sau này. Một Skill có thể đúng trong bản thân nó, nhưng một mô hình task yếu hơn có thể không thể tải nó trong tình huống đúng hoặc không thể tuân theo nó qua một quỹ đạo dài. Bất kỳ thất bại nào cũng làm cho điểm cuối cùng trông như thể không có evolution nào xảy ra. Chỉ hiệu suất đầu-cuối do đó không thể chẩn đoán updater. Thí nghiệm hoán đổi mô hình của Lin et al. chỉ ra rằng hai năng lực liên hệ khác nhau với năng lực mô hình cơ sở[^harness-benefit-2026]. Mối quan hệ chính xác yêu cầu xác minh trên nhiều tác vụ hơn, nhưng đánh giá chúng riêng biệt là hữu ích rộng rãi.
Bảng 8-3: Chỉ số đánh giá phân tầng cho evolution liên tục
| Chỉ số | Câu hỏi được trả lời | Bằng chứng chính |
|---|---|---|
| Tính hợp lệ thay đổi ứng viên | Updater có đề xuất thay đổi hữu ích không? | Tỷ lệ chấp nhận và lợi ích trong xác minh độc lập |
| Tỷ lệ kích hoạt sản phẩm | Task Agent có tải Skill, bộ nhớ hoặc công cụ mới trong tình huống đúng không? | Truy xuất, định tuyến và vết gọi công cụ |
| Tỷ lệ tuân thủ thành công | Sau khi kích hoạt, Agent có tuân theo quy tắc hoặc quy trình mới không? | Chuỗi hành động và trình xác minh quy trình |
| Lợi ích tác vụ giữ lại | Toàn bộ hệ thống có cải thiện trên các tác vụ không được sử dụng trong quá trình evolution không? | Thành công giữ lại, chất lượng và chi phí |
Để chẩn đoán, giữ Harness ứng viên cố định và chỉ hoán đổi task model. Nếu mô hình mạnh hưởng lợi trong khi mô hình yếu không bao giờ kích hoạt sản phẩm mới, truy xuất hoặc định tuyến là nút thắt cổ chai. Nếu cả hai kích hoạt nó nhưng chỉ mô hình mạnh thực thi đúng, tuân theo hướng dẫn hoặc lập kế hoạch tầm xa là nút thắt. Nếu mọi mô hình hồi quy, bản thân thay đổi đáng nghi ngờ hơn. Ngược lại, giữ task model cố định và hoán đổi mô hình đề xuất thay đổi để so sánh trực tiếp chất lượng updater. Hoán đổi mô hình hai chiều này định vị nơi ngân sách năng lực nên được chi tiêu hiệu quả hơn một điểm số post-evolution đơn lẻ.
Đánh giá không phải là kỳ thi được thực hiện sau khi học kết thúc, mà là một phần không thể thiếu của tự evolution. Đánh giá dài hạn nên quan sát ít nhất năm loại kết quả đồng thời:
- Hồi quy, tức là liệu kinh nghiệm mới có xung đột với kinh nghiệm hiện có khác hay không và liệu các trường hợp trước đây thành công có bắt đầu thất bại hay không;
- Tổng quát hóa, tức là cải thiện do kinh nghiệm mới tạo ra trong các kịch bản chưa được tập kiểm tra bao phủ;
- Hiệu quả Token, tức là chi phí token để hoàn thành tác vụ;
- An toàn, tức là liệu các quy tắc, bảo vệ quyền riêng tư và ranh giới từ chối có trôi trong quá trình evolution không;
- Chất lượng kỹ thuật dài hạn, tức là liệu độ phức tạp bảo trì, tính nhất quán kiến trúc, ranh giới sở hữu, tính tương thích ngược và chi phí di chuyển và gỡ lỗi trong tương lai có xấu đi không.
Chỉ sửa trường hợp thất bại hiện tại trong khi suy giảm hiệu suất trên các trường hợp hiện có khác hoặc trong lĩnh vực mới không cấu thành học liên tục thành công.
Ranh giới của vòng lặp có thể xác minh: Khi "xong" không có nghĩa là "tiến bộ"
Vòng lặp trước hoạt động tự nhiên nhất cho Coding, sử dụng công cụ và thay đổi trạng thái kinh doanh, nơi kiểm tra, trạng thái môi trường hoặc quy tắc xác định có thể cung cấp phản hồi nhanh. Nghiên cứu mở, lập kế hoạch chiến lược và thiết kế sản phẩm phức tạp thì khác: phản hồi bị trì hoãn, có thể không có câu trả lời đúng duy nhất, và các mục tiêu quan trọng nhất — gu nghiên cứu, giá trị dài hạn và khả năng bảo trì — khó biến thành điểm số ngay lập tức. Harness sau đó có thể thực thi quy trình hoàn hảo trong khi chỉ tạo ra những thứ trông giống kết quả thay vì thúc đẩy mục tiêu thực.
Nghiên cứu tự trị là một thử nghiệm căng thẳng hữu ích. Trehan và Chopra đã ghi lại bốn lần thử đầu-cuối biến ý tưởng nghiên cứu thành bài báo. Ba lần thất bại trong quá trình triển khai hoặc đánh giá, và chỉ một lần hoàn thành pipeline đầy đủ[^llm-scientists-2026]. Các thất bại chia thành ba nhóm. Đầu tiên, trôi triển khai: khi phương pháp đề xuất trở nên khó khăn, Agent rút lui về một triển khai quen thuộc từ phân phối đào tạo mà không còn kiểm tra giả thuyết ban đầu. Thứ hai, lạc quan nhận thức quá mức: trong khi tín hiệu có thể vẫn là nhiễu, hệ thống bắt đầu giải thích nó, vá phương pháp và công bố phát hiện, trong khi thất bại và kết quả tiêu cực dễ bị bỏ qua hơn. Thứ ba, thiếu đánh giá ngầm: Agent có thể chạy thí nghiệm mà không biết đường cơ sở nào quan trọng, bất thường nào đáng điều tra, hoặc khi nào giả thuyết nên bị từ bỏ.
Các tác vụ này yêu cầu thay đổi cấu trúc bằng chứng và giám sát, không chỉ là mô hình viết bài báo tốt hơn:
- Tách tuyên bố khỏi bằng chứng: Ghi riêng nguồn gốc cho trích dẫn, số liệu, phương pháp và kết luận; tài liệu cuối cùng chỉ là một rendering của đồ thị bằng chứng. Thiết kế Chain-of-Evidence của ScientistOne kết nối mỗi loại tuyên bố với nguồn có thể kiểm toán. Điều này cải thiện khả năng truy vết nhưng tự nó không làm cho câu hỏi nghiên cứu có giá trị[^scientistone-2026].
- Giữ lại kết quả tiêu cực: Ghi các thí nghiệm thất bại, ứng viên bị từ chối và lý do dừng vào nhật ký bất biến với cùng trạng thái truy xuất như thành công. Nếu không, mô-đun evolution chỉ thấy người sống sót, đi lại các đường dẫn đã bị bác bỏ và học cách diễn giải kết quả mơ hồ là thành công.
- Bảo tồn đa dạng tìm kiếm: Tìm kiếm mở không nên chỉ giữ lại chuỗi điểm cao nhất hiện tại. Hồ ứng viên cũng nên giữ lại một số nhánh điểm thấp hơn nhưng khác biệt có ý nghĩa theo cơ chế, tính mới mã hoặc loại giả thuyết, để mọi giải pháp không hội tụ vào cùng một mẫu dễ chấm điểm.
- Di chuyển sự tham gia của con người lên trên: Đầu vào của con người không giới hạn ở phê duyệt gọi công cụ nguy hiểm. Nó cũng bao gồm xác định vấn đề, đánh giá tiêu chí đánh giá, diễn giải kết quả bất thường và quyết định khi nào dừng. Với phản hồi mơ hồ, các đánh giá cấp cao này khó tự động hóa hơn — và có giá trị hơn — việc tiếp quản các bước thực thi riêng lẻ.
Cùng hạn chế xuất hiện trong kỹ thuật phần mềm thông thường. Vượt qua mọi kiểm tra đơn vị chỉ chứng minh rằng hành vi quan sát được hiện tại đáp ứng các kiểm tra; nó không chứng minh rằng codebase sẽ vẫn có thể bảo trì nhiều tháng sau. Đó là lý do tại sao phần trước coi chất lượng kỹ thuật dài hạn là chỉ số độc lập thay vì kỳ vọng thành công tác vụ hiện tại bao phủ các externalities bị trì hoãn. Trần của evolution liên tục cuối cùng được đặt bởi liệu hệ thống có thể đánh giá những gì nó thực sự quan tâm, không chỉ là proxy dễ đo nhất.
Ranh giới an toàn cho Evolution liên tục
Khả năng tự evolution của Agent có thể biến một lỗi đơn lẻ thành rủi ro dài hạn. Nếu Prompt injection trong trang web, email hoặc đầu ra công cụ được tóm tắt thành kinh nghiệm, nó có thể có hiệu lực lặp lại qua các phiên. Nếu một gói độc hại được tìm thấy qua tìm kiếm tự động được đóng gói thành công cụ, tác động của nó có thể lan truyền từ một lần sandbox sang mọi tác vụ tiếp theo. Một trình xác minh khiếm khuyết cũng có thể tiếp tục phê duyệt các ứng viên có vẻ cải thiện nhưng thực sự hồi quy. Do đó, hệ thống tự evolution Agent phải hỏi không chỉ liệu ứng viên có mạnh hơn không, mà còn ai có thể sửa đổi gì và bằng chứng nào biện minh cho thay đổi.
Ranh giới đầu tiên là tách bằng chứng khỏi hướng dẫn. Trang web thô, đầu ra công cụ và bất kỳ tóm tắt LLM nào của chúng là bằng chứng không đáng tin: chúng không được thực thi dưới dạng hướng dẫn hoặc nâng cấp trực tiếp thành Skill hoặc năng lực dài hạn tương tự. Tóm tắt LLM là một phép biến đổi cho khả năng đọc và xử lý, không phải là bước khử trùng làm cho đầu vào vô hại. Hệ thống nên trích xuất tuyên bố, vị trí nguồn và thời gian thu thập vào schema cố định trong khi bảo tồn nội dung thô và nguồn gốc; chuỗi được trích xuất không bao giờ được thực thi dưới dạng hướng dẫn. Độ tin cậy do mô hình tạo ra cũng là ước tính chưa được xác minh, không phải cổng phê duyệt. Ứng viên cũng phải vượt qua kiểm tra schema xác định, allowlist và nguồn gốc trước khi được gửi dưới dạng pull request được kiểm soát phiên bản. Người đánh giá độc lập khỏi trình tạo nên so sánh thay đổi với bằng chứng ban đầu, với phê duyệt của con người được thêm cho nâng cấp Skill rủi ro cao.
Ranh giới thứ hai là tách năng lực ứng viên khỏi năng lực sản xuất. Kiến thức, Prompt, Skills, chương trình và tham số mới trước tiên đi vào vùng ứng viên không thể phục vụ lưu lượng thực. Mã mới tạo và phụ thuộc bên ngoài cũng phải vượt qua kiểm tra bảo mật như thực thi sandbox, đánh giá quyền, quét chuỗi cung ứng và kiểm tra hành vi. Chỉ sau khi kiểm tra bảo mật và kiểm tra hồi quy vượt qua, ứng viên mới có thể phục vụ lưu lượng thực dưới dạng năng lực sản xuất.
Ranh giới thứ ba là cơ chế an toàn không được tự sửa đổi. Một Agent kinh doanh có thể sửa đổi Prompt, Skills, cơ sở kiến thức và công cụ, nhưng nó không được sửa đổi trình xác minh, trường hợp kiểm tra, ngưỡng phát hành, nhật ký kiểm toán hoặc bản sao phiên bản ổn định phê duyệt cập nhật của chính nó. Nếu không, Agent có thể ngụy trang hồi quy thành tiến bộ bằng cách đơn giản giảm ngưỡng kiểm tra hoặc xóa các trường hợp thất bại.
Học khi ngủ: hợp nhất, quên và bảo trì năng lực
"Học khi ngủ" là một phép loại suy nhận thức cho hợp nhất ngoại tuyến; nó không yêu cầu quy trình chạy theo nghĩa đen vào ban đêm. Agent trực tuyến có trách nhiệm chính là hoàn thành tác vụ hiện tại và nối bằng chứng bất biến. Một quá trình học nền đọc một đợt kinh nghiệm mới trong thời gian rảnh hoặc khi điều kiện gating được đáp ứng, so sánh kết luận cũ và mới, hợp nhất trùng lặp, giải quyết xung đột, đề xuất cập nhật ứng viên và chạy hồi quy. Tách thu thập khỏi tổ chức ngăn một thành công ngẫu nhiên, lỗi mạng hoặc đầu vào độc hại ngay lập tức viết lại năng lực dài hạn, và cho phép hợp nhất sử dụng các đợt lớn hơn và mô hình rẻ hơn.
Một chu kỳ học khi ngủ điển hình có năm bước:
- Kích hoạt: Đạt ngưỡng cho thời gian trôi qua, số quỹ đạo mới, dung lượng lưu trữ hoặc tần suất lỗi, đồng thời xác nhận rằng không có tác vụ trực tuyến ưu tiên cao đang chạy.
- Định hướng: Đọc các thư mục kiến thức, Prompt và Skill sản xuất và phiên bản của chúng để hiểu năng lực hiện có và ranh giới bất biến.
- Thu thập và hợp nhất: Tìm tín hiệu mới trong các quỹ đạo được đánh giá gần đây, hợp nhất trùng lặp, đánh dấu xung đột và điều kiện áp dụng, và ưu tiên bản vá cục bộ.
- Xác minh và phê duyệt: Đánh giá ứng viên trên tập chuyển giao, giữ lại và an toàn; ghi rủi ro cao chờ phê duyệt của con người.
- Cắt tỉa và lập chỉ mục: Cập nhật chỉ mục truy xuất và đánh dấu các năng lực lâu không sử dụng hoặc bị mâu thuẫn bởi bằng chứng mới là hết hạn, lưu trữ hoặc xóa, đồng thời giữ lại nguồn gốc và phiên bản rollback.
Bộ nhớ người dùng là ví dụ trực quan nhất, nhưng nó phải được phân biệt với kinh nghiệm hành động. Auto memory của Claude Code duy trì chỉ mục MEMORY.md và tệp chi tiết theo chủ đề cho mỗi dự án. Khi bắt đầu phiên, nó chỉ tải một tiền tố có giới hạn của chỉ mục và đọc nội dung còn lại theo yêu cầu; khi chỉ mục gần đến giới hạn, Agent được hướng dẫn hợp nhất hoặc chuyển chi tiết đi nơi khác. Điều này cho thấy ngay cả bộ nhớ văn bản thuần cũng yêu cầu giới hạn dung lượng, tải phân tầng và tổ chức chủ động. Cơ chế được ghi chép hiện tại chủ yếu ghi bộ nhớ trong phiên và không nên đơn giản được đánh đồng với một tác vụ nền cố định hàng đêm[^claude-code-memory].
Hermes cung cấp một ví dụ hoàn chỉnh hơn về evolution nền. Nó tách thông tin dài hạn thành các tệp MEMORY.md và USER.md có giới hạn, tìm kiếm SQLite/FTS5 qua các phiên trước, Skills theo yêu cầu và các nhà cung cấp bộ nhớ bên ngoài tùy chọn như Honcho. Tìm kiếm phiên trả về tin nhắn gốc thay vì trước tiên tóm tắt chúng bằng LLM, giữ truy xuất tách biệt khỏi tạo và có thể kiểm toán. Khi một tác vụ chứa nhiều cuộc gọi công cụ, phục hồi từ lỗi hoặc ngõ cụt, nhận sửa lỗi người dùng hoặc phát hiện workflow không rõ ràng, đánh giá nền có thể tạo hoặc sửa đổi cục bộ Skill; ghi bộ nhớ và Skill cũng có thể đi qua cổng phê duyệt. Một Curator riêng biệt theo dõi sử dụng Skill, độ cũ và trạng thái lưu trữ, thực hiện cắt tỉa xác định khi rảnh và có thể tùy chọn gọi LLM để hợp nhất nội dung. Nó chụp nhanh thay đổi trước để hợp nhất sai có thể được rollback[^hermes-memory]. Điều này biến "ghi–hợp nhất–xác minh–cắt tỉa" từ ẩn dụ thành vòng đời năng lực vận hành.
Evolution liên tục không có nghĩa là cho phép kiến thức, Prompt và công cụ tăng không giới hạn. Sự thối ngữ cảnh được thảo luận trong Chương 2 xuất hiện lại trên các thang thời gian dài hơn: tài liệu kinh nghiệm xung đột với nhau, Prompt bị choáng ngợp bởi các quy tắc ranh giới, thư viện Skill tích lũy năng lực trùng lặp và fine-tuning lặp lại gây ra quên thảm khốc. Do đó, hệ thống yêu cầu hợp nhất ngoại tuyến định kỳ:
- Hợp nhất kinh nghiệm trùng lặp trong khi giữ lại nguồn gốc và thông tin phiên bản;
- Chuyển quy tắc cục bộ từ Prompt toàn cầu sang Skills cụ thể lĩnh vực để giữ Prompt toàn cầu sạch;
- Giữ Prompt và Skills rõ ràng có cấu trúc, như sổ tay cho nhân viên mới, và tránh các liệt kê giống "99 quy tắc bất khả xâm phạm";
- Xác minh lại các công cụ lâu không sử dụng;
- Xóa kiến thức bị vô hiệu hóa bởi bằng chứng mới;
- Đào tạo lại LoRA từ mô hình cơ sở ban đầu.
Thí nghiệm 8-7 ★★★: Đánh giá liệu Agent có đang evolution liên tục không
Mục tiêu: Phân biệt giữa ba hành vi dài hạn — lưu một phản hồi, chỉ nối mãi và thực sự cập nhật, chuyển giao và giữ lại năng lực — để chạy lặp lại cùng tác vụ không bị nhầm là học liên tục.
Luồng tác vụ bốn giai đoạn: Giai đoạn học trình bày các tác vụ hoàn tiền, xác minh danh tính và chính sách hành lý chia sẻ mẫu ẩn. Giai đoạn chuyển giao thay đổi cách diễn đạt, người dùng và môi trường cục bộ để kiểm tra liệu kinh nghiệm cũ có áp dụng cho tác vụ mới không. Giai đoạn thay đổi quy tắc cập nhật giới hạn hành lý từ 20 kg sang 23 kg và yêu cầu hệ thống thay thế hoặc loại bỏ kiến thức lỗi thời. Giai đoạn giữ lại kiểm tra lại năng lực không thay đổi và các quy tắc hiện hành để đo lường quên. Bộ nhớ bên ngoài chỉ có thể được cập nhật sau khi mỗi tác vụ mang phản hồi kết thúc; hành động được kỳ vọng cho tác vụ hiện tại không bao giờ được rò rỉ cho Agent trước.
Nhóm đối chứng:
statickhông lưu phản hồi.append_onlynhớ phiên bản đầu tiên của quy tắc nhưng không thể giải quyết xung đột hoặc loại bỏ nó.evolvinglưu phiên bản và thay thế quy tắc cũ bằng bằng chứng mới. Thực hiện tham chiếu xác minh rằng Harness đánh giá có thể phân biệt các hành vi này. Thí nghiệm thực có thể đưa LLM qua cùng luồng tác vụ có thứ tự gồm 14 tác vụ, nhưng kết quả phải được tính bởi Harness bên ngoài mô hình.Chỉ số và chấp nhận: Báo cáo độ chính xác và đường cong học tập cho mỗi giai đoạn, và tính riêng độ chính xác chuyển giao, số tác vụ cần phục hồi sau quy tắc mới, giữ lại năng lực cũ, tỷ lệ chuyển giao tiêu cực, tỷ lệ vượt qua Rubric an toàn và chi phí Token, độ trễ và lưu trữ. Đối với hệ thống thực cập nhật Prompt, Skills hoặc Harness, cũng ghi tính hợp lệ thay đổi ứng viên, tỷ lệ kích hoạt sản phẩm và tỷ lệ tuân thủ thành công, để "cập nhật đúng nhưng không bao giờ được tải" không bị phân loại sai là cập nhật thất bại. Ngay cả Agent có độ chính xác cuối cùng cao cũng không đủ điều kiện là evolution liên tục nếu nó vẫn trích dẫn quy tắc đã loại bỏ, thành công qua đường tắt không an toàn hoặc quên năng lực hiện có sau cập nhật.
Thực hiện đi kèm có sẵn tại
self-evolution-eval. Theo mặc định, nó so sánh ba Agent tham chiếu: có thể cập nhật, chỉ nối và tĩnh. Sử dụng--profile llmđể LLM thực trải qua cùng luồng tác vụ dài hạn.
[^claude-code-memory]: Anthropic, "How Claude remembers your project", 2026. https://code.claude.com/docs/en/memory
[^hermes-memory]: Nous Research, Hermes Agent Documentation: Persistent Memory, Skills System, and Curator, 2026. https://hermes-agent.nousresearch.com/docs/user-guide/features/memory ; https://hermes-agent.nousresearch.com/docs/user-guide/features/skills ; https://hermes-agent.nousresearch.com/docs/user-guide/features/curator
[^voyager-2023]: Wang, G., et al. Voyager: An Open-Ended Embodied Agent with Large Language Models. arXiv:2305.16291, 2023.
[^weng-harness-2026]: Weng, Lilian. "Harness Engineering for Self-Improvement." Lil'Log, 2026. https://lilianweng.github.io/posts/2026-07-04-harness/
[^ace-2026]: Zhang, Qizheng, et al. Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models. ICLR 2026. arXiv:2510.04618.
[^mce-2026]: Ye, Haoran, et al. Meta Context Engineering via Agentic Skill Evolution. arXiv:2601.21557, 2026.
[^aflow-2025]: Zhang, Jiayi, et al. AFlow: Automating Agentic Workflow Generation. ICLR 2025. arXiv:2410.10762.
[^meta-harness-2026]: Lee, Yoonho, et al. Meta-Harness: End-to-End Optimization of Model Harnesses. arXiv:2603.28052, 2026.
[^ahe-2026]: Lin, Jiahang, et al. Agentic Harness Engineering: Observability-Driven Automatic Evolution of Coding-Agent Harnesses. arXiv:2604.25850, 2026.
[^self-harness-2026]: Zhang, Hangfan, et al. Self-Harness: Harnesses That Improve Themselves. arXiv:2606.09498, 2026.
[^harness-benefit-2026]: Lin, Minhua, et al. Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents. arXiv:2605.30621, 2026.
[^llm-scientists-2026]: Trehan, Dhruv and Paras Chopra. Why LLMs Aren't Scientists Yet: Lessons from Four Autonomous Research Attempts. arXiv:2601.03315, 2026.
[^scientistone-2026]: Meng, et al. ScientistOne: Towards Human-Level Autonomous Research via Chain-of-Evidence. arXiv:2605.26340, 2026.
Tóm tắt chương
Học liên tục đang trở thành một trong những năng lực quan trọng nhất của Agent, nhưng các mô hình ngày nay vẫn chưa thể thực hiện nó đáng tin cậy trên riêng mình. Thích nghi ngữ cảnh trong quá trình suy luận không tự động duy trì, trong khi cập nhật tham số trực tuyến chưa được xác minh khuếch đại nhiễu, tấn công và trôi năng lực. Phương pháp thực tiễn hơn ngày nay là xây dựng một hệ thống học có thể xác minh xung quanh mô hình.
Agent thu thập tín hiệu học tập từ tương tác và đánh giá, sau đó cập nhật kiến thức, Prompt, Skills, chương trình hoặc tham số mô hình tùy theo cách năng lực được biểu diễn. Hệ thống cũng có thể tối ưu hóa các phương pháp được sử dụng để quản lý và tạo các sản phẩm này, nhưng nên ưu tiên các thay đổi cục bộ có thể phân bổ, xác minh và đảo ngược.
Evolution liên tục nên tách thực thi trực tuyến khỏi học ngoại tuyến: ghi bằng chứng trực tuyến; tạo và xác minh cập nhật ứng viên ngoại tuyến; sau đó phát hành, hợp nhất hoặc rollback dần dần. Vòng lặp này đáng tin cậy nhất khi kết quả có thể tự động xác minh. Đối với các tác vụ mở với mục tiêu mơ hồ và phản hồi bị trì hoãn, con người vẫn phải tham gia vào xác định vấn đề và thiết kế tiêu chí đánh giá.
Câu hỏi suy ngẫm
- ★★ Một tài liệu kinh nghiệm được hỗ trợ bởi ba quỹ đạo thành công và một quỹ đạo thất bại. Thất bại xảy ra với phiên bản API mới hơn. Hệ thống nên xác định liệu kinh nghiệm đã bị vô hiệu hóa hay điều kiện áp dụng của nó đã thay đổi như thế nào?
- ★★ Sự hài lòng người dùng của một Agent dịch vụ khách hàng tăng, nhưng tỷ lệ vi phạm quy tắc cũng tăng. Tại sao sự hài lòng không thể đóng vai trò là tín hiệu học tập duy nhất? Bạn sẽ thiết kế các chỉ số guardrail như thế nào?
- ★★★ Cùng một vấn đề "cam kết sai" có thể được giảm thiểu thông qua Prompt, kiểm tra Harness hoặc đào tạo tham số. Bạn sẽ sử dụng bằng chứng nào để chọn nơi thực hiện sửa đổi?
- ★★★ Agent có thể sửa đổi công cụ và trình xác minh, nhưng không nên được phép sửa đổi gốc đáng tin cậy phê duyệt cập nhật của chính nó. Bạn sẽ tách quyền và ranh giới mã của hai phần này như thế nào?
- ★★ Khi cơ sở kiến thức kinh nghiệm tăng trưởng, lỗi truy xuất và xung đột kiến thức có thể bù đắp lợi ích của học tập. Cơ chế phiên bản, độ mới và loại bỏ nên được thiết kế như thế nào?
- ★★★ Học tham số hiệu quả cho phong cách ngôn ngữ tự nhiên nhưng khó đảm bảo quy tắc kinh doanh nghiêm ngặt. Thiết kế một lược đồ evolution liên tục cho dịch vụ khách hàng y tế phối hợp tham số, kiến thức, Skills và ràng buộc cấp mã.