Chương 1 so sánh context với "đôi mắt" của Agent: Agent chỉ có thể ra quyết định từ thông tin nó nhìn thấy. Thiết kế và quản lý context được gọi là Context Engineering. Context là tất cả thông tin AI thực sự "nhìn thấy" mỗi khi bạn tương tác với nó. Nó không chỉ bao gồm lịch sử hội thoại, mà còn cả các quy tắc hành vi do nhà phát triển viết (system instructions), mô tả các khả năng bên ngoài sẵn có cho AI (tool descriptions), và các thông tin khác. Từ góc nhìn Harness được giới thiệu trong Chương 1, context engineering là triển khai cốt lõi của lớp "Context and Tools" của Harness: nó xác định thông tin Agent nhìn thấy tại mỗi điểm ra quyết định và cách thông tin đó được cấu trúc. Một context được thiết kế tốt là hệ thống cung cấp thông tin hiệu quả cho phép Agent áp dụng đầy đủ khả năng suy luận tổng quát vào một tác vụ cụ thể.
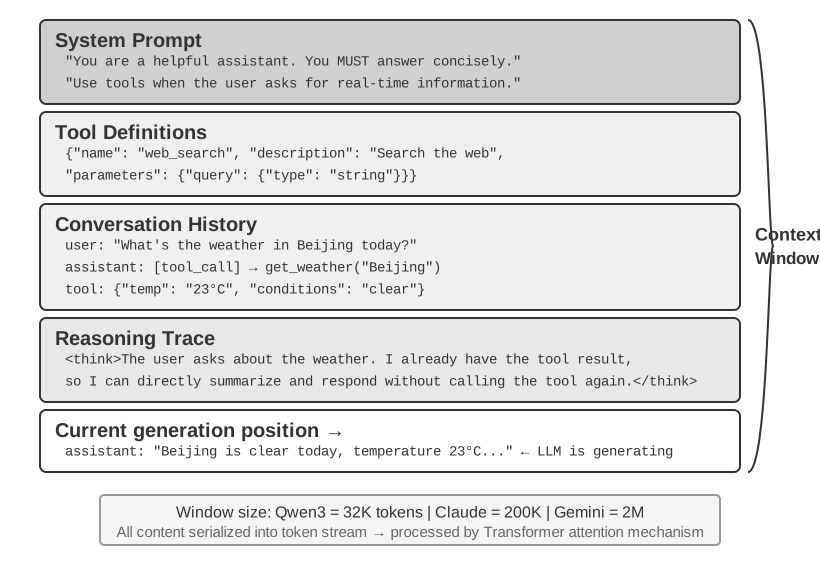
Hình 2-1: Tổng quan về thành phần Context Window
Context: Trần khả năng của Agent
Các large language model đạt kết quả mạnh trên các benchmark chuẩn hóa, nhưng thường gây thất vọng trong các thiết lập kinh doanh thực tế. Đó là vì các tác vụ cụ thể yêu cầu thông tin nền—chẳng hạn như kiến trúc sản phẩm, quy tắc kinh doanh và quy ước nội bộ—mà một model tổng quát đơn giản là không biết.
Xem xét một kỹ sư có năng lực cao tham gia một đội mới. Họ có thể có kiến thức lý thuyết sâu và khả năng lập trình mạnh, nhưng họ chưa hiểu kiến trúc sản phẩm, logic kinh doanh, nợ kỹ thuật hoặc quy chuẩn đội. Nếu các quyết định kiến trúc quan trọng nằm rải rác trong trí nhớ cá nhân và codebase được tài liệu hóa kém, ngay cả một kỹ sư xuất sắc cũng sẽ gặp khó khăn trong việc nhanh chóng tạo ra giá trị. Các AI Agent ngày nay đối mặt với cùng vấn đề.
Xem xét một Coding Agent. Với cùng hướng dẫn, "Giúp tôi sửa lỗi này," chất lượng context mà Agent nhận được xác định liệu nó có thể hoàn thành tác vụ hay không:
Code context: Cấu trúc codebase, trách nhiệm module, cấu trúc dữ liệu cốt lõi và tiêu chuẩn coding. Nếu không có thông tin này, Agent có thể tạo ra code đúng cú pháp nhưng không nhất quán với phong cách hoặc kiến trúc dự án.
Yêu cầu quy trình: Chiến lược branching Git, quy ước commit, quy trình review và yêu cầu CI/CD. Nếu không có thông tin này, Agent có thể commit code chưa được kiểm tra trực tiếp vào nhánh chính.
Cấu hình môi trường: Thiết lập phát triển, chuỗi kết nối cơ sở dữ liệu kiểm tra, quy trình triển khai môi trường kiểm tra và thực hành quản lý API key. Nếu không có thông tin này, một bản sửa hoạt động cục bộ có thể thất bại ngay trong môi trường kiểm tra.
Ba loại này—code, quy trình và môi trường—tạo thành context tối thiểu mà Agent cần để làm việc hiệu quả. Những gì đi vào context ở đây là quan sát, mô tả hoặc cấu hình của Environment, không phải chính Environment; Environment vẫn là đối tượng bên ngoài mà Agent tương tác. Khả năng nội tại của model chỉ là nền tảng; chất lượng context mới là chìa khóa thực sự cho khả năng Agent. Một model có năng lực trung bình với context được tổ chức tốt thường có thể vượt trội hơn một model mạnh hơn hoạt động với context không đủ.
Context engineering do đó là trung tâm để xây dựng Agent hiệu quả với các model ngày nay. Nó không chỉ đơn giản là thêm nhiều văn bản vào prompt. Nó đòi hỏi thiết kế, tổ chức và cung cấp có hệ thống kiến thức nền mà model cần để hoàn thành tác vụ.
Context engineering không chỉ là một vấn đề kỹ thuật, mà còn là một vấn đề tổ chức. Trong nhiều đội, kiến thức quan trọng vẫn ở dạng ngầm: các quyết định kiến trúc nằm trong trí nhớ của kỹ sư cao cấp, quy tắc kinh doanh được truyền đạt không chính thức, và context quan trọng bị chôn trong nhật ký trò chuyện riêng tư. Nếu bản thân đội là một môi trường thông tin kém, ngay cả một AI Agent mạnh cũng sẽ bị giới hạn.
Các đội làm việc hiệu quả trong thiết lập từ xa thường cũng cung cấp môi trường hiệu quả cho AI Agent. Các dự án open-source như Linux kernel là những ví dụ instructive: các nhà phát triển phân tán trên toàn thế giới đã duy trì dự án hơn ba mươi năm. Điều này hoạt động vì dự án có văn hóa giao tiếp minh bạch, lấy tài liệu làm trọng tâm. Các cuộc thảo luận là công khai, quyết định được ghi nhận, và người mới có thể hiểu sự tiến hóa của code bằng cách đọc lịch sử. Phong cách làm việc tương tự tự nhiên tạo ra môi trường thân thiện với AI: thông tin công khai, có thể truy xuất và có cấu trúc.
Hãy coi AI Agent như một thành viên mới của đội mỗi khi nó bắt đầu tác vụ. Với đủ nền tảng, nó có thể tạo ra công việc chất lượng cao; nếu không có nền tảng đó, phần lớn trí thông minh của nó bị lãng phí. Xây dựng một đội AI-native do đó chủ yếu là nỗ lực tài liệu hóa, không chỉ đơn giản là triển khai công cụ mới.
Nhà nghiên cứu OpenAI Jiayi Weng đã diễn đạt rõ ràng điểm này: "Đối với cả con người và model, điều quan trọng nhất là Context." Suy ngẫm về công việc của mình, anh ấy nhận xét: "Công việc của tôi tại OpenAI không khó khăn lắm. Nếu người khác có tất cả context của tôi, họ cũng có thể làm được." Nguyên tắc tương tự áp dụng cho Agent: giá trị mà Agent tạo ra trong kinh doanh thường phụ thuộc không phải vào kích thước model, mà vào sự đầy đủ và chính xác của context được cung cấp tại mỗi điểm ra quyết định. Weng cũng quan sát rằng vấn đề trung tâm trong làm việc nhóm là sự không nhất quán của context, và một lý do AI không thể thay thế con người trong ngắn hạn là AI và con người không chia sẻ cùng môi trường. Context engineering giải quyết chính xác vấn đề này: làm thế nào để cung cấp có hệ thống thông tin nền có cấu trúc mà Agent cần cho model.
ReAct được coi rộng rãi là một trong những công trình nền tảng về xây dựng Agent với large language models. Câu mở đầu của bài báo kết nối các mối quan hệ giữa Agent, Environment, Context và Action[^ch2-react]:
Consider a general setup of an agent interacting with an environment for task solving. At time step $t$, an agent receives an observation $o_t \in \mathcal{O}$ from the environment and takes an action $a_t \in \mathcal{A}$ following some policy $\pi(a_t \mid c_t)$, where $c_t=(o_1,a_1,\ldots,o_{t-1},a_{t-1},o_t)$ is the context to the agent.
Điều quan trọng nhất trong định nghĩa này không phải là các ký hiệu, mà là hành động tiếp theo của Agent phụ thuộc vào toàn bộ context tương tác tích lũy đến thời điểm hiện tại, không chỉ vào đầu vào ngay trước mặt nó. Đối với LLM Agent, user messages và tool execution results là observations trả về bởi Environment, trong khi model replies và tool-call requests là actions thực hiện bởi Agent; các observations và actions này xen kẽ và tích lũy thành lịch sử tương tác. Một yêu cầu API thực tế cũng đặt system prompt và tool definitions trước lịch sử này, cùng nhau tạo thành context mà model nhận được trong vòng hiện tại. Vì model API là stateless, Agent framework phải tái tạo context đầy đủ cho mỗi lần gọi. Cách tiếp cận không mất mát trực tiếp nhất là bao gồm toàn bộ message history cho đến nay; các hệ thống sản phẩm có thể tóm tắt và nén nó, nhưng không được loại bỏ im lặng thông tin cần thiết để xác định hành động tiếp theo. Tất cả các bố cục context, thanh trạng thái và kỹ thuật nén sau này trong chương này có thể được xem như câu trả lời cho một câu hỏi: làm thế nào chúng ta có thể cung cấp cho model một $c_t$ giàu thông tin với chi phí thấp hơn?
[^ch2-react]: Yao, Shunyu, et al. "ReAct: Synergizing Reasoning and Acting in Language Models." ICLR, 2023. https://arxiv.org/abs/2210.03629
Câu hỏi tiếp theo là cách thông tin ngữ cảnh này được cung cấp cho LLM ở cấp độ kỹ thuật.
Cách Agent gọi LLM: Cấu trúc Context cấp API
Phần này sử dụng Chat Completions API của OpenAI làm ví dụ cụ thể. Anthropic, Google và các nhà cung cấp khác khác biệt ở chi tiết, nhưng các API hướng Agent của họ theo một mẫu tương tự: mỗi lần gọi model được xây dựng từ một lịch sử hội thoại có cấu trúc cộng với một tập hợp tool definitions sẵn có. Hiểu cấu trúc này là nền tảng cho các kỹ thuật context engineering được thảo luận sau trong chương này.
Bốn vai trò Message
Trong các API kiểu Chat Completions, đầu vào cốt lõi là một danh sách message, thường được đặt tên là messages. Mỗi message có một trường role cho biết model cách diễn giải message và nó đến từ đâu:
system: Hướng dẫn do nhà phát triển viết, định nghĩa danh tính, hành vi, ràng buộc và quy trình làm việc của Agent. Model coi đây là hướng dẫn ưu tiên cao. Trong hầu hết các cuộc hội thoại, system message xuất hiện một lần ở đầu danh sách message.
user: Đầu vào từ người dùng cuối, đại diện cho yêu cầu Agent cần xử lý.
assistant: Các đầu ra model trước đó, bao gồm phản hồi ngôn ngữ tự nhiên và yêu cầu gọi tool. Trong các tương tác đa lượt, các message này được đưa vào các yêu cầu sau để lần gọi model stateless tiếp theo có thể truy cập quỹ đạo trước đó.
tool: Kết quả trả về sau khi Agent framework thực thi tool. Mỗi kết quả tool được liên kết với tool call tương ứng thông qua tool_call_id, cho phép model liên kết mỗi kết quả với yêu cầu đã tạo ra nó.
Tool definitions không phải là message. Chúng được cung cấp trong một trường tools riêng biệt, khai báo các tool sẵn có cho model và chỉ định các tham số mỗi tool chấp nhận.
Đây là cùng cấu trúc yêu cầu API như "năm thành phần của context" được giới thiệu trong Chương 1, được phân loại từ một góc nhìn khác: bốn vai trò message system, user, assistant và tool tương ứng với system prompt, user messages, assistant messages và tool results. Thành phần còn lại—tool definitions—được truyền qua trường tools cấp cao nhất thay vì vai trò message. Do đó, "bốn vai trò message + trường tools" chính xác bao phủ năm thành phần context của Chương 1.
Yêu cầu đơn lượt: Lời gọi API đơn giản nhất
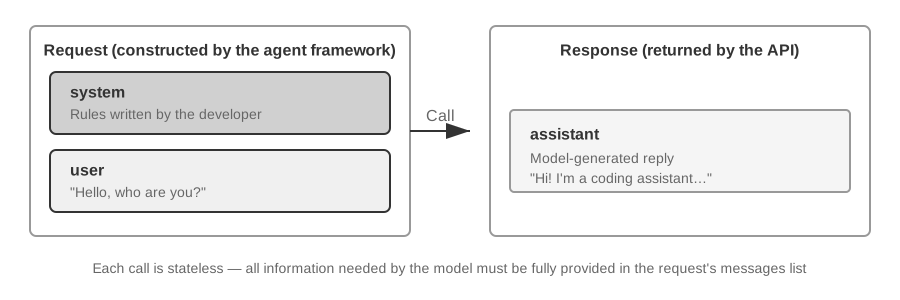
Hình 2-2: Cấu trúc yêu cầu và phản hồi của một lời gọi API đơn lượt
Bắt đầu với trường hợp đơn giản nhất, không có tool call: người dùng hỏi, "Xin chào, bạn là ai?" Ví dụ này sử dụng model Qwen3-0.6B triển khai cục bộ:
// ═══ Yêu cầu được xây dựng bởi Agent framework ═══
{
  "model": "Qwen3-0.6B",
  "messages": [
    {
      "role": "system",                           // ← Do nhà phát triển viết
      "content": "You are a helpful coding assistant. Follow user instructions."
    },
    {
      "role": "user",                              // ← Đầu vào người dùng
      "content": "Hello, who are you?"
    }
  ]
}
// ═══ Phản hồi trả về bởi API ═══
{
  "choices": [{
    "message": {
      "role": "assistant",                         // ← Được tạo bởi model
      "content": "Hi! I'm a coding assistant. I can help you write code, debug issues, and explain technical concepts. How can help?"
    }
  }]
}
Yêu cầu này chỉ chứa hai message: một system message chứa quy tắc do nhà phát triển viết và một user message chứa đầu vào của người dùng. Model trả về một assistant message làm phản hồi. Đây là mẫu tương tác LLM API cơ bản nhất: mỗi lần gọi là stateless, vì vậy danh sách message của yêu cầu phải chứa tất cả thông tin model cần.
Tương tác đa lượt với Tool Call: Vòng lặp cốt lõi của Agent
Các quy trình làm việc Agent thực tế thường phức tạp hơn một Q&A đơn lượt. Khi người dùng hỏi, "Thời gian hiện tại và thời tiết ở Vancouver là gì?", model không thể trả lời từ kiến thức của riêng nó (nó không biết thời gian "bây giờ" là gì, chưa nói đến thời tiết), nên nó phải gọi các tool bên ngoài. Ví dụ sau đây đi qua từng tương tác giữa Agent framework và model.
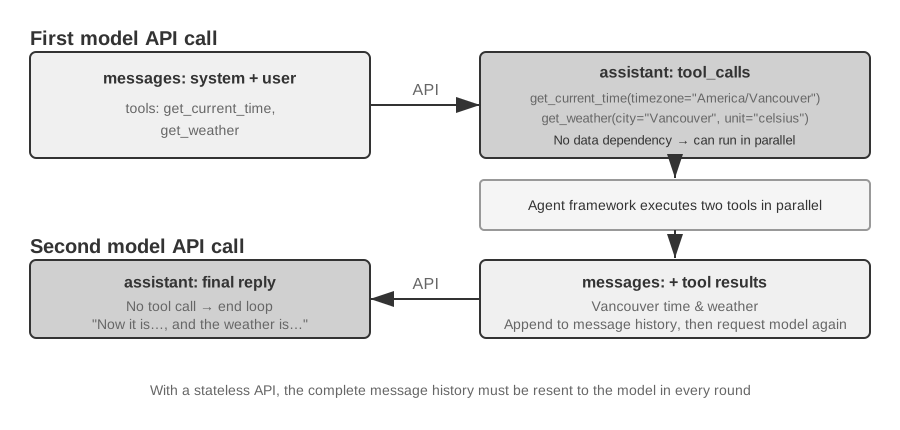
Hình 2-3: Chuỗi tương tác hoàn chỉnh cho hai lời gọi Model API
Hai lời gọi trong hình đều đề cập đến lời gọi đến model API, không phải hai tool được gọi tuần tự. Trong ví dụ này, đối số timezone cho get_current_time và đối số city và unit cho get_weather đều có thể được xác định trước; dịch vụ thời tiết trả về thời tiết mới nhất của thành phố và không phụ thuộc vào đầu ra của tool thời gian, nên Agent framework có thể thực thi chúng song song. Nếu đối số của một tool sau phải đến từ kết quả của một tool trước, model phải yêu cầu tool đó trong một vòng tiếp theo, và hai tool phải thực thi tuần tự.
Lời gọi API đầu tiên — Agent framework gửi yêu cầu ban đầu:
// ═══ Yêu cầu được xây dựng bởi Agent framework (lần gọi 1) ═══
{
  "model": "Qwen3-0.6B",
  "messages": [
    {
      "role": "system",                           // ← Do nhà phát triển viết
      "content": "You are a helpful assistant. Use the provided tools to get real-time information when needed."
    },
    {
      "role": "user",                              // ← Đầu vào người dùng
      "content": "What's the current time and weather in Vancouver?"
    }
  ],
  "tools": [                                       // ← Tools được định nghĩa bởi nhà phát triển
    {
      "type": "function",
      "function": {
        "name": "get_current_time",
        "description": "Get the current date and time in a specific timezone",
        "parameters": {
          "type": "object",
          "properties": {
            "timezone": { "type": "string", "description": "Timezone name, e.g. America/Vancouver" }
          }
        }
      }
    },
    {
      "type": "function",
      "function": {
        "name": "get_weather",
        "description": "Get the current weather for a specific city",
        "parameters": {
          "type": "object",
          "properties": {
            "city": { "type": "string", "description": "City name" },
            "unit": { "type": "string", "enum": ["celsius", "fahrenheit"] }
          }
        }
      }
    }
  ]
}
Model trả về yêu cầu gọi tool (không phải phản hồi cuối cùng):
// ═══ Phản hồi trả về bởi API (model quyết định gọi tool) ═══
{
  "choices": [{
    "message": {
      "role": "assistant",                         // ← Được tạo bởi model
      "content": null,                             // Không có phản hồi văn bản
      "tool_calls": [                              // Model yêu cầu hai tool call
        {
          "id": "call_abc123",
          "type": "function",
          "function": {
            "name": "get_current_time",
            "arguments": "{\"timezone\": \"America/Vancouver\"}"
          }
        },
        {
          "id": "call_def456",
          "type": "function",
          "function": {
            "name": "get_weather",
            "arguments": "{\"city\": \"Vancouver\", \"unit\": \"celsius\"}"
          }
        }
      ]
    }
  }]
}
Model chưa trả lời câu hỏi của người dùng. Thay vào đó, nó trả về hai yêu cầu gọi tool: một cho thời gian hiện tại và một cho thời tiết. Vì các yêu cầu này độc lập, Agent framework có thể thực thi chúng song song. Model phát ra yêu cầu gọi; Agent framework thực hiện thực thi thực tế. Sự phân chia trách nhiệm này là trung tâm của kiến trúc Agent: model quyết định gọi tool nào và đối số nào cần truyền, trong khi framework gọi API, chạy code và trả về kết quả.
Agent framework thực thi các tool và sau đó khởi tạo lời gọi API thứ hai:
Sau khi nhận được yêu cầu gọi tool của model, Agent framework thực thi hai tool (ví dụ, bằng cách gọi API thời gian và API thời tiết), sau đó gửi toàn bộ lịch sử hội thoại cùng với kết quả thực thi tool trở lại cho model:
// ═══ Yêu cầu được xây dựng bởi Agent framework (lần gọi 2) ═══
{
  "model": "Qwen3-0.6B",
  "messages": [
    {
      "role": "system",                           // ← Giống lần gọi 1
      "content": "You are a helpful assistant. Use the provided tools to get real-time information when needed."
    },
    {
      "role": "user",                              // ← Giống lần gọi 1
      "content": "What's the current time and weather in Vancouver?"
    },
    {
      "role": "assistant",                         // ← Đầu ra model từ lần gọi 1, được đưa vào nguyên văn
      "content": null,
      "tool_calls": [
        { "id": "call_abc123", "function": { "name": "get_current_time", "arguments": "{\"timezone\": \"America/Vancouver\"}" } },
        { "id": "call_def456", "function": { "name": "get_weather", "arguments": "{\"city\": \"Vancouver\", \"unit\": \"celsius\"}" } }
      ]
    },
    {
      "role": "tool",                              // ← Được tạo bởi Agent framework (kết quả thực thi tool)
      "tool_call_id": "call_abc123",
      "content": "{\"timezone\": \"America/Vancouver\", \"datetime\": \"2025-09-13T05:18:47\", \"day_of_week\": \"Saturday\"}"
    },
    {
      "role": "tool",                              // ← Được tạo bởi Agent framework (kết quả thực thi tool)
      "tool_call_id": "call_def456",
      "content": "{\"city\": \"Vancouver\", \"temperature\": 13.2, \"unit\": \"celsius\", \"conditions\": \"clear\", \"humidity\": 93}"
    }
  ],
  "tools": [ ... ]                                 // ← Định nghĩa tool giống như trên, bỏ qua
}
Có ba chi tiết quan trọng ở đây:
Yêu cầu thứ hai bao gồm toàn bộ lịch sử hội thoại từ yêu cầu đầu tiên — system message, user message, assistant message chứa tool calls, và các tool results mới được thêm vào. Điều này minh họa bản chất stateless của API: Agent framework phải đưa lịch sử liên quan vào mỗi yêu cầu.
Assistant message đầu tiên được chèn lại vào danh sách message nguyên văn — điều này cho phép lần gọi model tiếp theo truy cập các quyết định tool-call được thực hiện trong lần gọi trước.
Tool messages được liên kết với các tool call tương ứng thông qua tool_call_id — điều này cho model biết kết quả nào thuộc về yêu cầu gọi nào.
Model tạo phản hồi cuối cùng dựa trên kết quả tool:
// ═══ Phản hồi trả về bởi API (phản hồi cuối cùng) ═══
{
  "choices": [{
    "message": {
      "role": "assistant",                         // ← Được tạo bởi model
      "content": "It's currently 5:18 AM on Saturday, September 13, 2025 in Vancouver.\n\nWeather: 13.2°C with clear skies and 93% humidity. It's quite cool this morning - you might want to grab a jacket."
    }
  }]
}
Lần này, model không trả về tool_calls; nó trả về phản hồi văn bản vì nó đánh giá rằng nó có đủ thông tin để trả lời câu hỏi của người dùng, và Agent dừng lại. Chu kỳ "yêu cầu → gọi tool → thực thi → trả về kết quả → yêu cầu tiếp theo" này là triển khai cấp API của vòng lặp ReAct được giới thiệu trong Chương 1.
Nếu người dùng muốn thêm thông tin (ví dụ, bằng cách hỏi "Tokyo thì sao?"), Agent framework thêm phần theo dõi vào cuối lịch sử hội thoại và thực hiện một lời gọi model API khác. Model bắt đầu trả về tool_calls trở lại, và Agent framework thực thi chúng, gửi lại kết quả, và lặp lại chu kỳ.
Triển khai vòng lặp cốt lõi của Agent trong Code
Bây giờ cấu trúc JSON đã rõ ràng, chúng ta có thể kết nối các bước trên trong Python. Sau đây là triển khai Agent tối thiểu được xây dựng quanh một vòng lặp đơn:
from openai import OpenAI

client = OpenAI()

# ── Định nghĩa tool ──
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_current_time",
            "description": "Get the current date and time in a specific timezone",
            "parameters": {
                "type": "object",
                "properties": {
                    "timezone": {"type": "string", "description": "Timezone name, e.g. America/Vancouver"}
                },
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "Get the current weather for a specific city",
            "parameters": {
                "type": "object",
                "properties": {
                    "city": {"type": "string", "description": "City name"},
                    "unit": {"type": "string", "enum": ["celsius", "fahrenheit"]},
                },
            },
        },
    },
]

# ── Hàm thực thi tool (stub với kết quả mẫu; triển khai thực
#    phải phân tích JSON `arguments` và gọi API thực tế) ──
def execute_tool(name, arguments):
    if name == "get_current_time":
        return '{"datetime": "2025-09-13T05:18:47", "day_of_week": "Saturday"}'
    elif name == "get_weather":
        return '{"temperature": 13.2, "unit": "celsius", "conditions": "clear", "humidity": 93}'

# ── Danh sách message ban đầu ──
messages = [
    {"role": "system", "content": "You are a helpful assistant. Use tools to get real-time information when needed."},
    {"role": "user", "content": "What's the current time and weather in Vancouver?"},
]

# ── Vòng lặp cốt lõi của Agent ──
# Code sản phẩm cần giới hạn max_iterations ở đây: như được thảo luận sau
# trong chương này, Agent có thể bị kẹt lặp lại cùng tool call mãi mãi
while True:
    response = client.chat.completions.create(
        model="Qwen3-0.6B", messages=messages, tools=tools
    )
    assistant_message = response.choices[0].message

    # Thêm phản hồi model vào danh sách message (dù là văn bản hay tool calls)
    messages.append(assistant_message)

    # Nếu không có tool call nào được yêu cầu, model đã tạo phản hồi cuối cùng
    if not assistant_message.tool_calls:
        print(assistant_message.content)
        break

    # Thực thi mỗi tool mà model yêu cầu, thêm kết quả vào danh sách message
    for tool_call in assistant_message.tool_calls:
        result = execute_tool(tool_call.function.name, tool_call.function.arguments)
        messages.append({
            "role": "tool",
            "tool_call_id": tool_call.id,
            "content": result,
        })
    # Quay lại đầu vòng lặp, gọi model lại với danh sách message đã cập nhật
Vòng lặp có một nhánh chính: nếu model trả về tool_calls, thực thi các tool và tiếp tục; nếu không, xuất kết quả và thoát. Trong quá trình này, danh sách messages liên tục phát triển vì mỗi vòng thêm phản hồi model và bất kỳ kết quả thực thi tool nào.
Danh sách messages thay đổi qua các vòng như sau:
Trạng thái ban đầu (trước lần gọi đầu tiên):
messages = [
  { role: "system",  content: "You are a helpful assistant..." },     # Do nhà phát triển viết
  { role: "user",    content: "What's the current time and weather in Vancouver?" },  # Đầu vào người dùng
]
Sau lần gọi đầu tiên (model trả về tool calls):
messages = [
  { role: "system",    content: "..." },
  { role: "user",      content: "What's the current time..." },
  { role: "assistant", tool_calls: [get_current_time, get_weather] },  # + Được tạo bởi model
  { role: "tool",      tool_call_id: "call_abc", content: "{time...}" },  # + Được thực thi bởi framework
  { role: "tool",      tool_call_id: "call_def", content: "{weather...}" },  # + Được thực thi bởi framework
]
Sau lần gọi thứ hai (model trả về phản hồi cuối cùng, vòng lặp kết thúc):
Quá trình này cho thấy một trách nhiệm trung tâm của Agent framework là duy trì danh sách message: thêm message vào đúng thời điểm và gửi lịch sử liên quan đến model. Các kỹ thuật context engineering trong chương này phần lớn là về cải thiện nội dung và cấu trúc của danh sách đó.
Context được cấu trúc như thế nào ở cấp API
Ví dụ trên cho thấy thành phần hoàn chỉnh của context mỗi khi Agent gọi model:
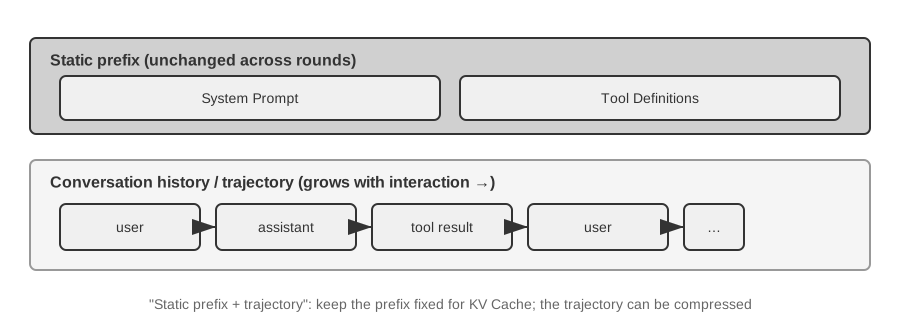
Hình 2-4: Thành phần Context mỗi khi Agent gọi Model
Phần trên (System Prompt + Tool Definitions) không thay đổi trong suốt cuộc hội thoại, trong khi phần dưới (lịch sử hội thoại, tức là trajectory được định nghĩa trong Chương 1) phát triển với mỗi tương tác. Đây là cách năm thành phần context từ Chương 1 xuất hiện ở cấp API: system prompt và tool definitions tạo thành một prefix tĩnh, trong khi user messages, model replies và tool execution results tạo thành lịch sử message phát triển động. Cấu trúc "prefix tĩnh + trajectory" này là nền tảng cho các thảo luận sau về tối ưu KV Cache, nén context và các kỹ thuật liên quan: prefix nên ổn định, trong khi các phần trajectory sau có thể được tóm tắt hoặc thay thế khi đánh đổi là xứng đáng.
Phần còn lại của chương này xem xét từng lớp của cấu trúc này: làm thế nào sử dụng prefix tĩnh ổn định để tăng tốc suy luận (KV Cache), làm thế nào thiết kế System Prompt hiệu quả (prompt engineering), làm thế nào ngăn nội dung bên ngoài chiếm đoạt context (chống prompt injection), làm thế nào tải kiến thức chuyên biệt theo nhu cầu (Agent Skills), làm thế nào tiêm trạng thái động vào cuối cuộc hội thoại (Agent Status Bar), và làm thế nào nén lịch sử hội thoại khi nó phát triển quá lớn (chiến lược nén).
Thí nghiệm 2-1 ★: Triển khai LLM Service cục bộ và gọi Tool
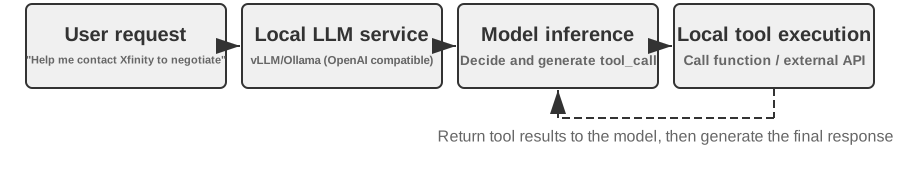
Hình 2-5: Kiến trúc gọi Tool LLM cục bộ
Trước khi chương chuyển sang các cơ chế sâu hơn của Agent context, dự án này minh họa những gì một model nhỏ có thể làm. Dự án local_llm_serving minh họa một điểm quan trọng: các model có khả năng suy luận Chain of Thought (CoT) và gọi tool không nhất thiết yêu cầu số lượng tham số lớn. Ngay cả một model 0.6B tham số cũng có thể thực hiện gọi tool đáng tin cậy khi kết hợp với thiết kế prompt hợp lý và kiến trúc hệ thống.
Thông qua thí nghiệm này, người đọc có thể quan sát:
Khả năng của Model nhỏ: Ngay cả model 0.6B cũng có thể hiểu và thực thi gọi tool chính xác với prompt engineering phù hợp (kỹ thuật thiết kế cẩn thận đầu vào prompt để hướng dẫn hành vi model).
Hiệu suất: Trên chip Apple M2 được sử dụng bởi tác giả cuốn sách này, model có thể tạo phản hồi với hơn 100 token mỗi giây, đủ cho các ứng dụng tương tác thời gian thực. Token là đơn vị cơ bản của xử lý văn bản cho model; một ký tự tiếng Trung thường tương ứng 1–2 token, và một từ tiếng Anh thường tương ứng 1–3 token.
Vòng lặp ReAct: Quan sát cách model giải quyết các vấn đề phức tạp qua nhiều vòng suy luận và gọi tool.
Ưu điểm của Streaming Responses: Đầu ra streaming cho phép người dùng thấy quá trình suy luận của model theo thời gian thực, bao gồm các quyết định về gọi tool và xử lý kết quả.
Tác động của KV Cache (quan sát ngẫu nhiên): Giữ nguyên system prompt, bắt đầu hai cuộc hội thoại liên tiếp và ghi nhận TTFT cho cuộc thứ hai. Sau đó thay đổi vài ký tự ở đầu system prompt, bắt đầu một cuộc hội thoại khác và so sánh TTFT. Trường hợp prefix không đổi sẽ nhanh hơn đáng kể vì nó có thể hit prefix cache, trong khi trường hợp prefix đã sửa phải tính toán lại toàn bộ prefix. Hiện tượng này là chủ đề của phần tiếp theo.
Vòng lặp ReAct trong thực tế.
Gọi tool đa lượt trong dự án này theo vòng lặp ReAct (Think-Act-Observe) được giới thiệu trong Chương 1, nên các nguyên tắc sẽ không được lặp lại ở đây. Phần trước đã cho thấy cấu trúc message hoàn chỉnh của quá trình này bằng định dạng JSON của OpenAI API. Trong triển khai cục bộ, máy chủ (ví dụ, vLLM hoặc Ollama) chuyển đổi các API message này thành định dạng token nội bộ của model. Dự án local_llm_serving cho phép người đọc kiểm tra luồng token đầu vào và đầu ra thô của model, bao gồm các chi tiết thường bị ẩn ở cấp API:
Quá trình suy luận nội bộ của Model: Các model hỗ trợ chain-of-thought (ví dụ, Qwen3) sẽ suy luận bên trong các thẻ trước khi tạo tool calls—phân tích ý định người dùng, đánh giá tool nào phù hợp, và lập kế hoạch thứ tự gọi. Quá trình suy luận này có giá trị cho việc gỡ lỗi hành vi Agent.
Cấu trúc chuỗi đầu ra: Các token đầu ra của model được tạo theo thứ tự cố định—đầu tiên là suy luận nội bộ (bên trong thẻ ), sau đó là phản hồi văn bản cho người dùng, và cuối cùng là yêu cầu gọi tool. Hiểu thứ tự này rất quan trọng cho việc triển khai streaming responses: khi thẻ xuất hiện, giao diện có thể chuyển sang trạng thái "suy luận"; ngay khi tham số cho tool call đầu tiên được tạo đầy đủ và xác nhận, thực thi có thể bắt đầu ngay lập tức, không cần chờ model tạo các tool call tiếp theo.
Gọi tool song song: Trong ví dụ thời gian và thời tiết Vancouver ở phần này, model không tìm thấy sự phụ thuộc giữa hai bài toán con, nên nó tạo hai yêu cầu gọi tool trong một đầu ra. Agent framework có thể phát hiện điều này và thực thi cả hai tool song song, giảm tổng độ trễ.
Phán quyết kết thúc của Model: Khi Agent framework gửi lại kết quả tool, model xác định liệu nó có đủ thông tin để trả lời người dùng hay không. Nếu có, nó xuất phản hồi cuối cùng mà không yêu cầu gọi tool khác; nếu không, nó phát ra thêm tool call và bắt đầu một vòng ReAct khác.
Tóm tắt thí nghiệm.
Điều quan trọng nhất rút ra từ thí nghiệm này là một model 0.6B, với thiết kế prompt hợp lý, có thể hoàn thành gọi tool đáng tin cậy. Kích thước model quan trọng, nhưng nó không phải là yếu tố quyết định duy nhất. Một số thiết bị di động cao cấp đã có thể chạy các model cấp 0.6B, và khả năng thực tế của các model trên thiết bị tiếp tục cải thiện. Agent trên thiết bị gần hơn nhiều người mong đợi.
Bạn có thể nhận thấy phản hồi đầu tiên của model chậm lại sau khi system prompt được sửa đổi. Sự chậm trễ này gây ra bởi hành vi KV Cache được giải thích trong phần tiếp theo: thay đổi prefix làm mất hiệu lực cache và buộc phải tính toán lại.
Thiết kế Context thân thiện với KV Cache
Trước khi xem xét ví dụ, hãy cân nhắc trực giác đằng sau KV Cache. Mỗi lần model tạo một token, nó phải tham chiếu lại các kết quả tính toán trung gian của các token trước đó. Tính toán lại các kết quả đó từ đầu mỗi vòng sẽ ngày càng tốn kém khi context phát triển. KV Cache lưu trữ các trạng thái key-value trung gian để tính toán sau có thể tái sử dụng chúng. Điều kiện tiên quyết là tiền tố chuỗi token context bạn muốn tái sử dụng không thay đổi: nếu chuỗi token lần đầu khác biệt tại một vị trí nào đó, các trạng thái KV cho token đó và mọi thứ sau nó phải được tính toán lại; các trạng thái KV trước vị trí đó không bị ảnh hưởng bởi thay đổi. Một lưu ý về thuật ngữ: khi phần này thảo luận về "cache hits" xuyên suốt các yêu cầu, các nhà cung cấp API thường gọi đây là Prompt Cache—một cache đa yêu cầu được xây dựng trên KV Cache của inference engine. Hai cấp độ được phân biệt ở cuối phần này.
Với trực giác đó, hãy xem xét một sự cố sản phẩm. Một Agent dịch vụ khách hàng của một đội xử lý 100.000 cuộc hội thoại mỗi ngày, và hệ thống hoạt động bình thường. Sau đó một kỹ sư, muốn Agent có quyền truy cập thời gian hiện tại, đã thêm một dòng Current time: {{now}} vào system prompt, tiêm timestamp theo thời gian thực. Ngày hôm sau, cảnh báo giám sát kêu lên: TTFT cho mỗi cuộc hội thoại tăng từ 0,5 giây lên 3–5 giây, và hóa đơn suy luận hàng tháng gần như tăng gấp đôi. Code trông đúng và model không thay đổi. Vấn đề nằm ở context.
Dòng timestamp đó làm cho chuỗi token khác biệt từ timestamp trở đi trên mỗi yêu cầu, nên các trạng thái KV tại vị trí đó và sau nó không thể tái sử dụng. Vì system prompt xuất hiện gần đầu context, model thường vẫn phải tính toán lại các cặp key-value cho hầu hết các token đầu vào theo sau (ở đây, "Key" và "Value" là hai loại vector trong cơ chế attention; Thí nghiệm 2-2 bên dưới minh họa vai trò của chúng). Loại chi phí vô hình này xuất hiện lặp đi lặp lại trong các hệ thống Agent: một dòng code tưởng như vô hại có thể làm chậm toàn bộ pipeline suy luận một bậc độ lớn. Phần này giải thích làm thế nào tránh những cái bẫy này.
Ghi chú kỹ thuật: Phần này liên quan đến các nguyên tắc nội bộ của cơ chế attention Transformer và KV Cache, khiến nó trở thành một trong những phần nặng kỹ thuật nhất của cuốn sách. Nếu bạn không quen thuộc với các cơ chế cơ bản này, bạn có thể bỏ qua các nguyên tắc chi tiết và ghi nhớ ba kết luận cốt lõi sau:
Khi system prompt và tool definitions đã được hoàn thiện, đừng thay đổi chúng. Bất kỳ sửa đổi nào, ngay cả thêm một dấu cách, có thể thay đổi chuỗi token và ngăn cache được tái sử dụng từ token khác biệt đầu tiên trở đi; thay đổi càng sớm, tác động điển hình càng lớn đến độ trễ và chi phí (mức độ chính xác phụ thuộc vào model và cấu hình).
Luôn thêm thông tin động vào cuối—các nội dung thay đổi như timestamp và trạng thái người dùng nên được thêm dưới dạng message mới ở cuối cuộc hội thoại, không phải bằng cách sửa đổi system prompt hiện có.
Sử dụng định dạng API chuẩn; không tự nối message thủ công: Các message có cấu trúc được Chat Template chuyển đổi thành chuỗi token cố định mà model đã thấy trong quá trình đào tạo. Vấn đề cơ bản với việc tự nối chuỗi thành định dạng như "USER: ... ASSISTANT: ..." là nó đi chệch khỏi định dạng đào tạo này, làm suy yếu khả năng suy luận đa bước của model. Tuy nhiên, caching chỉ phụ thuộc vào chuỗi token kết quả. Một prefix được nối thủ công vẫn có thể được cache nếu nó ổn định từng byte. Cache chỉ bị vô hiệu hóa khi prefix đó thay đổi, ví dụ, khi nội dung động được chèn vào nó.
Trực giác đằng sau ba kết luận này rất đơn giản: khi xử lý context, LLM cache nội dung nó đã xử lý ở đầu, nên yêu cầu tiếp theo chỉ cần xử lý những gì mới được thêm vào.
Hãy nhớ ba nguyên tắc này, và ngay cả khi bạn bỏ qua các chi tiết kỹ thuật bên dưới, bạn có thể thiết kế chính xác cấu trúc context của Agent. Nội dung sau dành cho người đọc muốn đi sâu hơn vào "tại sao."
Thí nghiệm 2-2 ★: Trực quan hóa cơ chế Attention
Trước khi giải thích KV Cache, trước tiên chúng ta xây dựng hiểu biết trực giác về cơ chế attention nội bộ của model thông qua thí nghiệm—đây là nền tảng để hiểu tại sao KV Cache hiệu quả và tại sao nó áp đặt yêu cầu nghiêm ngặt lên thiết kế context.
Cơ chế Attention là gì? Xem xét một ví dụ cụ thể. Giả sử model đang xử lý câu tiếng Trung "北京 的 天气 怎么样" ("Thời tiết ở Bắc Kinh thế nào?"), các từ là "北京" (Bắc Kinh), "的" (một trợ từ sở hữu, giống "của"), "天气" (thời tiết), và "怎么样" (thế nào). Khi nó đọc "怎么样", model cần quyết định: từ nào trong các từ trước đó quan trọng nhất để hiểu "怎么样"?
Cơ chế attention sử dụng ba loại vector để quyết định token trước nào liên quan nhất:
Bảng 2-1 tóm tắt vai trò của các vector Query, Key và Value trong cơ chế attention, giúp người đọc ánh xạ phép tính trừu tượng lên câu ví dụ "北京的天气怎么样" ("Thời tiết ở Bắc Kinh thế nào?").
Bảng 2-1 Vai trò của Query, Key và Value trong cơ chế Attention
Vector
Ý nghĩa
Trong ví dụ này
Query
"Yêu cầu tìm kiếm" do từ hiện tại phát ra
"怎么样" (thế nào) hỏi: từ nào liên quan nhất với tôi?
Key
"Nhãn" của mỗi từ, dùng để khớp tìm kiếm
Nhãn của "北京" (Bắc Kinh) nghiêng về "tên địa danh"; nhãn của "天气" (thời tiết) nghiêng về "khí tượng"
Value
"Nội dung" của mỗi từ, được trích xuất khi khớp thành công
Sau khi khớp "天气" (thời tiết), trích xuất thông tin ngữ nghĩa của nó
Đơn giản hóa, mỗi từ mới chấm điểm các từ trước theo mức độ liên quan, sau đó sử dụng thông tin liên quan nhất để xây dựng biểu diễn hiện tại.
Cụ thể hơn, phép tính có ba bước. Đầu tiên, "怎么样" tạo vector Query của riêng nó, đại diện cho những gì token hiện tại đang tìm kiếm. Thứ hai, Query được so sánh với Key của mỗi từ trước bằng tích vô hướng, tạo ra điểm liên quan; điểm cao hơn cho thấy khớp mạnh hơn. Cuối cùng, các điểm này trở thành trọng số attention, được sử dụng để tính tổng có trọng số của Values. Các từ có trọng số cao đóng góp nhiều hơn vào biểu diễn cuối cùng, trong khi các từ có trọng số thấp đóng góp ít hơn.
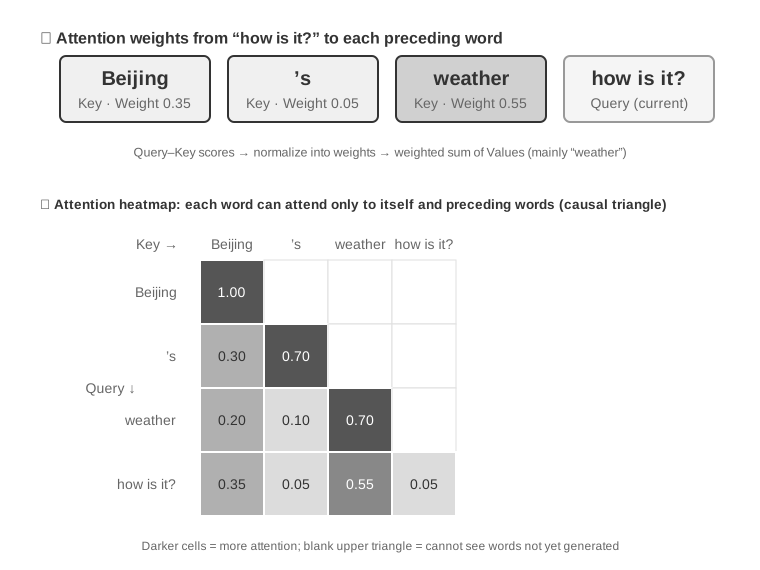
Hình 2-6: Hiểu biết trực giác về cơ chế Attention
Phần trên của Hình 2-6 cho thấy cách "怎么样" (thế nào) khớp với mỗi từ trước: khớp mạnh nhất là với "天气" (thời tiết, 0,55), có một số liên quan đến "北京" (Bắc Kinh, 0,35), gần như không có gì với "の" (trợ từ, 0,05), và trọng số còn lại khoảng 0,05 dành cho chính "怎么样"—tất cả trọng số cộng lại bằng 1. Đầu ra cuối cùng chủ yếu rút ra thông tin từ "天气", khớp hoàn hảo với trực giác.
Bản đồ nhiệt attention sắp xếp các trọng số attention giữa mỗi từ và tất cả các từ trước thành một ma trận. Phần dưới của Hình 2-6 cho thấy bản đồ nhiệt hoàn chỉnh: mỗi hàng là một Query (từ đang được xử lý), mỗi cột là một Key (từ đang được chú ý), và các ô đậm hơn cho thấy trọng số attention cao hơn. Bản đồ nhiệt là hình tam giác vì model tạo văn bản từ trái sang phải: mỗi từ chỉ có thể chú ý đến chính nó và các từ trước nó, không phải nội dung chưa được tạo.
Tại sao Key và Value cần được cache? Quan sát bản đồ nhiệt cho thấy mỗi khi một từ mới được tạo, Query của nó phải được khớp với Keys của tất cả các từ trước, và sau đó tổng có trọng số của tất cả Values được tính. Nếu tất cả K và V được tính lại từ đầu mỗi lần, phép tính sẽ tăng theo độ dài context. KV Cache lưu trữ các giá trị K và V đã được tính, cho phép từ mới trực tiếp tái sử dụng chúng—đây là tối ưu hóa cốt lõi được thảo luận tiếp theo.
Với hiểu biết cơ bản về cơ chế attention, bây giờ chúng ta có thể quan sát phân phối attention của model thực thông qua thí nghiệm attention_visualization.
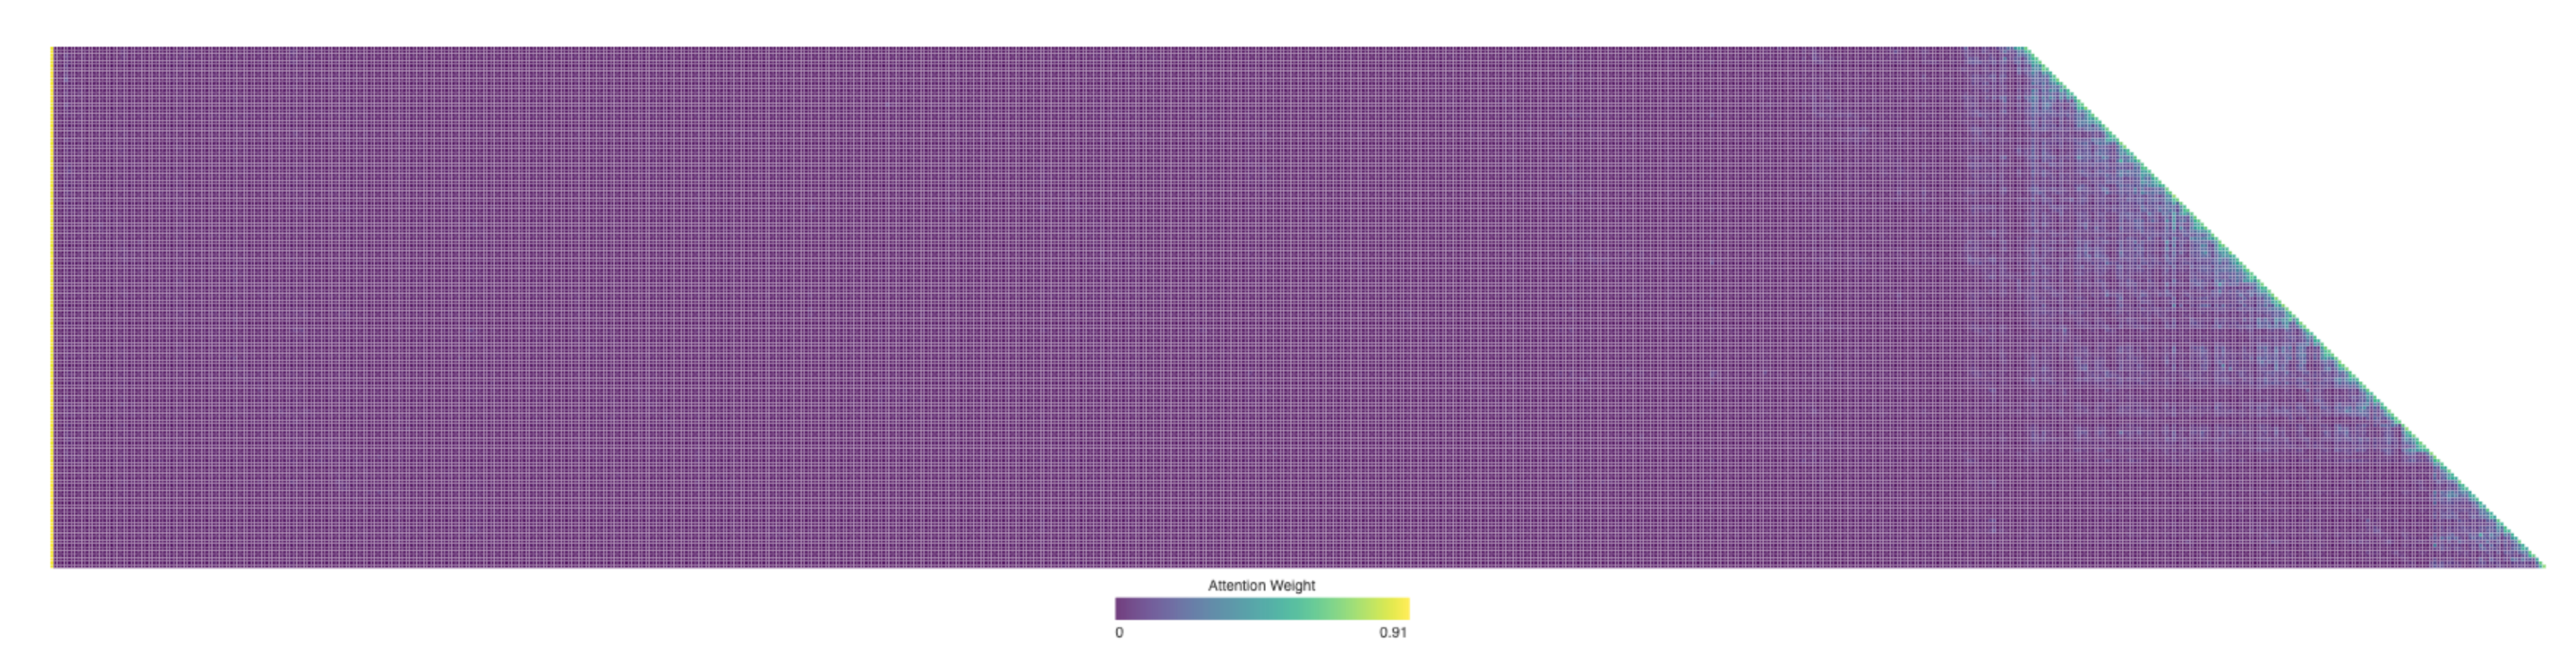
Hình 2-7: Trực quan hóa bản đồ nhiệt Attention
Bản đồ nhiệt attention tiết lộ một số mẫu chính:
Attention Sink: Token đầu tiên của chuỗi thường hấp thụ lượng trọng số attention bất thường cao, đôi khi vượt quá 70% tổng attention. Model sử dụng vị trí này như một "Attention Sink" để hấp thụ phần dư attention mass không tương ứng mạnh với bất kỳ token cụ thể nào khác. Nói cách khác, model học cách gán trọng số attention chưa được phân bổ cho token đầu tiên—đây là hiện tượng hệ thống, không phải lỗi model.
Lý do toán học là cơ chế attention có ràng buộc cứng: tất cả trọng số attention phải cộng lại đúng 100% (được đảm bảo bởi hàm toán học gọi là softmax), nên model không thể biểu diễn "không chú ý gì cả." Ngay cả khi từ hiện tại không liên quan lắm đến bất kỳ từ nào trước đó, các trọng số này phải được phân bổ somewhere. Do đó model cần một container ổn định cho "trọng số dư" này, và vị trí cố định ở đầu chuỗi trở thành lựa chọn tự nhiên nhất. Đây là hệ quả tất yếu của các tính chất toán học của softmax khi xử lý nhiều token.
Mẫu Tam giác Suy luận: Quá trình suy luận của model (bên trong thẻ ) thể hiện mẫu self-attention tam giác: khi tạo nội dung suy luận mới, nó thường xuyên chú ý đến nội dung suy luận trước đó và tool definitions.
Mẫu Tam giác Đầu ra: Quá trình đầu ra sau khi suy luận kết thúc cho thấy một tam giác khác, nơi model sử dụng vết suy luận làm prompt để tạo câu trả lời.
Sai lệch Vị trí[^lost-in-the-middle]: Model có độ nhớ chính xác cao hơn cho thông tin ở đầu và cuối context, trong khi thông tin ở giữa dễ bị bỏ qua hơn. Do đó, khi thiết kế context, đặt thông tin quan trọng nhất ở đầu hoặc cuối là một nguyên tắc thực hành quan trọng.
Thí nghiệm này cho thấy tạo suy luận chuỗi dài và gọi tool đều phụ thuộc nhiều vào in-context learning—khả năng của model thích ứng với tác vụ dựa trên hướng dẫn và ví dụ được cung cấp trong đầu vào, mà không cần đào tạo lại.
Chat Template là một khái niệm nền tảng xuyên suốt cuốn sách này. Nó ảnh hưởng không chỉ đến hành vi KV Cache, mà còn các cơ chế như gọi tool đa lượt, giữ lại chain-of-thought và tiêm status bar. Do đó nó deserves giải thích chuyên biệt. Các chuỗi token trong thí nghiệm trực quan hóa attention (ví dụ, các token đặc biệt như <|im_start|>,