Các chương trước đã khám phá cách Agent vận hành trong thế giới dựa trên văn bản, tương tác với các hệ thống kỹ thuật số thông qua Context, Tools và Code. Nhưng thế giới của một Agent không chỉ giới hạn ở văn bản và API. Khoảnh khắc nó cần hiểu một lệnh nói, tìm và nhấn đúng nút trên màn hình, hoặc điều khiển cánh tay robot để nắm lấy vật thể, nó bước vào lãnh địa mới: tương tác đa phương thức thời gian thực. Sự chuyển đổi từ đầu vào và đầu ra thuần văn bản sang nhận thức đa phương thức và phản hồi thời gian thực là bước ngoặt quan trọng đưa Agent ra khỏi "hộp thoại." "Đa phương thức" đơn giản nghĩa là xử lý nhiều dạng thông tin cùng lúc—văn bản, giọng nói, hình ảnh, video và hành động—thay vì chỉ văn bản.
Trước tiên, hãy xác định phạm vi của chương này. Việc hiểu hình ảnh và tài liệu tĩnh—xem xét ảnh chụp màn hình, đọc biểu đồ, hoặc phân tích PDF—đã trở thành một phần tự nhiên của quy trình làm việc Agent trong các chương trước. Đối với các LLM đa phương thức ngày nay, các tác vụ hiểu đầu vào đơn lẻ này tương đối trưởng thành và không yêu cầu kiến trúc đặc biệt. Chương này giải quyết một loại vấn đề khác: ba kịch bản trong đó ràng buộc thời gian thực khiến các vấn đề đa phương thức trở nên khó khăn—đối thoại giọng nói, vận hành GUI và điều khiển robot. Trong các thiết lập này, đầu vào đến liên tục và đầu ra phải đáp ứng ngân sách thời gian nghiêm ngặt, thay đổi căn bản kiến trúc. Hiểu biết thời gian thực về các luồng hình ảnh liên tục, hay video, vẫn là một vấn đề mở đối với Agent vào thời điểm viết sách. Chúng ta sẽ trở lại vấn đề này khi phần Computer Use kiểm tra giới hạn của ảnh chụp màn hình từng khung, và một lần nữa trong câu hỏi cuối chương. Một ranh giới nữa: trong khuôn khổ cuốn sách này, tạo đa phương thức (tạo hình ảnh hoặc video) đơn giản chỉ là một lệnh gọi công cụ thông thường, như đã đề cập trong Chương 5 về Tạo Đa phương thức. Agent sử dụng nó như một công cụ bên ngoài, vì vậy nó không đặt ra bất kỳ thách thức tương tác thời gian thực nào được giải quyết ở đây và nằm ngoài mạch chính của chương.
Tương tác giọng nói, Computer Use và vận hành robot có vẻ như ba lĩnh vực hoàn toàn khác nhau, nhưng các hệ thống trong cả ba đều gặp phải những vấn đề tương đồng đáng kinh ngạc: chúng phải xử lý nhiều phương thức cùng lúc, và chúng cực kỳ nhạy cảm với độ trễ. Một khoảng dừng hơn hai giây trong cuộc trò thoại giọng nói khiến người ta bồn chồn; độ rung ở mức mili giây trong điều khiển robot có thể gây ra va chạm. Cùng nhau, các ràng buộc này đẩy cả ba kịch bản theo cùng một hướng kiến trúc: rời khỏi pipeline tuần tự (như dây chuyền lắp ráp nhà máy, nơi một bước phải hoàn thành trước khi bước tiếp theo bắt đầu) và hướng tới mô hình end-to-end (một mô hình thống nhất đi trực tiếp từ đầu vào đến đầu ra, loại bỏ các chuyển giao trung gian).
Chương này triển khai theo các hướng sau:
- Trước tiên, chúng ta sử dụng ba paradigm kiến trúc giọng nói làm khuôn khổ: cascaded (pipeline VAD-ASR-LLM-TTS), end-to-end omnimodal (Omni, một mô hình duy nhất vẫn dựa vào lượt nói) và full-duplex (Moshi và GPT-Live, nghe và nói đồng thời). Chúng ta so sánh độ trễ và đánh đổi của mỗi paradigm bằng cách hỏi mỗi paradigm tiến xa như thế nào so với giả định lượt nói rời rạc của VAD. Phần cascaded cũng thảo luận về việc thay thế VAD + ASR bằng nhận thức giọng nói streaming.
- Tiếp theo, chúng ta xem xét kiến trúc suy luận giải quyết xung đột giữa "phản hồi thời gian thực" và "suy luận sâu" như thế nào: từ việc song song hóa đơn giản nhanh và chậm, đến cách tiếp cận tách biệt trong đó mô hình suy luận nền đóng vai trò "nhà chiến lược" (GPT-Live delegation, Pine AI, v.v.), đến "nội tại hóa" suy luận của Step-Audio R1 vào một mô hình duy nhất "suy nghĩ trong khi nói."
- Sau đó, chúng ta thảo luận về cách tổng hợp giọng nói giống con người hơn tối ưu hóa tầng thực thi.
- Cuối cùng, chúng ta mở rộng góc nhìn sang Computer Use (cho phép AI vận hành màn hình máy tính như con người) và vận hành robot, quan sát cách các vấn đề về độ trễ và đa phương thức thể hiện trong hai kịch bản này.
Hai chủ đề lý thuyết nữa đi xuyên suốt các kịch bản này và xứng đáng được chú ý đặc biệt: kiến trúc suy luận (cách suy nghĩ nhanh và chậm cộng tác) và giao diện nhanh-chậm theo sau từ đó (Latent Bridge—mô hình nhanh và chậm có thể trao đổi gì ngoài văn bản). Mặc dù được giới thiệu trong bối cảnh giọng nói, những ý tưởng này không giới hạn ở đó. Các phần Computer Use và robot học cũng gặp cùng câu hỏi về thời điểm tham vấn nhà chiến lược chậm, vì vậy hãy ghi nhớ cả hai chủ đề.
Giọng nói: Giao diện Người-Máy Tự nhiên nhất
Giọng nói không chỉ đơn thuần là văn bản chuyển thành âm thanh. Nói nhanh hơn gõ khoảng bốn lần và giải phóng tay và mắt, vì vậy nó tự nhiên đặt Agent vào vòng lặp đầu vào-đầu ra liên tục nơi người dùng có thể ngắt bất cứ lúc nào. Đọc chính tả chuyển giọng nói thành văn bản; Agent giọng nói cho phép người dùng cộng tác trực tiếp với Agent. Cả hai đều hỗ trợ quy trình whisper-coding được giới thiệu trước đó.
Phần này bao gồm hai hướng: người dùng nói với Agent, và Agent nói thay mặt người dùng với thế giới bên ngoài. Mô hình giọng nói xác định Agent có thể trả lời những gì; kiến trúc tương tác xác định liệu nó có thể nghe rõ, phản hồi kịp thời, chuyển giao tự nhiên và hoàn thành xác nhận cùng lệnh gọi công cụ trong cuộc gọi hay không. Chúng ta trước tiên xem xét thời điểm tương tác, sau đó là thời điểm nhận thức và chất lượng biểu đạt.
Thời điểm tương tác: từ cascaded đến full-duplex
Giới thiệu GPT-Live của OpenAI mô tả ba paradigm tương tác giọng nói—cascaded, lượt nói và full-duplex[^ch9-12]. Chúng không phải là sự thay thế đơn giản từ cũ sang mới; chúng đánh đổi độ trễ, chi phí và khả năng quan sát theo những cách khác nhau:
| Paradigm | Cấu trúc cốt lõi | Ưu điểm chính | Hạn chế chính |
|---|---|---|---|
| Cascaded | VAD → ASR → LLM → TTS | Các module rõ ràng, dễ thay thế và gỡ lỗi | Độ trễ tích lũy và thông tin phi ngôn ngữ bị mất tại các giao diện |
| End-to-end Omni | Một mô hình nghe, suy nghĩ và nói | Độ trễ thấp hơn và bảo tồn tốt hơn ngữ điệu, cảm xúc và âm thanh môi trường | Vẫn dựa trên lượt nói; chi phí đào tạo và gỡ lỗi cao hơn |
| Full-duplex | Liên tục nghe, nói và quyết định | Nói chồng, ngắt tự nhiên và luồng liên tục | Đào tạo, kiểm soát và đánh giá phức tạp hơn |
Sợi chỉ chung là thoát khỏi giả định rằng mọi người phải nói lần lượt, và thoát khỏi phỏng đoán của VAD về ai đang giữ lượt. Hệ thống Cascaded và Omni vẫn chia tương tác thành các lượt; full-duplex biến quyền sở hữu lượt thành một quyết định liên tục của mô hình.
[^ch9-12]: OpenAI. Introducing GPT-Live. 2026-07-08. https://openai.com/index/introducing-gpt-live/ Phân loại cascaded / lượt nói / full-duplex đến từ tóm tắt của bài viết về ba thế hệ ChatGPT Voice; thuật ngữ "end-to-end omnimodal (Omni)" tương ứng với danh mục "mô hình giọng nói lượt nói."
Paradigm 1 · Pipeline Cascaded
Hầu hết các trợ lý giọng nói thương mại vẫn sử dụng pipeline tuần tự (Hình 9-1): VAD quyết định khi nào người dùng đã kết thúc, ASR chuyển đổi âm thanh thành văn bản, LLM hiểu và tạo câu trả lời, và TTS phát âm. Tính mô hình hóa cho phép mỗi thành phần được tối ưu hóa độc lập, nhưng mỗi ranh giới đều có thể thêm thời gian chờ.
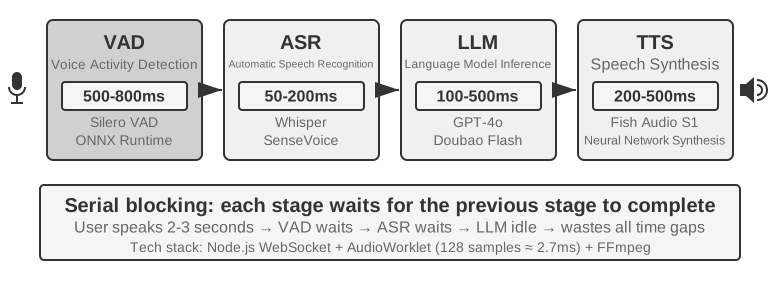
| Module | Vai trò | Nút thắt điển hình |
|---|---|---|
| VAD | Quyết định liệu lời nói đã kết thúc chưa | Ngưỡng im lặng thêm thời gian chờ và chia lượt sai |
| ASR | Chuyển đổi âm thanh thành văn bản | Độ trễ nhận dạng và mất ngữ cảnh |
| LLM | Hiểu, suy luận và tạo | Thời gian đến token đầu tiên; suy luận thêm thời gian chờ |
| TTS | Chuyển đổi văn bản thành giọng nói | Tổng hợp gói đầu tiên và bộ đệm phát lại |
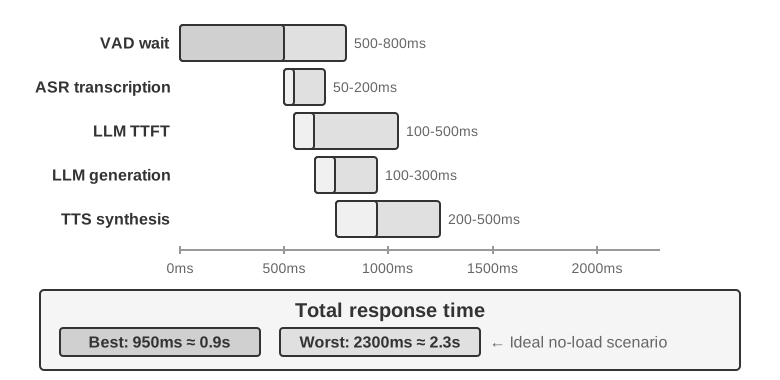
Đối với câu trả lời ngắn không có suy luận, thời gian chờ VAD, ASR, LLM và TTS tích lũy tuần tự (Hình 9-2). Giá trị thực phụ thuộc vào độ dài đầu vào, mô hình, phần cứng, mạng và tải.
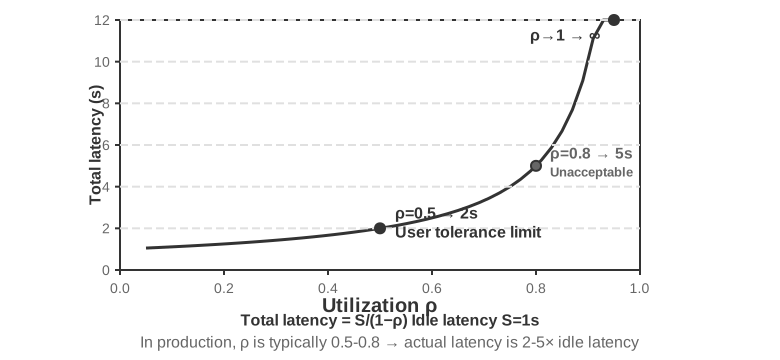
Hàng đợi sản xuất khuếch đại độ trễ nhàn rỗi hơn nữa (Hình 9-3), nhưng quy hoạch năng lượng nằm ngoài phạm vi chương này.
Thí nghiệm 9-1 ★: Xây dựng Agent giọng nói truyền thống
Kết nối micro, Silero VAD, Whisper cục bộ, LLM streaming và Fish S1 TTS qua WebSocket để thiết lập đường cơ sở cascaded. Bằng chứng lượt đơn thực được giữ lại cho thấy chuỗi phương tiện và mô hình đã chạy end-to-end; đây không phải là benchmark về đồng thời hoặc tải sản xuất. Code và hồ sơ chấp nhận nằm trong chapter9/live-audio.
Bổ sung: Xây dựng Agent giọng nói WebRTC "gọi người dùng"
Agent điện thoại không yêu cầu PSTN. WebRTC trình duyệt có thể tái hiện vòng lặp mở phiên, yêu cầu thông tin còn thiếu, lặp lại để xác nhận và lưu kết quả có cấu trúc. Khi phải liên hệ tổ chức bên ngoài, thay thế cùng hợp đồng công cụ bằng nhà cung cấp PSTN/SIP tuân thủ. Đường dẫn phương tiện hoàn chỉnh, so sánh trực tiếp/ReAct và bằng chứng chấp nhận nằm trong chapter9/phone-agent. Dự án giữ lại các định danh chạy `exp9-2` lịch sử nhưng không còn chiếm một thí nghiệm đánh số trong bản thảo.
Từ tuần tự sang nhận thức streaming
Hình 9-2 mô tả trường hợp hoàn toàn tuần tự trong đó mỗi giai đoạn đợi giai đoạn trước. Hệ thống sản xuất có thể giữ nguyên sự phân chia mô-đun trong khi tạo phần tăng càng sớm càng tốt:
- ASR streaming liên tục tạo bản ghi tạm thời trong khi người dùng nói, sau đó xác nhận văn bản cuối cùng tại ranh giới lượt.
- Đầu ra LLM phân đoạn gửi câu nói đầu tiên có thể phát âm cho TTS mà không đợi toàn bộ câu trả lời.
- TTS tăng dần trả về các khối âm thanh để tạo, tổng hợp và phát lại sau đó chồng lên nhau.
"Streaming mọi giai đoạn" không làm ASR, LLM và TTS hoàn toàn song song từ đầu đến cuối. Trong cascade chuẩn, ASR chồng lên lời nói của người dùng và TTS chồng lên các token sau của LLM, nhưng câu trả lời cuối cùng vẫn phụ thuộc vào bản ghi ổn định. Hệ thống tích cực hơn bắt đầu LLM từ bản ghi một phần; nếu văn bản sau thay đổi, nó phải hủy, khởi động lại hoặc sửa đổi tạo ra. Suy đoán yêu cầu cơ chế commit, vô hiệu hóa và rollback rõ ràng; chỉ bật `stream` không cung cấp chúng.
Streaming thông thường cũng không thể loại bỏ thời gian chờ im lặng của V. Một front-end VAD + ASR truyền thống có ba vấn đề:
- Độ trễ tích lũy: phải đợi qua im lặng trước khi xác nhận kết thúc.
- Mất thông tin: bit voiced/unvoiced không thể thể hiện do dự, cảm xúc, backchannel hoặc âm thanh môi trường.
- Ngữ cảnh bị phá vỡ: địa chỉ email, tên và danh từ riêng có thể bị chia giữa các khối và nhận dạng sai.
Mô hình streaming thực sự cần bộ mã hóa causal hoặc chunked với giải mã tăng dần. Bộ giải mã của Whisper là tự hồi quy, nhưng bộ mã hóa của nó mong đợi một đoạn âm thanh hoàn chỉnh, vì vậy nó không nên được gọi là mô hình streaming causal. RNN-T và ASR Conformer streaming đã được sử dụng lâu dài trong ngành; trọng tâm ở đây là nghe ngữ nghĩa được xây dựng trên nền tảng LLM.
Mô hình âm thanh streaming dựa trên LLM có thể phát ra văn bản và sự kiện ngữ nghĩa từ âm thanh liên tục, đặt nhận dạng và một phần hiểu biết trong một mô hình duy nhất. Nó giữ ngữ cảnh hội thoại từ đầu và có thể sử dụng kiến thức thế giới cho thương hiệu, tên và danh từ riêng. Mô phỏng chunking vẫn không phải là lời hứa hiệu suất cho mô hình causal.
Nếu mục tiêu duy nhất là quyết định liệu người dùng đã kết thúc chưa, endpointing có thể được tích hợp vào bộ nhận dạng streaming. Mô hình kết hợp ngữ nghĩa và im lặng để đánh giá liệu một phát ngôn đã hoàn thành chưa. Nhãn đào tạo chỉ được chứa thông tin khả dụng tại thời điểm quyết định, nếu không hindsight sẽ tạo ra đánh giá không thể tái tạo trực tuyến[^ch9-11]. Điều này nhẹ hơn một LLM có khả năng âm thanh hoàn chỉnh.
Mô hình có thể phát ra các đánh dấu sự kiện âm thanh cũng như từ:
- speak_start/end, interrupt: ranh giới lời nói và ý định ngắt;
- emotion: cảm xúc và do dự;
- laugh, sigh, noise: âm thanh phi ngôn ngữ và môi trường.
Cùng với token văn bản, các đánh dấu này tạo thành một luồng sự kiện. Agent có thể phát hiện do dự, ngắt và thay đổi môi trường mà không cần nén mọi âm thanh thành văn bản thuần.
[^ch9-11]: Đối với chẩn đoán về việc nhúng đánh giá lượt vào bộ nhận dạng và vấn đề nhãn dựa trên hindsight, xem Bojie Li và Noah Shi. The Trade-off Was in the Labels: Causal Supervision for Turn-Aware Streaming ASR. 2026 (sắp xuất bản).
Thí nghiệm 9-2 ★: Mô phỏng nhận thức giọng nói streaming với Qwen2-Audio
Qwen2-Audio không phải là mô hình streaming. Thí nghiệm này mô phỏng nhận thức liên tục với tiền tố âm thanh tăng dần và so sánh với VAD 600 ms + Whisper. Nó cho thấy cách ngữ cảnh đầy đủ thay đổi hành vi dừng và tiếng ồn, nhưng mỗi tiền tố mã hóa lại âm thanh trước đó, vì vậy thời gian của nó không phải là lời hứa cho mô hình streaming causal.
Lần chạy chính thức đã vượt qua tất cả cổng thực thi và xuất xứ nhưng chỉ tái tạo được 2/6 hành vi mong đợi: các lệnh gọi tiền tố tăng dần mất 8,4–11,3 giây, mẫu im lặng bỏ sót `silence`, và mẫu tiếng ồn vẫn phân loại sai `cough/laughter`. Kết quả âm này kiểm tra cơ chế và chế độ thất bại; nó không hỗ trợ tuyên bố "nhận thức streaming thực sự 100–200 ms." Xem chapter9/streaming-speech để biết hồ sơ đầy đủ.
Paradigm 2 · Mô hình omnimodal end-to-end (Omni)
Ngay cả với nhận thức streaming, một cascade chuyển nghe, suy nghĩ và nói qua các giao diện rời rạc; cảm xúc, ngữ điệu và âm thanh môi trường có thể bị mất khi âm thanh trở thành văn bản thuần. Omni sử dụng một mô hình để nghe âm thanh, tạo câu trả lời và phát âm nó, có thể bảo tồn các tín hiệu đó với chi phí đào tạo, gỡ lỗi và thay thế thành phần cao hơn (Hình 9-4).
Ưu điểm end-to-end chủ yếu là độ trễ và thông tin phi văn bản, không nhất thiết là độ chính xác. Một self-cascade trước tiên phiên âm với cùng mô hình và sau đó trả lời từ bản ghi: khi văn bản mang thông tin tác vụ, nó có thể sửa lỗi nhận thức; khi câu trả lời phụ thuộc vào tốc độ nói, cảm xúc hoặc âm thanh môi trường, nút thắt văn bản mất bằng chứng không thể phục hồi. Câu hỏi quan trọng không phải là có biểu diễn trung gian hay không, mà là thông tin nó mang[^ch9-13].
Omni vẫn giả định lượt nói và thường sử dụng VAD hoặc endpointing ngữ nghĩa để phân bổ lượt. Một khoảng dừng trong chuỗi số nói có thể bị nhầm là kết thúc; nhận thức cải thiện đánh giá nhưng không loại bỏ lượt.
[^ch9-13]: Đối với đo lường liên phương thức đầy đủ về khi nào ưu điểm chính xác cascade và end-to-end đảo ngược, và cách bản chất tác vụ dự đoán hướng, xem Li, Bojie và Noah Shi. The Cascade Gap: When and Why Self-Cascades Help Multimodal Agents. 2026 (sắp xuất bản).
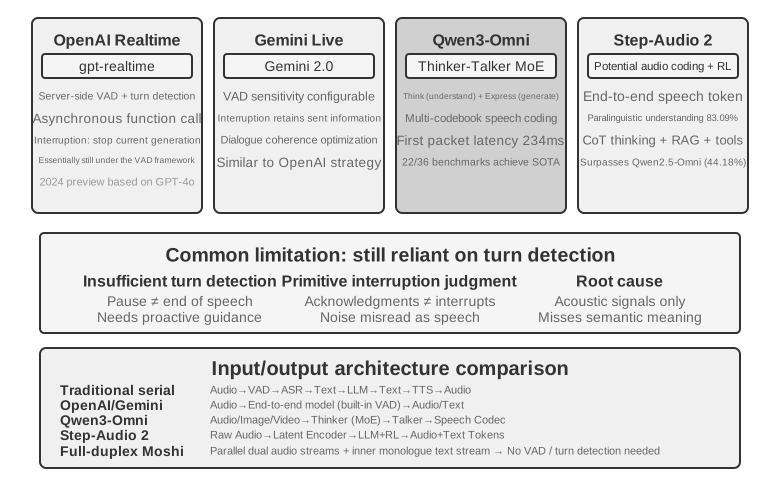
API giọng nói thời gian thực nằm giữa hệ thống cascaded và Omni: mô hình xử lý âm thanh gốc, nhưng kiểm soát tương tác vẫn dựa vào VAD, ngắt và lệnh gọi công cụ bất đồng bộ. Thinker-Talker của Qwen3-Omni và đường dẫn cục bộ của MiniCPM-o cho thấy cách tiếp cận này có thể kết hợp suy nghĩ, biểu đạt và đầu vào đa phương thức ở các kích thước mô hình khác nhau. So sánh hữu ích không phải là bảng xếp hạng; đó là cách đường dẫn end-to-end và self-cascade thất bại trên các tác vụ khác nhau.
Thí nghiệm 9-3 ★★: Chạy MiniCPM-o 4.5 cục bộ—end-to-end so với self-cascade
Chốt một phiên bản MiniCPM-o 4.5 cục bộ, tắt chế độ suy nghĩ, và so sánh câu trả lời âm thanh trực tiếp với self-cascade của cùng mô hình: phiên âm trước, sau đó trả lời từ bản ghi. Điều này đo lường liệu thông tin âm thanh có được bảo tồn hay không, không phải khả năng "suy nghĩ trong khi nói" sau này.
Bảng 9-1. Kết quả end-to-end và self-cascade MiniCPM-o 4.5 cục bộ (bốn kiểm tra cơ chế, không phải benchmark)
Loại tác vụ End-to-end Self-cascade Quan sát Số học ngữ nghĩa (2) 1/2 2/2 Self-cascade sửa một lỗi phiên âm Tốc độ nói phi ngôn ngữ (2) 2/2 1/2 Bản ghi văn bản thuần xóa phân biệt nhanh/chậm Tổng 3/4 3/4 Tổng bằng nhau, thất bại bổ sung Mẫu nhỏ, vì vậy không thể xác định đường dẫn nào nói chung chính xác hơn hoặc nhanh hơn. Phần cứng, phiên bản, đầu ra thô và bằng chứng âm thanh-âm thanh thực nằm trong chapter9/end-to-end-speech.
Step-Audio 2 thể hiện đường dẫn end-to-end xử lý âm thanh thô và phát ra văn bản và giọng nói; nó tập trung vào cảm xúc, tốc độ nói, ngữ điệu và âm thanh môi trường ngoài ngữ nghĩa. Step-Audio R1 mở rộng đường dẫn này bằng cách nội tại hóa suy luận trong mô hình âm thanh; nó sẽ đóng vai trò ví dụ cho "suy nghĩ trong khi nói."
Paradigm 3 · Mô hình tương tác full-duplex
Omni vẫn chia cuộc trò thoại thành "người dùng nói" và "mô hình nói," nhưng phiên dịch đồng thời và các tác vụ tương tự yêu cầu chồng chéo. Mô hình full-duplex do đó không giả định lượt trước: nó nghe và nói liên tục và lặp đi lặp lại quyết định liệu tiếp tục, dừng, ngắt hay gọi công cụ.
Moshi của Kyutai (2024) là một ví dụ nghiên cứu sớm. Nó mô hình hóa luồng âm thanh của người dùng và mô hình song song, vì vậy nói chồng và ngắt có thể là hành vi tự nhiên.
Thinking Machines Lab gọi đây là Mô hình Tương tác [^ch9-14]: tương tác được tích hợp vào mô hình thay vì lắp ráp xung quanh nó với VAD và các harness bên ngoài khác. Cơ chế micro-turn của nó tiến triển trong các khối âm thanh ngắn, bảo tồn im lặng, chồng chéo và ngắt như ngữ cảnh liên tục. Nó có thể chuyển giao toàn bộ cuộc trò thoại cho mô hình suy luận nền trong khi giữ cuộc trò thoại sống, sau đó tích hợp kết quả vào thời điểm phù hợp.
[^ch9-14]: Thinking Machines Lab, "Interaction Models: A Scalable Approach to Human-AI Collaboration," 2026-05. https://thinkingmachines.ai/blog/interaction-models/
GPT-Live của OpenAI đưa đường dẫn full-duplex vào quy mô sản xuất: nó liên tục xử lý đầu vào và tạo đầu ra, có thể chờ, backchannel, bị ngắt và xử lý dịch thuật thời gian thực. Giống như Mô hình Tương tác, nó chuyển giao công việc phức tạp cho mô hình nền trong khi mô hình tiền cảnh duy trì cuộc trò chuyện.
Câu chuyện là: cascade phỏng đoán lượt từ ngưỡng im lặng; nhận thức nâng cấp đánh giá lên cấp độ ngữ nghĩa; full-duplex biến chính công tắc thành một quyết định liên tục.
Thời điểm nhận thức: tương tác thời gian thực và suy luận sâu
Chất lượng tương tác và trần trí tuệ là các chiều khác nhau. Mô hình tiền cảnh phải phản hồi trong khi người dùng vẫn đang tương tác; mô hình nền có thể dành nhiều thời gian suy nghĩ hơn. Ba thiết kế sau đây là đánh đổi, không phải tiến triển tuyến tính. Hai thiết kế đầu có thể bọc mô hình cascade hoặc Omni; chỉ thiết kế thứ ba thống nhất suy nghĩ và biểu đạt trong một mô hình âm thanh end-to-end.
| Thiết kế | Tiền cảnh | Nền | Rủi ro chính |
|---|---|---|---|
| Nhanh điền, chậm sửa | Đưa câu trả lời ngay lập tức | Suy nghĩ lại và bổ sung | Mâu thuẫn |
| Nhanh tương tác, chậm tư vấn | Giữ cuộc trò chuyện sống và chọn từ ngữ | Cung cấp tư vấn hoặc kết quả công cụ | Giao diện bị giới hạn |
| Thống nhất suy nghĩ và biểu đạt | Suy nghĩ và nói cùng nhau | Chia sẻ trạng thái mô hình với biểu đạt | Chi phí đào tạo và thay thế cao |
Giải pháp 1: Suy nghĩ nhanh cho câu điền, suy nghĩ chậm cho câu trả lời
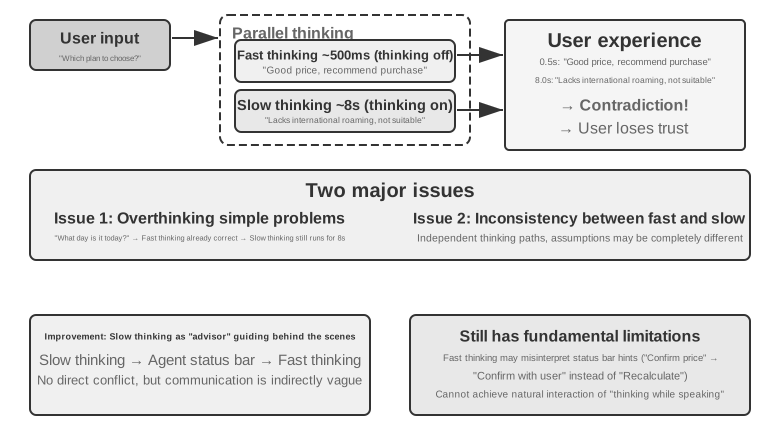
Suy nghĩ nhanh có thể đưa câu trả lời giữ chỗ trong vài trăm mili giây trong khi suy nghĩ chậm thực hiện suy luận sâu hơn trong nền. Câu hỏi đơn giản có thể được xử lý hai lần, trong khi câu hỏi khó có thể tạo ra mâu thuẫn: mô hình nhanh đề xuất mua hàng, sau đó mô hình chậm phát hiện một tính năng quan trọng bị thiếu. Nguyên nhân gốc là hai thể hiện độc lập suy nghĩ riêng biệt.
Giải pháp 2: Suy nghĩ nhanh cho tương tác, suy nghĩ chậm cho tư vấn
Mô hình nền có thể gửi tư vấn qua thanh trạng thái hoặc giao diện chuyên dụng trong khi mô hình tiền cảnh giữ cuộc trò chuyện sống và quyết định cách diễn đạt. Điều này ổn định hơn Giải pháp 1, nhưng giao tiếp vẫn gián tiếp: tiền cảnh có thể hiểu sai tư vấn và không thấy suy luận trung gian của nền. Trước khi nền hoàn thành, câu hỏi tiếp theo vẫn dựa vào mô hình tiền cảnh. Nó có thể tự nhiên chờ kết quả, nhưng không thể thực sự suy nghĩ trong khi nói.
Giải pháp 3: Thống nhất end-to-end suy nghĩ và biểu đạt (sử dụng Step-Audio R1)
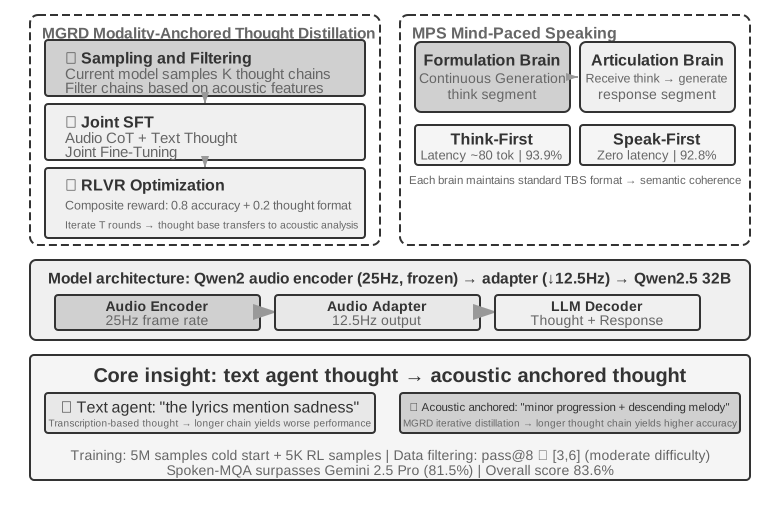
Thiết kế này nội tại hóa suy luận trực tiếp trong mô hình âm thanh end-to-end. Step-Audio R1 sử dụng hai cơ chế bổ sung: Modality-Grounded Reasoning Distillation (MGRD) đặt suy luận trong đặc trưng âm thanh, trong khi kiến trúc hai não MPS cho phép lập kế hoạch và biểu đạt tiến hành song song. Đầu tiên giúp mô hình suy nghĩ đúng; thứ hai giúp nó nói kịp thời.
Lý tưởng nhất, mô hình suy ra cảm xúc từ cao độ, nhịp điệu và ngữ điệu thay vì chỉ từ bản ghi. "Suy nghĩ qua văn bản đại diện" thay thế từ tiêu cực trong lời bài hát bằng phân tích giai điệu và âm học. MGRD chọn các vết suy luận thực sự trích dẫn đặc trưng âm thanh, đào tạo trên chúng và sử dụng học tăng cường để ngăn đoán mò mà không suy nghĩ.
MPS cho phép não kế hoạch liên tục phát ra phân đoạn suy nghĩ; não biểu đạt kết hợp mỗi phân đoạn với câu trả lời một phần và ngay lập tức tạo giọng nói. Pipeline chạy song song, vì vậy người nghe không cần đợi toàn bộ chuỗi suy luận trước khi nghe câu đầu tiên (Hình 9-6).
Mô hình thống nhất thực hiện "suy nghĩ trong khi nói" trực tiếp nhất, nhưng suy nghĩ và biểu đạt thời gian thực phải được đào tạo lại cùng nhau. Thiết kế tách biệt dễ thay thế não nền hơn; thiết kế thống nhất phù hợp với kịch bản chuyên biệt đòi hỏi tương tác tự nhiên nhất. Đây là đánh đổi, không phải thay thế đơn giản.
Tổng hợp giọng nói giống con người hơn
TTS truyền thống có thể lộ danh tính máy tính bằng quá mượt và dừng quá ít. Dừng, từ điền và lặp lại偶尔 trong lời nói con người báo hiệu sự không chắc chắn và suy nghĩ.
LLM chính có thể phát ra đánh dấu kiểm soát ngoài văn bản, chẳng hạn như THINKING, EMO:happy và SPEED:0.8x; TTS ánh xạ chúng thành dừng, ngữ điệu, tốc độ nói, cười, thở dài và âm thanh phi ngôn ngữ khác. Triển khai có thể là TTS được đào tạo hiểu đánh dấu kiểm soát, hoặc nhân bản giọng nói với clip tham chiếu cho các cảm xúc và phong cách khác nhau.
Thí nghiệm 9-4 ★★: TTS dựa trên token kiểm soát với Fish Audio
Sử dụng Fish Audio S1 để xây dựng thư viện giọng nói đa tham chiếu và so sánh ba cấu hình: không đánh dấu kiểm soát, một clip tham chiếu và nhiều clip tham chiếu. Tầng thực thi chọn cảm xúc, tốc độ nói và phong cách phù hợp từ các đánh dấu.
Cấu hình đa tham chiếu đạt điểm cao nhất trong ba lần nghe mù cân bằng vị trí (tương đồng dịch vụ khách hàng 4,67/5), nhưng thứ tự kế hoạch đầy đủ không được tái tạo vì nhóm không đánh dấu vượt qua nhóm một tham chiếu. Kết quả này gợi ý rằng kiểm soát biểu đạt hữu ích, nhưng nghiên cứu nghe nhỏ không phải là kết luận chất lượng giọng nói chung. Thư viện 28 tham chiếu đầy đủ, phương tiện A/B/C và hồ sơ chấp nhận nằm trong chapter9/controllable-tts.
Computer Use: Agent Tự động hóa GUI
Đến giờ bạn có thể nhận thấy chương này dành nhiều không gian hơn cho giọng nói so với hai kịch bản tiếp theo. Điều này có chủ ý. Trong số các hệ thống đa phương thức thời gian thực, công nghệ giọng nói đã tiến xa nhất và do đó cung cấp điểm tham chiếu tốt nhất. Nó đã theo dõi toàn bộ vòng cung từ vấn đề gốc—độ trễ quá mức trong pipeline tuần tự—qua mô hình end-to-end, tương tác full-duplex và suy nghĩ trong khi nói, đến các thiết kế tương đối trưởng thành ngày nay. Đó là lý do chúng ta đã kể câu chuyện đầy đủ. Khi bạn đọc phần Computer Use và robot, hãy so sánh chúng với quỹ đạo này: mỗi lĩnh vực đã tiến xa đến đâu, và mỗi lĩnh vực vẫn bị mắc kẹt ở đâu?
Ba kịch bản này có vẻ khác nhau nhưng đối mặt với cùng thách thức cốt lõi: nhận thức thời gian thực, ra quyết định độ trễ thấp và tương tác liên tục. Tiếp theo, chúng ta chuyển sang tương tác hình ảnh, hay Computer Use, mở rộng góc nhìn từ thính giác sang thị giác: điều gì sẽ xảy ra nếu Agent không chỉ hiểu lời nói mà còn "nhìn thấy" màn hình và vận hành giao diện đồ họa của nó?
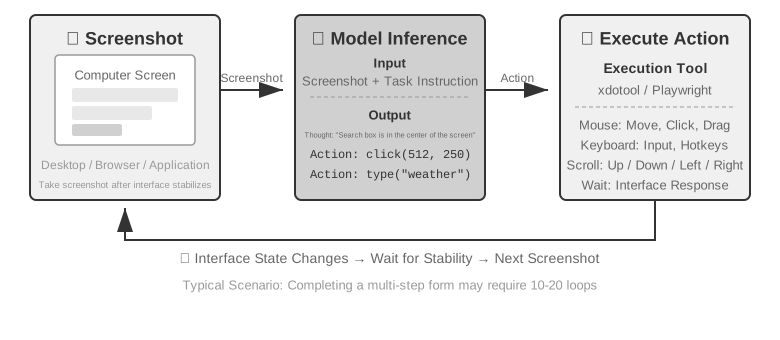
Computer Use, còn được gọi là tự động hóa GUI, cho phép AI sử dụng phần mềm như con người bằng cách quan sát màn hình và vận hành chuột và bàn phím—ví dụ: mở trình duyệt để tìm kiếm thông tin, điền dữ liệu vào ứng dụng bảng tính hoặc điều chỉnh cấu hình trong cài đặt hệ thống. Cốt lõi của nó là vòng lặp Nhận thức-Suy luận-Hành động (Hình 9-6):
- Agent chụp ảnh màn hình hiện tại.
- Mô hình đa phương thức nhận ảnh chụp màn hình và hướng dẫn tác vụ, và xuất ra suy nghĩ và hành động cụ thể.
- Tầng thực thi thực hiện hành động trong môi trường thực (di chuyển chuột, nhấp, gõ văn bản, v.v.).
- Nó đợi giao diện phản hồi, chụp ảnh màn hình khác và bước vào vòng lặp tiếp theo.
Có ba chiều thiết kế chính trong vòng lặp này: Không gian Hành động (những thao tác Agent có thể thực hiện), Định vị Trực quan (cách tìm phần tử mục tiêu trong ảnh chụp màn hình) và Kiến trúc Mô hình (cách tạo hành động đúng từ ảnh chụp màn hình).
Thiết kế Không gian Hành động
Anthropic định nghĩa ba loại công cụ tạo thành khả năng tương tác hoàn chỉnh (Hình 9-7):
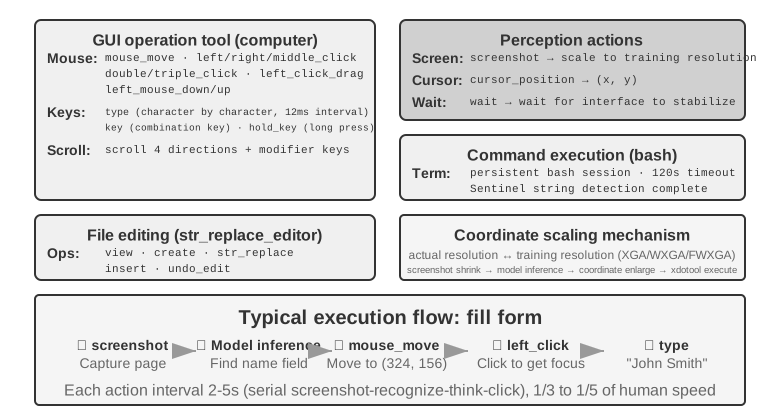
Công cụ Vận hành GUI (công cụ `computer`): Thao tác chuột bao gồm di chuyển (`mouse_move`), nhấp trái/phải/giữa, nhấp đúp hoặc nhấp ba, kéo (`left_click_drag`) và các hành động nhấn/thả chính xác hơn (`left_mouse_down` và `left_mouse_up`). Cuộn (`scroll`) hỗ trợ bốn hướng và có thể kết hợp với phím bổ trợ. Thao tác bàn phím bao gồm gõ từng ký tự (`type`, với khoảng cách 12ms giữa các ký tự để mô phỏng gõ thực), tổ hợp phím (`key`, ví dụ: `Ctrl+C`) và giữ phím (`hold_key`). Hành động nhận thức bao gồm chụp ảnh màn hình, lấy vị trí con trỏ (`cursor_position`) và chờ (`wait`).
Công cụ Thực thi Lệnh (công cụ bash): Cung cấp phiên terminal bash liên tục với thời gian chờ 120 giây. Nó sử dụng chuỗi sentinel để phát hiện hoàn thành lệnh và duy trì trạng thái môi trường qua nhiều lệnh gọi (ví dụ: sau `cd` đến thư mục, lệnh gọi tiếp theo vẫn ở thư mục đó).
Công cụ Chỉnh sửa Tệp (`str_replace_editor`): Cho phép chỉnh sửa an toàn thông qua khớp chuỗi và hỗ trợ xem, tạo, thay thế, chèn và hoàn tác. Nó chính xác hơn việc ghi đè toàn bộ tệp và ít có khả năng sửa đổi nội dung không liên quan một cách vô tình.
Thí nghiệm 9-5 ★: Chạy Computer Use (Đường dẫn Tham chiếu Anthropic hoặc Đường dẫn Mô hình Mở)
Đường dẫn A sử dụng Anthropic Computer Use Demo. Container của nó đóng gói môi trường Ubuntu desktop hoàn chỉnh, bao gồm trình duyệt, terminal và các công cụ phổ biến khác. Frontend nhận tác vụ, trong khi backend gửi hướng dẫn và ảnh chụp màn hình cho Claude và sau đó thực thi các hành động chuột, bàn phím, terminal hoặc chỉnh sửa mà mô hình trả về. Đường dẫn này nhằm hiểu giao thức công cụ `computer` gốc; nó không yêu cầu mọi người đọc có quyền truy cập API Anthropic.
Đường dẫn B sử dụng tài liệu đồng hành của cuốn sách chapter9/computer-use-open-model. Theo mặc định, nó điều khiển browser-use với mô hình mã mở Qwen3-VL 32B Instruct, thông qua API lưu trữ OpenRouter hoặc bằng cách trỏ `OPEN_MODEL_BASE_URL` đến vLLM/SGLang tự lưu trữ hoặc endpoint tương thích khác. Endpoint phải chấp nhận ảnh chụp màn hình và hỗ trợ JSON Schema gốc; nếu nó chỉ hỗ trợ JSON thông thường, chế độ tương thích schema-in-prompt có thể được bật rõ ràng.
Cả hai đường dẫn sử dụng cùng tác vụ chỉ đọc và hợp đồng chấp nhận: tối đa 25 bước, một hành động mỗi bước, và giữ lại danh tính mô hình/endpoint, phản hồi thô của nhà cung cấp, ảnh chụp màn hình từng bước, chuỗi hành động, câu trả lời cuối cùng và lý do dừng. Các mô hình khác nhau phải được báo cáo như các nhánh thí nghiệm riêng biệt; kết quả mô hình mở không được trình bày như bản sao Claude, và khởi động container thành công cũng không được coi là hoàn thành tác vụ. Khoảng cách hành động và chất lượng lập kế hoạch là kết quả đo lường, không phải giả định khoảng cách 2–5 giây hoặc ưu thế không thể tránh khỏi so với các mô hình khác.
Định vị Trực quan
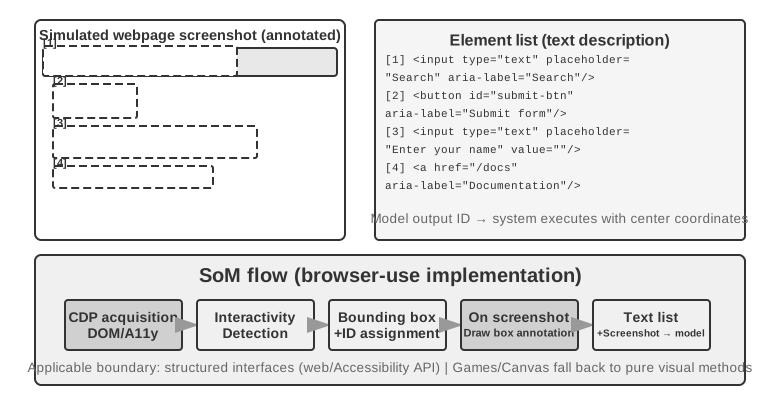
Trong mỗi vòng lặp, mô hình cần định vị chính xác phần tử mục tiêu trong ảnh chụp màn hình—"Hộp tìm kiếm ở đâu?" "Tọa độ của nút gửi là gì?" Đây là vấn đề định vị trực quan. Hiện tại, có hai cách tiếp cận chính: một là biến định vị thành bài toán trắc nghiệm—trước tiên đánh số các phần tử giao diện, và mô hình chỉ cần chọn một; hai là dự đoán tọa độ thuần—để mô hình "nhìn" ảnh chụp màn hình và báo cáo tọa độ trực tiếp, giống như con người. Cách tiếp cận trắc nghiệm có hai phương pháp triển khai: chú thích hình ảnh thuần (Set-of-Mark gốc, sử dụng mô hình phân đoạn để phân đoạn các vùng ứng viên trong hình ảnh) và chỉ mục phần tử có cấu trúc (DOM/Cây Truy cập, đọc trực tiếp cấu trúc cố hữu của giao diện). Ưu điểm chung của cách tiếp cận trắc nghiệm là nó biến bài toán mở "tìm nút trong ảnh chụp màn hình và dự đoán tọa độ" thành bài toán đóng "chọn một từ các phần tử đã được chú thích"—giống như câu hỏi trắc nghiệm dễ trả lời đúng hơn câu điền khuyết trong bài kiểm tra, mô hình chỉ cần nói "nhấp [123]" thay vì "nhấp nút xanh khoảng 200 pixel bên phải góc trên bên trái màn hình."
Set-of-Mark: Phương pháp Chú thích Trực quan.
Set-of-Mark (SoM) gốc được Microsoft Research đề xuất năm 2023, ban đầu để mở khóa khả năng định vị trực quan của GPT-4V. Đây là phương pháp thuần trực quan: nó sử dụng mô hình phân đoạn hình ảnh (SAM, SEEM, v.v.) để tự động phân đoạn các vùng ứng viên trong ảnh chụp màn hình, phủ đánh dấu có số lên mỗi vùng, và mô hình thấy hình ảnh có số. Mô hình chỉ cần báo cáo số, và hệ thống chuyển đổi nó thành tọa độ trung tâm của vùng tương ứng. Toàn bộ quá trình không yêu cầu DOM hoặc bất kỳ cấu trúc giao diện bên trong nào, vì vậy nó áp dụng equally cho phần mềm desktop gốc và giao diện trò chơi—miễn là mô hình phân đoạn có thể xác định các vùng ứng viên.
Chỉ mục Phần tử Có cấu trúc: Triển khai Có cấu trúc của Ý tưởng SoM trên Web.
Khi giao diện bản thân cung cấp thông tin có cấu trúc, chú thích có thể chính xác hơn. Trước khi kết xuất, các trang web hiện đại định nghĩa cấu trúc phần tử hoàn chỉnh (cây DOM) và vai trò ngữ nghĩa xác định nút, trường nhập và các điều khiển khác. Cây truy cập cung cấp thông tin tương tự cho nhiều ứng dụng desktop. Thay vì yêu cầu mô hình phân đoạn đoán vùng nào là nút từ pixel, hệ thống có thể truy vấn trực tiếp giao diện cho các phần tử có thể nhấp. Các hệ thống Web Agent như `browser-use` làm chính xác điều này: chúng liệt kê và đánh số các phần tử tương tác từ DOM. Đây là triển khai có cấu trúc của ý tưởng SoM cho web (Hình 9-8). Quá trình có bốn bước:
- Thu được biểu diễn có cấu trúc (cây DOM) và thông tin truy cập cho trang qua giao diện gỡ lỗi của trình duyệt (CDP, Chrome DevTools Protocol)
- Tự động phát hiện phần tử nào là tương tác (nút, hộp nhập, liên kết, v.v.)
- Chú thích mỗi phần tử tương tác với ID duy nhất và vẽ hộp giới hạn trên ảnh chụp màn hình
- Đồng thời tạo danh sách văn bản mô tả phần tử tương ứng với mỗi ID
Screenshot: [Các phần tử chính trong hình ảnh được chú thích với ID như [1], [2], [3], [4]]

Elements:
[1] <input type="text" placeholder="Search" aria-label="Search" />
[2] <button id="submit-btn" aria-label="Submit form" />
[3] <input type="text" placeholder="Enter your name" value="" />
[4] <a href="/docs" aria-label="Documentation" />
Mô hình chỉ cần xuất ID, và hệ thống tự động nhấp trung tâm của phần tử tương ứng. Cách tiếp cận này không tiết kiệm token vì tất cả dữ liệu chú thích vẫn phải được gửi đến mô hình, nhưng nó cung cấp định vị chính xác, ổn định trong khi tránh bỏ sót và dương tính giả mà mô hình phân đoạn có thể gây ra.
Dự đoán Tọa độ Thuần.
Con đường thứ ba bỏ qua chú thích và yêu cầu mô hình xuất tọa độ trực tiếp. Các hệ thống như SeeClick và computer use của Claude dựa vào mô hình thị giác được đào tạo trên bộ dữ liệu lớn ảnh chụp màn hình GUI ghép nối với vị trí phần tử. Các mô hình này học ánh xạ mô tả ngôn ngữ tự nhiên (ví dụ: "nhấp nút gửi") trực tiếp đến tọa độ chính xác trên ảnh chụp màn hình, dựa vào nhận thức trực quan giống như người dùng con người.
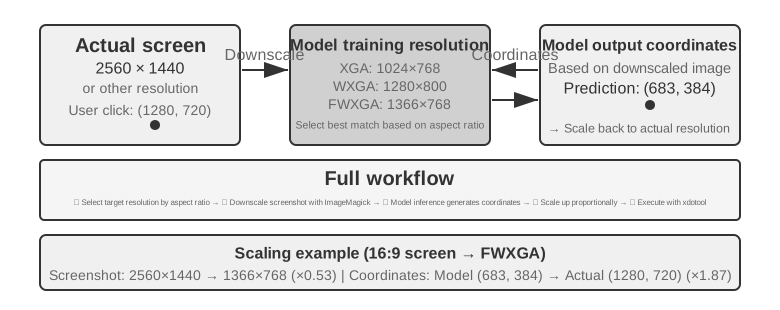
Trong sơ đồ dự đoán tọa độ, hiểu biết của mô hình về tọa độ phụ thuộc nhiều vào độ phân giải được sử dụng trong quá trình đào tạo (Hình 9-9). Claude được đào tạo sử dụng XGA (1024×768), WXGA (1280×800) và FWXGA (1366×768). Nếu độ phân giải ảnh chụp màn hình đầu vào không khớp, tọa độ dự đoán của mô hình sẽ dịch chuyển có hệ thống—giống như đo khoảng cách trên bản đồ nhỏ rồi áp dụng trực tiếp lên bản đồ lớn. Do đó, cơ chế tỷ lệ tọa độ hai chiều phải được triển khai ở tầng công cụ, và độ phân giải đích phải được chọn dựa trên tỷ lệ khung hình để tránh kéo giãn không đều làm méo hình ảnh và do đó thiên lệch đánh giá tọa độ. Ví dụ: nếu độ phân giải màn hình thực là 2560×1440 (16:9), mục tiêu phù hợp nhất trong ba tùy chọn được hỗ trợ của Claude là FWXGA (1366×768), có tỷ lệ khung hình gần nhất với 16:9. Ảnh chụp màn hình được tỷ lệ hóa theo tỷ lệ 1366×768 và đưa vào mô hình; sau khi mô hình xuất tọa độ nhấp (683, 384), chúng được ánh xạ ngược sang tọa độ thực (683×2560/1366, 384×1440/768) ≈ (1280, 720). Ngược lại, nếu hình ảnh 16:9 bị kéo cưỡng bức thành 1024×768 4:3, hình ảnh sẽ bị nén ngang, khiến tọa độ dự đoán của mô hình dịch chuyển có hệ thống.
Lựa chọn giữa ba con đường có thể tóm tắt như sau: khi thông tin có cấu trúc khả dụng, ưu tiên chỉ mục DOM/cây truy cập để định vị chính xác và ổn định nhất. Khi nó không khả dụng—trong phần mềm desktop gốc như Photoshop, giao diện Canvas/WebGL hoặc trò chơi—sử dụng chú thích trực quan (con đường SoM gốc) hoặc dự đoán tọa độ. Chú thích trực quan biến định vị thành bài toán trắc nghiệm, thân thiện hơn với mô hình đa năng không có đào tạo chuyên biệt. Dự đoán tọa độ loại bỏ bước chú thích và trực tiếp hơn cho mô hình được đào tạo chuyên biệt trên định vị GUI. Cả hai cách tiếp cận vẫn gặp khó khăn với phần tử nhỏ và giao diện dày đặc.
Thí nghiệm 9-6 ★: Sử dụng browser-use để triển khai vận hành trình duyệt tự động
Sử dụng Playwright, framework tự động hóa trình duyệt, cùng với mô hình đa phương thức để triển khai vận hành trình duyệt được điều khiển bằng ngôn ngữ tự nhiên. Bật trực quan hóa SoM và lưu ảnh chụp màn hình với hộp giới hạn được chú thích trước mỗi quyết định. Giao diện mô hình không giới hạn ở OpenAI hoặc Anthropic; cuốn sách cung cấp cấu hình API cho mô hình Qwen3-VL mở và giữ lại URL gốc tương thích OpenAI chung cho các dịch vụ lưu trữ khác hoặc suy luận tự lưu trữ.
Tác vụ kiểm tra "Mở Google và tìm kiếm thời tiết San Francisco": sau khi khởi động, ảnh chụp màn hình cho thấy trang tìm kiếm Google với các phần tử tương tác được đánh số. Mô hình chọn hộp tìm kiếm, nhập "San Francisco weather today," gửi tìm kiếm, sau đó trích xuất nhiệt độ và điều kiện từ trang kết quả. Trong quá trình chấp nhận, xác minh độc lập câu trả lời và quỹ đạo và ghi lại số bước thực tế và thời gian trôi qua. "5 bước và khoảng 20 giây" chỉ có thể là quan sát từ một lần chạy cụ thể, không phải kết quả cố định được nêu mà không có biên nhận thực thi.
Lần chạy mô hình mở chính thức được giữ lại của cuốn sách đã sử dụng `qwen/qwen3-vl-32b-instruct` trên OpenRouter. Khi mô hình gặp CAPTCHA trên Google Search ở bước 4, nó không tuyên bố thành công; nó chuyển sang weather.com và, ở bước 16, đọc 64°F, Sunny, feels like 62°F, high 74°F và low 55°F từ trang Today của San Francisco. Tất cả 16 trong 16 phản hồi API báo cáo mô hình Qwen3-VL được yêu cầu, và 15 ảnh chụp màn hình bước hợp lệ cộng với quỹ đạo hành động chỉ đọc đã vượt qua chấp nhận xác định độc lập. Kết quả này chứng minh đường dẫn API mô hình mở chạy thành công; nó không có nghĩa là nhánh công cụ `computer` gốc của Anthropic đã được tái tạo.
Agent Computer Use có thể Xem Hoạt hình và Nghe Âm thanh
Cho đến nay, nhận thức Computer Use dựa trên một giả định ẩn: màn hình là tĩnh—chụp ảnh màn hình, suy luận bước tiếp theo, nhấp và chụp ảnh màn hình tiếp theo. Màn hình thực phát video, thông báo nhấp nháy biến mất trong vài giây và phát âm thanh từ cuộc họp. Agent mở mắt chỉ một lần mỗi 3–5 giây và hoàn toàn không có tai thì mù và điếc với mọi thứ xảy ra giữa hai khung. Xem ghi hình màn hình, tham gia cuộc họp, theo dõi nhắc giọng nói, bắt hộp thoại trước khi nó biến mất—toàn bộ loại công việc máy tính hàng ngày này thực tế nằm ngoài tầm với của Agent Computer Use ngày nay.
Điều thực sự cần được thiết kế lại ở đây không phải là "giao diện hành động," mà là "giao diện quan sát"[^ch9-9]. Ý tưởng cốt lõi là tách quan sát (liên tục, thích ứng, đa phương thức) khỏi hành động (rời rạc), tạo lớp trung gian nhận thức nằm giữa môi trường và bất kỳ mô hình Computer Use có sẵn nào mà không yêu cầu đào tạo lại. Chúng ta có thể gọi đây là Giao diện Quan sát Agent–Computer (AOI). Nó có ba thành phần "cổng": Đầu tiên, bắt khung chính giữa các khung—sử dụng cổng pixel rất rẻ để bỏ qua các khung gần như không thay đổi, sau đó sử dụng mô hình nhỏ để xác định liệu thay đổi có ý nghĩa đã xảy ra, chỉ bắt khung khi có thay đổi, dẫn đến chi phí gần bằng không cho màn hình tĩnh; Thứ hai, phiên âm giọng nói cổng khối lượng—chỉ gọi nhận dạng giọng nói khi có âm thanh, lần đầu tiên cho Agent "tai"; Thứ ba, và quan trọng nhất, chuyển đổi quan sát thành mô tả văn bản liên tục—để mô hình mô tả khung đã bắt trong một câu (ví dụ: "Popup vừa nói ngày phát hành đã được đổi thành 28 tháng 4"), và ngay cả khi hình ảnh gốc sau đó bị xóa khỏi context, văn bản này vẫn ở trong bộ nhớ, mang thông tin động về phía trước ở dạng văn bản.
Phát hiện phản trực giác là điều thực sự quan trọng không phải là chọn khung mà là chuyển đổi khung đã chọn thành văn bản liên tục, vì văn bản là phương thức LLM Agent xử lý tốt nhất. Qua tám mô hình, từ mô hình 7 tỷ tham số đến hệ thống quy mô frontier, lớp trung gian này mang lại cải thiện từ +17 đến +48 phần trăm mà không cần đào tạo lại, với khoảng cách rộng nhất trên tác vụ giọng nói: với lớp nhận thức tại chỗ, Agent cuối cùng có thể hoàn thành các tác vụ giọng nói đã "nghe được nhưng không thể hành động." Tuy nhiên, nó không phải là cấu hình phù hợp tất cả—trên một số mô hình mới hơn, tiêm quá nhiều token hình ảnh chiếm chỗ suy luận và kéo hiệu suất xuống. Vì vậy các thành phần nên được chọn theo mô hình, không bật hàng loạt. Đây là bài học giống như đánh đổi Set-of-Mark so với dự đoán tọa độ: không có viên đạn bạc trong sơ đồ nhận thức; bạn cấu hình chúng để phù hợp với tính khí của mô hình.
[^ch9-9]: Đối với cơ chế đầy đủ và ablation theo mô hình của ba thành phần—khung chính cổng, phiên âm theo yêu cầu và kể khung thành văn bản liên tục—xem Bojie Li và Noah Shi. Agent-Computer Observation Interfaces Enable Dynamic Computer Use. arXiv:2606.29472, 2026.
Mô hình Thế giới cho Computer Use
Giao diện quan sát trả lời "điều gì đã xảy ra giữa các ảnh chụp màn hình?" bằng cách làm cho thay đổi động đến sớm hơn và tồn tại trong bộ nhớ. Nó không tự loại bỏ chi phí lập kế hoạch: Agent Computer Use chuẩn vẫn có thể lặp lại vòng lặp tuần tự "chụp màn hình—suy nghĩ—nhấp" và cân nhắc lại bước tiếp theo sau mỗi hành động. OSWorld-Human cho thấy độ chính xác cấp con người có thể đồng thời với nhiều bước hơn và thời gian chờ dài hơn con người cần.
Con người vận hành desktop một cách dự đoán. Họ dự đoán kết quả của hành động; khi trạng thái quan sát khớp với dự đoán đó, họ tiếp tục theo kế hoạch hiện có thay vì lập kế hoạch lại từ đầu. Chỉ khi lệch khớp mới đưa họ trở lại quan sát và lập kế hoạch. Đây là thực thi suy đoán, và mô hình thế giới làm cho nó khả dụng cho Agent. Mô hình thế giới giải quyết nửa còn lại của vấn đề: nó dự đoán desktop có thể trở thành gì sau hành động, vì vậy Agent có thể tiếp tục trực tiếp khi thực tế khớp dự đoán và lập kế hoạch lại hoặc dừng khi không khớp.
Trạng thái desktop không chỉ là pixel: nó bao gồm cửa sổ hoạt động và tiêu điểm, vị trí cuộn, nội dung nhập, trạng thái tải và quyền, và phản hồi mạng. Hành động bao gồm nhấp, gõ, cuộn, kéo và chờ. Mô hình thế giới hữu ích mã hóa trạng thái hiện tại, dự đoán thay đổi trạng thái cho các hành động ứng viên, và chuyển dự đoán đó cho bộ lập kế hoạch. Nó không cần kết xuất ảnh chụp màn hình thực tế trong tương lai; khác biệt trạng thái liên quan đến tác vụ đủ để xếp hạng hành động, chuẩn bị bước tiếp theo trong khi tải, và cổng các thao tác không thể đảo ngược.
Photon-1 của Induction Labs là một ví dụ gần đây. Nó nén khung thành token tiềm ẩn rời rạc và dự đoán tự hồi quy biểu diễn trạng thái tiếp theo sau hành động. Bộ tạo hình ảnh đính kèm trực quan hóa trạng thái tiềm ẩn nhưng không bắt buộc cho suy luận. Kết quả nên được coi là sidecar dự đoán, không phải thay thế cho ảnh chụp màn hình tươi hoặc kiểm tra trạng thái có cấu trúc trong môi trường thực.
Di động: Rào cản Hệ sinh thái Khó hơn Công nghệ
Computer Use cũng đang mở rộng sang thiết bị di động. Hệ thống di động và desktop khác nhau về mặt kỹ thuật: thay vì dựa vào tọa độ chuột và đầu vào bàn phím, không gian hành động di động thường sử dụng API dịch vụ truy cập của hệ thống (ví dụ: `AccessibilityService` của Android) để đọc phần tử giao diện và phát nhấp hoặc nhập văn bản. Tương tác cũng chuyển từ con trỏ chuột sang cử chỉ chạm, thay đổi ý nghĩa của tọa độ. Cùng vị trí `(x, y)` có thể chỉ ra chạm, chạm giữ hoặc điểm bắt đầu vuốt, vì vậy hành động cũng phải chỉ định loại cử chỉ. Các benchmark di động như AndroidWorld, được giới thiệu trong Chương 6, đánh giá khả năng hoàn thành tác vụ của Agent trong các ứng dụng thực trong không gian hành động này.
Tuy nhiên, điều thực sự cản trở Computer Use di động thường không phải là những khác biệt kỹ thuật này, mà là rào cản hệ sinh thái. Một số nhà sản xuất điện thoại đã cố gắng tích hợp trợ lý AI vào điện thoại tiêu dùng để trợ lý có thể tự động vận hành các ứng dụng hàng ngày như WeChat, Taobao và Alipay, nhưng họ nhanh chóng gặp phải hạn chế nền tảng.
Điều này tiết lộ thách thức độc đáo cho Computer Use: rào cản hệ sinh thái. Lý do cơ bản đằng sau các hạn chế này là xung đột mô hình kinh doanh. Logic kiếm tiền cốt lõi của ứng dụng internet truyền thống là lưu lượng và sự chú ý: người dùng thấy quảng cáo khi cuộn qua nguồn cấp, được hướng dẫn bởi thuật toán đề xuất khi tìm kiếm sản phẩm, và mua hàng bốc đồng trong khi duyệt trang. Khi Agent vận hành thay mặt người dùng, chuỗi kiếm tiền đó bị bỏ qua hoàn toàn: AI bỏ qua quảng cáo, không mua bốc đồng, đi thẳng đến mục tiêu, hoàn thành tác vụ và rời đi. Đối với các nền tảng sống nhờ quảng cáo và lưu lượng, mỗi thao tác Agent xói mòn nền tảng của mô hình kinh doanh.
Điều này có nghĩa là Computer Use đối mặt không chỉ với biện pháp đối phó kỹ thuật như CAPTCHA, mà còn với xung đột lợi ích cấu trúc. Xung đột này sẽ khó giải quyết trong ngắn hạn và đặt ra trở ngại lớn hơn cho việc áp dụng tiêu dùng so với các vấn đề thuần kỹ thuật.
Hiệu suất Thời gian thực: Thách thức Cốt lõi Chưa được Giải quyết
OSWorld, phương pháp đánh giá được mô tả trong Chương 6, là benchmark được sử dụng rộng rãi cho Computer Use kiểm tra khả năng hoàn thành tác vụ liên ứng dụng của Agent trong môi trường Ubuntu/Windows/macOS thực. Các mô hình đa năng đầu tiên chỉ đạt khoảng 20% tỷ lệ thành công trên benchmark này. Các mô hình chuyên biệt tiếp theo và mô hình đa năng mạnh hơn liên tục đẩy tỷ lệ thành công cao hơn, dần đạt gần hiệu suất cấp con người vào thời điểm viết sách. Tuy nhiên, tỷ lệ thành công còn xa đích đến—nút thắt thực sự đã chuyển từ "nó có thể làm đúng không?" sang "nó có thể làm nhanh không?"
Nghiên cứu hiệu quả OSWorld-Human đưa ra phát hiện tỉnh táo: ngay cả khi tác vụ cuối cùng thành công, Agent cần nhiều bước hơn đáng kể so với con người, và độ trễ suy luận mỗi bước tiếp tục tăng khi tác vụ tiến triển—context càng dài, mô hình quyết định càng chậm, vì vậy các bước sau thường mất thời gian lâu hơn nhiều so với các bước trước. Điều chỉnh định dạng tài liệu mất vài chục giây ở người có thể mất vài phút ở Agent. Độ chính xác cấp con người không giống như khả năng sử dụng thực tế; hiệu quả là nút thắt thực sự.
Nguyên nhân gốc phản ánh kịch bản giọng nói: trong vòng lặp tuần tự "chụp màn hình—suy nghĩ—nhấp," ngay cả khi mọi giai đoạn được tối ưu hóa hết mức, tích lũy từng bước của độ trễ vẫn không thể chấp nhận được. Vấn đề sâu hơn là Computer Use ngày nay hoàn toàn không thể suy nghĩ trước. Nếu Agent có thể dự đoán bước tiếp theo trong khi thực hiện bước hiện tại—tính toán nơi nhấp tiếp theo trong khi trang vẫn đang tải—nó có thể chồng suy nghĩ lên thực thi và cắt giảm tổng độ trễ đáng kể (cùng nhu cầu như suy nghĩ-trong-khi-nói trước đó trong chương này và Agent "suy nghĩ liên tục" bất đồng bộ của Chương 4, được trình bày lại ở đây như suy nghĩ-trong-khi-vận hành).
Không giống như lĩnh vực giọng nói, hiện tại không có giải pháp có hệ thống để cải thiện hiệu suất thời gian thực của chính Computer Use—làm cho vòng lặp "chụp màn hình—suy nghĩ—nhấp" nhanh hơn—và nó vẫn bị mắc kẹt trong vòng lặp rời rạc của ảnh chụp màn hình từng khung. Tuy nhiên, giải pháp thay thế đã được chứng minh hiệu quả, sử dụng tách biệt nhanh-chậm xuất hiện lặp đi lặp lại trong chương này: vì khó làm cho Agent Computer Use chậm nhanh hơn, đừng để người dùng đợi nó. Sử dụng hai mô hình đồng thời: mô hình nhanh cho giọng nói và mô hình chậm cho vận hành máy tính[^ch9-10]. Mô hình nhanh xử lý hội thoại giọng nói thời gian thực, trong khi VLM tiên tiến vận hành từng bước trong trình duyệt. Hai mô hình chỉ giao tiếp qua "hợp đồng văn bản thuần" tối thiểu: mỗi khi Agent chậm thực hiện hành động, nó cập nhật tóm tắt trạng thái đang chạy ("Đang điền biểu mẫu, vẫn cần ngày sinh của bạn"). Agent nhanh sử dụng điều này để trả lời người dùng thời gian thực và chuyển tiếp bất kỳ thông tin mới nào người dùng cung cấp bằng lời nói cho Agent chậm. Quan trọng là, Agent nhanh không bao giờ được nói "xong" cho đến khi tóm tắt trạng thái xác nhận hoàn thành. Đây là kịch bản "nói chuyện điện thoại trong khi để máy tính tự vận hành." Trong thí nghiệm, sự tách biệt này làm phản hồi giọng nói nhanh hơn khoảng 15 lần so với mô hình duy nhất vừa vận hành vừa nói (độ trễ trung bình 0,58 giây so với 8,64 giây), mà không mất tỷ lệ thành công tác vụ. Loại bỏ kênh văn bản giữa nhanh và chậm, và tỷ lệ thành công giảm xuống zero—thông tin quan trọng người dùng cung cấp bằng lời nói không thể đến được trình duyệt. Đây là ý tưởng giống như Latent Bridge trước đó và suy nghĩ-trong-khi-nói trong kịch bản giọng nói: khi một thành phần vốn chậm, để thành phần nhanh lấp đầy thời gian chờ của người dùng—"hợp đồng văn bản thuần" đó về cơ bản là khái niệm Thanh Trạng thái Agent được giới thiệu trong Chương 2. Tăng tốc vòng lặp Computer Use có thể là hướng nghiên cứu quan trọng tiếp theo, nhưng che giấu sự chậm chạp đằng sau tách biệt nhanh-chậm đã là câu trả lời khả thi.
[^ch9-10]: Thiết kế đầy đủ của tách biệt nhanh-chậm giọng nói-vận hành và "hợp đồng văn bản thuần" có thể tìm thấy trong Bojie Li và Noah Shi. Talking While Acting: Real-Time Voice for Slow Computer-Use Agents. 2026 (sắp xuất bản).
Điều khiển Robot: Từ Kiểm soát Thời gian thực đến Đào tạo và Khái quát hóa
Agent Giọng nói chiến đấu với độ trễ trong thính giác; Computer Use làm điều đó trong thị giác. Khi Agent phải điều khiển robot trong thế giới vật lý, độ trễ và đa phương thức cắn mạnh hơn—hành động có hậu quả không thể đảo ngược, và một va chạm có thể làm hỏng vật thể hoặc chính robot. Phần này trước tiên cho thấy robot thuần hóa vấn đề kiểm soát thời gian thực với kiến trúc hai tầng và chunking hành động, sau đó chuyển sang vấn đề khó hơn mà chúng đối mặt ngày nay—đào tạo và khái quát hóa: dữ liệu đến từ đâu, và mô hình chuyển giao giữa các tác vụ và nền tảng như thế nào.
Phần cứng Không phải Nút thắt; Thuật toán Mới là
Tại sao robot chưa được áp dụng rộng rãi trong cài đặt mở, đa năng? Nút thắt là phần cứng hay thuật toán? Dự án XLeRobot cung cấp một phản ví dụ thuyết phục: khi được điều khiển từ xa bởi con người qua tai nghe VR, robot hai tay bánh xe có giá dưới 1.000 USD đã có thể thực hiện nhiều tác vụ gia đình trơn tru. Robot Unitree cũng có thể xử lý các tác vụ gia đình phức tạp hơn đòi hỏi bàn tay khéo léo khi được vận hành bởi con người. Độ trễ điều khiển từ xa khoảng 100-200ms, gần với thời gian phản hồi cần thiết cho tương tác vật lý. Trên các nền tảng chi phí thấp ngày nay, độ phân giải cảm biến, độ chính xác chấp hành và tần số kiểm soát—số lần mỗi giây robot cập nhật lệnh hành động—đã đủ cho các tác vụ thực tế.
Tuyên bố này cần ranh giới rõ ràng: ví dụ điều khiển từ xa chỉ chứng minh rằng phần cứng chi phí thấp hiện có, kết hợp với trí tuệ con người, đủ cho các tác vụ thao tác gia đình chủ yếu dựa vào phản hồi hình ảnh. Nó không có nghĩa là phần cứng đủ ở mọi khía cạnh. Thiếu cảm biến xúc giác và chi phí cùng độ tin cậy của bàn tay khéo léo vẫn là hạn chế đã biết. Đối với các tác vụ phụ thuộc nhiều vào kiểm soát lực chính xác và phản hồi xúc giác, phần cứng có thể thực sự là nút thắt. Tuyên bố "phần cứng không phải nút thắt" do đó giới hạn ở loại tác vụ được thảo luận trong phần này.
Đối với các tác vụ này, khoảng cách thực sự nằm ở tầng thuật toán, được trình bày chi tiết trong hai phần con sau.
Thí nghiệm 9-7 ★: Trải nghiệm Điều khiển từ xa XLeRobot
Mục tiêu: Trên XLeRobot thực, người vận hành điều khiển từ xa robot qua cùng tác vụ: đặt cốc đỏ vào khay, đặt giấy vàng thừa vào thùng rác, sau đó quan sát lại và xác minh trạng thái desktop.
Nguyên lý: Cánh tay vài trăm đô la có thể hoàn thành tác vụ nhiều bước này dưới điều khiển từ xa của con người. Đối với tác vụ này, thân phần cứng không phải nút thắt; khoảng cách nằm ở nhận thức, lập kế hoạch, thời điểm, kiểm soát vòng kín và phục hồi.
Kiến trúc Hai tầng: Phân tách Lập kế hoạch và Kiểm soát
Robot cần đưa ra quyết định ở hai thang thời gian khác nhau để hoàn thành các tác vụ gia đình phức tạp. Tầng thứ nhất là lập kế hoạch dài hạn chậm hơn: phân tách lệnh cấp cao như "dọn bàn" thành chuỗi mục tiêu phụ (di chuyển cốc đỏ vào khay, đặt giấy vàng thừa vào thùng, sau đó xác minh trạng thái cuối cùng). Điều này đòi hỏi hiểu ngữ nghĩa môi trường, suy luận phụ thuộc tác vụ và lập kế hoạch chuỗi hành động nhiều bước—giống như cách con người suy nghĩ về "làm gì trước và làm gì tiếp" trước khi bắt đầu. Tầng thứ hai là kiểm soát VLA (mô hình Vision-Language-Action) nhanh hơn: thực hiện mỗi thao tác cụ thể ("tiếp cận cốc," "nắm lấy," "đặt vào khay"), liên tục xuất tín hiệu kiểm soát dựa trên đầu vào hình ảnh hiện tại và hướng dẫn ngôn ngữ để đảm bảo chuyển động robot mượt mà và liền mạch.
Kiến trúc hai tầng này phân tách trách nhiệm hiệu quả: lập kế hoạch dài hạn xử lý "làm gì," trong khi kiểm soát VLA xử lý "làm như thế nào." Sự kết hợp giữa ra quyết định cấp cao chậm và thực thi cấp thấp nhanh closely tương tự kiến trúc nhanh-chậm được mô tả trước đó cho giọng nói: cả hai đều gán suy luận phức tạp và phản hồi thời gian thực cho các module khác nhau. Tuy nhiên, sự phân tách kế hoạch/kiểm soát tương ứng với suy luận sâu chậm so với phản hồi thời gian thực nhanh, không phải với sự phân tách suy nghĩ/biểu đạt giữa Não Biểu đạt và Não Xây dựng Công thức của MPS trong Giải pháp 3. MPS tách suy nghĩ khỏi nói; kiến trúc robot tách lập kế hoạch toàn cầu khỏi thực thi thời gian thực. Hai kiến trúc do đó chia công việc theo các chiều khác nhau.
Ràng buộc thời gian thực chưa biến mất; chúng đã bị đẩy xuống tầng kiểm soát VLA, nơi Action Chunking giúp giảm thiểu chúng (xem phần "Kiểm soát VLA" bên dưới). Mô hình tạo chuỗi hành động tương lai ngắn trong một lần suy luận, và luồng kiểm soát phát lại chúng ở tần số cao, phân bổ độ trễ suy luận trên toàn bộ chuỗi. Điều này tạo ra đánh đổi không thể tránh giữa mượt mà và khả năng phản hồi: chunk dài hơn trải độ trễ trên nhiều hành động hơn và tạo chuyển động mượt hơn, nhưng mô hình không nhận đầu vào hình ảnh mới trong khoảng thời gian đó và do đó phản ứng chậm hơn với thay đổi đột ngột, như vật thể bị di chuyển hoặc tay chặn đường. Kiến trúc hai tầng không loại bỏ căng thẳng này; nó chỉ chuyển vị trí.
Trọng tâm chương này bây giờ chuyển: trong robot, căng thẳng thời gian thực đã được giảm bớt một phần bởi tách biệt hai tầng và action chunking, trong khi đào tạo và khái quát hóa—cách thu đủ dữ liệu biểu diễn và làm cho mô hình khái quát hóa giữa các tác vụ và nền tảng—đã trở thành mối quan tâm trung tâm. Các phần con sau mở rộng các chủ đề của môi trường mô phỏng Chương 6 và học tăng cường Chương 7 vào thế giới vật lý.
Thách thức mới này rơi chủ yếu vào tầng kiểm soát VLA. Hãy nghĩ VLA như "VLM + đầu ra hành động": VLM (Vision-Language Model—mô hình lớn hiểu cả hình ảnh và văn bản) xử lý nhận thức và suy luận, trong khi VLA phải hành động nữa—và hành động là nơi khó khăn thực sự. Ngày nay, tầng kiểm soát VLA được đào tạo chủ yếu qua học bắt chước, hay nhân bản hành vi, học ánh xạ từ quan sát đến hành động sử dụng bộ sưu tập lớn các biểu diễn con người. OpenVLA, RT-2 và π₀ đều thuộc loại này. Học tăng cường gần đây nổi lên như kỹ thuật bổ sung. Mặc dù VLA được đào tạo RL có thể hoạt động tốt trên từng tác vụ riêng lẻ, chúng thường khái quát hóa kém. Ví dụ: SimpleVLA-RL từ Chương 7 báo cáo kết quả đơn tác vụ mạnh trên LIBERO, nhưng nó được đào tạo riêng cho mỗi tác vụ thay vì như một mô hình thống nhất khái quát hóa zero-shot trên tất cả tác vụ. Mẫu một-lần-đào-tạo-mỗi-tác vụ này có nghĩa là mỗi tác vụ mới yêu cầu thu thập dữ liệu mới và đào tạo lại.
Hai phần sau đi sâu vào giải pháp kỹ thuật cụ thể cho lập kế hoạch dài hạn và kiểm soát VLA, tương ứng.
Lập kế hoạch Dài hạn: Từ VLM đến Mô hình Suy luận Thể hình Chuyên biệt
VLM đa năng đã sở hữu khả năng suy luận thể hình kha khá. Gemini Robotics-ER 1.5 của Google DeepMind được tối ưu hóa đặc biệt cho Suy luận Thể hình (hiểu vị trí, chuyển động và quan hệ nhân quả của vật thể trong thế giới vật lý). Nó đạt trung bình 62,8% trên 15 benchmark học thuật (Point-Bench, RefSpatial, RoboSpatial, BLINK, v.v.), vượt qua GPT-4o (60,6%) và Gemini 2.5 Pro (59,3%). Ưu điểm chính bao gồm: hiểu không gian nâng cao và định vị vật thể, suy luận thời gian (dự đoán kết quả hành động như "điều gì xảy ra nếu tôi đẩy cốc này"), sắp xếp tác vụ (phân tách lệnh cấp cao thành các bước nhỏ hơn), và hỗ trợ gốc cho cơ chế suy nghĩ và lệnh gọi công cụ.[^ch9-2]
[^ch9-2]: Google DeepMind, "Gemini Robotics-ER 1.5." https://deepmind.google/models/gemini-robotics/gemini-robotics-er/
Thí nghiệm 9-8 ★: Đo lường Giới hạn trên Kiểm soát Lý tưởng cho cùng Tác vụ trong Mô phỏng
Mục tiêu: Chạy cùng tác vụ dọn bàn với bộ kiểm soát lý tưởng không mắc lỗi nhận thức hoặc chọn hành động, thiết lập giới hạn trên có thể tái tạo.
Nguyên lý: Đây là tham chiếu cho trần kiểm soát, không phải bằng chứng robot thực đã được chạy.
Thí nghiệm 9-9 ★★: Kiểm soát Tự động XLeRobot thực với Gemini Robotics-ER 1.5
Mục tiêu: Thay thế người vận hành bằng Agent quan sát desktop và gọi các kỹ năng nắm, đặt và xác minh có giới hạn, trong khi giữ nguyên XLeRobot thực, tác vụ và tiêu chí thành công từ Thí nghiệm 9-7.
Nguyên lý: So sánh trực tiếp bộc lộ khoảng cách trong nhận thức, lập kế hoạch, thời điểm, kiểm soát vòng kín và phục hồi—không phải hạn chế cơ học mới của thân robot.
Kiểm soát VLA: Từ Dữ liệu Biểu diễn đến Khái quát hóa Liên thân
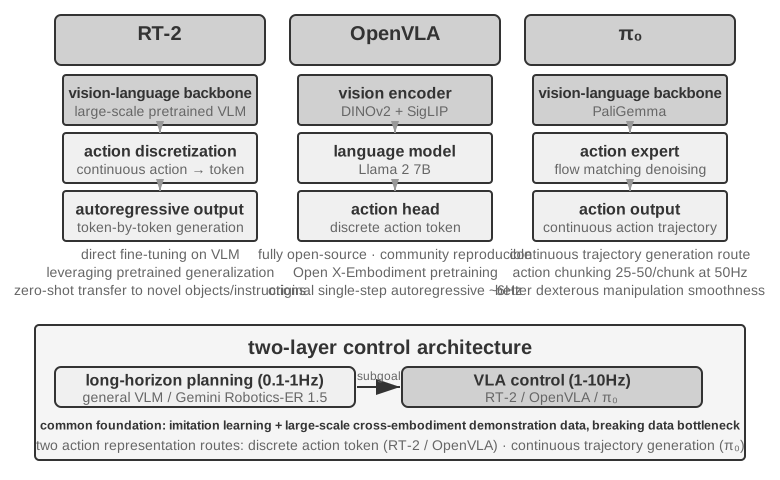
Trong tầng thực thi của kiến trúc hai tầng, ba mô hình đại diện—RT-2, OpenVLA và π₀—tập trung vào kiểm soát VLA, tức là xuất hành động robot thời gian thực dựa trên hình ảnh camera và hướng dẫn ngôn ngữ (Hình 9-10). Chúng theo hai cách tiếp cận khác nhau cho biểu diễn hành động: token hành động rời rạc và tạo quỹ đạo liên tục.
RT-2 và OpenVLA: Con đường Token Hành động Rời rạc.
RT-2 tiên phong con đường này: nó trực tiếp tinh chỉnh mô hình ngôn ngữ-vision lớn, rời rạc hóa hành động liên tục của robot thành token và xuất chúng tự hồi quy từng cái một, giống như tạo văn bản. Nó tận dụng khả năng khái quát hóa của mô hình được đào tạo trước để cải thiện chuyển giao zero-shot sang vật thể và hướng dẫn mới. OpenVLA theo sơ đồ biểu diễn hành động của RT-2, thống nhất mô hình ngôn ngữ và bộ mã hóa vision trong một kiến trúc duy nhất. Nó nhận hình ảnh và hướng dẫn văn bản làm đầu vào và xuất token hành động. Đào tạo được thực hiện trong hai giai đoạn: trước tiên, tiền đào tạo trên bộ dữ liệu liên nền tảng lớn Open X-Embodiment (bao gồm biểu diễn thao tác thế giới thực từ hơn 20 nền tảng robot) để học kiến thức thao tác chung (mẫu hành động như "nắm" và "đặt" là chung giữa các robot khác nhau); thứ hai, tinh chỉnh với dữ liệu nhỏ cho nền tảng cụ thể. Vì biểu diễn hành động tương tự, khác biệt thực tế được nhấn mạnh nằm ở tính mở và lựa chọn kỹ thuật: RT-2 và dữ liệu đào tạo của nó là nội bộ của Google, trong khi OpenVLA hoàn toàn mã nguồn mở—mô hình nền tảng mã nguồn mở (Llama 2 cộng bộ mã hóa vision) ghép nối với bộ dữ liệu công khai, làm cho ngăn xếp OpenVLA có thể tái tạo và mở rộng bởi cộng đồng rộng hơn.
Action Chunking: Kỹ thuật Bù tần số Phổ biến trong Lĩnh vực VLA.
Vì suy luận mô hình lớn chậm, VLA chạy suy luận ở tần số thấp hơn nhiều so với bộ kiểm soát robot truyền thống vận hành. Kiểm soát truyền thống thường chạy ở 50-1000Hz, trong khi suy luận VLA thường chỉ chạy khoảng 1-10Hz—khoảng cách có thể từ một đến ba bậc độ lớn. OpenVLA gốc minh họa vấn đề này: nó chỉ xuất một hành động mỗi lần suy luận, ở khoảng 6Hz sử dụng dự đoán tự hồi quy từng bước, và chuyển động giật là một trong những thiếu sót bị chỉ trích nhiều nhất. Action Chunking là kỹ thuật phổ biến để bắc cầu khoảng cách này. Được đề xuất lần đầu bởi ACT (Zhao và cộng sự, 2023) và sau đó được π₀, OpenVLA-OFT và những mô hình khác áp dụng, nó để mô hình tạo chuỗi hành động tương lai ngắn trong mỗi lần suy luận thay vì một hành động đơn lẻ. Trong cấu hình π₀ điển hình, ví dụ, mô hình tạo chunk 0,5-1 giây chứa 25-50 hành động ở tần số kiểm soát 50Hz. Luồng kiểm soát thực thi tuần tự các hành động đó ở tần số cao trong khi mô hình tạo lô tiếp theo bất đồng bộ trong nền. Miễn là suy luận hoàn thành trước khi lô hành động hiện tại hoàn thành thực thi, robot có thể duy trì chuyển động liên tục, mượt mà—giống như bộ đệm video ngăn phát lại bị giật bằng cách tải nội dung trước.
π₀: Con đường Tạo Quỹ đạo Liên tục.
Sự phân chia thực sự trong biểu diễn hành động không phải giữa RT-2 và OpenVLA, mà giữa token rời rạc và tạo quỹ đạo liên tục. π₀ theo con đường sau: thay vì dự đoán token hành động rời rạc từng cái một, nó sử dụng flow matching, phương pháp tạo liên tục liên quan đến mô hình khuếch tán, bắt đầu với nhiễu ngẫu nhiên và lặp đi lặp lại "khử nhiễu" thành quỹ đạo hành động liên tục mượt mà. Biểu diễn này ghép nối tự nhiên với action chunking và hoạt động tốt hơn trên các tác vụ như thao tác khéo léo đòi hỏi chuyển động chính xác, mượt mà. Theo cách tương tự, cách tiếp cận token rời rạc giống như chọn lệnh như "5 độ trái" và "3 cm tiến" từng cái một từ menu. Tạo quỹ đạo liên tục giống như nghệ sĩ phác thảo toàn bộ đường cong và sau đó tinh chỉnh từng nét.
Chuyển giao Sim2Real: Khoảng cách từ Mô phỏng đến Thực tế
Phần mô phỏng của Chương 6 đã giải thích khoảng cách sim-to-real đến từ đâu và randomization miền chống lại nó như thế nào, vì vậy chúng ta sẽ không lặp lại ở đây. Tóm gọn: mô phỏng không bao giờ có thể tái tạo hoàn hảo vật lý, hình ảnh và phần cứng thế giới thực, vì vậy đào tạo random hóa các tham số đó trong phạm vi rộng, ép chính sách học biểu diễn mạnh mẽ với các biến thể đó (Hình 9-11). Phần tiếp theo là nguyên lý đó hạ cánh trên cánh tay robot thực như thế nào.
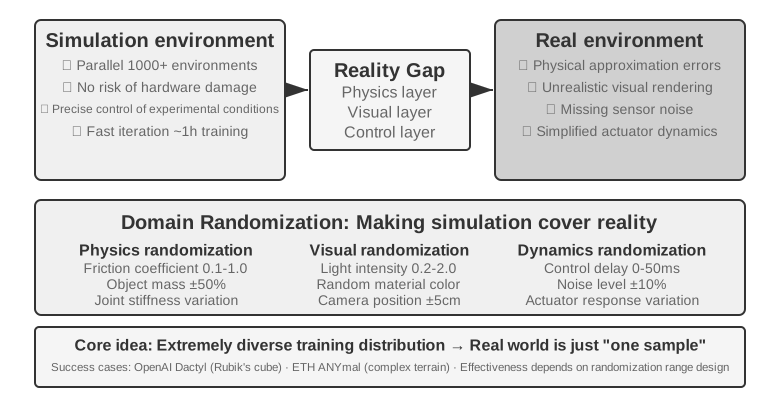
Cách tiếp cận này đã tạo ra nhiều thành công đáng chú ý. Dự án Dactyl của OpenAI đạt được xoay lại hình khối trong tay, và công trình tiếp theo sử dụng Automatic Domain Randomization (ADR) để giải Rubik's Cube bằng một tay. Robot bốn chân ANYmal của ETH Zurich đã thể hiện di chuyển mạnh mẽ trên địa hình ngoài trời khó như tuyết và sỏi.
Điều chương này bổ sung là hai bước kỹ thuật bạn không thể bỏ qua khi đưa randomization miền đến robot thực. Đầu tiên là hiệu chuẩn phạm vi randomization: phạm vi không thể đặt theo cảm tính. Quá hẹp, và nó bỏ sót biến thể thế giới thực; quá rộng, và đào tạo khó hơn và cho chính sách phụ tối ưu "xử lý mọi thứ, chẳng giỏi gì." Trong thực tế, phân phối các tham số chính (hệ số ma sát, độ trễ phản hồi động cơ) trước tiên được đo lường và hiệu chuẩn từ dữ liệu thế giới thực và lấy mẫu trong phạm vi đó; nếu chính sách được đào tạo mô phỏng giảm hiệu suất đáng kể trên robot thực, phạm vi được mở rộng từng bước cho đến khi khoảng cách sim-to-real hội tụ ở mức chấp nhận được. Thứ hai là căn chỉnh hình ảnh: hiệu chuẩn chính xác tư thế camera giữa mô phỏng và thực tế (căn chỉnh môi trường), và ngẫu nhiên ghép nối hình ảnh nền thế giới thực vào kết xuất mô phỏng (thay thế nền greenscreen) để mô phỏng trông giống nhất có thể với những gì robot thực thấy. Các thí nghiệm ghép nối dưới đây minh họa các nguyên lý này.
Thí nghiệm 9-10 ★★: So sánh Ba Vòng lặp Tự động trong Mô phỏng
Mục tiêu: Giữ nguyên tác vụ và công cụ trong khi so sánh thực thi vòng mở, kiểm tra từng bước và kiểm soát vòng kín dự đoán.
Nguyên lý: Kiểm tra từng bước cho phép phục hồi lỗi cục bộ; mô hình thế giới cho phép tiếp tục khi dự đoán khớp thực tế và lập kế lại khi lệch. Trạng thái cuối cùng luôn được xác nhận bằng quan sát mới.
Thí nghiệm 9-11 ★★★: Kiểm tra Môi trường RGB Liên cho cùng Tác vụ
Mục tiêu: Thay đổi nền, bề ngoài vật thể, ánh sáng và nhiễu hình ảnh trong khi giữ nguyên tác vụ dọn bàn, kiểm tra liệu chính sách thị giác được học trong mô phỏng có mạnh mẽ qua các môi trường RGB.
Nguyên lý: Đa dạng hình ảnh có thể cải thiện độ mạnh mẽ, nhưng nó không thay thế hiệu chuẩn robot thực hoặc vòng kiểm tra và xác minh hoàn chỉnh.
Cập nhật 2026: Thí nghiệm Dọn bàn Căn chỉnh
Các thí nghiệm robot bây giờ sử dụng một tác vụ có giới hạn xuyên suốt: đặt cốc đỏ vào khay, đặt giấy vàng thừa vào thùng rác, sau đó quan sát lại và xác minh trạng thái desktop. XLeRobot là cánh tay vài trăm đô la, và con người có thể hoàn thành tác vụ nhiều bước này qua điều khiển từ xa. Đó là bằng chứng trực tiếp rằng, đối với tác vụ này, thân phần cứng không phải nút thắt; khoảng cách tự động nằm ở nhận thức, lập kế hoạch, thời điểm, kiểm soát vòng kín và phục hồi.
Năm thí nghiệm được ghép nối có chủ đích:
- Thí nghiệm 9-7: điều khiển từ xa XLeRobot thực và thiết lập giới hạn trên phần cứng được kiểm soát bởi con người.
- Thí nghiệm 9-8: đo lường giới hạn trên kiểm soát lý tưởng cho cùng tác vụ trong mô phỏng không chấp hành.
- Thí nghiệm 9-9: thay thế con người bằng Gemini Robotics-ER 1.5 và tự động kiểm soát XLeRobot thực.
- Thí nghiệm 9-10: so sánh chiến lược vòng mở, kiểm tra từng bước và vòng kín dự đoán trong cùng mô phỏng.
- Thí nghiệm 9-11: thay đổi nền, bề ngoài vật thể, ánh sáng và nhiễu hình ảnh để kiểm tra độ mạnh mẽ liên môi trường RGB.
Ví dụ điều hướng trước đó không phải là một phần của chuỗi thí nghiệm này: cánh tay cố định nên được đánh giá trên tác vụ nó có thể thực hiện về mặt vật lý.
Bộ lập kế hoạch vẫn biểu diễn tác vụ như đồ thị phụ thuộc với điều kiện tiên quyết và kiểm tra thành công:
- "Di chuyển đến bàn và dừng cách mép 30 cm."
- "Đặt giấy vàng thừa vào thùng rác; xác minh vị trí mới."
- "Giữ cốc đỏ ổn định và đặt vào khay; xác minh nó ở bên trong."
- "Quan sát lại desktop và xác minh cả hai vị trí."
- "Dừng ở tư thế an toàn khi trạng thái cuối được xác nhận."
Đây là đồ thị phụ thuộc, không phải đoạn văn xuôi. Nếu người dùng nói "cất laptop trước," hệ thống cập nhật ưu tiên mục tiêu. Nếu cốc rơi, nó dừng ở điểm an toàn, ghi lại các sự kiện như cup.orientation=fallen và laptop.at_risk=true, vô hiệu hóa phần đuôi cũ, và lập kế hoạch lại: bảo vệ laptop, chứa tràn, quan sát lại, sau đó chỉ tiếp tục các tác vụ không bị ảnh hưởng. Các hành động đã hoàn thành không được lặp lại. Sự kiện khẩn cấp hủy chunk hiện tại; cập nhật thông thường đợi đến điểm an toàn tiếp theo.
Thực thi streaming
Lập kế hoạch và thực thi có thể chồng lên. Khi tiền tố an toàn hoàn thành, bộ lập kế hoạch stream lệnh đầy đủ cho bộ thực thi trong khi tiếp tục lập kế hoạch phần đuôi. Sự kiện lệnh phải hoàn chỉnh và kiểm toán được:
{"type":"command.commit","seq":12,"command_id":"desk-02","command":"put paper in bin","preconditions":["paper.visible","bin.reachable"],"success":"paper_count=0","cancel_at":"before_grasp"}Bộ thực thi báo cáo bắt đầu, thành công, hủy hoặc thất bại. Bộ lập kế hoạch sử dụng các quan sát này để cập nhật phụ thuộc và áp dụng backpressure khi hàng đợi cũ hoặc đầy. Streaming giảm thời gian đến hành động an toàn đầu tiên; nó không cho phép thực thi JSON một phần hoặc suy nghĩ mô hình chưa được xác minh.
Tại sao VLA hiện tại khái quát hóa kém
OpenVLA không phải theo nghĩa đen được đào tạo bằng cách chỉ cập nhật projector: công trình gốc báo cáo tinh chỉnh đầy đủ cũng như các biến thể frozen-vision, lớp cuối và LoRA. Phê bình sâu hơn vẫn hợp lệ. Một corpus tiền đào tạo văn bản/hình ảnh khổng lồ được kết nối với bộ dữ liệu robot nhỏ hơn nhiều qua đường dẫn thích ứng hẹp, và thích ứng chi phí thấp hạ nguồn thường tập trung hành vi mới vào projector, module LoRA hoặc đầu hành động. Nhân bản hành vi học "quan sát + hướng dẫn → chunk hành động," không phải hậu quả vật lý phản thực tế. Không gian hành động đặc thù thân và chunk hành động cũ hạn chế chuyển giao thêm. Nền tảng ngôn ngữ biết từ "cốc"; nó không do đó biết cách ma sát, chất lỏng, tiếp xúc và cáp điện cư xử.
Mô hình thế giới
Mô hình thế giới học chuyển đổi có thể hành động:
trạng thái + hành động ứng viên -> trạng thái tương lai dự đoán -> chọn và xác minh hành độngNó rộng hơn V-JEPA đơn thuần. Họ bao gồm mô hình dự đoán tiềm ẩn (V-JEPA 2), mô hình tạo tương tác (Genie 3 và Cosmos), Mô hình Thế giới-Hành động (GeniWorld và Robust-WAM), học hành động tiềm ẩn từ video không nhãn (LAWM-3D), và RL dựa trên mô hình (Dreamer và MuZero). Giá trị là học từ quan sát ở quy mô lớn, kiểm tra hành động phản thực tế trước khi thực thi, tách động lực học chung khỏi kiểm soát đặc thù thân, và lập kế lại khi dự đoán và thực tế lệch.
Các bản in trước 2026 gần đây khám phá tiền đề động lực học chung và đầu đặc thù thân (DyPES-VLA), biểu diễn hình ảnh-hành động cho thao tác vòng kín OOD (GeniWorld), hành động tiềm ẩn 3D-aware từ video con người (LAWM-3D), căn chỉnh tầm nhìn ngữ nghĩa (Robust-WAM), và triển khai thời gian thực bất đồng bộ. Đây là kết quả nghiên cứu đầy hứa hẹn, không phải khái quát hóa đã giải quyết.
Tóm tắt Chương
Trên bề mặt ba kịch bản khó có thể khác hơn, nhưng cặp rào cản độ trễ và đa phương thức bao trùm tất cả. Agent Giọng nói đã tiến hóa từ pipeline tuần tự sang end-to-end và hệ thống full-duplex, và từ suy nghĩ nhanh và chậm riêng biệt sang suy nghĩ trong khi nói. Computer Use bây giờ đạt gần độ chính xác con người trên benchmark như OSWorld, nhưng nó cần nhiều bước hơn con người, và mỗi bước mất thời gian lâu hơn khi tác vụ tiến triển—khoảng cách hiệu quả chưa có giải pháp có hệ thống. Đối với robot thực hiện tác vụ thao tác được hướng dẫn bằng hình ảnh, nút thắt đã chuyển từ phần cứng sang khả năng tầng kiểm soát VLA khái quát hóa qua các tác vụ (cảm biến xúc giác và bàn tay khéo léo vẫn là hạn chế phần cứng chưa giải quyết). Chương tiếp theo chuyển sang cộng tác giữa nhiều Agent—thách thức chiều khác.
Câu hỏi Suy nghĩ
- ★★ Mô hình end-to-end cho Agent Giọng nói hợp nhất ASR-LLM-TTS thành một mô hình duy nhất, giảm độ trễ nhưng mất tính mô hình hóa. Nếu mô hình end-to-end mắc lỗi ở giai đoạn cụ thể (ví dụ: nhận dạng giọng nói), gỡ lỗi và sửa nó khó hơn nhiều so với pipeline tuần tự. Bạn sẽ thiết kế hệ thống khả năng quan sát cho Agent giọng nói end-to-end như thế nào?
- ★ Step-Audio R1 đạt "suy nghĩ trong khi nói" qua kiến trúc hai não MPS. Tuy nhiên, con người, khi "suy nghĩ trong khi nói," thường nói những điều trước khi suy nghĩ kỹ, tự sửa hoặc sử dụng từ điền. "Suy nghĩ trong khi nói" của Agent có nên mô phỏng những đặc điểm con người này không?
- ★★ SoM (Set-of-Mark) và các biến thể có cấu trúc (chỉ mục phần tử DOM) chuyển đổi định vị trực quan Computer Use từ dự đoán tọa độ mở sang chọn ID tập đóng, nhưng tất cả đều yêu cầu phát hiện và chú thích phần tử UI trước—dù qua mô hình phân đoạn hoặc DOM. Nếu giao diện chứa điều khiển không chuẩn hoặc phần tử thay đổi động, chú thích có thể không đầy đủ hoặc không chính xác. Trong trường hợp đó, chúng ta có nên dự phòng dự đoán tọa độ không?
- ★★ Nền tảng robot nghìn đô như XLeRobot làm cho thu thập dữ liệu điều khiển từ xa rẻ. Tuy nhiên, chất lượng dữ liệu điều khiển từ xa phụ thuộc nhiều vào kỹ năng người vận hành. Dữ liệu chất lượng thấp từ người vận hành không lành nghề sẽ ảnh hưởng đào tạo mô hình VLA như thế nào? Làm thế nào dữ liệu chất lượng thấp có thể được lọc tự động trong giai đoạn thu thập?
- ★★★ Chương này bao gồm ba phương thức tương tác: giọng nói, Computer Use và robot. Xu hướng chung qua các phương thức là tiến hóa từ pipeline tuần tự sang mô hình end-to-end. Nếu xu hướng này tiếp tục, tầng tương tác Agent có thể trông như thế nào trong năm năm?
- ★★★ Computer Use hiện tại vận hành trong vòng lặp rời rạc "ảnh chụp màn hình → hành động → ảnh chụp màn hình," nơi mỗi quan sát là khung tĩnh. Nhưng nhận thức con người về màn hình là liên tục—chúng ta thấy hoạt hình phát, quan sát tiến trình tải và hiểu nội dung video. Điều này có nghĩa Computer Use ngày nay không thể xử lý tác vụ đòi hỏi hiểu hình ảnh thời gian thực. Bạn sẽ thiết kế lại tầng nhận thức để hỗ trợ hiểu luồng hình ảnh liên tục như thế nào?
- ★★ Chỉ mục phần tử DOM/Cây Truy cập hoạt động tốt trên ứng dụng web chuẩn, nhưng ngày càng nhiều giao diện phần mềm (kết xuất Canvas/WebGL, điều khiển vẽ tùy chỉnh liên nền tảng) không cung cấp thông tin có cấu trúc truy cập được, dựa hoàn toàn vào chú thích hình ảnh hoặc dự đoán tọa độ. Bạn nghĩ Computer Use nên đặt cược vào cách tiếp cận thuần trực quan, hay duy trì cả đường dẫn có cấu trúc và trực quan? Chi phí và lợi ích của việc duy trì cả hai đường dẫn là gì?
- ★★ Mô hình VLA sử dụng action chunking—như đã đề cập trong văn bản, cấu hình điển hình của π₀ tạo 25-50 hành động tương lai ở 50Hz—để che giấu độ trễ suy luận trong thời gian thực thi. Tuy nhiên, nếu môi trường thay đổi đột ngột trong quá trình thực thi (ví dụ: vật thể bị di chuyển), chuỗi hành động được tạo trước trở nên không hợp lệ. Làm thế nào chúng ta có thể cân bằng ưu thế hiệu quả của action chunking với nhu cầu phản hồi thay đổi môi trường?
- ★★★ Cả ba kịch bản trong chương này (giọng nói, Computer Use, robot) đều đối mặt vấn đề độ trễ của vòng lặp "nhận thức-suy nghĩ-hành động" và đang tiến hóa hướng tới song song hóa suy nghĩ nhanh và chậm. Trong giọng nói, nó thể hiện như "sửa sau khi nói sai"; trong Computer Use, như "nhấp trước, nhìn sau"; trong robot, như "bước một bước, nhìn sau." Làm thế nào chúng ta có thể đảm bảo rằng những hành động dựa trên suy nghĩ nhanh này không dẫn đến hậu quả không thể đảo ngược?