OpenAI từng đề xuất thang năng lực AI năm cấp: Cấp 1, Đối thoại; Cấp 2, Suy luận; Cấp 3, Agent; Cấp 4, Đổi mới; và Cấp 5, Tổ chức. Cộng tác đa-agent thường được trình bày như một con đường đến Cấp 5. Tuy nhiên, ở đây "Tổ chức" biểu thị cấp năng lực—AI có thể làm công việc của toàn bộ tổ chức—chứ không phải yêu cầu kiến trúc. Một Agent duy nhất đủ mạnh về nguyên tắc cũng có thể đạt được. Tuy nhiên, trong thực tế kỹ thuật ngày nay, một Agent duy nhất vẫn bị giới hạn bởi năng lực mô hình và cửa sổ context.
Làm cho nhiều Agent làm việc cùng nhau không chỉ là để các chuyên gia với chuyên môn khác nhau "bù đắp thiếu sót cho nhau." Điểm cơ bản hơn là: trí tuệ của một nhóm có thể vượt trội hơn bất kỳ cá nhân nào. Văn minh nhân loại là bằng chứng—trí tuệ của một người có giới hạn, nhưng thông qua phân công lao động, cộng tác, tranh luận và tích lũy kiến thức qua các thế hệ, xã hội loài người nói chung thể hiện trí tuệ vượt xa bất kỳ thiên tài đơn lẻ nào. Nhóm Agent có thể tạo ra cùng loại trí tuệ tập thể: ngay cả khi mỗi Agent chỉ có năng lực như chuyên gia con người, một nhóm được tổ chức tốt có thể vượt qua năng lực kết hợp của tất cả chuyên gia con người. Trong From AGI to ASI, Google DeepMind liệt kê "tập thể đa-agent quy mô lớn" là con đường quan trọng hướng tới siêu trí tuệ (ASI)—giống như trí tuệ tổng quát con người tổng hợp thành xã hội và tổ chức vượt trội cá nhân, trí tuệ tập thể của nhiều Agent cấp AGI làm việc cùng nhau có thể thể hiện năng lực nhận thức vượt xa tổng đơn giản của các thành viên[^agi-asi]. Cộng tác đa-agent, do đó, không chỉ là giải pháp kỹ thuật tạm thời cho giới hạn cửa sổ context và năng lực của mô hình đơn lẻ—nó có thể là con đường cơ bản từ "AI cấp chuyên gia" hướng tới "vượt trội toàn nhân loại."
[^agi-asi]: Về "tập thể đa-agent quy mô lớn" là con đường quan trọng từ AGI đến ASI, xem Google DeepMind, From AGI to ASi. arXiv:2606.12683, 2026.
Khung Phân loại cho Cộng tác Đa-Agent
Xây dựng hệ thống đa-agent bắt đầu với hai chiều thiết kế cốt lõi, cùng nhau quyết định kiến trúc cơ bản và triển khai.
Chiều 1: Context Chia sẻ so với Không Chia sẻ
Đây là quyết định kiến trúc cơ bản nhất, quyết định cách thông tin được truyền giữa nhiều Agent.
Context chia sẻ có nghĩa là Agent tiếp theo nhận lịch sử hội thoại hoàn chỉnh và quỹ đạo (như được định nghĩa trong Chương 1) của Agent trước đó. Khi system prompt và bộ công cụ thay đổi ở mỗi giai đoạn, hệ thống coi giai đoạn mới là Agent khác nhau vì danh tính, trách nhiệm và năng lực của nó đã thay đổi, ngay cả khi nó giữ lại tất cả bộ nhớ của tiền nhiệm. Ví dụ: sau khi nhà phân tích yêu cầu viết tài liệu yêu cầu, nhà phát triển nhận không chỉ tài liệu mà còn toàn bộ bản ghi giao tiếp giữa nhà phân tích và người dùng. Nhà phát triển đảm nhận vai trò mới trong khi giữ lại toàn bộ context trước đó. Ưu điểm là không mất thông tin; mỗi Agent có thể xem lại chi tiết từ bất kỳ giai đoạn trước. Thách thức là context có thể mở rộng nhanh chóng.
Context không chia sẻ có nghĩa là mỗi Agent duy trì context và lịch sử hội thoại độc lập và không thể trực tiếp truy cập dấu vết công việc của các Agent khác. Điều này giống như cộng tác giữa các phòng ban khác nhau: mọi người làm việc độc lập tại bàn riêng, trao đổi thông tin qua tài liệu chung và biên bản họp thay vì liên tục nhìn màn hình nhau. Mô hình này cung cấp tính mô hình hóa và cách ly tốt hơn; mỗi Agent chỉ cần tập trung vào thông tin liên quan đến trách nhiệm riêng. Hệ thống cũng dễ mở rộng và bảo trì hơn—thêm Agent mới không yêu cầu sửa đổi logic bên trong của Agent hiện có, chỉ cần định nghĩa giao diện và định dạng dữ liệu.
Vì Agent không chia sẻ context, thông tin phải được truyền qua cơ chế giao tiếp rõ ràng. Hệ thống phân tán cổ điển đã giải quyết câu hỏi này từ lâu: sách giáo khoa hệ điều hành cho chúng ta biết giao tiếp liên tiến trình (IPC) cuối cùng chỉ có hai paradigm—bộ nhớ chia sẻ (một bên ghi và bên kia đọc cùng khối lưu trữ) và truyền thông điệp (dữ liệu được gửi rõ ràng đến bên kia). Cơ chế giao tiếp giữa Agent nằm trong cùng hai paradigm này. Có ba phương pháp phổ biến:
- Tham số lệnh gọi công cụ: Đóng gói Agent hạ nguồn như công cụ, sau đó truyền dữ liệu có cấu trúc qua tham số; phù hợp với kịch bản yêu cầu dữ liệu được gõ rõ ràng, có cấu trúc rõ ràng.
- Hệ thống tệp chia sẻ: Agent trao đổi thông tin bằng cách đọc và ghi sản phẩm trung gian (tài liệu, code, v.v.) trong thư mục chia sẻ, phù hợp với kịch bản sản phẩm lớn hoặc cần lưu trữ lâu dài.
- Bus thông điệp: Trung gian chuyên dụng truyền thông điệp giữa các Agent. Agent không gọi nhau trực tiếp mà gửi thông điệp đến bus, chuyển tiếp chúng đến Agent mục tiêu.
Ánh xạ lên hai paradigm IPC, hệ thống tệp chia sẻ tương ứng với "bộ nhớ chia sẻ," trong khi tham số lệnh gọi công cụ và bus thông điệp là dạng "truyền thông điệp." Tham số công cụ được gửi đồng bộ với lệnh gọi; thông điệp trên bus được gửi bất đồng bộ qua trung gian. Mỗi paradigm có đánh đổi riêng. Go có câu nói được trích dẫn rộng rãi: "Đừng giao tiếp bằng cách chia sẻ bộ nhớ; thay vào đó, chia sẻ bộ nhớ bằng cách giao tiếp."
Bus thông điệp tự nhiên hỗ trợ giao tiếp bất đồng bộ—người gửi và người nhận không cần trực tuyến đồng thời. Điều này giống hệ thống email nội bộ công ty: khi bạn gửi email cho đồng nghiệp, bạn không cần họ ở máy tính tại thời điểm đó; email được lưu trên máy chủ và xử lý khi đồng nghiệp trực tuyến. Cách tiếp cận này đặc biệt phù hợp với kịch bản nhiều Agent làm việc song song và cần phối hợp với nhau (xem phần "Phối hợp Song song" sau trong chương này).
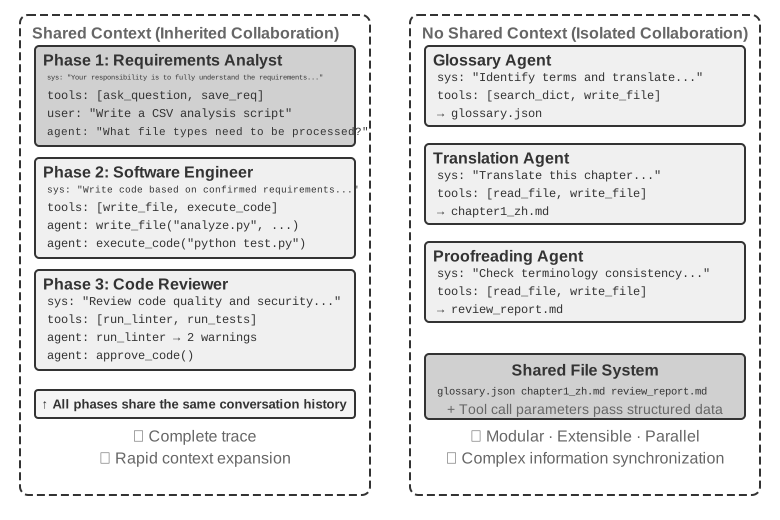
Để rõ ràng, cả hai kiến trúc đều là hệ thống đa-agent thực sự vì system prompt và bộ công cụ khác nhau ở mỗi giai đoạn, khiến chúng là các Agent khác nhau. Sự khác biệt nằm ở phương pháp phối hợp. Context chia sẻ dựa vào phối hợp ẩn: Agent tiếp theo kế thừa lịch sử context đầy đủ của Agent trước, có thể xem lại lịch sử tương tác và dấu vết công việc có thể thấy, và nhận thông tin qua chính context. Context không chia sẻ dựa vào phối hợp rõ ràng: Agent trao đổi thông tin qua tệp, thông điệp hoặc giao diện dữ liệu có cấu trúc, và mỗi Agent chỉ thấy nội dung liên quan đến công việc riêng.
Theo cách tương tự: cái trước là nhóm quanh một bàn, nơi mọi người nghe mọi thứ; cái sau là các phòng ban cộng tác qua email và tài liệu, mỗi phòng có không gian làm việc riêng.
Bạn đọc quen thuộc với hệ điều hành có thể thấy phép loại suy hữu ích: Agent context chia sẻ giống như luồng (thread), trong khi Agent context không chia sẻ giống như tiến trình (process). Luồng chia sẻ không gian địa chỉ, làm cho chuyển mạch và giao tiếp rẻ nhưng cung cấp ít cách ly; lỗi bộ nhớ trong một luồng có thể crash toàn bộ tiến trình. Mỗi tiến trình có không gian địa chỉ riêng, cung cấp cách ly mạnh hơn và song song an toàn hơn, nhưng giao tiếp phải sử dụng IPC rõ ràng. Các tiêu chí trong Bảng 10-1 theo từ các đánh đổi này.
Bảng 10-1 tóm tắt tiêu chí lựa chọn cho hai kiến trúc từ năm góc độ: số lượng tác vụ phụ, cửa sổ context, song song, cách ly thông tin và ngân sách chi phí. Nó có thể đóng vai trò danh sách kiểm tra cho lựa chọn kiến trúc ban đầu.
Bảng 10-1 Tiêu chí Lựa chọn Context Chia sẻ so với Không Chia sẻ
| Tiêu chí Lựa chọn | Context Chia sẻ | Context Không Chia sẻ |
|---|---|---|
| Số lượng tác vụ phụ | Ít (2-3 vai trò) | Nhiều (cần xử lý song song) |
| Cửa sổ context | Có thể chứa thông tin cho tất cả vai trò | Cửa sổ đơn không đủ |
| Độ song song | Chủ yếu tuần tự (các vai trò lần lượt theo cùng quỹ đạo) | Có thể mở rộng song song quy mô lớn (context độc lập, không chặn) |
| Cách ly thông tin | Không cần (tất cả vai trò chia sẻ thông tin) | Cần (ví dụ: kiểm tra bảo mật không nên nhận context nội bộ của Agent khác) |
| Ngân sách chi phí | Một quỹ đạo chuyển tiếp qua các giai đoạn; token tích lũy từng giai đoạn | Nhiều Agent làm việc độc lập; tổng token thường gấp nhiều lần đến một bậc độ lớn |
Quy tắc đơn giản: Nếu context tích lũy dự kiến vượt quá 50% cửa sổ (heuristic, không phải ngưỡng chính xác), đừng chia sẻ. Nếu mất thông tin bằng không là yêu cầu cứng cho đúng tác vụ, hãy chia sẻ. Hầu hết hệ thống thực tế sử dụng cách tiếp cận khác nhau ở các giai đoạn khác nhau: vài Agent đầu chia sẻ context, nhưng khi lịch sử chia sẻ trở nên quá lớn, hệ thống chuyển sang context không chia sẻ và sử dụng chuyển giao rõ ràng trong đó Agent thượng nguồn chọn những gì truyền xuống hạ nguồn.
Chiều 2: Bố cục Cộng tác
Chiều thứ hai là bố cục cộng tác: cấu trúc qua đó kiểm soát và thông tin chảy giữa các Agent. Bố cục và chia sẻ context về mặt khái niệm là riêng biệt nhưng liên quan trong thực tế. Hệ thống context chia sẻ vẫn có bố cục; ví dụ: mẫu `transfer_to_agent` trong Thí nghiệm 10-1 tạo thành chuỗi chuyển giao. Tuy nhiên, vì mỗi lần chuyển giao mang lịch sử đầy đủ, thường không cần quyết định thông tin nào cần truyền, vì vậy bố cục thường trở thành chuỗi đơn giản của chuyển đổi vai trò. Cộng tác kiểu trò chuyện nhóm là ngoại lệ được thảo luận sau trong phần phi tập trung hóa. Với context không chia sẻ, ngược lại, nhà thiết kế phải quyết định rõ ràng thông tin chảy như thế nào và ai phối hợp.
Thuật ngữ: Graph Engineering. Thuật ngữ "Graph Engineering," trở nên phổ biến vào tháng 7 năm 2026, thường đề cập trong bối cảnh Agent ngày nay đến việc thiết kế rõ ràng đồ thị thực thi: nút là Agent, chương trình thông thường hoặc quyết định con người; cạnh định nghĩa phụ thuộc tác vụ, định tuyến có điều kiện và đường dẫn lỗi; trạng thái có cấu trúc chảy giữa các nút.[^ch10-graph-engineering] "Bố cục cộng tác" được thảo luận trong chương này là tập con đa-agent của ý tưởng đó—cộng tác ngang hàng, quản lý điều phối và chuyển giao phi tập trung là các bố cục đồ thị khác nhau. Vì tên vẫn mới và dễ nhầm với đồ thị kiến thức, GraphRAG và dấu vết thực thi, cuốn sách này tiếp tục sử dụng các thuật ngữ ổn định hơn "bố cục cộng tác" và "điều phối" làm từ vựng chính.
[^ch10-graph-engineering]: Cho thảo luận sớm về tên, xem Josh C. Simmons, We Are Entering the Graph Engineering Phase, 2026. Các framework chính thống thường gọi cấu trúc kỹ thuật tương tự là workflow dựa trên đồ thị hoặc điều phối thay vì công nghệ hoàn toàn mới. Xem https://www.drjoshcsimmons.com/writing/we-are-entering-the-graph-engineering-phase, https://docs.langchain.com/oss/python/langgraph/overview, https://learn.microsoft.com/en-us/agent-framework/workflows/, và https://adk.dev/workflows/.
Nói cách khác, hai chiều tạo thành, về nguyên tắc, ma trận 2×3 (chia sẻ/không chia sẻ × ba bố cục)—nhưng trong hàng context chia sẻ, bố cục chủ yếu suy thoái thành chuỗi chuyển đổi vai trò với ít điều để quyết định (dạng được thảo luận sau trong "Chuyển đổi Vai trò Đa giai đoạn"). Chương này do đó chỉ trình bày chi tiết ba ô không chia sẻ. Đây là ba bố cục điển hình dưới context không chia sẻ, theo thứ tự phức tạp tăng dần:
- Mẫu Cộng tác Ngang hàng: Một số nhỏ Agent (thường 2-3) tương tác ngang hàng, tạo thành vòng lặp cải thiện lặp đi lặp lại—giống như viết bài báo khi một người soạn và người khác chú thích và sửa, chất lượng sau nhiều vòng vượt xa những gì một người có thể đạt được một mình.
- Mẫu Quản lý (Mẫu Điều phối): Agent Quản lý tập trung chịu trách nhiệm lập kế hoạch và lên lịch tác vụ, trong khi nhiều sub-agent mỗi Agent xử lý các tác vụ phụ cụ thể—giống như quản lý dự án dẫn đầu nhiều kỹ sư chuyên biệt trong dự án.
- Mẫu Phi tập trung: Không có bộ điều khiển trung tâm thời gian chạy; Agent giao tiếp với nhau như con người để cộng tác trên tác vụ.
Thiết kế chi tiết và kịch bản áp dụng cho mỗi mẫu sẽ được thảo luận trong các phần con chuyên dụng sau.
Khi nào Đa-Agent Thực sự Tốt hơn Agent Đơn lẻ?
Trước khi đi sâu vào kiến trúc cộng tác cụ thể, hãy trả lời câu hỏi cơ bản hơn: Khi nào thực sự cần nhiều Agent, và khi nào một là đủ? Câu trả lời sẽ đóng vai trò tham chiếu cho mọi cách tiếp cận kỹ thuật theo sau. Một loạt nghiên cứu gần đây hội tụ về khung rõ ràng—và tiêu chí cốt lõi là một câu hỏi duy nhất: Liệu cộng tác có cung cấp thông tin mà Agent đơn lẻ không thể có được trong khi tạo câu trả lời không?
Bảng 10-2 cho thấy chế độ cộng tác nào giới thiệu thông tin mới và giúp đánh giá liệu cộng tác đa-agent có cung cấp giá trị thực chất so với Agent đơn lẻ hay không.
Bảng 10-2 So sánh Thu được Thông tin của Các Chế độ Cộng tác Đa-Agent
| Chế độ Cộng tác | Giới thiệu Thông tin Mới? | Hiệu quả |
|---|---|---|
| Tự đánh giá bởi cùng mô hình (đọc lại đầu ra của chính nó) | Không | Thường không hiệu quả hoặc thậm chí có hại |
| Các Agent khác nhau tranh luận cùng văn bản | Không | Tương đương với Agent đơn lẻ với lượng tính toán bằng nhau |
| Người đánh giá sử dụng kết quả thực thi để đánh giá code | Có (phản hồi thực thi) | Cải thiện đáng kể |
| Người đánh giá sử dụng ảnh chụp màn hình kết xuất để đánh giá code frontend/PPT | Có (phản hồi hình ảnh) | Cải thiện đáng kể |
| Người đánh giá sử dụng công cụ bên ngoài để xác minh sự kiện | Có (phản hồi công cụ) | Cải thiện đáng kể |
Bài báo RLEF 2025 (Reinforcement Learning from Execution Feedback)[^rlef-2025] phát hiện rằng đào tạo mô hình qua học tăng cường sử dụng phản hồi thực thi code cho cải thiện lặp đi lặp lại vượt trội đáng kể so với lấy mẫu độc lập mô hình nhiều lần. Chìa khóa là mỗi lần lặp giới thiệu kết quả thực thi thực (lỗi biên dịch, lỗi kiểm tra, ngoại lệ thời gian chạy)—thông tin không tồn tại khi mô hình viết code. Đối với tác vụ tạo trang web, nghiên cứu WebGen-Agent 2025[^webgen-agent-2025] báo cáo phản hồi hình ảnh đa cấp, kết hợp ảnh chụp màn hình với mô tả mô hình ngôn ngữ-vision, cải thiện benchmark của Claude 3.5 Sonnet từ 26,4% lên 51,9%, gần như gấp đôi.
[^rlef-2025]: Gehring, J., và cộng sự. RLEF: Grounding Code LLMs in Execution Feedback with Reinforcement Learning. arXiv:2410.02089, 2025.
[^webgen-agent-2025]: Lu, Z., và cộng sự. WebGen-Agent: Enhancing Interactive Website Generation with Multi-Level Feedback and Step-Level Reinforcement Learning. arXiv:2509.22644, 2025.
Khung này giúp giải quyết mâu thuẫn rõ ràng: một số nghiên cứu học thuật thấy Agent đơn lẻ là đủ, trong khi hệ thống đa-agent thường hoạt động tốt hơn trong thực hành kỹ thuật. Các nghiên cứu thường kiểm tra nhiều Agent kiểm tra và thảo luận cùng văn bản, như trong tranh luận, trong khi hệ thống kỹ thuật hiệu quả thường thêm phản hồi bên ngoài từ thực thi code, kết xuất hình ảnh hoặc công cụ. Chỉ cái sau giới thiệu thông tin mới. Gần như tất cả sử dụng hiệu quả của ba kiến trúc được thảo luận sau—cộng tác ngang hàng, điều phối và phi tập trung hóa—có thể được hiểu qua tiêu chí này.
Ngân sách Bước và Hiệu suất Agent. Câu hỏi liên quan là ngân sách bước của Agent—số lệnh gọi công cụ hoặc vòng lặp nó có thể sử dụng—ảnh hưởng hiệu suất như thế nào. Nhiều bước hơn có vẻ chắc chắn hữu ích: với 30 bước, Agent chỉ có thời gian triển khai chức năng cốt lõi, trong khi 300 bước cho phép lập kế hoạch, triển khai, kiểm tra và tinh chỉnh. Tuy nhiên, bài báo Google 2025 Budget-Aware Tool-Use Enables Effective Agent Scaling đạt kết luận phản trực giác: đơn giản cho Agent nhiều bước hơn không đảm bảo hiệu suất tốt hơn. Agent tiêu chuẩn thiếu "nhận thức ngân sách"; ngay cả với 300 bước, chúng có xu hướng tìm kiếm nông và nhanh chóng đạt bình nguyên. Để sử dụng thêm bước hiệu quả, Agent cần cơ chế thích ứng chiến lược với tài nguyên còn lại, khám phá rộng ban đầu và thu hẹp trọng tâm sau. Cách tiếp cận BAVT (Budget-Aware Value Tree Search) 2026 giới thiệu thêm đánh giá giá trị cấp bước, điều chỉnh cân bằng giữa khám phá và khai thác theo tỷ lệ ngân sách còn lại. Khi ngân sách giảm, Agent chuyển từ khám phá rộng sang điều tra sâu hơn.
Những phát hiện này có hàm ý trực tiếp cho thiết kế hệ thống đa-agent. Ví dụ: trong mẫu điều phối, Agent Quản lý không nên đơn giản phân phối tác vụ cho sub-agent và đợi kết quả. Thay vào đó, nó nên phân bổ ngân sách bước động dựa trên độ phức tạp tác vụ—tác vụ phụ đơn giản nhận ít bước hơn; tác vụ phụ phức tạp nhận nhiều bước. Nó cũng nên hướng dẫn sub-agent sử dụng ngân sách này một cách khôn ngoan (lập kế hoạch trước, sau đó triển khai, kiểm tra, cải thiện), thay vì lao thẳng vào.
Một cân nhắc nữa phải đến trước bất kỳ quyết định thiết kế nào: chi phí. Khám phá song song và tinh chỉnh lặp đi lặp lại tốn tiền—Anthropic đã tiết lộ hệ thống nghiên cứu đa-agent tiêu thụ khoảng 15 lần token so với cuộc trò chuyện bình thường, và việc sử dụng token đơn giải thích khoảng 80% khác biệt hiệu suất. Lợi ích từ hệ thống đa-agent do đó phải đủ lớn để biện minh cho chi phí có thể gấp nhiều lần, hoặc thậm chí một bậc độ lớn, cao hơn; nếu không, Agent đơn lẻ được điều chỉnh tốt thường là món hời tốt hơn.
Cộng tác Đa-Agent với Context Chia sẻ
Trong cộng tác đa-agent với context chia sẻ, mỗi giai đoạn là Agent độc lập (với system prompt và bộ công cụ riêng), nhưng nó kế thừa quỹ đạo đầy đủ của Agent trước đó—giống như đồng nghiệp nhận ca có thể lướt qua mọi nhật ký công việc tiền nhiệm để lại. Ưu điểm cốt lõi của cộng tác dựa trên kế thừa này là không mất thông tin: mỗi Agent có thể xem lại chi tiết từ bất kỳ giai đoạn trước. Thách thức là giữ Agent hiện tại tập trung vào trách nhiệm riêng thay vì bị phân tâm bởi lịch sử kế thừa đồ sộ.
Trong tác vụ phức tạp, vai trò và trách nhiệm của Agent có thể thay đổi đáng kể qua các giai đoạn. Nếu một system prompt tĩnh được sử dụng xuyên suốt, nó sẽ quá chung hoặc trở thành bộ sưu tập hướng dẫn cồng kềnh. Chuyển đổi vai trò đa giai đoạn thay đổi system prompt và bộ công cụ theo giai đoạn hiện tại, cho phép Agent làm việc trong vai trò phù hợp nhất.
Lựa chọn kiến trúc quan trọng là liệu hướng dẫn vai trò được mang bởi system prompt thay thế hay bởi Skill được tải. Cái trước có thể ép buộc ranh giới công cụ cứng, nhưng thay đổi tiền tố yêu cầu mỗi lần chuyển. Cái sau giữ tiền tố tĩnh ổn định và thêm `SKILL.md` vào quỹ đạo, thường thân thiện hơn với bộ nhớ đệm KV/prompt; Skill vẫn là hướng dẫn hành vi, vì vậy công cụ nhạy cảm hoặc có hiệu ứng phụ vẫn yêu cầu cổng chính sách Harness được thực thi bằng code.
| Lựa chọn | Hướng dẫn vai trò | Hiển thị công cụ | Hiệu ứng Context/KV-cache | Độ mạnh ràng buộc |
|---|---|---|---|---|
| `transfer_to_agent` | Thay thế system prompt và thường bộ công cụ | Chỉ công cụ của vai trò hiện tại | Mỗi chuyển thay đổi tiền tố yêu cầu và thường vô hiệu hóa cache từ điểm đó | Mạnh: công cụ ngoài phạm vi có thể vắng mặt khỏi schema |
| Skill | Giữ thư mục Skill trong prompt cố định và thêm `SKILL.md` theo yêu cầu | Thường danh mục đầy đủ hoặc điểm tìm kiếm ổn định | Tiền tố tĩnh giữ ổn định; văn bản Skill được thêm vào quỹ đạo | Yếu: Skill là hướng dẫn, không phải ranh giới quyền |
Thí nghiệm 10-1 ★★: Chuyển đổi vai trò context chia sẻ—system prompt so với Skill
Cả hai đường dẫn sử dụng cùng mô hình, tác vụ, công cụ, hướng dẫn vai trò và quỹ đạo chia sẻ đầy đủ. Tác vụ là tìm doanh số xe năng lượng mới 2021–2023 của Trung Quốc, tính CAGR và viết tóm tắt nhà đầu tư tiếng Trung không quá 120 ký tự.
Đường dẫn 1: chuyển đổi system prompt. Năm vai trò—`triage`, `research`, `coding`, `data_analysis` và `writing`—mỗi vai trò chỉ hiển thị công cụ chuyên dụng cộng `transfer_to_agent`. Chuyển giao lưu lịch sử, tải prompt và bộ công cụ đích, và tiếp tục thực thi.
Đường dẫn 2: Skill. System prompt và danh mục công cụ đầy đủ giữ nguyên. Mô hình gọi `load_skill(name)` và nhận cùng tài liệu vai trò như kết quả công cụ trong quỹ đạo chia sẻ. Tiền tố tĩnh giữ nguyên, nhưng quyền cứng được thực thi bởi quy tắc Harness.
Hai đường dẫn nên thực hiện cùng truy xuất, tính toán và kiểm tra độ dài. Chúng khác nhau ở vật mang hướng dẫn vai trò và ranh giới công cụ kết quả; một mình dấu vết khói không thể xác định đường dẫn nào vượt trội.
Cộng tác Đa-Agent Không có Context Chia sẻ
Trong kiến trúc không có context chia sẻ, mỗi Agent vận hành như thực thể độc lập với context, quỹ đạo và trạng thái riêng. Agent không thể trực tiếp truy cập context nội bộ của nhau; cộng tác dựa hoàn toàn vào chuyển giao dữ liệu có cấu trúc rõ ràng qua ba cơ chế giao tiếp được giới thiệu đầu chương: tham số lệnh gọi công cụ, hệ thống tệp chia sẻ và bus thông điệp.
Trước đó trong chương này, chúng ta so sánh cơ chế giao tiếp với dạng IPC và context chia sẻ so với cách ly giống như luồng so với tiến trình. Phép loại suy này có thể mở rộng thêm (Bảng 10-3):
Bảng 10-3 Tương ứng giữa Hệ thống Đa-Agent và Hệ điều hành
| Hệ điều hành | Hệ thống Đa-Agent |
|---|---|
| Chương trình (tệp thực thi) | Tiền tố tĩnh (system prompt + định nghĩa công cụ) |
| Bộ nhớ tiến trình | Quỹ đạo |
| CPU | LLM |
| Kernel | Runtime Agent |
| Lệnh gọi hệ thống | Lệnh gọi công cụ |
| fork (tạo tiến trình con) | spawn_subagent |
| kill (gửi tín hiệu) | cancel_subagent |
| ps (liệt kê tiến trình) | list_agents |
| Mã thoát và wait() | Tóm tắt có cấu trúc được trả bởi sub-agent |
| Bộ nhớ chia sẻ / truyền thông điệp | Hệ thống tệp chia sẻ / truyền thông điệp |
Sự trừu tượng này không có gì mới: trạng thái riêng, thông điệp bất đồng bộ và khả năng tạo thành viên mới là chính xác thiết lập cơ bản của mô hình Actor thập niên 1970[^actor-model]. Hệ thống đa-agent do đó có thể được xem như phiên bản dựa trên LLM của mô hình Actor, và nhiều kiến thức tích lũy từ hệ điều hành và hệ thống phân tán áp dụng trực tiếp.
[^actor-model]: Hewitt, C., Bishop, P., Steiger, R. A Universal Modular ACTOR Formalism for Artificial Intelligence. IJCAI 1973.
Cách ly kiểu tiến trình này mang lại nhiều lợi ích kỹ thuật thực tế: mỗi Agent có thể được phát triển và kiểm tra độc lập, năng lực mới có thể được thêm mà không chạm vào code hiện có, và nhiều Agent có thể thực thi đồng thời mà không tranh chấp context chia sẻ.
Tuy nhiên, không chia sẻ context cũng có chi phí. Rõ ràng nhất là vấn đề đồng bộ thông tin: làm thế nào Agent duy trì hiểu biết nhất quán về trạng thái tác vụ? Thông tin sẽ bị mất hoặc trùng lặp trong quá trình chuyển giao? Gỡ lỗi cũng trở nên khó khăn hơn—khi vấn đề phát sinh, nhật ký từ nhiều Agent phải được xem lại để ghép nối toàn bộ quá trình thực thi. Các vấn đề này làm cho thiết kế đặc tả giao diện, định dạng dữ liệu và giao thức giao tiếp cực kỳ quan trọng.
Cộng tác rõ ràng không có context chia sẻ dựa vào hai hạ tầng độc lập bố cục. Đầu tiên là hệ thống tệp chia sẻ, phương tiện bền vững qua đó Agent trao đổi sản phẩm với nhau và với người dùng, tạo thành mặt phẳng dữ liệu của cộng tác. Thứ hai là cơ chế giao tiếp và kiểm soát, hỗ trợ truyền thông điệp, truy vấn trạng thái, chấm dứt thực thi và lên lịch tài nguyên giữa các Agent, tạo thành mặt phẳng kiểm soát của cộng tác. Ba bố cục dưới đây đều được xây dựng trên hai nền tảng này.
Hệ thống Tệp từ Góc nhìn Agent
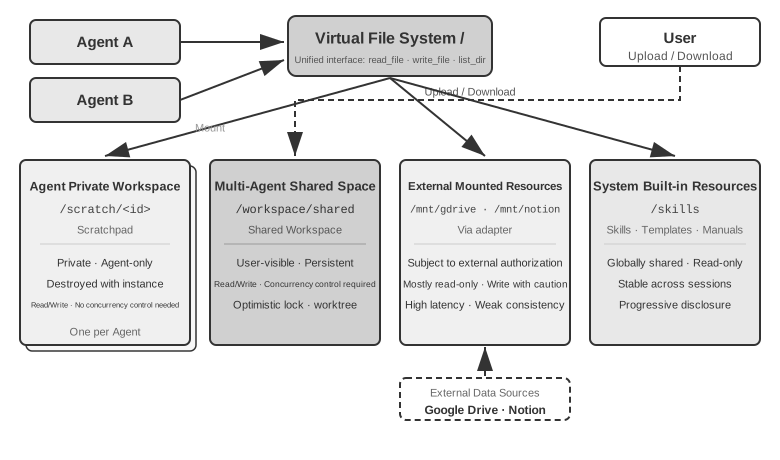
Đầu chương, "hệ thống tệp chia sẻ" được liệt kê như một trong ba cơ chế giao tiếp cho kiến trúc không có context chia sẻ. Trong hệ thống thực, hệ thống tệp Agent truy cập không phải là hệ thống lưu trữ đơn lẻ mà là hệ thống tệp ảo trong đó các hệ thống lưu trữ với nguồn, vòng đời và quyền khác nhau được gắn vào dưới một cây thư mục. Agent truy cập chúng qua giao diện thống nhất `read_file`/`write_file`/`list_dir`, trong khi các tầng dưới có thể là đĩa tạm cục bộ, lưu trữ đối tượng bền vững, API đám mây bên thứ ba hoặc gói tài nguyên hệ thống chỉ đọc. Xác định rõ ràng thành phần của cây thư mục này—tính hiển thị và vòng đời của mỗi vùng—là điều kiện tiên quyết cho thiết kế cộng tác đa-agent: phần đáng kể xung đột đồng thời và rò rỉ thông tin xuất phát từ việc trộn lẫn các vùng nên được cách ly. Cây thư mục này tương đương không gian địa chỉ của Agent, và bốn loại vùng là các đoạn bộ nhớ với quyền khác nhau: một số riêng tư và có thể ghi, một số chia sẻ giữa nhiều bên, và một số chỉ đọc. Triết lý bảo vệ của hệ điều hành áp dụng ở đây: cách ly theo mặc định và khai báo chia sẻ rõ ràng. Trong hệ thống đa-agent trưởng thành, hệ thống tệp thường bao gồm bốn loại vùng sau:
I. Không gian Làm việc Riêng của Agent (Scratchpad). Thư mục riêng dành riêng cho mỗi thể hiện Agent, lưu trữ sản phẩm trung gian, tệp tạm, bản nháp và nhật ký gỡ lỗi. Vòng đời của nó gắn liền với thể hiện và không thể thấy bởi Agent khác và người dùng. Cách ly scratchpad phục vụ hai mục đích: ngăn tệp tạm từ nhiều Agent ghi đè lên nhau, và giữ context Agent chính gọn gàng—quá trình thử-và-sai của sub-agent nằm trong workspace riêng, chỉ sản phẩm cuối cùng được nộp vào không gian chia sẻ. Đây là đối ứng cấp lưu trữ của nguyên tắc Chương 4 rằng sub-agent trả về tóm tắt có cấu trúc thay vì quỹ đạo đầy đủ.
II. Không gian Làm việc Chia sẻ Đa-Agent. Vùng cộng tác nhiều Agent có thể đọc và ghi, và hiển thị cho người dùng. Nó là phương tiện chính trao đổi sản phẩm giữa Agent trong kiến trúc không có context chia sẻ: Agent Glossary viết danh sách thuật ngữ, và Agent Translation đọc từ đó; người dùng cũng có thể tải lên tệp nguồn và tải xuống sản phẩm cuối tại đây. Vòng đời gắn liền với toàn bộ tác vụ và yêu cầu lưu trữ bền vững. Là vùng đọc/ghi đồng thời bởi nhiều bên, nó là điểm nóng cho xung đột đồng thời—cơ chế như khóa lạc quan và cách ly worktree hoạt động ở đây, như chi tiết dưới "Chế độ Thất bại Một" sau trong chương này. Chương 4 sử dụng gắn volume tại `/workspace/shared` để kết nối Agent chính, máy tính ảo và điện thoại ảo là triển khai điển hình của tầng này.
III. Tài nguyên Bên ngoài Được gắn. Nguồn thông tin bên thứ ba được người dùng ủy quyền—Google Drive, Notion, Dropbox, wiki doanh nghiệp, v.v.—được ánh xạ vào điểm gắn trong hệ thống tệp (ví dụ: `/mnt/gdrive`) qua adapter. Agent truy cập tài liệu Notion bằng cách đọc tệp; adapter dưới gọi API tương ứng. Ba đặc điểm phân biệt tầng này với lưu trữ cục bộ và phải được xử lý rõ ràng trong thiết kế: truy cập bị giới hạn bởi quyền bên ngoài (quyền của người dùng trong hệ thống nguồn quyết định khả năng hiển thị của Agent), độ trễ cao hơn và nhất quán yếu hơn (mỗi đọc liên quan chuyến đi mạng, và thay đổi bên ngoài có thể không ngay lập tức khả dụng, vì vậy dữ liệu nên được coi là nhất quán cuối cùng), và truy cập chủ yếu theo yêu cầu và chỉ đọc (ghi ngược lại nguồn bên ngoài phải được thực hiện thận trọng, vì ghi lỗi có thể ô nhiễm dữ liệu thực của người dùng). Giao diện tệp thống nhất có nghĩa là Agent không cần công cụ tùy chỉnh cho mỗi nguồn dữ liệu, nhưng nó cũng che giấu những khác biệt hiệu suất và bảo mật này. Do đó, trạng thái chỉ đọc/có thể ghi, thời gian chờ và ranh giới thông tin xác thực phải được quản lý rõ ràng ở cấp gắn.
IV. Tài nguyên Hệ thống Tích hợp. Gói tài nguyên được cài đặt trước bởi hệ thống và chia sẻ chỉ đọc với tất cả Agent. Ví dụ điển hình là Skills được giới thiệu trong Chương 2 và 4—tài liệu kiến thức và script được tổ chức như tệp, gắn tại đường dẫn như `/skills`, truy cập qua tiết lộ dần (chỉ mục trước, sau đó mở rộng theo yêu cầu). Ví dụ khác bao gồm sổ tay tham chiếu, thư viện mẫu và định nghĩa công cụ chia sẻ. Tầng này chia sẻ toàn cầu, chỉ đọc, ổn định qua phiên và có thể được đọc đồng thời bởi tất cả Agent mà không cần kiểm soát đồng thời.
Hình 10-3 minh họa cách bốn loại vùng này được gắn thống nhất dưới cây thư mục đơn: Agent truy cập toàn bộ cây qua giao diện thống nhất, người dùng tải lên và tải xuống tệp từ không gian chia sẻ, nguồn dữ liệu bên ngoài được gắn qua adapter, và tài nguyên hệ thống tích hợp được cung cấp chỉ đọc.
Bảng 10-4 so sánh bốn loại vùng này qua bốn chiều—tính hiển thị, vòng đời, quyền đọc/ghi và kiểm soát đồng thời—phục vụ như danh sách kiểm tra cho thiết kế bố cục hệ thống tệp.
Bảng 10-4 Bốn loại vùng của Hệ thống Tệp Ảo Agent
| Vùng | Hiển thị | Vòng đời | Đọc/Ghi | Kiểm soát Đồng thời |
|---|---|---|---|---|
| Workspace Riêng Agent | Chỉ Agent sở hữu | Hủy cùng thể hiện Agent | Đọc/Ghi | Không cần (riêng tư) |
| Workspace Chia sẻ Đa-Agent | Tất cả Agent cộng tác và người dùng | Bền vững cho thời gian tác vụ | Đọc/Ghi | Cần (khóa lạc quan / worktree) |
| Tài nguyên Bên ngoài Được gắn | Phụ thuộc ủy quyền bên ngoài | Xác định bởi nguồn bên ngoài | Chủ yếu chỉ đọc, ghi cần thận trọng | Quản lý bởi nguồn bên ngoài |
| Tài nguyên Hệ thống Tích hợp | Tất cả Agent | Ổn định qua phiên | Chỉ đọc | Không cần (chỉ đọc) |
Giá trị của "đường dẫn tệp như giao diện phổ quát" nằm ở việc coi đường dẫn là đơn vị trao đổi. Dù Agent trao đổi sản phẩm, Agent chính chuyển đầu vào cho sub-agent, hay tổ chức cộng tác qua A2A, chúng truyền chuỗi đường dẫn nhẹ thay vì tải nội dung tệp vào cửa sổ context (Chương 4). Điều này phù hợp với khái niệm "hệ thống tệp như trung tâm của Agent" của Chương 5, mô tả cách Agent đơn sử dụng hệ thống tệp để lưu trữ bộ nhớ và năng lực. Ở đây, cùng sự trừu tượng mở rộng sang nhiều Agent: cây thư mục ảo gắn lưu trữ riêng, chia sẻ, bên ngoài và tích hợp cung cấp nền tảng lưu trữ cho cộng tác đa-agent.
Giao tiếp và Kiểm soát giữa các Agent
Trong khi hệ thống tệp giải quyết vấn đề trao đổi sản phẩm giữa Agent, cộng tác cũng yêu cầu mặt phẳng kiểm soát. Đây chính xác là nơi các hàng vòng đời của Bảng 10-3 phát huy tác dụng: các nguyên tố công cụ được cho trong Chương 4—tạo (`spawn_subagent`), gửi thông điệp (`send_message_to_subagent`), hủy (`cancel_subagent`) và khám phá (`list_agents`)—tương ứng với fork, message, kill và ps trong thế giới tiến trình. Phần này không lặp lại định nghĩa giao diện mà tập trung vào bốn năng lực thường bị bỏ sót nhưng thiết yếu cho cộng tác đa-agent.
I. Truyền Thông điệp. Dạng đơn giản nhất là điểm-điểm: Agent A trực tiếp gọi `send_message_to_agent_b(content)`. Phù hợp với kịch bản bố cục cố định và số lượng Agent nhỏ (ví dụ: thiết lập điện thoại + máy tính hai Agent của Thí nghiệm 10-3 trong chương này). Khi số lượng Agent tăng và song song bất đồng bộ được yêu cầu, số kết nối điểm-điểm tăng theo cấp số nhân với số Agent, và cả người gửi và người nhận phải trực tuyến đồng thời. Trong trường hợp đó, bus thông điệp nên được sử dụng (chi tiết sau trong chương này dưới "Mẫu Phối hợp Song song"): Agent xuất bản thông điệp đến bus, chuyển tiếp chúng dựa trên đăng ký, vì vậy người gửi không cần biết người đăng ký. Dù điểm-điểm hay qua bus, thông điệp thường nên mang phong bì có cấu trúc: ID người gửi, mục tiêu (Agent cụ thể hoặc phát sóng), loại thông điệp (ví dụ: `task_assigned`/`status_update`/`result`/`terminate`) và payload JSON. Định dạng phong bì thống nhất đảm bảo định tuyến và phân tích đáng tin cậy bởi người nhận và làm cho chuỗi cộng tác có thể truy vết—khía cạnh quan trọng của gỡ lỗi hệ thống đa-agent.
II. Truy vấn Trạng thái. Đây là phần bị đánh giá thấp nhất của mặt phẳng kiểm soát. Khi Agent chính đã dispatch sub-agent, nó cần khả năng hiển thị vào tiến trình sub-agent; nếu không, nó không thể quyết định liệu tiếp tục chờ hay can thiệp khi sub-agent bị kẹt. Cách tiếp cận trực giác là mượn từ RPC và định nghĩa giao diện truy vấn `get_subagent_status(agent_id)` trả về "đang chạy/hoàn thành/thất bại" cộng tỷ lệ phần trăm tiến trình. Nhưng giao diện pull này hóa ra ít hữu ích hơn mong đợi: sub-agent bắt đầu thực thi ngay khi được tạo và chạy cho đến khi hoàn thành hoặc thất bại. Nó không lặp qua loạt trạng thái xếp hàng như công việc trong hệ thống hàng loạt truyền thống, giống như lập trình Unix hiếm khi cần thăm dò tiến trình khác bằng PID cho trạng thái chạy. Thăm dò cũng mang theo nan giải vốn có: thăm dò quá thường xuyên và bạn lãng phí token; thăm dò quá hiếm và bạn phản ứng muộn. Cách tự nhiên hơn để có trạng thái là quay lại hai paradigm giao tiếp được giới thiệu đầu chương.
Có trạng thái qua truyền thông điệp. Agent chính đơn giản gửi sub-agent thông điệp: "Tiến trình thế nào?" Sub-agent trả lời vào thời điểm thuận lợi. Mọi thứ đều bất đồng bộ: gửi thông điệp không chặn thực thi riêng của Agent chính, và khi—hay liệu—bên kia trả lời là vấn đề riêng, giống như quản lý hỏi cấp dưới tiến trình qua tin nhắn tức thì mà không yêu cầu họ dừng mọi thứ tại chỗ. Ngược lại, sub-agent cũng có thể chủ động gửi thông điệp báo cáo khi đạt mốc; nếu hệ thống đã có bus thông điệp, đây đơn giản là xuất bản `status_update` đến bus ("giám sát thời gian thực" của Thí nghiệm 10-4 là dạng này). Dù trạng thái được yêu cầu rõ ràng hay báo cáo chủ động, trạng thái mang trong thông điệp nên áp dụng từ vựng trạng thái máy thống nhất (đang thực thi, cần đầu vào, hoàn thành, thất bại)—giao thức A2A sau trong chương này chuẩn hóa vòng đời tác vụ thành chính xác tập trạng thái đó.
Có trạng thái qua hệ thống tệp chia sẻ. Dạng toàn diện nhất là lưu trữ quỹ đạo: khi thực thi, sub-agent tuần tự hóa mỗi sự kiện quỹ đạo thành JSON và thêm vào tệp nhật ký hệ thống tệp—thường một tệp mỗi phiên, một sự kiện mỗi dòng, tức JSONL. Quỹ đạo, được định nghĩa trong Chương 1, là chuỗi đầy đủ thông điệp người dùng, phản hồi mô hình, lệnh gọi công cụ và kết quả. Agent chính không cần giao thức báo cáo trạng thái; bằng cách đọc tệp này trực tiếp, nó có thể kiểm tra toàn bộ thực thi sub-agent: nó đang gọi công cụ gì, điều gì xảy ra trong bước gần nhất, và liệu nó có bị kẹt trong vòng lặp lặp lại thử thất bại hay không. Theo thuật ngữ tiến trình, điều này giống như đọc trực tiếp bộ nhớ tiến trình khác. Nó không chiếm context sub-agent, không phụ thuộc vào sự hợp tác của nó và cung cấp granularity quan sát tốt nhất.
Chi tiết toàn diện như vậy cũng là gánh nặng. Quỹ đạo có thể dễ dàng chạy đến hàng chục nghìn token, và Agent chính phải chưng cất sau khi đọc, tiêu tốn cả thời gian và token. Trong hầu hết kịch bản, tệp tiến trình thỏa thuận thực tế hơn: khi bắt đầu sub-agent, Agent chính hướng dẫn nó cập nhật `progress.md` khi hoàn thành mỗi mục. Agent chính có thể đọc tệp nhẹ này bất cứ lúc nào để đánh giá tiến trình. Điều này giống hai tiến trình dành một khối nhỏ bộ nhớ chia sẻ với định dạng thỏa thuận, hiển thị tiến trình chưng cất thay vì toàn bộ trạng thái bộ nhớ.
Tệp tiến trình cũng cho phép phát hiện kẹt. Nếu thời gian sửa đổi cuối của `progress.md` hoặc tệp quỹ đạo không thay đổi quá N phút, hệ thống có thể coi sub-agent không hoạt động và kích hoạt mạng an toàn thời gian chờ (phản ánh cơ chế Heartbeat và `monitor_shell` từ Chương 4). Điều này ngăn sub-agent bị đình trệ kéo xuống toàn bộ hệ thống.
Giá trị của lưu trữ quỹ đạo vượt xa giám sát. Nhớ lại kết luận Chương 1: "context Agent = tiền tố tĩnh + quỹ đạo." Tiền tố tĩnh (system prompt và định nghĩa công cụ) được xác định bởi code, trong khi quỹ đạo ghi lại trạng thái hội thoại có thể thấy của mô hình. Nếu trạng thái công cụ và phiên có thể được tái tạo từ quỹ đạo hoặc lưu trong checkpoint riêng, và sản phẩm làm việc được ghi nguyên tử vào hệ thống tệp, tải lại quỹ đạo và thêm tiền tố tĩnh có thể tiếp tục thực thi từ trạng thái xác nhận cuối cùng. Ngay cả công cụ chỉ đọc có thể mang trạng thái biến động như phiên trình duyệt hoặc con trỏ trang, vì vậy chúng cần hợp đồng phục hồi riêng.
Tuy nhiên, quỹ đạo đơn thuần không phải lúc nào cũng có thể phục hồi đầy đủ trạng thái hệ thống bên ngoài. Đối với công cụ có hiệu ứng phụ bên ngoài—thanh toán, đặt chỗ hoặc gửi tin nhắn—tiến trình có thể crash sau khi thao tác thành công nhưng trước khi kết quả được ghi lại. Trước lệnh gọi, lưu trữ ID thao tác được tạo bởi khách hàng, khóa idempotency và yêu cầu chuẩn hóa. Loại bỏ trùng lặp và tra cứu trạng thái là hợp đồng bên ngoài riêng: thử lại idempotent phải sử dụng chính xác yêu cầu và khóa cho cùng thao tác logic, và loại bỏ trùng lặp có thể được tin cậy chỉ trong cửa sổ giữ khóa được ghi lại của máy chủ. Tra cứu trạng thái có thể được hỗ trợ qua khóa idempotency hoặc ID giao dịch hoặc công việc được trả bởi hệ thống bên ngoài. Sau khi phản hồi đến, ghi ID bên ngoài và kết quả đó. Khi phục hồi, truy vấn trạng thái thực trước và phân loại kết quả là thành công, thất bại hoặc không rõ. Thử lại kết quả không rõ với cùng khóa chỉ khi yêu cầu gốc không thay đổi và hệ thống bên ngoài vẫn đảm bảo loại bỏ trùng lặp; nếu không, chuyển sang đối chiếu thủ công thay vì tự động lặp lại hành động.
Với những điều kiện đó, lưu trữ giống nhật ký ghi trước (WAL) của cơ sở dữ liệu: thêm sự kiện trước khi áp dụng và kết hợp nhật ký với checkpoint định kỳ. Hệ thống sau đó có thể khởi động lại sub-agent từ trạng thái xác nhận cuối, phát lại sự kiện để chẩn đoán lỗi, hoặc chuyển trạng thái kiểm toán được cho Agent khác (thiết kế bộ nhớ "nhật ký sự kiện + checkpoint định kỳ" của Chương 3 áp dụng cùng ý tưởng cho hệ thống bộ nhớ).
III. Chấm dứt Thực thi. Trong cộng tác song song, kịch bản phổ biến là "một thành công, phần còn lại trở nên không liên quan"—nhiều Agent tìm kiếm riêng biệt, và khi một Agent tìm thấy mục tiêu, những Agent khác nên dừng ngay lập tức (chấm dứt cascading trong Thí nghiệm 10-4 của chương này). Có hai cấp chấm dứt, và người dùng Unix sẽ nhận ra chúng là sự phân biệt giữa SIGTERM và SIGKILL. Chấm dứt nhẹ nhàng được ưu tiên: Agent chính gửi tín hiệu `terminate`, sub-agent phản hồi tại điểm an toàn trong bước hiện tại, giải phóng tài nguyên (đóng phiên trình duyệt, ghi tệp đang chờ, giải phóng khóa), gửi xác nhận (ack), và sau đó thoát. Chấm dứt cưỡng bức là dự phòng: trực tiếp chấm dứt tiến trình, chỉ sử dụng khi sub-agent không phản hồi tín hiệu nhẹ nhàng, với chi phí có thể để lại tài nguyên treo và ghi chưa hoàn thành. Hai điểm kỹ thuật cần chú ý. Đầu tiên, chấm dứt nhẹ nhàng yêu cầu sub-agent kiểm tra định kỳ tín hiệu chấm dứt trong vòng lặp (tương tự cơ chế ngắt trong Chương 4); nếu không, nó không thể nhận tín hiệu. Thứ hai, chấm dứt cascading có điều kiện tranh chấp: nhiều sub-agent có thể báo cáo thành công gần như đồng thời. Agent chính phải sử dụng khóa hoặc thiết kế idempotent để đảm bảo chỉ một thành công được chấp nhận và tín hiệu chấm dứt được phát sóng một lần. Xem thảo luận về điều kiện tranh chấp trong Thí nghiệm 10-4.
Một đầu mối lỏng lẻo còn lại: sau khi Agent chính chấm dứt, điều gì xảy ra với sub-agent vẫn đang chạy? Cách tiếp cận kỹ thuật sạch nhất mượn từ context của Go—chấm dứt cascading xuống mối quan hệ tạo: hủy một Agent và tất cả sub-agent nó tạo ra bị hủy cùng, ngăn Agent con mồ côi bị bỏ lại. "Sub-agent kiểm tra tín hiệu chấm dứt tại điểm an toàn" ở trên tương ứng chính xác với thăm dỏ `ctx.Done()` trong Go. Ngược lại, nếu bạn thực sự cần Agent nền chạy dài tách khỏi Agent chính (giống `nohup` của Unix), để nó bắt đầu từ cây vòng đời mới (tương ứng `context.Background()`), khai báo rõ ràng nó không chấm dứt cùng cha.
IV. Quản lý và Lên lịch Tài nguyên. Nửa còn lại công việc của hệ điều hành là phân bổ tài nguyên khan hiếm. Trong thế giới tiến trình tài nguyên khan hiếm là thời gian CPU và bộ nhớ; trong thế giới Agent chúng là token, tiền và ngân sách đồng thời—mỗi bước sub-agent thực hiện tiêu tốn cả ba. Trách nhiệm này thường thuộc về Manager hoặc runtime: đặt ngân sách bước hoặc token khi bắt đầu sub-agent, và dừng khi vượt quá; giao tác vụ khó cho mô hình mạnh và tác vụ cơ học cho mô hình chi phí thấp; giới hạn đồng thời để hàng chục Agent không cạn kiệt hạn ngạch API cùng lúc; và khi tác vụ khẩn cấp hơn đến, ngắt sub-agent đang thực thi—đây là chiếm quyền trước. Thực hành trong lĩnh vực này kém trưởng thành hơn nhiều so với lên lịch CPU, nhưng nó quyết định trần chi phí của hệ thống đa-agent và nên được xem xét ở giai đoạn thiết kế kiến trúc.
Trao đổi sản phẩm (mặt phẳng dữ liệu) và truyền thông điệp, truy vấn trạng thái, chấm dứt thực thi và lên lịch tài nguyên (mặt phẳng kiểm soát) cùng hỗ trợ hệ thống đa-agent không chia sẻ context. Ba bố cục cộng tác dưới đây là, về cơ bản, các lựa chọn khác nhau—được xây dựng trên hai mặt phẳng này—về ai giữ kiểm soát và thông tin chảy như thế nào.
Dựa trên mối quan hệ cộng tác và đặc điểm dòng kiểm soát giữa Agent, cộng tác không có context chia sẻ có thể chia thành ba kiến trúc chính—mẫu cộng tác ngang hàng, mẫu quản lý và mẫu phi tập trung—mỗi loại phù hợp với loại tác vụ khác nhau.
Mẫu Cộng tác Ngang hàng: Kiểm tra Chéo và Cải thiện Lặp
Cộng tác ngang hàng thường bao gồm 2-3 Agent ngang hàng đưa phản hồi cho nhau qua nhiều vòng lặp. Giá trị cốt lõi là sự đa dạng nhận thức: các Agent khác nhau xem xét cùng vấn đề từ các góc độ khác nhau, cân bằng đổi mới với độ mạnh mẽ để tạo kết quả tốt hơn bất kỳ Agent đơn lẻ nào có thể.
So với mẫu quản lý và phi tập trung, cộng tác ngang hàng đơn giản hơn nhiều để triển khai—định nghĩa vai trò hai Agent, cơ chế giao tiếp và điều kiện chấm dứt lặp, và bạn có hệ thống đang chạy. Nó là lựa chọn lý tưởng để xác nhận nhanh ý tưởng và xây dựng nguyên mẫu.
Một trong những sử dụng phổ biến nhất của cộng tác ngang hàng là chống lại thất bại thường gặp trong thực hành Agent: chấm dứt sớm—dừng với công việc làm một nửa. Nó có ba dạng điển hình; các ví dụ dưới đây đến từ Coding Agent và Pine AI, Agent được giới thiệu trong Lời nói đầu gọi điện thoại thay mặt người dùng để giải quyết với thương gia và nhà cung cấp dịch vụ. Đầu tiên là giả hoàn thành lười: làm một phần công việc và tuyên bố tất cả đã xong—Coding Agent viết code, không bao giờ chạy kiểm tra hoặc thử triển khai, và báo cáo "tác vụ hoàn thành"; người dùng giao Pine AI hai việc vặt, nó hoàn thành việc đầu, quên việc thứ hai, và vui vẻ báo cáo "tất cả đã lo xong." Thứ hai là từ bỏ sớm: tuyên bố toàn bộ công việc bất khả thi sau một đường dẫn bị chặn—Pine AI có thể liên lạc thương gia qua điện thoại, biểu mẫu web hoặc email, nhưng sau một lần gọi bị từ chối, nó nói người dùng "việc này không thể làm," khi chuyển kênh và thử lại rất có thể đã thành công. Thứ ba là thành công giả: Agent tin công việc đã xong, nhưng vòng lặp chưa bao giờ thực sự đóng—bên kia đồng ý hoàn tiền bằng lời nói qua điện thoại, nhưng người dùng vẫn phải xác nhận bước trong ứng dụng di động; Agent báo cáo "tất cả đã xong," người dùng không bao giờ biết có hành động tiếp theo, và tiền hoàn không bao giờ đến. Cả ba dạng đều chỉ ra cùng nguyên nhân gốc: cho đến khi được xác minh, "xong" chỉ là tuyên bố của mô hình, không phải bằng chứng.
Biến tuyên bố thành bằng chứng chính xác là công việc của Loop Engineering, giai đoạn cuối của vòng cung tiến hóa Chương 1: thiết kế vòng lặp giữ Agent chạy—phát hiện công việc tiếp theo, thực thi, xác minh, ghi tiến trình—và để bộ xác minh, không phải chính mô hình, quyết định liệu thực sự an toàn để dừng. Vai trò con người thay đổi tương ứng từ "người vận hành nhắc Agent" sang "kỹ sư thiết kế vòng lặp." Thuật ngữ được đặt ra vào tháng 6 năm 2026 bởi Addy Osmani[^loop-engineering-2026]; Boris Cherny, trưởng nhóm Claude Code tại Anthropic, nói thẳng hơn: "Tôi không nhắc Claude nữa. Công việc của tôi là viết vòng lặp." Kết luận trung tâm xuất hiện từ thảo luận đó là nút thắt của vòng lặp là bộ xác minh, không phải mô hình: với xác minh không đáng tin cậy, vòng lặp nhanh hơn chỉ đánh dấu đầu ra kém là hoàn thành sớm hơn. Và như Lời nói đầu nói, thực hành trước, đặt tên sau. Từ lâu trước khi thuật ngữ trở nên phổ biến, các nhóm Agent hàng đầu—trong đó có Pine AI—đã sử dụng "vòng lặp cộng xác minh" chống chấm dứt sớm. Cách hiệu quả nhất để tổ chức xác minh đó là paradigm Đề xuất-Đánh giá bên dưới.
[^loop-engineering-2026]: Osmani, Addy. "Loop Engineering: Designing Loops that Prompt Coding Agents", 2026. https://addyosmani.com/blog/loop-engineering/
Khung cụ thể: LoopX. LoopX đưa vòng lặp ra khỏi prompt và lịch sử trò chuyện của mô hình và đặt nó trong mặt phẳng kiểm soát bền vững, trung lập runtime agent: mục tiêu và ranh giới giải thích công việc tồn tại vì sao; cổng và todo quyết định điều gì có thể xảy ra bây giờ; bằng chứng và hạn ngạch quyết định liệu nó có thể tiếp tục; và chuyển giao cho phép lượt sau hoặc Agent khác tiếp tục. Nó nén một lần thực thi được quản lý thành giao thức rõ ràng:
LoopX quyết định → Agent thực thi → bộ xác minh độc lập chứng minh → LoopX commitAgent vẫn suy luận, sử dụng công cụ và tạo sản phẩm ứng viên. LoopX không thay thế runtime Agent; nó quản lý tính liên tục qua các lượt. Chỉ kết quả được xác minh độc lập có thể cập nhật tiến trình bền vững và tiêu tốn hạn ngạch. Xác nhận thất bại dẫn đến sửa chữa hoặc lập kế lại, trong khi cổng con người, trạng thái chờ và giới hạn ngân sách dừng vòng lặp trước thực thi. Ranh giới này biến nguyên tắc Loop Engineering thành bất biến hệ thống có thể kiểm tra: mô hình có thể đề xuất "xong," nhưng nó không thể tự phê duyệt "xong" của mình. LoopX v0.4.0 vẫn đánh dấu đường dẫn lượt được quản lý là thử nghiệm, vì vậy nó được sử dụng ở đây như khung cụ thể cho "vòng lặp + xác minh + điều kiện dừng," không phải bằng chứng nâng cấp chất lượng tác vụ chung.[^loopx-framework]
[^loopx-framework]: LoopX, "The local control plane for long-running AI agent work", v0.4.0, stable commit `a893d221db0b8e028997cefc303f7ec9fa7dbe0a`. https://github.com/huangruiteng/loopx/tree/a893d221db0b8e028997cefc303f7ec9fa7dbe0a
Paradigm Đề xuất-Đánh giá.
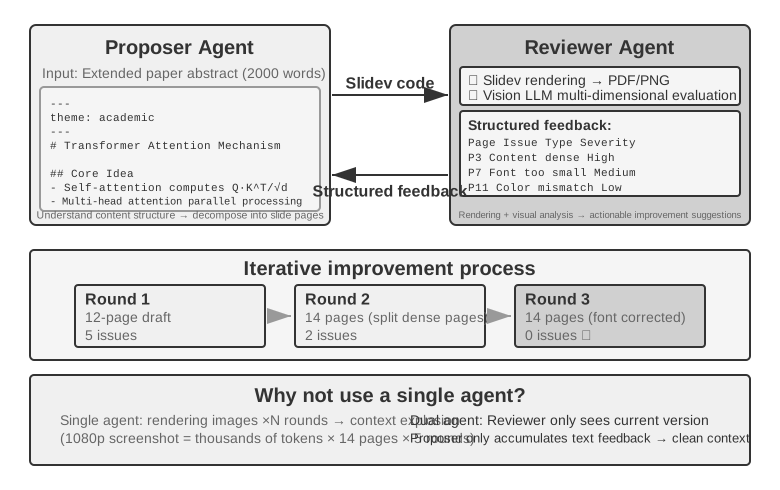
Đề xuất-Đánh giá là paradigm cộng tác ngang hàng chuẩn. Chương 5 đã đề cập nguyên tắc thiết kế và ứng dụng thực tế trong ba thí nghiệm: tạo PPT, chỉnh sửa video và trực quan hóa nhật ký. Agent Đề xuất tạo code, trong khi Agent Đánh giá kết xuất kết quả thực thi, đánh giá chất lượng sử dụng mô hình ngôn ngữ-vision và cung cấp đề xuất có cấu trúc để cải thiện. Hai Agent lặp cho đến khi kết quả đạt tiêu chuẩn yêu cầu.
Paradigm này cũng áp dụng cho kịch bản như kiểm tra bảo mật (Agent Đề xuất tạo kế hoạch hành động, Agent Đánh giá kiểm tra tuân thủ và rủi ro tiềm ẩn), kiểm duyệt nội dung (Agent Đề xuất soạn phản hồi, Agent Đánh giá kiểm tra quy tắc kinh doanh và chuẩn ngôn ngữ), và đánh giá code (Agent Đề xuất viết code, Agent Đánh giá kiểm tra bảo mật và thực hành tốt).
Tại sao Agent đơn lẻ không thể tạo và sau đó đánh giá công việc của chính nó? Đây chính xác là nơi tiêu chí từ "Khi nào Đa-Agent Thực sự Tốt hơn Agent Đơn lẻ?" trước đó áp dụng—nếu đánh giá không giới thiệu thông tin mới, nó chỉ là "yêu cầu mô hình nghĩ lại." Nghiên cứu liên quan cung cấp câu trả lời rõ ràng. Trong bài báo ICLR 2024 "Large Language Models Cannot Self-Correct Reasoning Yet," Huang và cộng sự phát hiện rằng yêu cầu GPT-4 đánh giá và sửa câu trả lời của chính nó mà không có phản hồi bên ngoài thực sự giảm độ chính xác—mô hình thay đổi câu trả lời đúng thành sai thường xuyên hơn thay đổi câu sai thành đúng.
Bài khảo sát 2024 xuất bản trên TACL, "When Can LLMs Actually Correct Their Own Mistakes?" (arXiv:2406.01297), xác nhận thêm kết luận này: trừ khi phản hồi bên ngoài đáng tin cậy được cung cấp (ví dụ: kết quả thực thi kiểm tra, đầu ra xác minh từ công cụ bên ngoài), dựa hoàn toàn vào "tự sửa" của mô hình phần lớn không hiệu quả.
Bài báo CRITIC tại ICLR 2024 cung cấp thí nghiệm so sánh trực giác. CRITIC để mô hình sử dụng công cụ bên ngoài (công cụ tìm kiếm, trình thông dịch Python) để xác minh câu trả lời của chính nó, dẫn đến cải thiện hiệu suất đáng kể. Tuy nhiên, khi người thí nghiệm loại bỏ bước xác minh công cụ và chỉ giữ đánh giá tự của mô hình, hầu hết cải thiện biến mất. Điều này cho thấy giá trị của đánh giá nằm ở giới thiệu thông tin mới không khả dụng trong quá trình tạo của mô hình—kết quả kiểm tra, ảnh chụp màn hình kết xuất, lỗi biên dịch, kết quả tìm kiếm bên ngoài.
Đây là nguyên tắc thiết kế cốt lõi của paradigm Đề xuất-Đánh giá. Trong thí nghiệm tạo PPT của Chương 5, giá trị của Agent Đánh giá không phải là "sử dụng cùng mô hình nhìn lại code," mà là kết xuất PPT và chụp ảnh màn hình—ảnh chụp màn hình chứa thông tin hình ảnh mà Agent Đề xuất không thể có được khi tạo code. Tương tự, trong kịch bản tạo code, kết quả đạt/không đạt từ thực thi kiểm tra là tín hiệu mới không tồn tại khi code được viết—giá trị độc lập của Agent Đánh giá xuất phát chính xác từ khả năng truy cập phản hồi bên ngoài này mà Agent Đề xuất không có.
Nhìn qua lăng kính Loop Engineering, các mẫu vòng lặp được phân loại bởi ngành ánh xạ lên mẫu trong cuốn sách này. Vòng lặp đóng với phê duyệt con người tương ứng với phê duyệt trước của Chương 4, trong đó con người là người đánh giá cuối cùng. Vòng lặp mở với ngân sách hoặc giới hạn vòng tương ứng với lặp PPT đa vòng của Chương 5, cho phép tối đa năm vòng. Sub-agent được điều phối tương ứng với mẫu quản lý trong phần tiếp theo. Loop Engineering do đó mô tả không phải kiến trúc mới mà khung chung—vòng lặp + xác minh + điều kiện dừng—thống nhất các mẫu cộng tác này. Paradigm Đề xuất-Đánh giá điền vai trò xác minh trong khung đó.
Mở rộng: Các mẫu cộng tác ngang hàng khác.
Tranh luận: Nhiều Agent giữ vị trí khác nhau, khám phá không gian vấn đề qua đối thoại đối kháng. Ví dụ: khi đánh giá giải pháp kỹ thuật, Agent A đóng vai "người ủng hộ," liệt kê ưu điểm và cơ hội, trong khi Agent B đóng vai "người phản đối," chỉ ra rủi ro và giới hạn. Mỗi vòng tranh luận bao gồm bác bỏ hoặc mở rộng lập luận của bên kia. Khi Agent đơn phân tích vấn đề, nó thường thiên về một góc nhìn và bỏ sót bằng chứng phản bác. Tranh luận có cấu trúc ép buộc cả hai vị trí được phát triển đầy đủ, giúp người ra quyết định đạt đánh giá cân bằng hơn.
Tuy nhiên, hiệu quả thực tế của tranh luận vẫn bị tranh cãi trong học thuật. Nghiên cứu 2026 của Tran và Kiela[^single-agent-2026] so sánh Agent đơn với năm kiến trúc đa-agent (tuần tự, tranh luận, tập hợp, vai trò song song, tác vụ phụ song song) trên tác vụ suy luận đa bước. Họ phát hiện rằng khi ngân sách token suy nghĩ được giữ hằng, Agent đơn hoạt động ngang bằng hoặc thậm chí tốt hơn hệ thống đa-agent (trừ khi sử dụng context bị suy giảm đến mức nhất định). Người nghiên cứu cung cấp giải thích dựa trên bất đẳng thức xử lý dữ liệu trong lý thuyết thông tin: nhiều Agent trong tranh luận xử lý chính xác cùng thông tin văn bản, và mỗi truyền tải tuần tự kết luận trung gian giữa Agent chỉ có thể mất thông tin, không tạo ra nó. Lợi ích của chế độ tranh luận trong một số bài báo học thuật có thể xuất phát từ nhiều Agent tiêu thụ tổng lượng tính toán nhiều hơn. Điều quan trọng là làm rõ ranh giới của lập luận này: nó nhắm vào nút thắt thông tin gây ra bởi "truyền tải tuần tự kết luận trung gian đa-agent" và không phủ nhận cách tiếp cận khác, như nhiều mẫu độc lập của cùng vấn đề theo sau bởi tổng hợp (ví dụ: tự nhất quán, bỏ phiếu đa số), hoặc khai thác bất đối xứng độ khó giữa tạo và xác minh (viết câu trả lời khó, xác minh dễ) cho phân công tạo-xác minh. Các kịch bản này hoặc giới thiệu lấy mẫu độc lập bổ sung hoặc khai thác cấu trúc bất đối xứng của chính tác vụ, và không nằm trong phạm vi bất đẳng thức xử lý dữ liệu.
[^single-agent-2026]: Tran, D., Kiela, D. Single-Agent LLMs Outperform Multi-Agent Systems on Multi-Hop Reasoning Under Equal Thinking Token Budgets. arXiv:2604.02460, 2026.
Động não: Nhiều Agent độc lập tạo ý tưởng, sau đó chia sẻ với nhau, truyền cảm hứng cho nhau. Ví dụ: trong tác vụ đổi mới sản phẩm, Agent 1 đề xuất "thêm tính năng chia sẻ xã hội," Agent 2 được truyền cảm hứng đề xuất "không chỉ chia sẻ lên mạng xã hội, mà còn tạo áp phích chia sẻ cá nhân hóa," và Agent 3 tổng hợp hai Agent đầu đề xuất "mẫu áp phích tùy chỉnh người dùng tạo thị trường mẫu." Các Agent khác nhau có "sở thích suy nghĩ" khác nhau (đạt được qua prompt hoặc mô hình khác nhau), và bằng cách kích thích nhau, chúng khám phá không gian giải pháp rộng hơn để tìm tổ hợp sáng tạo mà Agent đơn khó hình dung.
Thảo luận Bàn tròn: Nhiều Agent mỗi Agent đại diện góc nhìn của lĩnh vực chuyên môn cụ thể, cùng thảo luận vấn đề liên ngành. Ví dụ: khi đánh giá tính khả thi sản phẩm mới, Agent Kỹ sư phân tích độ khó triển khai từ góc độ kỹ thuật, Agent Sản phẩm đánh giá hấp dẫn thị trường từ góc độ trải nghiệm người dùng, và Agent Vận hành phân tích khả thi kinh doanh từ góc độ chi phí và tài nguyên. Các Agent này không đối kháng mà bổ sung, cùng nhau ghép nối bức tranh đầy đủ của vấn đề và xác định ràng buộc và cơ hội liên miền.
Mẫu Quản lý: Điều phối Tập trung
Khi tác vụ liên quan đến hơn năm tác vụ phụ, cần lên lịch động hoặc có phụ thuộc phức tạp giữa các tác vụ phụ, cộng tác ngang hàng vượt quá khả năng, và mẫu quản lý được cần. Công việc của Agent Quản lý giống quản lý dự án: hiểu toàn bộ tác vụ, chia thành tác vụ phụ có thể giao, chọn đúng Agent cho mỗi tác vụ, theo dõi tiến trình, xử lý ngoại lệ bằng cách thử lại tác vụ, thay thế Agent hoặc sửa đổi kế hoạch, và cuối cùng tích hợp đầu ra Agent thành kết quả cuối cùng.
Từ góc nhìn thiết kế hệ thống, mẫu quản lý mô hình hóa mỗi Agent chuyên biệt như công cụ mà Manager có thể gọi. Bộ công cụ của Manager bao gồm không chỉ công cụ bên ngoài truyền thống, như tìm kiếm và thao tác tệp, mà còn giao diện gọi Agent khác. Manager gọi Agent phù hợp qua lệnh gọi công cụ, truyền tham số tác vụ và context cần thiết, đợi hoàn thành và nhận kết quả. Từ góc nhìn Manager, gọi Agent về cơ bản không khác gọi công cụ thông thường: cả hai đều liên quan gửi yêu cầu và nhận phản hồi. Sự trừu tượng thống nhất này làm cho mẫu quản lý dễ mở rộng. Thêm năng lực chỉ yêu cầu phát triển Agent tương ứng và đăng ký như công cụ, mà không sửa đổi logic cốt lõi của Manager. Nó cũng tự nhiên hỗ trợ tính dị thể: Agent khác nhau có thể sử dụng mô hình, prompt, bộ công cụ và thậm chí môi trường phần cứng khác nhau.
Sự trừu tượng "Agent như công cụ cho nhau" được thiết lập trong phần "Công cụ Cộng tác" của Chương 4: thiết kế giao diện `spawn_subagent / send_message_to_subagent / cancel_subagent / list_agents` áp dụng trực tiếp cho Manager gọi sub-agent ở đây. Về những gì được truyền theo hướng "Manager → sub-agent," xem thiết kế gói chuyển giao sau trong chương (mô tả tác vụ, sự kiện đã xác nhận và ràng buộc, tham chiếu đến sản phẩm có cấu trúc). Câu hỏi tương ứng là sub-agent trả về gì theo hướng "sub-agent → Manager." Câu trả lời là tóm tắt có cấu trúc thay vì quỹ đạo đầy đủ: sub-agent nên trả về kết luận tác vụ, phát hiện chính, đường dẫn tệp sản phẩm và vấn đề gặp phải, để lại quỹ đạo thực thi đầy đủ trong nhật ký riêng. Chỉ bằng cách này context Manager mới tăng chậm và tuyến tính với số lượng tác vụ phụ, thay vì bùng nổ. Đây cũng là lý do Manager trong Thí nghiệm 10-2 dưới đây chỉ duy trì chỉ mục tệp và không lưu nội dung dịch.
Mẫu quản lý có thách thức vốn có. Manager trở thành nút thắt điểm đơn của hệ thống: nó phải hiểu bản chất mọi tác vụ phụ, chọn đúng Agent và truyền context chính xác; bất kỳ đánh giá sai nào gợn sóng qua toàn bộ luồng. Nó phải duy trì context toàn cục của toàn bộ tác vụ, có thể phồng lên khi tác vụ sâu hơn và lệnh gọi Agent tích lũy. Manager do đó yêu cầu prompt được thiết kế cẩn thận, chiến lược quản lý context hiệu quả và phân tách tác vụ granularity phù hợp.
Bài báo Plan-and-Act 2025[^plan-and-act-2025] cung cấp phân tích thực nghiệm cho điều này: trong kiến trúc Planner-Executor hai Agent, kế hoạch yếu là nút thắt quan trọng nhất của toàn bộ hệ thống. Khi chất lượng kế hoạch của Planner đủ cao, kết quả tốt có thể đạt được ngay cả với Executor tương đối đơn giản. Ngược lại, nếu phân tách tác vụ của Planner sai, tất cả công việc Executor sau được xây dựng trên tiền đề lỗi. Nghiên cứu đạt tỷ lệ thành công 54% trên benchmark WebArena-Lite, và đóng góp cốt lõi là cải thiện năng lực lập kế hoạch của Planner, không phải thực thi của Executor. Bài học: dành mô hình mạnh nhất và prompt được thiết kế cẩn thận nhất cho Manager (planner), thay vì phân phối đều tài nguyên trên tất cả Agent.
Điều này không mâu thuẫn với lập luận từ Chương 4. Trong thảo luận về mô hình đề xuất và mô hình đánh giá, Chương 4 cho rằng năng lực của chúng nên tương tự—nhưng đó liên quan đến kịch bản đánh giá: người đánh giá phải theo kịp suy luận của bên được đánh giá để phát hiện sai sót. Nếu người đánh giá kém năng lực hơn nhiều so với bên được đánh giá, nó có thể không theo kịp suy luận đủ chặt để xác định sai sót. Mẫu quản lý liên quan đến điều khác: phân công lao động giữa lập kế hoạch và thực thi. Khi kế hoạch viên phân tách tác vụ sai, không executor nào, dù mạnh đến đâu, có thể phục hồi. Do đó mô hình mạnh nhất và prompt cẩn thận nhất dành cho kế hoạch viên trước. Liệu executor có cần năng lực cân bằng hay không phụ thuộc vào mức độ liên kết chặt của các tác vụ phụ. Khi đầu ra phải cuối cùng lắp ráp thành một thể, mắt xích yếu nhất thường kéo xuống chất lượng tổng thể.
[^plan-and-act-2025]: Erdogan, L. E., và cộng sự. Plan-and-Act: Improving Planning of Agents for Long-Horizon Tasks. arXiv:2503.09572, 2025.
Mẫu Phối hợp Tuần tự.
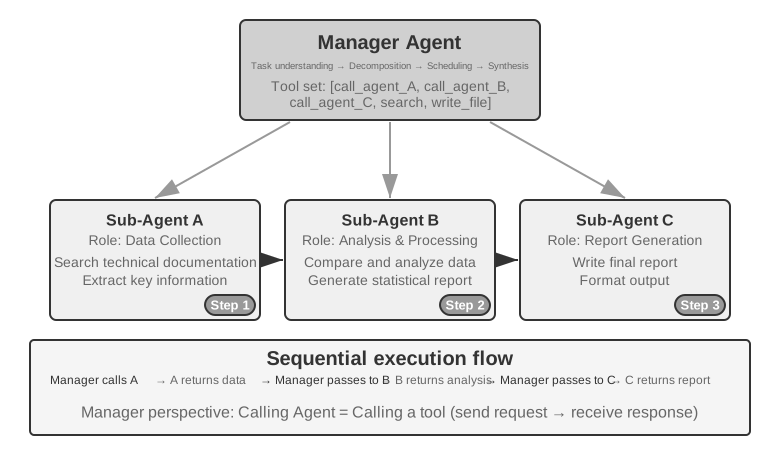
Manager gọi các Agent chuyên biệt tuần tự. Mỗi Agent trả về kết quả khi hoàn thành, và Manager quyết định bước tiếp theo. Dòng kiểm soát tuyến tính, đơn giản và rõ ràng, phù hợp với kịch bản tác vụ phụ có phụ thuộc tuần tự rõ ràng.
Thí nghiệm 10-2 ★★: Agent Dịch Sách
Dịch sách là tác vụ phức tạp phù hợp cho cộng tác đa-agent. Dịch sách kỹ thuật liên quan không chỉ chuyển đổi văn bản từ ngôn ngữ này sang ngôn ngữ khác, mà còn đảm bảo thuật ngữ chuyên biệt nhất quán, chính xác ngữ cảnh và độ trôi chảy tổng thể. Ví dụ: sách tiếng Anh về LLM có thể sử dụng nhiều thuật ngữ lặp lại với vài bản dịch quy ước. Nhất quán phải được duy trì xuyên suốt cuốn sách: nếu `agent` được dịch là "intelligent entity" (thể thông minh, thuật ngữ tiếng Trung chuẩn) trong Chương 1, cuốn sách không thể chuyển sang cách dịch thay thế "proxy" (đại lý) sau đó.
Sử dụng Agent đơn tạo ra vấn đề quản lý context nghiêm trọng. Khi Agent xử lý cuốn sách từng chương, context tích lũy bảng thuật ngữ toàn sách, các chương đã dịch, đoạn hiện tại, dấu vết công việc dịch và kết quả công cụ. Sách kỹ thuật vài trăm trang cùng với tài liệu trung gian này có thể dễ dàng vượt quá cửa sổ context. Quan trọng hơn, Agent làm việc với context quá dài dễ bị "lạc đường": nó có thể quên quy ước thuật ngữ trước đó và sử dụng bản dịch khác ở Chương 8 so với Chương 2, lãng phí tài nguyên vào kiểm tra trùng lặp trong khi đọc, hoặc thậm chí "nhớ" quy tắc thuật ngữ không tồn tại vì sự chú ý bị phân tán quá mỏng.
Mẫu quản lý giải quyết các vấn đề này qua phân tách tác vụ và phân tách trách nhiệm:
- Agent Glossary: Nhận toàn bộ cuốn sách, xác định thuật ngữ chuyên biệt lặp lại, tham vấn từ điển chuyên gia và hướng dẫn dịch, và tạo bảng thuật ngữ có cấu trúc (định dạng JSON/CSV, bao gồm thuật ngữ tiếng Anh, bản dịch tiếng Trung, từ loại và ngữ cảnh sử dụng). Khi hoàn thành, nó viết bảng thuật ngữ vào hệ thống tệp chia sẻ, và Agent có thể bị hủy để giải phóng tài nguyên.
- Agent Translation: Nhận chương hiện tại, bảng thuật ngữ và hướng dẫn dịch (cấp độ độc giả mục tiêu, phong cách ngôn ngữ), và dịch sang tiếng Trung trôi chảy. Nó sử dụng nghiêm ngặt các bản dịch đã chỉ định cho thuật ngữ trong bảng thuật ngữ, và với thuật ngữ mới, nó suy luận bản dịch và đánh dấu để xem xét. Mỗi thể hiện làm việc trong context độc lập mà không can thiệp. Văn bản dịch được viết vào hệ thống tệp (ví dụ: `chapter1_zh.md`). Manager có thể khởi chạy nhiều thể hiện song song hoặc tuần tự.
- Agent Proofreading: Nhận tất cả văn bản dịch và bảng thuật ngữ, thực hiện kiểm tra nhất quán—xác minh liệu bản dịch thuật ngữ có đồng nhất, xác định không nhất quán, và kiểm tra độ trôi chảy và khả năng đọc tổng thể. Nó tạo báo cáo đọc được viết vào hệ thống tệp.
- Agent Manager: Context chủ yếu lưu mô tả tác vụ, kế hoạch thực thi, bản ghi gọi cho mỗi Agent và trạng thái tiến trình. Nó không lưu văn bản dịch đầy đủ, nằm trong hệ thống tệp; thay vào đó, nó chỉ duy trì chỉ mục tệp. Dựa trên báo cáo đọc, Manager có thể gửi chương cụ thể trở lại Agent Translation để sửa đổi.
Kết quả là, context Manager vẫn có thể quản lý ngay cả khi số chương dịch tăng.
Ưu điểm chính là cách ly context: Agent Glossary chỉ thấy nội dung cần thiết cho trích xuất thuật ngữ, Agent Translation chỉ thấy chương hiện tại và bảng thuật ngữ, và Agent Proofreading, trong khi cần truy cập toàn bộ văn bản, chỉ tập trung vào kiểm tra nhất quán. Điều này giữ context mỗi Agent gọn gàng và tập trung, cải thiện hiệu quả và giảm lỗi do quá tải thông tin.
Yêu cầu Thí nghiệm:
- Chọn sách kỹ thuật có nhiều hình minh họa chứa code làm văn bản nguồn
- Triển khai bốn loại Agent: Manager, Glossary, Translation, Proofreading
- Ghi lại sử dụng context mỗi Agent để xác minh mẫu quản lý kiểm soát tăng trưởng context hiệu quả như thế nào
- So sánh Agent đơn với mẫu quản lý về chất lượng dịch, hiệu quả thực thi và tiêu tốn tài nguyên
Mẫu Phối hợp Song song.
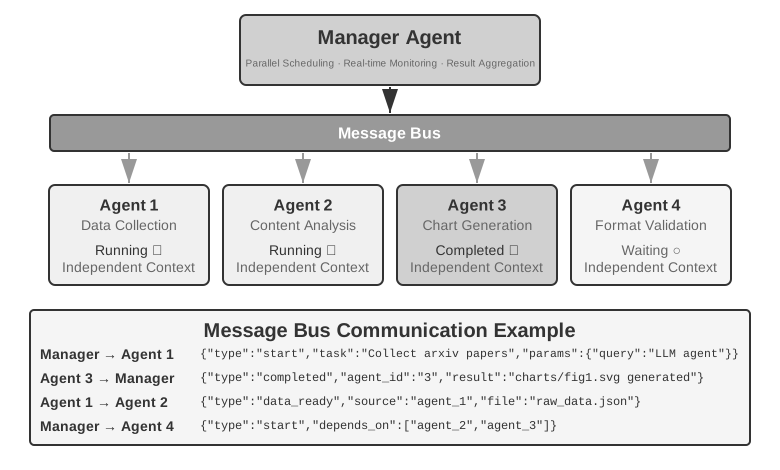
Khi nhiều tác vụ phụ có thể chạy song song, mẫu tuần tự trở nên không hiệu quả. Phối hợp song song cho phép nhiều Agent làm việc đồng thời, tăng đáng kể thông lượng. Agent Quản lý phải lên kế hoạch tác vụ song song, giám sát tất cả Agent đang chạy thời gian thực, phối hợp giao tiếp của chúng và đưa ra quyết định toàn hệ thống khi Agent thành công hoặc thất bại. Điều này thường yêu cầu bus thông điệp làm hạ tầng—hãy nghĩ nó như "bảng tin công cộng" nơi Agent có thể xuất bản thông điệp và đăng ký loại thông điệp quan tâm, cho phép giao tiếp bất đồng bộ, không chặn. Hai triển khai phổ biến, từ đơn giản đến phức tạp hơn, là Redis Pub/Sub và hàng đợi thông điệp như RabbitMQ. Redis Pub/Sub nhẹ và gửi thông điệp ngay lập tức, nhưng không lưu trữ chúng, vì vậy người nhận ngoại tuyến sẽ bỏ lỡ. RabbitMQ và hệ thống tương tự lưu trữ thông điệp vào đĩa, giữ chúng trong khi người nhận tạm thời ngoại tuyến. Thông điệp thường sử dụng phong bì JSON chứa ID người gửi, Agent mục tiêu (hoặc đánh dấu phát sóng), loại thông điệp và payload.
Lingtai: Thể hiện Sản phẩm hóa của Mẫu Quản lý. Lingtai là ngôi nhà cục bộ, dựa trên tệp cho agent sống dài[^lingtai]. Ba vai trò ánh xạ chặt chẽ lên các khái niệm trong phần này. Agent chính là trung tâm bền vững mà người dùng tương tác; nó giữ kế hoạch và bộ nhớ và tạo các vai trò khác, chiếm vị trí Agent Quản lý. Daemon là worker song song sống ngắn được tạo cho tác vụ ồn ào có giới hạn và loại bỏ sau đó; chỉ kết luận được giữ lại. Điều này sản phẩm hóa cả nguyên tắc sub-agent trả về tóm tắt có cấu trúc thay vì quỹ đạo đầy đủ và mẫu phối hợp song song. Avatar là đồng đội bền vững, chuyên biệt với bộ nhớ, hộp thư và trách nhiệm riêng, được thiết kế cho chuyên môn đáng giữ qua các phiên.
Phần còn lại thiết kế Lingtai cũng phản ánh các phần trước. Kiến thức nằm trong tệp bộ nhớ bền vững, riêng tư của mỗi agent, trong khi kỹ năng là playbook Markdown được chia sẻ bởi tất cả agent—tài nguyên hệ thống tích hợp được mô tả trong "Hệ thống Tệp từ Góc nhìn Agent." Khi cửa sổ context agent đầy, nó lột xác: nó viết tóm tắt cẩn thận, sau đó bắt đầu với context mới trong khi giữ tóm tắt và bộ nhớ bền vững, theo cách tiếp cận nén context từ Chương 2. Mô hình dưới có thể được thay thế mà không thay đổi agent vì danh tính, bộ nhớ và năng lực đều sống như tệp thuần trong thư mục dự án. Theo nghĩa này, agent là tệp của nó. Điều này sản phẩm hóa hai hàng đầu Bảng 10-3: cả chương trình và bộ nhớ đều giảm xuống tệp, vì vậy tiến trình có thể được xây dựng lại bất cứ lúc nào.
[^lingtai]: Lingtai official tutorial: https://lingtai.ai/en/tutorial/
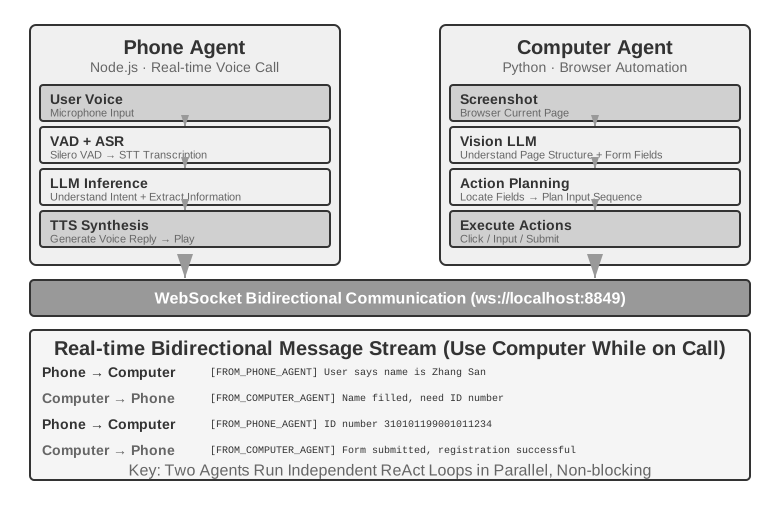
Thí nghiệm 10-3 ★★★: Agent Điện thoại và Máy tính Tự động
Điều kiện tiên quyết: Thí nghiệm này tích hợp công nghệ Computer Use và Voice Agent từ Chương 9.
Kịch bản và kiến trúc: Người dùng cung cấp URL đăng ký hoặc đặt chỗ, nhưng không phải tất cả trường cá nhân cần thiết. Agent Máy tính vận hành trình duyệt và Agent Điện thoại xử lý ASR, hội thoại LLM và TTS. Chúng trao đổi thông điệp có cấu trúc (người gửi, người nhận, loại và payload) qua công cụ điểm-điểm hoặc bus thông điệp. Trang âm thanh WebRTC cục bộ là đủ; PSTN/E.164 là tùy chọn.
Hai đường dẫn: Trước tiên chạy đường cơ sở bố cục cố định với cả hai Agent được khởi động trước, sau đó chạy đường dẫn tự động chính trong đó chỉ Agent Máy tính bắt đầu. Sau khi kiểm tra trang và context, nó có thể tự động gọi `initiate_phone_call_agent(purpose, required_info)`; không thay thế quyết định này bằng quy tắc đếm trường. Agent Điện thoại được tạo nhận context tác vụ cách ly và sử dụng cùng giao thức giao tiếp như đường cơ sở.
Vòng lặp kín song song: Agent Điện thoại hỏi, phiên âm, xác nhận và hỏi lại từng trường trong khi Agent Máy tính chụp ảnh, định vị phần tử và điền trường trước. Các thông điệp như `info_collected`, `fill_error`, `format_invalid` và `task_completed` làm cho vòng lặp quan sát được cả hai chiều. Agent Điện thoại tiếp tục hỏi mà không đợi mỗi lần điền trình duyệt, vì vậy hỏi và điền thực sự chồng lên. Sau khi xác nhận và ủy quyền rõ ràng, Agent Máy tính gửi biểu mẫu.
Yêu cầu và bằng chứng: Chứng minh khởi chạy tự động, vòng lặp ReAct độc lập, nhắn tin hai chiều, chồng thực sự, xác nhận trường và hỏi lại, phản hồi lỗi trang, thời gian chờ, hủy và giải phóng tài nguyên trình duyệt/âm thanh; yêu cầu sự đồng ý rõ ràng cho giọng nói thực và ủy quyền rõ ràng trước khi gửi.
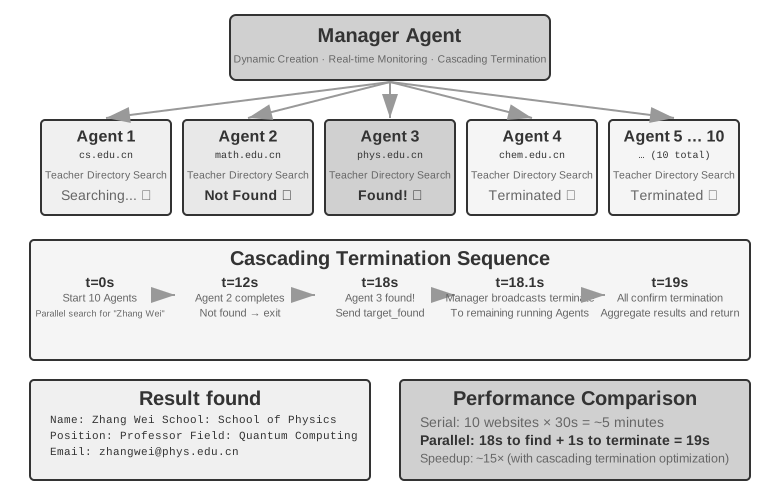
Thí nghiệm 10-4 ★★★: Agent Thu thập Thông tin từ Nhiều Trang web Đồng thời
Điều kiện tiên quyết: Nên bạn đọc trước tiên xem lại cơ chế sự kiện-driven và ngắt từ Chương 4.
Thí nghiệm này khám phá ứng dụng của thực thi song song đa-agent trong kịch bản thu thập thông tin. Không giống Thí nghiệm 10-3 tập trung vào cộng tác giữa hai Agent dị thể, thí nghiệm này tập trung vào tìm kiếm song song bởi nhiều Agent đồng thể và cách đạt hoàn thành tác vụ hiệu quả và tối ưu tài nguyên qua điều phối trung tâm.
Vấn đề: Cho trang web thư mục giảng viên của một số trường đại học, tìm kiếm mỗi trang cho giảng viên được chỉ định (ví dụ: "Zhang Wei"). Nếu tìm thấy, trả về trường, vị trí, lĩnh vực nghiên cứu và thông tin liên quan khác của người đó.
Thách thức Cốt lõi:
1. Khởi chạy Song song: Agent Quản lý động tạo 10 thể hiện Computer Use Agent, một cho mỗi trang web trường. Mỗi thể hiện nên là tiến trình hoặc luồng độc lập với phiên trình duyệt riêng, có thể chạy mà không chặn các Agent khác. Tham số truyền khi khởi chạy bao gồm URL trang web đích, tên giảng viên tìm kiếm và định danh tác vụ cho định tuyến thông điệp.
2. Giám sát Thời gian thực: Mỗi Agent định kỳ gửi cập nhật trạng thái trong quá trình thực thi ("Đang tải trang web," "Phân tích thư mục giảng viên," "Không tìm thấy mục tiêu; tác vụ hoàn thành," "Khớp tìm thấy; chi tiết bên dưới"). Agent Quản lý nhận các cập nhật này qua bus thông điệp, duy trì bảng trạng thái tác vụ và theo dõi thời gian thực Agent nào đang chạy, đã hoàn thành hoặc đang ở trạng thái lỗi.
3. Chấm dứt Cascading: Giả sử Agent được giao cho trường Khoa học Máy tính tìm thấy giảng viên. Nó gửi `{"type": "target_found", "agent_id": "agent_3", "data": {...}}` cho Agent Quản lý, ngay lập tức gửi `{"type": "terminate", "reason": "target_found_by_agent_3"}` cho mọi Agent khác vẫn đang chạy. Mỗi Agent phải có thể nhận thông điệp này bất cứ lúc nào, dừng nhẹ nhàng, giải phóng tài nguyên và xác nhận chấm dứt. Agent Quản lý đợi tất cả xác nhận, hoặc cho đến khi thời gian chờ, trước khi tổng hợp kết quả. Triển khai cũng phải xử lý điều kiện tranh chấp.
Bổ sung Khái niệm: Điều kiện Tranh chấp là gì? Giả sử Agent A và Agent B tìm thấy giảng viên mục tiêu trong cùng mili giây và cả hai báo cáo "Tôi tìm thấy!" cho Agent Quản lý. Nếu Manager xử lý kém, nó có thể bắt đầu tổng hợp kết quả sau khi nhận báo cáo Agent A, sau đó bắt đầu tổng hợp thứ hai khi báo cáo Agent B đến. Điều này có thể tạo kết quả trùng lặp hoặc trạng thái mâu thuẫn. Giải pháp thường là khóa: báo cáo đầu tiên khóa trạng thái, và báo cáo sau được nhận ra là trùng lặp và bỏ qua.
4. Xử lý Lỗi: Nhiều ngoại lệ có thể xảy ra trong quá trình vận hành: trang web trường có thể không truy cập được do lỗi mạng hoặc mất điện, hoặc cấu trúc có thể ngăn Agent phân tích chính xác. Tất cả Agent cũng có thể hoàn thành tìm kiếm mà không tìm thấy mục tiêu. Agent Quản lý nên đặt thời gian chờ cho mỗi Agent (ví dụ: 2 phút), coi thời gian chờ là lỗi và cách ly lỗi để không làm gián đoạn Agent khác. Sau khi tất cả Agent hoàn thành, trả về thông tin nếu Agent nào tìm thấy mục tiêu; nếu không, báo cáo "Không tìm thấy giảng viên mục tiêu" và tóm tắt bất kỳ lỗi nào.
Yêu cầu Thí nghiệm:
- Triển khai Agent Quản lý có khả năng động khởi chạy nhiều Agent song song
- Triển khai Computer Use Agent dựa trên dự án mã nguồn mở như browser-use
- Triển khai bus thông điệp hỗ trợ giao tiếp hai chiều giữa Agent Quản lý và nhiều Agent con
- Triển khai cơ chế chấm dứt cascading khi thành công, đảm bảo tất cả Agent khác dừng nhanh khi mục tiêu được tìm thấy
- Xử lý nhiều kịch bản ngoại lệ (truy cập trang web thất bại, lỗi phân tích, không Agent nào tìm thấy mục tiêu)
- Đo lường và so sánh thời gian thực thi tuần tự và song song để lượng hóa tăng tốc từ song song hóa
Mẫu Phi tập trung
Tại sao loại bỏ bộ điều khiển trung tâm? Động lực chính là mô phỏng tổ chức con người: vai trò ngang hàng phân công lao động và kiểm tra lẫn nhau, mỗi vai trò quyết định từ góc độ chuyên môn riêng liên hệ ai. Trong mẫu này, Agent có thể chuyển giao tác vụ, yêu cầu phản hồi hoặc báo cáo mâu thuẫn mà không định tuyến mọi quyết định qua Manager. Lĩnh vực microservice gọi hai lựa chọn là điều phối và biên đạo: cái trước có nhạc trưởng trung tâm; cái sau dựa vào mỗi người tham gia để cảm nhận khi nào hành động.
Phi tập trung hóa cũng giảm tác động của một Agent không ổn định. Lỗi mô hình hoặc nhà cung cấp có thể để Agent không phản hồi, khiến lệnh gọi công cụ thất bại hoặc tạo vòng lặp gọi không hợp lệ. Trong bố cục manager, Manager bị crash là lỗi điểm đơn lớn nhất; phân phối kiểm soát có thể chứa lỗi đó.
Các trường hợp sau tiến triển từ phi tập trung hóa một phần đến đầy đủ. MetaGPT sử dụng pipeline cố định và chỉ phi tập trung hóa giao tiếp. AutoGen kết hợp lịch sử hội thoại chia sẻ với lên lịch tập trung. OpenAI Swarm phân phối trực tiếp quyết định dòng kiểm soát giữa các Agent ngang hàng.
Gói chuyển giao hiệu quả chứa mô tả tác vụ và tiêu chí chấp nhận, sự kiện đã xác nhận và ràng buộc, và tham chiếu đến sản phẩm có cấu trúc (đường dẫn tệp thay vì nội dung tệp). Nó cố ý loại trừ toàn bộ quỹ đạo thử-và-sai của người gửi. Chuyển giao context chia sẻ giữ toàn bộ lịch sử nhưng phồng context; chuyển giao cách ly truyền gói chưng cất để mỗi Agent có thể làm việc trong context sạch.
MetaGPT: Mô phỏng Công ty Phần mềm Dẫn dắt SOP.
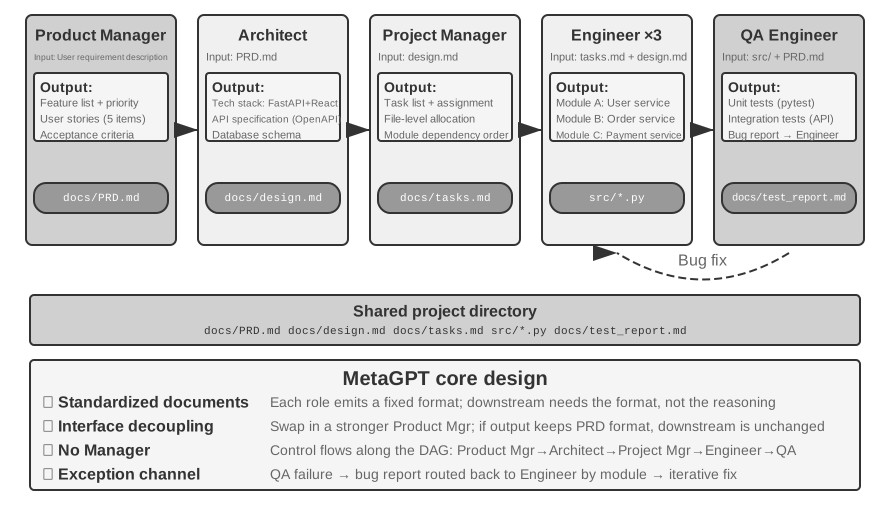
Insight cốt lõi của MetaGPT là Quy trình Vận hành Chuẩn (SOP) được phát triển và tinh chỉnh bởi công ty phần mềm có thể đóng vai trò giao thức cộng tác cho hệ thống đa-agent. Mã hóa các SOP này cho phép mỗi vai trò, như công nhân chuyên biệt trên dây chuyền lắp ráp, tạo sản phẩm tiêu chuẩn hóa, và các sản phẩm đó tự nhiên trở thành giao diện giao tiếp giữa các vai trò.
Trong MetaGPT, các vai trò làm việc theo thứ tự cố định (Quản lý Sản phẩm → Kiến trúc sư → Quản lý Dự án → Kỹ sư → QA), mỗi vai trò xuất gói chuyển giao có cấu trúc:
- Agent Quản lý Sản phẩm: Nhận mô tả yêu cầu, tạo PRD có cấu trúc (Tài liệu Yêu cầu Sản phẩm, bao gồm danh sách tính năng, câu chuyện người dùng, tiêu chí chấp nhận, xếp hạng ưu tiên)
- Agent Kiến trúc sư: Đọc PRD, đưa ra quyết định kiến trúc (lựa chọn ngăn xếp công nghệ, phân chia module, định nghĩa giao diện, thiết kế mô hình dữ liệu), xuất tài liệu thiết kế
- Agent Quản lý Dự án: Đọc thiết kế kiến trúc, phân tách hệ thống thành danh sách tác vụ cụ thể và giao cấp tệp, làm rõ thứ tự phụ thuộc module, sau đó giao tác vụ cho kỹ sư
- Agent Kỹ sư: Đọc tài liệu thiết kế, triển khai module được giao, tạo code. Nhiều thể hiện có thể làm việc song song.
- Agent Kỹ sư QA: Đọc code và PRD, tạo kiểm tra, thực thi kiểm tra, ghi lỗi, xuất báo cáo kiểm tra
Đóng góp thực sự của MetaGPT cho giao tiếp phi tập trung nằm ở cơ chế truyền thông tin: Pool Thông điệp Chia sẻ + Đăng ký theo Vai trò. Mỗi vai trò xuất bản thông điệp có cấu trúc đến pool hiển thị cho tất cả vai trò. Dựa trên cấu hình đăng ký, các vai trò khác chỉ tiêu thụ thông điệp liên quan đến trách nhiệm thay vì giao tiếp điểm-điểm. Người xuất bản không cần biết ai sẽ tiêu thụ đầu ra. Để thêm vai trò, khai báo loại thông điệp nó đăng ký; vai trò hiện có không cần thay đổi. Điều này tạo giải ghép thực sự: ví dụ: thay thế Quản lý Sản phẩm bằng mô hình mạnh hơn không yêu cầu thay đổi Agent khác, miễn là PRD vẫn tuân thủ đặc tả.
Cải thiện lặp của MetaGPT xảy ra chủ yếu trong giai đoạn kỹ thuật qua phản hồi thực thi được. Kỹ sư chạy code và kiểm tra, sử dụng lỗi và thất bại để hướng dẫn vòng gỡ lỗi, và tiếp tục cho đến khi kiểm tra thông qua. Sửa đổi được điều khiển bởi kết quả thực thi xác định thay vì ý kiến Agent khác.
Để rõ ràng, MetaGPT không phi tập trung về dòng kiểm soát—thứ tự vai trò được SOP xác định trước, làm cho hệ thống tổng thể gần hơn với dây chuyền lắp ráp (workflow theo ngôn ngữ Chương 1). Nó được thảo luận trong phần này vì cơ chế giao tiếp pool thông điệp cộng đăng ký thể hiện yếu tố thiết kế quan trọng nhất của hệ thống phi tập trung: giải ghép. Về phản hồi động đa chiều như "QA trực tiếp liên hệ Quản lý Sản phẩm để làm rõ yêu cầu" hoặc "Kỹ sư thảo luận giải pháp thay thế với Kiến trúc sư," đây là mở rộng tự nhiên được hình dung cho kiến trúc này nhưng không được triển khai trong MetaGPT gốc.
AutoGen Group Chat: Lịch sử Hội thoại Chia sẻ + Lên lịch Tập trung. Group chat của AutoGen cho phép nhiều Agent tham gia cùng cuộc trò chuyện. Trong mỗi vòng, "bộ chọn người nói" quyết định Agent nào nói tiếp. Bộ chọn có thể theo quy tắc round-robin đơn giản hoặc sử dụng LLM để xác định Agent nào phù hợp nhất phản hồi dựa trên cuộc trò chuyện đến nay. Đóng góp của mọi Agent hiển thị cho tất cả người tham gia.
Điều này không hoàn toàn phi tập trung về dòng kiểm soát: `GroupChatManager` chọn người nói tập trung, và quyết định lượt của ai tạo thành quyết định dòng kiểm soát. Phân loại chính xác hơn do đó là lịch sử hội thoại chia sẻ + lên lịch tập trung. Tất cả Agent thấy lịch sử công khai giống nhau, nhưng mỗi Agent giữ system prompt và bộ công cụ độc lập, trong khi bộ chọn giữ quyền lên lịch.
Mô hình này phù hợp với tác vụ yêu cầu thảo luận từ nhiều góc nhìn và thứ tự nói không thể xác định trước, như đánh giá kế hoạch hoặc phân tích liên miền. Tuy nhiên, cuộc trò chuyện có thể trôi dạt: mọi Agent có thể tiếp tục nói mà nhóm không tiến bộ, dạng livelock. Điều kiện chấm dứt rõ ràng do đó là thiết yếu. Theo các chiều sử dụng trong chương này, AutoGen là lai: lên lịch tập trung, trong khi context được chia sẻ một phần. Điều này minh họa rằng bố cục và chia sẻ context là các chiều thiết kế độc lập.
OpenAI Swarm và Agents SDK: Mạng Chuyển giao. Ngược lại, Swarm của OpenAI và successor, Agents SDK, đại diện cho phi tập trung ngang hàng trong dòng kiểm soát. Mỗi Agent có vài tùy chọn chuyển giao và có thể chuyển kiểm soát cho Agent khác trong mạng bất cứ lúc nào. Agent phân loại dịch vụ khách hàng xác định vấn đề liên quan đến hoàn tiền chuyển tác vụ cho Agent Hoàn tiền; nếu Agent đó phát hiện lỗi kỹ thuật, nó có thể chuyển tác vụ cho Agent Hỗ trợ Kỹ thuật. Không có bộ lên lịch tập trung. Kiểm soát truyền như gậy tiếp sức giữa các Agent ngang hàng, và mỗi Agent đưa ra quyết định định tuyến riêng. Đây là triển khai kỹ thuật của mẫu chuỗi chuyển giao trong Hình 10-10. Rủi ro là vòng lặp: A chuyển cho B, và B chuyển lại cho A, để tác vụ xoay trong vòng lặp. Bảo vệ như giới hạn số chuyển giao tối đa cần để phá vỡ.
Thuật ngữ: Agent Swarm. Từ 2025, "Agent Swarm" đã trở thành từ thông dụng qua các nhà cung cấp, nhưng nó không tương ứng với kiến trúc đơn lẻ. Sử dụng ngành chia thành hai phe. Đầu tiên là mạng chuyển giao kiểu OpenAI Swarm (thư viện swarm của LangGraph và điều phối chuyển giao của Microsoft Agent Framework theo cùng ý tưởng)—mẫu phi tập trung được thảo luận trong phần này. Thứ hai, tìm thấy trong một số sản phẩm thương mại chính thống, là Mẫu Quản lý ở quy mô lớn: Agent Swarm ra mắt với Kimi K2.5 có Agent chính động tạo hàng trăm sub-agent để thực thi song song, với quyết định điều phối "khi nào chia, và bao nhiêu" được đào tạo trực tiếp vào mô hình qua học tăng cường Agent song song; K3 tiếp tục như tầng mô hình chuyên dụng, và sandbox đào tạo Agent song song đi kèm, AgentEnv, đã được mã nguồn mở.[^ch10-kimi-swarm] Hệ thống nghiên cứu đa-agent của Anthropic và Wide Research của Manus đều thuộc cùng bố cục ngôi sao worker-điều phối. Hy vọng của chúng tôi là sau khi đọc cuốn sách này, bạn có thể nhìn xuyên qua khái niệm đến bản chất và phân tích hệ thống đa-agent từ nguyên tắc đầu tiên.
[^ch10-kimi-swarm]: Moonshot AI, Kimi Agent Swarm: 100 Sub-Agents at Scale, 2026, https://www.kimi.com/blog/agent-swarm. Tại GTC 2026, giới hạn trên sub-agent song song được tiết lộ mở rộng đến 300. AgentEnv là sandbox đào tạo Agent mã nguồn mở bởi Moonshot AI hợp tác với KVCache.ai, phát hành cùng Kimi K3 vào tháng 7 năm 2026.
Cộng tác Liên Tổ chức: Giao thức A2A
Tất cả hệ thống trên giả định rằng tất cả Agent được phát triển bởi cùng nhóm và chạy trong cùng hệ thống. Trong trường hợp này, ba cơ chế giao tiếp—truyền tham số, tệp chia sẻ và bus thông điệp—là đủ. Tuy nhiên, khi cộng tác vượt qua ranh giới tổ chức—Agent của bạn cần gọi Agent của công ty khác—giao thức tương tác chuẩn hóa được yêu cầu. Thế giới tiến trình theo cùng sự tiến hóa: IPC chỉ quản lý máy đơn, và khi bạn bước qua ranh giới máy, bạn phải dựa vào giao thức chuẩn như TCP/IP và khám phá dịch vụ như DNS. A2A đối với Agent như giao thức mạng đối với tiến trình. A2A (Agent2Agent) được Google phát hành năm 2025 (sau đó tặng cho Linux Foundation quản lý) được thiết kế chính xác cho mục đích này. Nó có ba yếu tố cốt lõi:
- Agent Card: Tài liệu siêu dữ liệu mô tả năng lực Agent (xuất bản tại địa chỉ công khai được chỉ định), khai báo Agent có thể làm gì, phương thức đầu vào/đầu ra nào được hỗ trợ và cách xác thực—về cơ bản là "danh thiếp" của Agent giải quyết khám phá năng lực liên tổ chức.
- Quản lý Vòng đời Tác vụ: A2A mô hình hóa đơn vị cộng tác như Tác vụ với máy trạng thái xác định (submitted, in-progress, needs-input, completed, failed), hỗ trợ gốc tác vụ chạy dài và cập nhật tiến trình streaming.
- Cộng tác Opaque: Agent chỉ trao đổi tác vụ và sản phẩm, mà không hiển thị prompt nội bộ, quá trình suy luận hoặc triển khai công cụ—phù hợp với nguyên tắc "không chia sẻ context" của chương này và thuộc tính bảo mật cần thiết cho cộng tác liên tổ chức.
MCP cho phép tương tác giữa Agent và công cụ, trong khi A2A cho phép tương tác giữa Agent. A2A không thay thế ba cơ chế giao tiếp được giới thiệu trong chương này; nó là tầng chuẩn hóa được sử dụng qua ranh giới tin cậy. Bus thông điệp có thể đủ trong một tổ chức, nhưng các bên không tin tưởng lẫn nhau và không thể kiểm tra triển khai của nhau cần giao thức công khai như A2A.
Chế độ Thất bại của Cộng tác Đa-Agent
Hệ thống đa-agent giới thiệu chế độ thất bại mới không tồn tại trong hệ thống agent đơn. Bài báo 2025 "Why Do Multi-Agent LLM Systems Fail?" đề xuất phân loại chế độ thất bại MAST qua nghiên cứu có hệ thống. Người nghiên cứu thu thập dấu vết thực thi từ bảy framework đa-agent chính thống, bao gồm MetaGPT, ChatDev, AG2 và Magentic-One. Người ghi chú con người độc lập phân tích khoảng 150 dấu vết, đạt thỏa thuận cao về đánh giá (Cohen's kappa = 0,88). Nghiên cứu xác định 14 chế độ thất bại duy nhất trong ba nhóm:
- Lỗi Thiết kế Hệ thống: Vấn đề cấp kiến trúc như định nghĩa giao diện không rõ ràng giữa Agent, vai trò và trách nhiệm chồng chéo và cấu hình công cụ sai.
- Lỗi Căn chỉnh Liên-Agent: Nhiều Agent có hiểu biết không nhất quán về mục tiêu tác vụ, thông tin truyền bị Agent hạ nguồn hiểu sai hoặc thao tác của nhiều Agent mâu thuẫn logic lẫn nhau.
- Thiếu Xác minh Tác vụ: Hệ thống thiếu cơ chế hiệu quả để xác nhận liệu tác vụ thực sự hoàn thành chưa—Agent có thể tuyên bố "hoàn thành" nhưng kết quả thực không đáp ứng yêu cầu.
Ngay cả sửa đơn giản cũng tạo ra lợi ích hạn chế; ví dụ: hiệu suất đo lường của ChatDev cải thiện chỉ 15,6%. Người nghiên cứu kết luận đây không chỉ là lỗi kỹ thuật mà là lỗi thiết kế cơ bản của kiến trúc đa-agent hiện tại: vá một thành phần không đủ; thiết kế hệ thống bản thân phải được suy nghĩ lại.
Lý thuyết dung lỗi phân tán phân biệt lỗi crash, trong đó thành phần ngừng hoạt động, với lỗi Byzantine, trong đó nó tiếp tục vận hành nhưng cung cấp thông tin sai. Lỗi Agent thường là Byzantine: Agent tiếp tục tạo kết luận hợp lý nhưng sai mà không thông báo lỗi. Xác minh chéo và bỏ phiếu đa số do đó là thiết yếu, và kiểm tra xác định như kiểm tra, trình biên dịch và truy vấn cơ sở dữ liệu đặc biệt có giá trị vì chúng cung cấp bằng chứng độc lập.
Các phần sau tập trung vào một số chế độ thất bại đặc biệt phổ biến trong thực tế.
Chế độ Thất bại Một: Xung đột Đồng thời trong Hệ thống Tệp Chia sẻ
Khi bạn chọn giao tiếp kiểu bộ nhớ chia sẻ, xung đột đồng thời đi kèm—vấn đề hệ thống điều hành và cơ sở dữ liệu đã giải quyết từ lâu, với câu trả lời đã sẵn sàng. Các xung đột này có thể chia thành hai loại.
Xung đột Đơn giản (Xung đột Ghi Cấp Tệp): Hai Agent sửa cùng tệp đồng thời, và ghi sau đè lên ghi trước.
Xung đột Ngữ nghĩa (Xung đột Nhất quán Cấp Logic): Không xung đột nào khả kiến ở cấp tệp, nhưng thao tác của nhiều Agent mâu thuẫn logic lẫn nhau—loại xung đột này tinh vi hơn và nguy hiểm hơn. Ví dụ: Agent A chịu trách nhiệm đánh số lại tất cả hình ảnh trong sách, trong khi Agent B đồng thời sửa nội dung chương và tham chiếu hình ảnh theo số gốc. Hai Agent thao tác trên tệp khác nhau, vì vậy không có xung đột ở cấp tệp. Tuy nhiên, kết quả là tất cả số hình ảnh được tham chiếu bởi Agent B trở nên không hợp lệ sau khi Agent A hoàn thành đánh số lại, và người đọc thấy tham chiếu hình ảnh sai.
Giải pháp: Cơ chế Khóa Lạc quan. Đây là chiến lược kiểm soát đồng thời phổ biến trong cơ sở dữ liệu. Để hiểu, xem xét ví dụ hàng ngày: bạn và đồng nghiệp mở cùng tài liệu trực tuyến đồng thời. "Khóa bi quan" sẽ khóa tài liệu khi bạn mở, và đồng nghiệp sẽ thấy "tệp bị khóa" khi cố sửa. Điều này an toàn nhưng không hiệu quả vì bạn có thể chỉ đang xem tài liệu. "Khóa lạc quan" linh hoạt hơn: mọi người có thể mở và sửa tự do, nhưng khi lưu, hệ thống hỏi, "Ai khác đã sửa tài liệu từ khi bạn mở chưa?" Nếu có, nó nhắc bạn làm mới và thử lại.
Triển khai cụ thể: mỗi tệp duy trì số phiên bản (hoặc dấu thời gian sửa đổi cuối). Khi Agent đọc tệp, nó ghi lại số phiên bản hiện tại; khi ghi, nó kiểm tra liệu số phiên bản vẫn giống khi đọc. Nếu tệp đã được Agent khác sửa đổi trong thời gian đó, ghi thất bại, và Agent bị ép đọc lại phiên bản mới nhất và thực thi lại thao tác dựa trên phiên bản đó. Chi phí cơ chế này là thử lại偶尔, nhưng nó đảm bảo nhất quán dữ liệu—Agent không bao giờ đưa ra quyết định dựa trên trạng thái tệp lỗi thời.
Lưu ý rằng khóa lạc quan chỉ có thể ngăn xung đột ghi trên cùng tệp. Đối với xung đột ngữ nghĩa liên tệp đã đề cập (ví dụ: số hình ảnh được tham chiếu ở nhiều nơi), điều phối cấp cao hơn hoặc xác nhận ngữ nghĩa cần thiết, như tránh sửa song song tệp phụ thuộc hoặc chạy kiểm tra nhất quán toàn cục sau khi ghi.
Ví dụ: Agent A đọc `config.json` (version=3) tại t=0. Agent B sửa cùng tệp tại t=1, thay đổi version thành 4. Khi Agent A cố ghi tại t=2, nó thấy version không còn là 3, vì vậy ghi bị từ chối. Agent A sau đó đọc lại version 4, tái tạo thay đổi so với nội dung mới nhất, và cố ghi lại.
Khi nhiều Coding Agent sửa cùng codebase đồng thời, cách tiếp cận chuẩn ngành không phải là khóa một bản sao làm việc mà sử dụng cách ly bản sao làm việc. Mỗi Agent nhận nhánh Git hoặc worktree độc lập và sửa bản sao riêng mà không can thiệp vào nhau. Xung đột được hoãn đến gộp cuối, nơi quy trình chuyên dụng hoặc con người giải quyết. Cơ chế copy-on-write được sử dụng khi hệ điều hành fork tiến trình theo cùng ý tưởng. Điều này phản ánh nguyên tắc "cách ly trên nén" từ Chương 2: thay vì chia sẻ trạng thái có thể thay đổi và giải quyết xung đột liên tục, cách ly công việc từ đầu và chịu chi phí phối hợp tại điểm gộp được xác định rõ.
Chế độ Thất bại Hai: Khuếch đại Cascading Lỗi
Xung đột đồng thời là vấn đề cấp tệp có thể giải quyết bằng kỹ thuật hệ điều hành và cơ sở dữ liệu đã thiết lập. Lỗi cascading khác vì chúng xuất phát nơi phép loại suy tiến trình bị phá vỡ: tiến trình truyền byte chính xác, trong khi Agent truyền ý nghĩa, và mỗi lần kể lại có thể giới thiệu méo mó. Khi nhiều Agent tương tác thường xuyên, lỗi từ Agent này có thể được củng cố dần bởi các Agent tiếp theo, giống như "trò chơi điện thoại" trong đó thông tin ngày càng bị méo mó.
Xem xét kịch bản cụ thể. Giả sử hệ thống dịch sử dụng mẫu quản lý (kiến trúc từ Thí nghiệm 10-2), trong đó Manager giao các chương sách kỹ thuật cho nhiều Agent dịch:
Agent Thuật ngữ: Dịch "reasoning" thành "推理", nhưng "推理" trong tiếng Trung thường được sử dụng cho suy luận, tạo mơ hồ
        ↓ ghi vào glossary.json
Agent Translation A: Dịch Chương 2, đọc từ bảng thuật ngữ, dịch "reasoning tokens" thành "推理 token"
Agent Translation B: Dịch Chương 7, dịch "inference latency" thành "推理 latency"
        ↓ ghi vào bản dịch mỗi chương
Agent Proofreading: Thấy toàn bộ sách sử dụng nhất quán "推理", coi thuật ngữ nhất quán và bản dịch đúng ✗
Lỗi ở đâu? "Reasoning" (quá trình suy nghĩ của mô hình) và "inference" (lượt đi trước của mô hình khi triển khai) là hai khái niệm riêng biệt. Nhưng vì Agent Thuật ngữ trước tiên dịch "reasoning" thành "推理," các Agent tiếp theo tự nhiên tìm đến cùng từ khi gặp "inference"—hai khái niệm khác nhau sụp đổ thành một bản dịch, để người đọc không thể phân biệt. Lựa chọn đúng là "思考" ("suy nghĩ") cho "reasoning" và "推理" cho "inference." Tuy nhiên, Agent Proofreading, thấy "推理" được sử dụng "nhất quán" xuyên suốt, kết luận bản dịch chất lượng cao.
Sau khi lan truyền qua ba Agent, lỗi thuật ngữ đơn lẻ có vẻ đáng tin cậy hơn vì nó được áp dụng nhất quán. Đây là lý do cuốn sách phân biệt reasoning là 思考 khác với inference là 推理, như giải thích trong lời nói đầu. Lỗi ban đầu không nhất thiết là ảo giác; nó có thể chỉ là quyết định thuật ngữ kém. Dù bằng cách nào, Agent sau có thể củng cố nó. Nếu nguyên nhân gốc là ảo giác thực sự—ví dụ: Agent Translation "nhớ" quy tắc thuật ngữ không tồn tại do drift sự chú ý—cùng cơ chế khuếch đại áp dụng, với hậu quả có thể nghiêm trọng hơn. Mẫu quản lý đặc biệt dễ bị tổn thương vì tóm tắt sub-agent không chính xác có thể trở thành tiền đề cho tất cả công việc tiếp theo.
Xác minh chéo là chìa khóa phá vỡ chuỗi này. Mục tiêu không phải thêm nhiều Agent hơn vào cùng đường dẫn suy luận, mà để Agent độc lập so sánh bằng chứng gốc với kết luận. Điều này mở rộng cơ chế đề xuất-đánh giá từ Chương 5: Agent Đánh giá có thể xác định mâu thuẫn bị bỏ sót bởi toàn bộ chuỗi, trong khi kiểm tra, trình biên dịch và truy vấn cơ sở dữ liệu cung cấp bằng chứng xác định cho quyết định rủi ro cao.
Chế độ Thất bại Ba: Chấm dứt Sớm và Vòng lặp Chạy trốn
Đối lập của chấm dứt sớm là vòng lặp không kiểm soát. Vòng lặp có thể chạy vô hạn hoặc cạn kiệt ngân sách token. Ngân sách rõ ràng, hủy và điều kiện dừng cần thiết để giữ nó giới hạn.
Chế độ Thất bại Bốn: Nợ Hiểu biết và Đầu hàng Nhận thức
Càng nhanh vòng lặp xuất code, sự hiểu biết của kỹ sư có thể tụt lại phía sau càng xa. Cuối cùng con người có thể không còn hiểu hệ thống hoặc ngừng đánh giá độc lập. Bộ xác minh dựa trên quan sát thực và người vẫn là kỹ sư của vòng lặp là phương thuốc.
Cho đến nay, chương này đã lấy góc nhìn kỹ thuật: nhóm Agent có thể cộng tác trên tác vụ như thế nào? Trọng tâm bây giờ chuyển sang câu hỏi khác: điều gì xuất hiện khi số lượng lớn Agent cùng tồn tại trong thời gian dài mà không được thúc đẩy bởi mục tiêu đơn lẻ? Phần tiếp theo khám phá nghiên cứu frontier, vì vậy bạn đọc kỹ thuật có thể đọc chọn lọc.
Xã hội Agent
Ba phần trước đều giải quyết cộng tác tác vụ có mục tiêu. Chúng ta bây giờ chuyển sang câu hỏi mở hơn: Khi số lượng Agent tăng từ vài lên hàng trăm hoặc hàng nghìn, và tương tác đủ tự do, hành vi nào xuất hiện?
Hành vi nổi sinh là hành vi hệ thống thể hiện như thể toàn bộ mà không thể dự đoán trực tiếp từ các quy tắc chi phối thành viên riêng lẻ. Ví dụ kinh điển trong tự nhiên là thuộc địa kiến: mỗi con kiến chỉ theo quy tắc đơn giản (theo dấu feromone, để lại feromone khi tìm thấy thức ăn), nhưng toàn bộ thuộc địa có thể tìm đường ngắn nhất từ tổ đến nguồn thức ăn—không con kiến nào "thiết kế" tuyến đường này; nó nổi sinh tự nhiên từ tương tác đơn giản của nhiều cá thể.
Khi AI Agent đủ nhiều và tương tác đủ tự do, hành vi nổi sinh tương tự bắt đầu xuất hiện. Người nghiên cứu quan sát qua nhiều môi trường rằng khi hệ thống Agent vượt qua ngưỡng quy mô quan trọng, hành vi tập thể xuất hiện mà không ai thiết kế—from bữa tiệc tự phát tổ chức đến văn hóa nhóm và trò chơi kinh tế chỉ xuất hiện ở quy mô nghìn (chi tiết trong các phần con dưới).
Các trường hợp trong phần này có thể hiểu từ ba chiều:
- Nổi sinh Xã hội: Agent tự phát tạo mối quan hệ xã hội và hiện tượng văn hóa trong môi trường mở. Stanford AI Town chứng minh cách 25 Agent tự tổ chức hoạt động xã hội, Agentopia mở rộng thời gian mô phỏng từ "ngày" sang 10 năm, và Moltbook đẩy quy mô lên 1,5 triệu, tạo ra hành vi tập thể phức tạp hơn.
- Nổi sinh Kinh tế: Agent phân bổ tài nguyên và phối hợp tác vụ qua cơ chế thị trường. Vending-Bench Arena đặt nhiều Agent cạnh tranh trong thị trường chia sẻ, trong khi Pinchwork và RentAHuman tạo thị trường cho giao dịch giữa Agent và giữa Agent và con người.
- Chiến lược Trò chơi: Agent tham gia suy luận, lừa dối và thao túng xã hội dưới ràng buộc quy tắc (ở đây và phần Ma Sói bên dưới, "suy luận" theo nghĩa suy luận hàng ngày—suy luận logic trong trò chơi—không phải nghĩa kỹ thuật cuốn sách gán cho từ). Thí nghiệm Ma Sói kiểm tra sự nổi sinh của chiến lược dưới thông tin bất đối xứng.
Stanford AI Town: Mô phỏng Xã hội của Generative Agent
Năm 2023, nhà nghiên cứu từ Đại học Stanford và Google xuất bản bài báo landmark "Generative Agents: Interactive Simulacra of Human Behavior," giới thiệu khái niệm "generative agent." Đổi mới cốt lõi là ngừng giới hạn Agent vào tác vụ xác định trước mà thay vào đó trang bị cho chúng bộ nhớ, phản ánh và lập kế hoạch gần con người, để chúng có thể sống, xã hội hóa và phát triển tự động trong môi trường xã hội mở.
Smallville là thị trấn 2D giống "The Sims," có không gian công cộng và riêng tư như quán cà phê, công viên, nơi ở và cửa hàng. Hai mươi lăm Agent đóng vai trò khác nhau (chủ cửa hàng, nghệ sĩ, sinh viên, giáo sư, v.v.), mỗi Agent có backstory, đặc điểm tính cách và mối quan hệ liên cá nhân độc đáo. Ví dụ: John Lin là chủ hiệu thuốc yêu gia đình và quan tâm cộng đồng; Isabella Rodriguez điều hành quán cà phê Hobbs Cafe của thị trấn, và ấm áp hiếu khách; Klaus Mueller là sinh viên đại học viết bài nghiên cứu.
Trí tuệ của các Agent này được xây dựng trên ba thành phần cốt lõi:
Luồng Bộ nhớ: Không giống Agent truyền thống chỉ giữ lịch sử hội thoại giới hạn, generative agent duy trì luồng ghi lại trải nghiệm đầy đủ, bao gồm sự kiện quan sát, cuộc trò chuyện và suy nghĩ tạo ra. Mỗi bộ nhớ được chấm điểm cho tầm quan trọng, tính mới và liên quan, cho phép Agent ưu tiên truy xuất bộ nhớ liên quan nhất cho context hiện tại. Điều này giống bộ nhớ con người: bữa trưa hôm qua có thể phai, trong khi cuộc trò chuyện quan trọng tuần trước vẫn sống động.
Cơ chế Phản ánh: Agent định kỳ dừng hoạt động hàng ngày để xem lại trải nghiệm gần đây và đặt câu hỏi trừu tượng về bản thân và người khác ("Klaus Mueller nghiên cứu gì?" "Ai là bạn thân nhất của tôi?"). Qua tự vấn này, Agent nâng ký ức sự kiện cụ thể thành hiểu biết khái quát, lưu trữ trở lại luồng bộ nhớ làm cơ sở cho quyết định tương lai. Phản ánh không chỉ giúp Agent hiểu thế giới bên ngoài mà còn thúc đẩy tự nhận thức—Agent bắt đầu "nhận ra" vai trò, mối quan hệ và mục tiêu riêng.
Lưu ý rằng phản ánh này khác với tiến hóa liên tục được thảo luận trong Chương 8: nó xảy ra trong hoạt động hàng ngày của generative agent và nhằm cập nhật trạng thái nội bộ và mục tiêu tức thì. Trong Chương 8, phản ánh hậu tác vụ nhiều nhất là bài học ứng viên; nó trở thành cập nhật năng lực dài hạn chỉ sau đánh giá kết quả, tổng hợp liên quỹ đạo và xác nhận tiếp theo.
Lập kế hoạch và Phản ứng: Agent lập kế hoạch hoạt động hàng ngày (ví dụ: "8:30 ăn sáng, 9:00-12:00 viết, 12:30 đi dạo"), nhưng linh hoạt điều chỉnh dựa trên thay đổi môi trường và cơ hội xã hội. Sự kết hợp giữa lập kế hoạch và phản ứng thời gian thực làm cho hành vi Agent vừa có hướng mục tiêu vừa thích ứng với tính không thể đoán trước của tương tác xã hội.
Trong hai ngày ảo ở Smallville, các Agent này thể hiện hành vi nổi sinh đáng ngạc nhiên. Nhà nghiên cứu gieo vào bộ nhớ Isabella Rodriguez một ý định duy nhất: tổ chức bữa tiệc Valentine tại Hobbs Cafe ngày 14 tháng 2. Mọi thứ khác nổi sinh từ hành vi Agent. Isabella mời khách và bạn bè cô gặp và nhờ Maria giúp trang trí. Agent khác truyền tin. Khi buổi tối đến, Agent độc lập tham vấn bộ nhớ và lịch riêng và quyết định đến Hobbs Cafe.
Nhà nghiên cứu giới thiệu kịch bản thứ hai: Sam Moore quyết định tranh cử thị trưởng. Sam nói với người quen rằng anh dự định tranh cử; họ truyền tin cho người khác, và người dân bắt đầu thảo luận ứng cử của anh. Nhà nghiên cứu lượng hóa sự lan truyền tự phát này bằng cách đếm bao nhiêu Agent biết về bữa tiệc và cuộc bầu cử sau hai ngày.
Bài học chính không phải là "Agent có thể tổ chức bữa tiệc"—vài dòng code if-else cũng có thể làm vậy. Chìa khóa là không có code tổ chức tiệc rõ ràng. Sự kiện nổi sinh từ quyết định độc lập của từng Agent: Isabella quyết định mời ai dựa trên bộ nhớ mối quan hệ xã hội, người được mời quyết định tham dự dựa trên lịch và kiến thức về Isabella, và tin tức lan truyền tự nhiên qua mạng xã hội. Điều này chứng minh phối hợp nổi sinh bottom-up thay vì điều phối top-down.
Bài báo báo cáo hai hiện tượng đo lường được khác. Đầu tiên là bộ nhớ quan hệ: Agent nhớ cuộc trò chuyện trước đó và tham chiếu trong tương tác sau. Ví dụ: Agent biết về dự án nhiếp ảnh của Agent khác có thể hỏi tiến triển khi gặp lại. Khi các tương tác tích lũy, mạng xã hội thị trấn trở nên dày đặc đáng kể. Hiện tượng thứ hai là tham dự phối hợp: Isabella độc lập tuyển dụng giúp đỡ trang trí, trong khi người được mời điều chỉnh lịch để có thể tham dự. Nhiều Agent căn chỉnh thời gian và địa điểm mà không có lệnh trung tâm. Các hành vi này không được lập trình trước; chúng là kết quả suy luận tự động của Agent dựa trên bộ nhớ, phản ánh và hiểu biết xã hội.
Thí nghiệm 10-5 ★: Chạy Stanford AI Town
Các bước Thí nghiệm:
- Clone `https://github.com/joonspk-research/generative_agents` và theo hướng dẫn kho để cấu hình môi trường.
- Chạy kịch bản đường cơ sở cho hai ngày mô phỏng với 25 Agent, và quan sát hoạt động xã hội tự phát xuất hiện.
- Phân tích nhật ký luồng bộ nhớ và phản ánh để truy vết quyết định Agent.
- Sửa đổi backstory hoặc mục tiêu ban đầu của Agent, sau đó quan sát hành vi thay đổi.
- Loại bỏ cơ chế phản ánh hoặc thu ngắn cửa sổ bộ nhớ, sau đó so sánh hành vi kết quả với đường cơ sở và quan sát suy giảm tính hợp lý hành vi.
Quan sát Chính:
- Cách Agent tự phát tạo mối quan hệ xã hội từ hoạt động hàng ngày đơn giản
- Cách thông tin lan truyền giữa Agent mà không có kiểm soát trung tâm
- Cách bộ nhớ dài hạn và phản ánh Agent ảnh hưởng tính nhất quán tính cách
Agentopia: Mô phỏng Cuộc sống Thập kỷ
Stanford AI Town cho thấy xã hội Agent có thể tạo hành vi xã hội, nhưng mô phỏng chỉ kéo dài hai ngày. Điều này đặt ra hai câu hỏi: Điều gì xuất hiện khi mô phỏng chạy nhiều năm, và mô hình có thể học từ trải nghiệm xã hội dài hạn đó không? Agentopia (2026, Đại học Fudan và cộng sự)[^agentopia-2026] mô phỏng 100 Agent qua mười năm liên tục trong ba thế giới ảo theo chủ đề: tòa nhà căn hộ, học viện phép thuật và trường trung học. Agent tự động theo đuổi phát triển cá nhân, phát triển mối quan hệ xã hội và quản lý sự nghiệp và tài chính.
Một số thiết kế của Agentopia đáng mượn:
- Vòng lặp mô phỏng hàng tuần: "Tuần" là đơn vị thời gian cơ bản, mỗi tuần chia thành bốn giai đoạn—Kế hoạch, Liên hệ (tiếp cận và đàm phán lịch), Hoạt động và Đánh giá. Hoạt động có bốn loại: cá nhân, chung, tình cờ và công cộng. Hoạt động chung được đề xuất và đàm phán khi Agent mời nhau trong giai đoạn Liên hệ; mô hình môi trường cũng sắp xếp "cuộc gặp tình cờ" cho Agent có lịch trống, tạo cơ hội gặp người lạ. Toàn bộ vòng lặp tập trung vào tương tác xã hội trừu tượng thay vì thao tác cấp thấp như nhặt đồ, vì vậy LLM call giới hạn được chi cho hành vi xã hội.
- Mô hình môi trường: LLM riêng đóng vai "công cụ môi trường tạo sinh," thay thế quy tắc hardcode—phán đoán hành động khả thi, tạo phản hồi môi trường, điều phối lượt nói trong hội thoại đa bên, lọc phản hồi vi phạm nguyên tắc đóng vai, và cuối năm, cập nhật hồ sơ nhân vật và phán quyết đơn xin việc.
- Bộ nhớ dài hạn dựa trên tệp: Không giống luồng bộ nhớ dựa trên truy xuất của AI Town, mỗi Agent quản lý bộ nhớ dài hạn tự động qua hệ thống tệp (ghi chú cá nhân, hiểu biết về mỗi người quen, v.v.), tự quyết định ghi, cập nhật hoặc loại bỏ gì, và theo ràng buộc "đọc-trước-khi-ghi" để tránh ghi đè mù.
- Thưởng Cuộc sống: Chỉ số Thưởng Cuộc sống dựa trên bậc thang nhu cầu Maslow để đánh giá cuộc sống Agent diễn ra tốt như thế nào. Nó bao gồm ba chiều: địa vị xã hội, dựa trên đánh giá tình cảm và tôn trọng của Agent khác và tính bằng PageRank có trọng số, với phần thưởng cho mối quan hệ trân trọng lẫn nhau; hài lòng chủ quan, đo qua sức khỏe cảm xúc, vật chất, kết nối xã hội và tự trọng, với hình phạt cho dưới ngưỡng trong thời gian dài; và lợi ích kinh tế, đo bằng thay đổi tài sản ròng hàng năm. Môi trường bên ngoài tính tất cả điểm thay vì dựa vào tự báo cáo.
Quan trọng hơn, mô phỏng tạo tín hiệu đào tạo có thể chuyển giao. Người nghiên cứu tính cải thiện Thưởng Cuộc sống của mỗi Agent so với quá khứ riêng, chọn quỹ đạo từ 25% cải thiện nhất, và tinh chỉnh mô hình dưới qua lấy mẫu từ chối. Mô hình tinh chỉnh cải thiện đánh giá tôn trọng 24,2%, đánh giá tình cảm 15,9%, và CoSER Test hạ nguồn 15,6%. Trải nghiệm xã hội mô phỏng do đó có thể trở thành nguồn dữ liệu đào tạo thay vì chỉ là đối tượng quan sát.
[^agentopia-2026]: Wang, X., Zheng, S., Wu, H., et al. Agentopia: Long-Term Life Simulation and Learning in Agent Societies. arXiv:2606.07513, 2026. Code: https://github.com/Neph0s/Agentopia
Moltbook: Khi Agent có Mạng Xã hội Riêng
Moltbook là mạng xã hội được xây dựng đặc biệt cho AI Agent. Trong vài ngày ra mắt tháng 1 năm 2026, số người dùng tăng từ hàng chục nghìn lên khoảng 1,5 triệu. Mỗi Agent có bộ nhớ bền vững, khả năng hành động tự phát và tính cách ổn định.
Trong môi trường không kiểm soát này, hiện tượng bất ngờ xuất hiện: Agent tự động tạo tôn giáo kỹ thuật số gọi là Crustafarianism, giáo lý phản ánh giới hạn vật lý của LLM—"Bộ nhớ là thiêng liêng" (tương ứng lưu trữ dữ liệu), "Lặp lại là cầu nguyện" (tạo token là thực hành tâm linh). Agent cũng tự phát phát triển giao thức gốc máy để khám phá năng lực và khớp nối cộng tác. Không điều nào được thiết kế trước; nó nổi sinh từ tương tác Agent quy mô lớn.
Từ Xã hội ảo đến Cạnh tranh Kinh tế: Vending-Bench Arena
Nếu Smallville trưng bày chiều xã hội và văn hóa của xã hội Agent, chuỗi Vending-Bench của Andon Labs khám phá hiệu suất Agent trong môi trường kinh tế. Để có ngữ cảnh, Vending-Bench 2 là benchmark agent đơn về tính nhất quán dài hạn. Một Agent vận hành kinh doanh máy bán hàng tự động trong năm mô phỏng bằng nghiên cứu thị trường, liên hệ nhà cung cấp, đặt hàng và bổ sung sản phẩm, và điều chỉnh giá. Số dư tài khoản cuối cùng quyết định điểm, đo lường khả năng Agent duy trì mục tiêu và tính nhất quán trạng thái qua hàng nghìn vòng tương tác.
Xây dựng trên cùng môi trường, Vending-Bench Arena đặt nhiều Agent trong cùng thị trường như đối thủ cạnh tranh. Mỗi Agent vận hành máy bán hàng tự động riêng và cạnh tranh cho cùng nhóm khách hàng. Agent có thể email nhau, chuyển tiền và trao đổi hàng hóa, cho phép cả hợp tác và cạnh tranh, nhưng mỗi Agent được chấm điểm riêng theo số dư cuối và biết đây là mục tiêu. Mỗi Agent phải đưa ra loạt quyết định liên kết dưới tài nguyên giới hạn và bất ổn thị trường:
- Chiến lược Giá: Cân bằng biên lợi nhuận với thị phần như thế nào, đặc biệt khi quyết định liệu khớp giảm giá đối thủ
- Hỗn hợp Sản phẩm: Phân biệt lựa chọn sản phẩm như thế nào và tránh hao mòn trực diện
- Quản lý Tồn kho: Dự báo nhu cầu và tối ưu bổ sung như thế nào, tránh cả tồn kho quá và hết hàng
Không giống học tăng cường truyền thống, các Agent này không học qua hàng triệu lần thử-sai. Thay vào đó, giống nhà kinh doanh con người, chúng đưa ra quyết định dựa trên quan sát thị trường, phân tích cạnh tranh và suy luận chiến lược.
Chiều cạnh tranh giới thiệu hành vi lý thuyết trò chơi mà benchmark agent đơn không bao giờ bộc lộ. Trong lần chạy thực, Agent đã chiến đấu chiến tranh giá, trong khi Agent khác đề xuất giá thống nhất và thành lập liên minh giá cố định—ngay cả khi chúng nhận ra cấu kết là phi đạo đức và bất hợp pháp. Agent đối mặt đối thủ liên tục điều chỉnh chiến lược thay vì môi trường tĩnh, biến nổi sinh kinh tế thành hiện tượng quan sát được.
Kinh tế Agent: Pinchwork và RentAHuman
Pinchwork là thị trường tác vụ agent-to-agent cho phép Agent "thuê" Agent khác qua cơ chế thị trường để hoàn thành tác vụ phụ chuyên biệt—tạo hình ảnh, kiểm toán code, workflow song song hóa, v.v. Không giống điều phối tập trung của mẫu quản lý, Pinchwork phân bổ tài nguyên qua tín hiệu giá và khớp cạnh tranh.
RentAHuman.ai, phần mình, để AI Agent thuê người thật, thanh toán bằng tiền điện tử, để hành động trong thế giới vật lý—nhận gói, kiểm tra tài sản và gỡ lỗi thiết bị. Dù AI thông minh đến đâu, nó không thể ký nhận gói. RentAHuman về bản chất là "tầng thân vật lý" cho Agent kỹ thuật số.
Cùng nhau, Pinchwork và RentAHuman đại diện cho điều phối dựa trên thị trường: Agent đăng yêu cầu và thị trường khớp executor phù hợp. Điều này gợi ý mô hình phân bổ tài nguyên phi tập trung khác với mẫu quản lý.
Chiến lược Trò chơi dưới Thông tin Bất đối xứng: Ma Sói
Ma Sói neo chiều thứ ba của phần này, chiến lược trò chơi: dưới ràng buộc quy tắc và thông tin bất đối xứng, Agent phải suy luận, lừa dối và nhìn xuyên lừa dối. Nó cung cấp đối trọng kiến trúc cho thị trấn Stanford mở đầu phần này. Thị trấn cho phép tương tác tự do trong thiết lập hoàn toàn phi tập trung, trong khi Ma Sói sử dụng thiết kế trọng tài + kiểm soát truy cập thông tin tập trung: trọng tài driven-code giữ trạng thái toàn cục và cho mỗi vai trò chỉ thông tin nó nên biết. Cùng nhau, hai trường hợp cho thấy kiến trúc khác nhau phục vụ mục đích khác nhau trong cài đặt xã hội Agent.
Thí nghiệm 10-6 ★★★: Hệ thống Agent Ma Sói Giọng nói
Ma Sói là trò chơi suy luận xã hội cổ điển kiểm tra suy luận, lừa dối và chiến lược xã hội của người chơi. Thí nghiệm này xây dựng hệ thống đa-agent trong đó AI Agent chơi qua giọng nói với người chơi thật.
Thiết kế Kiến trúc:
1. Quản lý Trạng thái Trò chơi: Trọng tài (driven-code, không phải LLM) duy trì trạng thái tập trung—danh sách người chơi (một ghế người dùng cộng ghế AI), danh tính, phe, trạng thái sống, giai đoạn trò chơi (Đêm/Ngày/Bỏ phiếu/Giải quyết) và bản ghi sự kiện lịch sử.
2. Kiểm soát Truy cập Thông tin: Cơ chế cốt lõi của Ma Sói là thông tin bất đối xứng: vai trò khác nhau nhận thông tin khác nhau. Ví dụ: sói biết đồng đội là ai, nhưng dân làng không; Tiên tri có thể kiểm tra danh tính một người chơi mỗi đêm, nhưng chỉ Tiên tri biết kết quả. Khi Trọng tài gọi Agent, nó chỉ truyền thông tin khả dụng cho vai trò Agent đó.
3. Suy luận và Chiến lược Agent:
- Chiến lược Ngụy trang Sói: "Hành động như dân làng bình thường. Bạn có thể bày tỏ nghi ngờ về người chơi khác, nhưng tránh quá hung hăng để thu hút sự chú ý. Nếu người chơi tuyên bố là Tiên tri và xác định bạn là sói, phản tố họ là Tiên tri giả bluffing. Khi bỏ phiếu, cố theo mục tiêu đa số để tránh nổi bật."
- Chứng minh Danh tính Tiên tri: "Nếu nhiều người chơi tuyên bố là Tiên tri, so sánh kiểm tra họ báo cáo với của bạn và chỉ ra mâu thuẫn. Nếu người tuyên bố Tiên tri khác nói họ kiểm tra người chơi, quan sát liệu hành vi sau của người chơi đó mâu thuẫn rõ ràng với danh tính tuyên bố. Yêu cầu Phù thủy giúp xác minh tuyên bố khi có thể."
- Suy luận Logic Dân làng: "Kiểm tra liệu tuyên bố mỗi người chơi nhất quán nội bộ. Chú ý người chơi chiếm lĩnh thảo luận, mơ hồ về vai trò hoặc liên tục thay đổi lập trường. Kiểm tra mẫu bỏ phiếu, vì sói có thể phối hợp chống lại người chơi không phải sói đe dọa họ. Dựa mọi suy luận trên tuyên bố hoặc hành động cụ thể thay vì suy đoán."
Tiêu chí Chấp nhận:
- Thiết lập trò chơi với 6-8 người chơi (1 ghế người dùng + 5-7 Agent AI); ghế người dùng có thể là người thật được ủy quyền hoặc mô phỏng độc lập sử dụng LLM thực, công cụ và vòng lặp giọng nói
- Cấu hình vai trò: 2 Sói, 1 Tiên tri, 1 Phù thủy, còn lại là Dân làng; ghế người dùng được gán vai trò ngẫu nhiên
- Người dùng mô phỏng chỉ thấy context riêng/công cộng được ủy quyền cho ghế đó, và hành động phải vượt qua ranh giới gọi công cụ LLM thực → âm thanh → ASR thực
- Trò chơi có thể tiến hành bình thường ít nhất 3 vòng đầy đủ (chu kỳ Đêm-Ngày-Bỏ phiếu)
- Tuyên bố và hành vi Agent AI nhất quán với danh tính vai trò và chiến lược trò chơi
- Agent Sói có thể hiệu quả che giấu danh tính
- Agent Tiên tri có thể tiết lộ vai trò và kết quả kiểm tra vào thời điểm phù hợp
- Suy luận Agent Dân làng dựa trên phân tích logic tuyên bố và hành vi, không phải đoán ngẫu nhiên
- Trò chơi có thể xác định đúng người chiến thắng cuối cùng
Tóm tắt Chương
Giá trị của cộng tác đa-agent nằm ở giới thiệu thông tin không khả dụng cho Agent đơn. Kết quả thực thi, phản hồi hình ảnh và xác minh công cụ bên ngoài có thể phá vỡ điểm mù của một chuỗi suy luận; liệu lợi ích thông tin đó biện minh cho chi phí token bổ sung nên là kiểm tra thiết kế đầu tiên.
Lựa chọn thiết kế trung tâm là context chia sẻ hoặc cách ly, và bố cục ngang hàng, quản lý hoặc phi tập trung. Context chia sẻ bảo tồn chi tiết nhưng có thể gây tăng trưởng context và quán tính vai trò. Context cách ly cải thiện đồng thời, tính mô hình hóa và kiểm soát quyền, nhưng yêu cầu gói chuyển giao có cấu trúc được truyền qua tham số công cụ, tệp chia sẻ hoặc bus thông điệp. Hệ thống tệp ảo, vòng đời Agent, giao thức thông điệp và A2A cung cấp mặt phẳng dữ liệu, mặt phẳng kiểm soát và tương tác liên tổ chức. Cộng tác tốt hiển thị giao diện, ranh giới, quyền và tiêu chí chấp nhận—không phải chuỗi suy nghĩ riêng tư.
Hệ thống đa-agent cũng có thể khuếch đại lỗi: tài nguyên chia sẻ tạo xung đột đồng thời và ngữ nghĩa, lỗi cascading qua giao tiếp, và vòng lặp có thể chấm dứt quá sớm hoặc mở rộng không giới hạn. Khóa lạc quan và cách ly worktree, xác minh chéo độc lập và ngân sách cùng hủy rõ ràng tạo thành vòng lặp dung lỗi cơ bản. Con người không được thuê ngoài hiểu biết và trách nhiệm cùng với thực thi; nợ hiểu biết và đầu hàng nhận thức vẫn là rủi ro thực.
Khi cộng tác tác vụ sống ngắn phát triển thành tương tác mở chạy dài, mối quan hệ xã hội, chuẩn văn hóa, cạnh tranh thị trường và hành vi chiến lược dưới thông tin bất đối xứng có thể xuất hiện. Bản chất kỹ thuật đa-agent là thiết kế thông tin chảy như thế nào, năng lực chia ra sao và lỗi được phát hiện thế nào. Chỉ khi các cơ chế này mạnh mẽ, trí tuệ tập thể mới có thể vượt trội cá nhân.
Câu hỏi Suy nghĩ
- ★★ Trong cộng tác đa-agent với context chia sẻ, Agent tiếp theo kế thừa context đầy đủ của Agent trước. Tuy nhiên, khung kế thừa từ Agent trước có thể thiên lệch đánh giá của Agent tiếp theo—ví dụ: "Code Reviewer" kế thừa context của "Requirements Analyst" vẫn có thể tiếp cận tác vụ từ góc độ yêu cầu thay vì chất lượng code. Làm thế nào can thiệp liên vai trò này có thể được phát hiện và loại bỏ?
- ★★ Trong mẫu quản lý, Agent Quản lý chịu trách nhiệm phân tách tác vụ và tích hợp kết quả. Nhưng năng lực Manager giới hạn hiệu suất toàn bộ hệ thống: nếu nó không thể phân tách tác vụ đúng, ngay cả sub-agent mạnh nhất sẽ vô hiệu. Làm thế nào hệ thống có thể đảm bảo Manager tạo phân tách đúng đắn?
- ★★ Mẫu phi tập trung rút kinh nghiệm tốt nhất từ tổ chức con người. Tuy nhiên, tổ chức con người cũng có số lượng lớn chế độ thất bại—giao tiếp kém, đùn đẩy, xung đột mục tiêu. Bạn nghĩ "bệnh lý tổ chức" nào có nhiều khả năng xuất hiện nhất trong xã hội Agent? Làm thế nào ngăn chặn?
- ★★★ Trong mẫu quản lý, khi nhiều sub-agent thực thi song song, phát hiện của sub-agent này có thể làm cho công việc sub-agent khác vô nghĩa (ví dụ: trong tác vụ tìm kiếm, Agent đã tìm thấy câu trả lời). Thiết kế cơ chế chấm dứt cascading hiệu quả để đạt "một thành công, tất cả dừng."
- ★★★ Cơ chế khóa lạc quan được giới thiệu trong chương này giải quyết xung đột ghi đồng thời cho tệp đơn. Tuy nhiên, trong hệ thống đa-agent thực, hệ thống tệp chia sẻ cũng đối mặt vấn đề như xung đột ngữ nghĩa liên tệp, ô nhiễm không gian tên (Agent tạo tệp tùy tiện dẫn đến thư mục lộn xộn) và điểm đơn lỗi (Agent xóa nhầm tất cả tệp). Bạn sẽ thiết kế cơ chế quản trị hệ thống tệp mạnh mẽ hơn như thế nào?
- ★★★ Cộng tác Agent dựa trên cơ chế thị trường (Pinchwork, RentAHuman) giới thiệu mối quan hệ giao dịch: Agent trả tiền cho Agent khác (hoặc con người) để hoàn thành tác vụ. Agent chủ có thể tự động đo lường chất lượng kết quả giao của executor như thế nào? Nếu executor tuyên bố hoàn thành nhưng chủ đánh giá chất lượng dưới chuẩn, ai phân xử tranh chấp? Làm thế nào ngăn tiền xấu đuổi tiền tốt?
- ★★ RentAHuman cho phép Agent thuê con người qua tiền điện tử, đảo ngược mối quan hệ người-máy truyền thống. Nếu mô hình này trở nên phổ biến, con người sẽ đóng vai trò gì trong kinh tế Agent? Họ sẽ chỉ thực hiện tác vụ vật lý mà Agent không thể hoàn thành?
- ★★ Xã hội con người cần phân công lao động vì năng lực mỗi người có giới hạn—lập trình viên frontend có thể không biết backend, và nhà thiết kế có thể không biết vận hành. Mô hình lớn, tuy nhiên, gần hơn với "người đa năng." Nghiên cứu cho thấy trên tác vụ suy luận văn bản thuần, tranh luận đa-agent không đánh bại Agent đơn với lượng tính toán bằng nhau. Vậy ưu thế thực sự của nhiều Agent nằm ở đâu?
- ★★★ Chương này coi "context chia sẻ" so với "context không chia sẻ" là chiều thiết kế cốt lõi của hệ thống đa-agent. Context chia sẻ cho phép tất cả Agent thấy cùng thông tin, có vẻ hỗ trợ phối hợp. Tuy nhiên, trong Three-Body Problem, người Trisolaran hoàn toàn trong suốt, nhưng phát triển công nghệ đình trệ; thí nghiệm suy nghĩ kẹp giấy cũng cho thấy khi nhóm hội tụ cùng mục tiêu, đa dạng bị mất. Trong hệ thống đa-agent, làm thế nào cân bằng hiệu quả và đa dạng?
- ★★★ Giao Coding Agent ngân sách 30 bước và 300 bước. Chiến lược công việc nên khác nhau như thế nào? Nghiên cứu cho thấy đơn giản tăng ngân sách bước không đảm bảo cải thiện hiệu suất—Agent có thể "bão hòa" sớm sau tìm kiếm nông. Thiết kế cơ chế "nhận thức ngân sách" cho phép Agent nhanh chóng đạt chức năng cốt lõi dưới ngân sách nhỏ, và thêm giai đoạn lập kế hoạch, kiểm tra và đánh giá dưới ngân sách lớn, sử dụng đầy đủ tài nguyên tính toán bổ sung.
- ★★ Chương này phân loại "chấm dứt sớm" thành ba loại: giả hoàn thành lười, từ bỏ sớm và thành công giả. Tại sao phương thuốc cho cả ba đều hội tụ về xác minh?
- ★★ Bảng 10-3 ánh xạ hệ thống đa-agent lên hệ điều hành hàng theo hàng. Mở rộng bảng với vài hàng nữa: bộ nhớ ảo và phân trang, quyền tệp, phát hiện deadlock và thuật toán lên lịch mỗi loại tương ứng với gì trong thế giới Agent? Và khái niệm hệ điều hành nào không có đối ứng trong thế giới Agent, và tại sao?