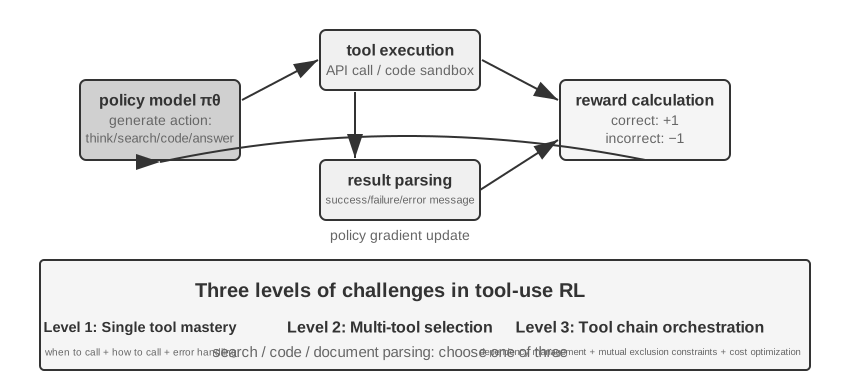
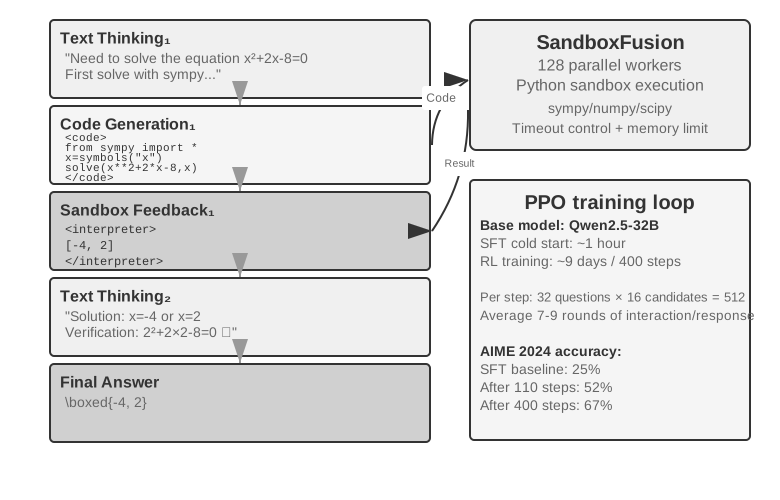
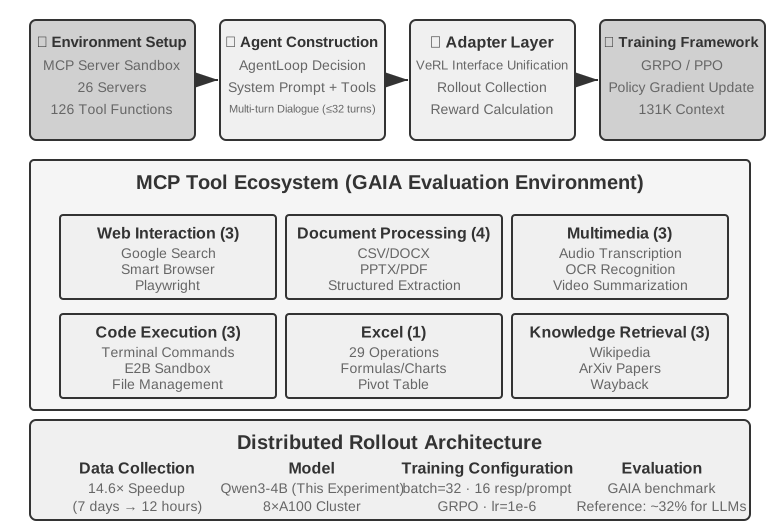
Bản sửa đổi 2026. Chương sửa đổi làm rõ phạm vi của "SFT ghi nhớ, RL khái quát hóa": đó là một quan sát từ các phép so sánh có kiểm soát GeneralPoints/V-IRL, không phải một quy luật phổ quát. Chương cũng tách biệt giá trị trả về công cụ được mô phỏng bởi mô hình và động lực môi trường được mô phỏng, đồng thời coi độ lệch của trình mô phỏng như trần huấn luyện.
Hai lộ trình hiệu quả mẫu được nhấn mạnh: On-Policy Distillation biến phần thưởng cuối cùng của một lần chạy thành hướng dẫn cấp Token; RLVP biến phản hồi đường dẫn bị lãng phí thành tín hiệu học được. Khi không có giáo viên mạnh hơn, OPSD sử dụng thông tin đặc quyền với cùng một mô hình đóng vai trò cả giáo viên lẫn học sinh.
Thứ tự thí nghiệm trong phiên bản này: 7-13 SimpleVLA-RL; 7-14 ReTool; 7-15 AWorld-train; 7-16 RLVP.
Công thức cốt lõi của cuốn sách này là Agent = LLM + Context + Tools. Chương này chuyển sang bản thân LLM—"bộ não"—và xem xét cách tinh chỉnh sau huấn luyện có thể giúp mô hình sử dụng Context và Tools hiệu quả hơn, từ đó cải thiện năng lực của toàn bộ hệ thống Agent. Phần cuối Chương 6 đã chỉ ra rằng hệ thống đánh giá và môi trường mô phỏng là hai nền tảng của tinh chỉnh sau huấn luyện: môi trường đánh giá cho huấn luyện bãi tập luyện, và các chỉ số đánh giá cho mục tiêu. Chương này xây dựng trên những nền tảng đó và thảo luận cách thực sự thay đổi trọng số mô hình—cách đưa năng lực vào các tham số.
Chương này giả định không có nền tảng về học tăng cường hay huấn luyện mô hình. Chúng tôi không mong bạn biết gradient hay tối ưu hóa chính sách. Thay vào đó, chúng tôi bắt đầu từ câu hỏi làm thế nào một mô hình được huấn luyện, làm rõ mỗi bước dùng để làm gì, nó hoạt động như thế nào, và nó giải quyết vấn đề gì. Đến cuối chương, bạn có thể trả lời các câu hỏi sau: Năng lực mô hình được hình thành ở giai đoạn nào? Mỗi giai đoạn làm gì? Các giai đoạn thường được kết hợp như thế nào, và thứ tự có thể khác khi nào? Và bạn nên tập trung nỗ lực vào đâu trong dự án của riêng mình?
Trước tiên, hãy thiết lập bản đồ quan trọng nhất: phát triển mô hình hiện đại thường được mô tả trong ba giai đoạn. Pre-training đặt nền tảng, trong khi SFT và RL là các giai đoạn post-training được chọn hoặc kết hợp tùy theo mục tiêu, mô hình gốc và yêu cầu đầu ra:
Pre-training: Huấn luyện trên văn bản internet khổng lồ để "dự đoán Token tiếp theo." Bước này dạy mô hình quy tắc ngôn ngữ, kiến thức thế giới và lý luận cơ bản. Giống như một người đã đọc tất cả sách trong thư viện—uyên bác, nhưng chưa giỏi trả lời câu hỏi. Đây là bước đắt nhất (thường hàng chục triệu đô la) và là nền tảng của mọi năng lực.
Supervised Fine-Tuning (SFT): Huấn luyện mô hình trên các cặp đầu vào-đầu ra có nhãn, giống như giáo viên cho học sinh câu trả lời chuẩn để bắt chước. Hàng nghìn đến hàng chục nghìn ví dụ hỏi-đáp chuẩn dạy mô hình định dạng, phong cách và quy trình khi phản hồi. Bước này biến mô hình uyên bác thành trợ lý hiểu hướng dẫn và tạo đầu ra có cấu trúc tốt. Nó rẻ, nhanh và ổn định, và hiện là bước mà gần như tất cả mô hình triển khai đều trải qua.
Reinforcement Learning (RL): Để mô hình thử đi thử lại và cải thiện từ phần thưởng và hình phạt, giống như huấn luyện chó con (khen khi làm đúng, không gì khi làm sai). Thay vì bắt chước trực tiếp các Token của câu trả lời chuẩn, RL để mô hình tự thử, tăng xác suất hành vi tốt và giảm xác suất hành vi kém. Với phần thưởng, dữ liệu và môi trường phù hợp, bước này có thể cải thiện quyết định trong các tình huống chưa thấy—và nó cũng là bước chiếm nhiều không gian nhất trong chương này và đòi hỏi nhiều nỗ lực kỹ thuật nhất.
Một phép loại suy trực giác: Pre-training là "đọc vạn cuốn sách" (tích lũy kiến thức), SFT là "giáo viên hướng dẫn giải bài chuẩn" (bắt chước trình diễn), và RL là "tự giải bài và mài giũa từ đúng sai" (học bằng thử và sai). Pre-training rồi SFT rồi RL là phổ biến, nhưng không phải là trình tự duy nhất: một mô hình gốc mạnh có thể đi thẳng đến RL, trong khi một nhiệm vụ chỉ cần định dạng và phong cách ổn định có thể chỉ dùng SFT.
Chương này có hai mạch chủ đề xuyên suốt. Xin hãy ghi nhớ chúng, vì tất cả nội dung tiếp theo phục vụ cho chúng:
Mạch Một: Trong các thí nghiệm có kiểm soát của chương này, SFT có xu hướng ghi nhớ trình diễn trong khi RL khái quát hóa tốt hơn. Dưới cùng nhiệm vụ, mô hình và ngân sách trong GeneralPoints và V-IRL, SFT quá khớp câu trả lời huấn luyện, trong khi RL thường học chiến lược có thể chuyển giao dưới các phân phối kiểm tra dịch chuyển. Đây là kết quả đo được trong các điều kiện thí nghiệm đó, không phải thuộc tính phổ quát của SFT và RL: SFT có thể khái quát hóa với dữ liệu đa dạng và regularization phù hợp, và RL có thể quá khớp khi phần thưởng hoặc môi trường bị lệch. Chương này sử dụng "SFT ghi nhớ, RL khái quát hóa" như viết tắt cho các thí nghiệm này, và Mục 7.1 giải thích tại sao hai mục tiêu có thể tạo ra sự khác biệt đó.
Mạch Hai: Dữ liệu và môi trường quan trọng hơn thuật toán. Đây là bài học counterintuitive nhất và có giá trị nhất của ngành. Với các thuật toán RL có sẵn (PPO, GRPO và tương tự), biết cách sử dụng chúng là đủ. Điều thực sự quyết định thành công là hai thứ: môi trường mô phỏng (bãi tập có đủ thực tế không?) và dữ liệu huấn luyện (các trình diễn và tín hiệu phần thưởng có đủ tốt không?). Trong nhiều kịch bản, nếu dữ liệu SFT đủ tốt, bạn có thể không cần RL. Chương này sẽ liên tục chuyển sự chú ý của bạn từ "nên tinh chỉnh thuật toán nào?" sang "dữ liệu và môi trường đã được thiết lập đúng chưa?"
Hướng dẫn đọc: Nội dung chương này được chia thành hai lộ trình dựa trên nền tảng người đọc:
Nhà phát triển ứng dụng Agent (không cần tự huấn luyện mô hình): Bắt đầu bằng đọc phần mở đầu "Pre-training, SFT, RL: Toàn cảnh ba giai đoạn" để xây dựng hiểu biết tổng thể. Sau đó bạn có thể bỏ qua hai phần [Đọc tùy chọn] sau (RL cổ điển và nền tảng pre-training) và tiếp tục từ phần SFT. Tập trung vào khung quyết định cho "sự khác biệt cốt lõi giữa SFT và RL" và "khi nào chọn SFT so với RL," cũng như nhận định rằng "dữ liệu và môi trường quan trọng hơn thuật toán"—các hiểu biết này sẽ ảnh hưởng đến quyết định thiết kế trong kỹ thuật Harness (khi nào giải quyết bằng Prompt, khi nào fine-tuning đáng giá).
Kỹ sư huấn luyện mô hình: Đọc tuần tự từ đầu. Hai phần [Đọc tùy chọn] cung cấp nền tảng đầy đủ về học tăng cường và pre-training. Các thí nghiệm tiếp theo cung cấp các sơ đồ huấn luyện có thể tái tạo.
Pre-training, SFT, RL: Toàn cảnh ba giai đoạn
Phần giới thiệu đã cho bạn bản đồ của ba giai đoạn; phần này đi sâu vào cơ chế của từng giai đoạn. Ba giai đoạn khác nhau về dữ liệu, mục tiêu tối ưu hóa và chi phí. Hiểu điểm giống và khác là chìa khóa cho toàn bộ chương. Bảng 7-1 cho cái nhìn tổng quan; chi tiết theo sau.
Bảng 7-1 Ba giai đoạn rèn luyện năng lực mô hình
Giai đoạn
Dữ liệu sử dụng
Mục tiêu tối ưu hóa
Điều gì được học
Chi phí điển hình
Pre-training
Văn bản internet thô khổng lồ
Dự đoán Token tiếp theo
Quy tắc ngôn ngữ, kiến thức thế giới, lý luận cơ bản
Rất cao (vài triệu đến hàng chục triệu USD)
SFT
Hàng nghìn đến hàng chục nghìn cặp trình diễn "đầu vào-đầu ra"
Dự đoán Token tiếp theo (tổn thất chỉ tính trên phần trả lời)
Tuân thủ hướng dẫn, định dạng đầu ra, phong cách, quy trình
Thấp (vài giờ đến vài ngày)
RL
Nhiệm vụ và môi trường + tín hiệu phần thưởng (câu trả lời tham chiếu là tùy chọn)
Tối đa hóa phần thưởng kỳ vọng
Chiến lược ra quyết định có thể chuyển giao, giải pháp mới được khám phá
Cao (thường gấp mười đến trăm lần SFT)
Pre-training làm gì: Dự đoán Token tiếp theo
Tất cả "trí thông minh" của các mô hình lớn hiện đại được xây dựng trên một nhiệm vụ đơn giản đến bất ngờ: Next Token Prediction (NTP).
Cho mô hình xem phần đầu của văn bản và bảo nó đoán Token tiếp theo. Ví dụ, với đầu vào "Thủ đô của Trung Quốc là," mô hình nên gán xác suất cao cho "Bắc Kinh." Mỗi lần mô hình đoán, nó so sánh dự đoán với Token thực tế tiếp theo. Sự khác biệt càng lớn (gọi là loss), nó càng điều chỉnh tham số để đoán chính xác hơn trong các ngữ cảnh tương tự. Bằng cách lặp lại điều này trên hàng nghìn tỷ Token văn bản internet, mô hình bị bắt buộc phải học ngữ pháp, sự thật, logic và thậm chí cả lý luận cơ bản—vì để đoán đúng Token tiếp theo trên phạm vi ngữ cảnh rộng lớn, không có shortcut; nó phải thực sự "tiêu hóa" các mẫu trong văn bản.
Có một điểm quan trọng cần ghi nhớ sẽ贯穿 đến SFT và RL: Đầu ra của mô hình本质上 là một phân phối xác suất. Cho văn bản phía trước, mô hình gán xác suất cho mọi Token có thể trong từ điển của nó. "Huấn luyện," ở cốt lõi, là điều chỉnh phân phối xác suất này—làm cho xác suất của các Token mong muốn cao hơn và không mong muốn thấp hơn. Sự khác biệt giữa ba giai đoạn chỉ nằm ở "cái gì được mong muốn" và "tín hiệu nào xác định 'mong muốn.'"
Sau pre-training, mô hình uyên bác nhưng chưa thân thiện với người dùng: nếu bạn hỏi nó một câu, nó có thể tiếp tục tạo thêm câu hỏi thay vì trả lời—vì trong văn bản internet, một câu hỏi thường theo sau bởi một câu hỏi khác. Nó chưa học được quy trình "khi được hỏi, bạn nên trả lời."
Bản chất của SFT: "Dự đoán Token tiếp theo" với dữ liệu khác
Đây là hiểu biết đầu tiên cần nắm trong chương này: Về mặt toán học, SFT và pre-training là cùng một nhiệm vụ—cả hai đều dự đoán Token tiếp theo và tối thiểu hóa cùng hàm loss. Nhiều người mới nghĩ SFT là một phương pháp hoàn toàn mới, nhưng không phải. Sự khác biệt giữa SFT và pre-training chỉ nằm ở hai điểm:
Dữ liệu khác. Pre-training sử dụng văn bản internet thô (không cấu trúc, chứa mọi thứ); SFT sử dụng các cặp "đầu vào-đầu ra" được chuẩn bị cẩn thận, được định dạng thống nhất thành "câu hỏi người dùng → câu trả lời lý tưởng." Mô hình tiếp tục "dự đoán Token tiếp theo" trên các trình diễn này, từ đó học quy trình "cách cấu trúc phản hồi khi được hỏi."
Loss chỉ tính trên "phần trả lời" (loss masking). Một mẫu SFT gồm câu hỏi và câu trả lời có nhãn. Chúng tôi không muốn mô hình học "cách đặt câu hỏi," chỉ "cách trả lời." Vì vậy, khi tính loss, các Token trong phần câu hỏi bị che, và gradient chỉ lan truyền ngược qua phần trả lời. Đây là sự khác biệt kỹ thuật duy nhất giữa SFT và pre-training.
Khi bạn thấy điều này, trở nên rõ ràng tại sao SFT có thể表现出 ghi nhớ trên trình diễn有限: mục tiêu tối ưu hóa của nó là tối đa hóa xác suất của mọi Token trong câu trả lời có nhãn, tái tạo trình diễn càng chính xác càng tốt. Đối với các nhiệm vụ có mục tiêu rõ ràng và định dạng cố định, điều này cực kỳ hiệu quả—một vài nghìn ví dụ là đủ. Nhưng khi độ phủ và tính đa dạng không đủ, mô hình có thể quá khớp các mẫu bề mặt hoặc shortcut trong trình diễn và mất hiệu suất dưới phân phối dịch chuyển.
Tóm lại, SFT sử dụng hiệu quả mẫu cực cao để mã hóa ánh xạ đầu vào-đầu ra ổn định và quy trình vào tham số mô hình. Nó mã hóa kiến thức quy trình—cách nói hoặc làm gì đó, bao gồm định dạng, phong cách và quy trình—chứ không phải lượng lớn kiến thức事实—mô hình biết gì. Phần sau dựa vào pre-training hoặc RAG (chúng tôi sẽ quay lại sự phân biệt này ở cuối chương).
Chi phí huấn luyện: Tinh chỉnh tham số hiệu quả LoRA. Cả SFT và RL tiếp theo đều yêu cầu cập nhật tham số mô hình, và fine-tuning toàn tham số có yêu cầu VRAM cao (cần lưu trữ gradient và trạng thái tối ưu hóa cho hàng tỷ tham số). LoRA (Low-Rank Adaptation) là phương pháp tiết kiệm chi phí phổ biến nhất: thay vì sửa đổi các ma trận trọng số gốc lớn, nó gắn một "bản vá" nhỏ (ma trận hạng thấp) để học nhiệm vụ. Số lượng tham số chỉ 1%–5% so với gốc, nhưng có thể接近 hiệu suất fine-tuning toàn phần. Vì trọng số gốc bị đóng băng, LoRA cũng gây ít nhiễu loạn hơn cho năng lực hiện có của mô hình gốc, giảm nguy cơ quên thảm họa. Một vài quy tắc thực tế đã được xác nhận: Bạn phải áp dụng LoRA cho tất cả các ma trận trọng số chính (đặc biệt là các lớp MLP, có số lượng tham số lớn nhất); chỉ áp dụng cho các lớp attention sẽ mất độ chính xác. Tốc độ học tối ưu khoảng gấp 10 lần so với fine-tuning toàn phần (đúng cho cả SFT và RL, một quy tắc chuyển giao rất thực tế). Sử dụng rank trung bình-cao (64–256) cho SFT; vì thông tin mỗi vòng nhỏ cho RL, rank nhỏ (8–32) hoặc thậm chí rank=1 là đủ. Trong triển khai, một máy chủ suy luận duy nhất có thể tải nhiều adapter LoRA cùng lúc cho dịch vụ đa thuê bao. Cuốn sách này coi LoRA là lựa chọn kỹ thuật mặc định cho tất cả các phương pháp post-training và sẽ không trình bày riêng.
Khi nào SFT nên đi trước RL
Pre-training cung cấp nền tảng ngôn ngữ và kiến thức. Điều cần giải thích là: Trong điều kiện nào SFT nên đi trước RL?
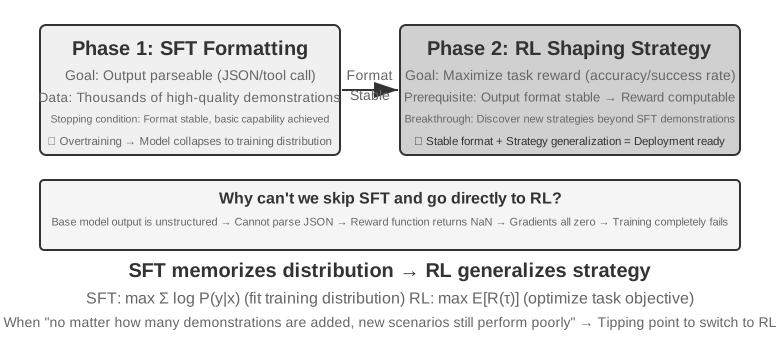
Câu trả lời nằm ở cách RL hoạt động. Thay vì bắt chước trực tiếp các Token của câu trả lời tham chiếu, một chính sách RL học bằng cách đánh giá các phản hồi được tạo ra của chính nó với tín hiệu phần thưởng; câu trả lời tham chiếu hoặc dữ liệu preference vẫn có thể đóng góp vào phần thưởng đó. Nhưng để đánh giá chất lượng, trước tiên bạn cần có thể phân tích đầu ra của mô hình: nếu nhiệm vụ yêu cầu đối tượng JSON hoặc lệnh gọi công cụ và mô hình tạo ra văn bản định dạng kém, hàm phần thưởng thậm chí không thể phân biệt thành công và thất bại, và RL không thể học.
Khi đầu ra có cấu trúc不稳定, SFT có thể làm cho mô hình tạo ra đầu ra có định dạng tốt trước: một số lượng nhỏ trình diễn ổn định định dạng để có thể phân tích đáng tin cậy, cho RL một điểm bắt đầu có thể chấm điểm. Đây là một paradigm "SFT trước, rồi RL" hai giai đoạn mạnh mẽ. Trong thiết lập như vậy, bỏ qua SFT có thể khiến đầu ra不稳定, biến tín hiệu phần thưởng thành nhiễu, và khiến huấn luyện thất bại. Mượn một khái niệm từ hội họa Trung Quốc: SFT trước tiên thiết lập "hình thức" (định dạng, cấu trúc), rồi RL theo đuổi "tinh thần" (chiến lược, khái quát hóa)—hình thức trước, tinh thần sau.
Một điều kiện ranh giới quan trọng: "SFT phải đi trước" đúng trong thiết lập "mô hình gốc nhỏ hơn + đầu ra có cấu trúc nghiêm ngặt" (Thí nghiệm 7-11 sẽ cho thấy mô hình ở quy mô Llama-3.2-Vision-11B thất bại hoàn toàn nếu RL được áp dụng trực tiếp mà không có SFT). Tuy nhiên, nếu mô hình gốc đủ mạnh, nó có thể tạo ra đầu ra đủ tốt ngay từ đầu, cho phép bỏ qua SFT—DeepSeek-R1-Zero đã chứng minh rằng RL trực tiếp có thể thành công với mô hình gốc mạnh, với phản tư và chuỗi suy nghĩ dài xuất hiện tự nhiên. Chi phí là khả năng đọc đầu ra kém và trộn lẫn tiếng Trung/tiếng Anh, nên cuối cùng DeepSeek đã thêm lại "SFT khởi động lạnh" trong R1 để tái thiết lập "hình thức." Hành trình của R1 từ Zero đến khởi động lạnh là minh họa tốt nhất cho "hình thức trước, tinh thần sau."
Sự khác biệt cốt lõi giữa SFT và RL (Bảng quan trọng nhất chương này)
Chúng tôi đã dùng "SFT ghi nhớ, RL khái quát hóa" để tóm tắt các thí nghiệm có kiểm soát của chương này. Bây giờ hãy giải thích tại sao xu hướng đó có thể xuất hiện. Chìa khóa là mục tiêu tối ưu hóa khác nhau:
SFT tối đa hóa xác suất của câu trả lời có nhãn. Maximum likelihood đẩy mô hình tái tạo trình diễn cho mỗi mẫu huấn luyện. Các trình diễn đa dạng, đại diện có thể dạy các特征 có thể khái quát hóa, nhưng trình diễn有限 hoặc Prompt cũng có thể tạo ra quá khớp với mẫu bề mặt hoặc shortcut. Trong GeneralPoints, các trình diễn有限 coi J/Q/K là 10, và hiệu suất giảm khi các giá trị đó thay đổi khi kiểm tra.
RL tối đa hóa phần thưởng kỳ vọng. Mô hình khám phá các đường dẫn và tăng xác suất của những đường dẫn獲得 phần thưởng cao. Khi phần thưởng đại diện trung thành cho mục tiêu và khám phá đủ, nó có thể发现 các chiến lược có thể chuyển giao không có trong trình diễn. Trong GeneralPoints, tính lại câu trả lời khi giá trị thay đổi tạo ra hiệu suất ngoài phân phối tốt hơn. Ngược lại, phần thưởng hoặc môi trường偏 cũng có thể khiến RL hợ với shortcut.
Bảng 7-2 So sánh cốt lõi SFT và RL
Chiều
SFT (Supervised Fine-Tuning)
RL (Reinforcement Learning)
Mục tiêu tối ưu hóa
Tối đa hóa xác suất câu trả lời có nhãn (Maximum Likelihood)
Tối đa hóa phần thưởng kỳ vọng
Tín hiệu huấn luyện
Giám sát cấp Token trên câu trả lời có nhãn
Phản hồi/đường dẫn được tạo bởi chính sách + phần thưởng vô hướng cấp kết quả hoặc cấp bước
Định dạng dữ liệu
Cặp trình diễn "đầu vào-đầu ra"
Nhiệm vụ và môi trường + tín hiệu phần thưởng (câu trả lời tham chiếu là tùy chọn)
Áp lực tối ưu hóa trực tiếp
Bắt chước ánh xạ và quy trình trong trình diễn
Tăng cường hành vi và chiến lược獲得 phần thưởng
Dưới phân phối dịch chuyển
Phụ thuộc vào độ phủ trình diễn và regularization; trình diễn有限 quá hợ trong thí nghiệm này
Phụ thuộc vào phần thưởng, môi trường và khám phá; chuyển giao tốt hơn trong thí nghiệm này
Hiệu quả mẫu
Cao (vài nghìn ví dụ có hiệu quả)
Thấp (thường gấp mười đến trăm lần SFT)
Ổn định huấn luyện
Cao, hội tụ nhanh
Thấp, dễ振荡, cần tinh chỉnh cẩn thận
Phù hợp nhất cho
Cố định hóa định dạng/phong cách/quy trình, trình diễn chất lượng cao, môi trường ổn định
Cần khái quát hóa sang kịch bản mới, khám phá chiến lược tối ưu, chi phí标注 cao
Post-training cũng塑造 thời điểm mô hình hành động. Các mô hình coding cung cấp một ví dụ cụ thể: các mô hình họ GPT và họ Claude thường表现出 ngưỡng hành động mặc định khác nhau.前者 có thể đọc nhiều hơn kho lưu trữ trước khi chỉnh sửa;后者 có thể定位 từ ít tệp hơn, triển khai trước, rồi dùng phản hồi kiểm tra để điều chỉnh hướng. Đây không phải là vấn đề nhân hóa một mô hình là "cẩn thận" và另一个 là "bản năng." Đó là một chính sách trong các tham số估计 liệu giá trị kỳ vọng của việc đọc thêm một tệp có vượt quá giá trị kỳ vọng của việc提交 và xác thực bản vá hiện tại hay không. Nếu trình diễn SFT反复 điều tra广泛 trước khi chỉnh sửa, mô hình bắt chước ngưỡng hành động cao hơn. Nếu phần thưởng quá trình hoặc kết quả反复 xác thực定位 nhanh và vòng lặp có thể xác minh sớm, khối lượng xác suất chuyển sang hành động sớm hơn. Thí nghiệm 6-7 hoán đổi mô hình bên trong cùng một Harness coding trung tính và đo hành vi này thay đổi theo mô hình: Harness không cần强制 quy trình làm việc để mô hình tự mang chính sách sử dụng công cụ ổn định riêng. Harness có thể sửa đổi chính sách, nhưng nguồn chính của nó có thể nằm trong các tham số post-training. Vì các nhà cung cấp không公布 đầy đủ dữ liệu và công thức phần thưởng, thí nghiệm thiết lập sự khác biệt hành vi phía mô hình, chứ không phải thuật toán riêng biệt cụ thể gây ra nó.
Một cơ chế sâu hơn đáng biết: tìm kiếm chế độ (mode-seeking). Phân phối xác suất của tất cả câu trả lời có thể cho một câu hỏi có thể chứa nhiều chế độ, mỗi chế độ đại diện cho một nhóm phản hồi hợp lý. SFT maximum-likelihood có thể表现出 xu hướng trải rộng khối lượng (mass-covering), phân bổ xác suất across các chế độ có trong trình diễn. Tối ưu hóa chính sách bị约束 với reverse KL có thể表现出 xu hướng tìm kiếm chế độ (mode-seeking), tập trung xác suất vào một vài chế độ phần thưởng cao. Hành vi chính xác phụ thuộc vào dữ liệu, phần thưởng, hướng KL và hệ số, nên nó不应被视为 thuộc tính不变 của SFT và RL. Phần RLHF sẽ kết nối lựa chọn thiết kế này với KL divergence.
Phản hồi trực tuyến tạo cơ hội khám phá chiến lược ngoài trình diễn. SFT trên bộ dữ liệu cố định sử dụng tín hiệu huấn luyện trực tiếp từ trình diễn, nhưng nó vẫn có thể kết hợp kiến thức pre-training và khái quát hóa sang đầu vào chưa thấy. RL trực tuyến tạo phản hồi từ chính sách hiện tại và nhận phản hồi môi trường, nên nó có thể đánh giá trực tiếp các ứng viên không có trong trình diễn. Điều này không tự động đảm bảo trần cao hơn: kết quả phụ thuộc vào mô hình gốc, độ phủ trình diễn, độ chính xác phần thưởng, khám phá và ổn định tối ưu hóa. (Các thuật ngữ "trực tuyến/ngoại tuyến" và "on-policy/off-policy" nghiêm ngặt hơn sẽ được phân biệt chính thức trong Mục 7.8.) Hiện tại, hãy xem xét ba cơ hội do phản hồi trực tuyến tạo ra:
Thứ nhất, nó có thể đánh giá ứng viên ngoài bộ trình diễn cố định. Sự giám sát trực tiếp của SFT đến từ các phản hồi được ghi lại; RL cũng có thể tăng cường hành vi mới mà hàm phần thưởng có thể chấm điểm. Hành động "pushcut" trong Thí nghiệm 7-13 (SimpleVLA-RL) chưa từng xuất hiện trong trình diễn con người, cho thấy khả năng发现 chiến lược ngoài dữ liệu. Nhưng mô hình không thể học chất lượng mà phần thưởng không thể nhận ra hoặc发现 chiến lược mà nó không bao giờ khám phá.
Thứ hai, nó có thể khai thác các nhiệm vụ mà xác minh dễ hơn tạo ra. SFT cần câu trả lời đúng hoặc đường dẫn tốt được viết trước; RL cần cách đáng tin cậy để đánh giá chất lượng câu trả lời. Câu trả lời toán học có thể được kiểm tra, code có thể được thử, và chứng minh có thể được xác minh. Sự bất đối xứng này là thế mạnh của RLVR, nhưng trình xác minh không đầy đủ cũng có thể tạo ra reward hacking.
Thứ ba, nó có thể huấn luyện trên các trạng thái được truy cập bởi chính sách hiện tại. Bắt chước ngoại tuyến có vấn đề cổ điển về dịch chuyển hiệp biến (covariate shift): sau khi chính sách rời khỏi trình diễn và进入 trạng thái chưa thấy, tín hiệu phục hồi có thể không có. Trong các thiết lập bắt chước-học tuần tự cụ thể, lỗi worst-case có thể tích lũy khoảng $T^2$ với độ dài đường dẫn $T$, trong khi tổng hợp dữ liệu trực tuyến có thể giảm xuống khoảng $T$. On-Policy Distillation (Mục 7.12) kết hợp khớp trực tuyến này với sự giám sát dày đặc của SFT.
Để dùng phép loại suy: SFT nghiên cứu bản đồ hiện có một cách chi tiết, trong khi RL có thể dùng phần thưởng như la bàn để khám phá các tuyến đường候选 ngoài bản đồ đó. Bản đồ hoặc la bàn không chính xác có thể dẫn mô hình đi lạc. Nhiều hệ thống因此 sử dụng SFT để thiết lập điểm bắt đầu ổn định, rồi thêm RL khi phần thưởng và môi trường đáng tin cậy.
Với toàn cảnh này trong tay, mọi phần sau đều có vị trí trên bản đồ. Hai phần tiếp theo, cả hai [Đọc tùy chọn]—"Từ Agent RL cổ điển đến Agent hiện đại" và "Kiến thức cơ bản Pre-training mô hình"—điền nền tảng học tăng cường và pre-training cho người đọc muốn đi sâu hơn. Người đọc chỉ muốn bắt tay vào post-training có thể bỏ qua đến phần SFT.
Từ Agent RL cổ điển đến Agent hiện đại [Đọc tùy chọn]
Tương tác Agent-Môi trường
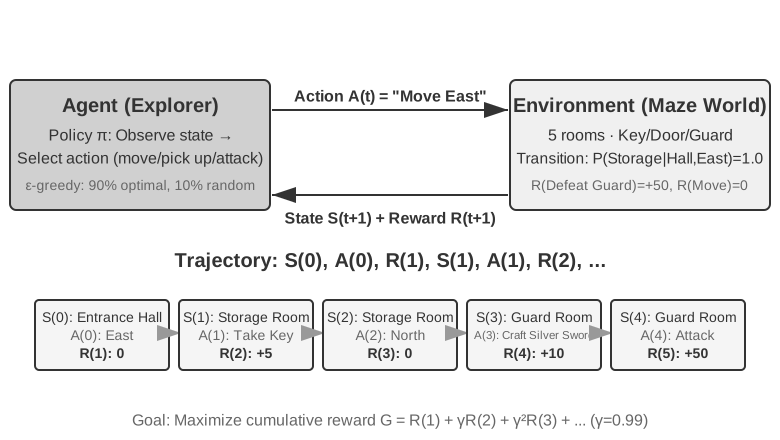
Reinforcement Learning (RL) về cơ bản là học cách chọn hành động dựa trên tình huống hiện tại để tối đa hóa phần thưởng tích lũy. Hãy tưởng tượng một AI học chơi cờ: mỗi nước đi là một hành động, thắng cho phần thưởng dương, thua cho phần thưởng âm, và phần thưởng tích lũy là tổng lợi nhuận từ toàn bộ ván. Agent và môi trường tương tác liên tục: tại mỗi bước, Agent quan sát trạng thái hiện tại, chọn hành động, và môi trường tạo trạng thái mới và cho phần thưởng.
Để hiểu tương tác này trực giác hơn, sơ đồ sau cho thấy vòng lặp RL tiêu chuẩn—tại mỗi bước thời gian, Agent quan sát trạng thái môi trường, xuất hành động, và môi trường cho phần thưởng và chuyển sang trạng thái mới dựa trên hành động đó.
Hình 7-1: Vòng lặp tương tác Agent-Môi trường trong Reinforcement Learning
Tương tác này tạo ra một đường dẫn (trajectory)—bản ghi hoàn chỉnh của "trạng thái → hành động → phần thưởng → trạng thái mới → hành động → phần thưởng..." Chất lượng của một chính sách phản ánh cuối cùng trong chất lượng của các đường dẫn. Một hàm giá trị (value function) trả lời câu hỏi: "Nếu tôi ở trạng thái này bây giờ và tiếp tục hành động theo chính sách hiện tại, tôi sẽ tích lũy được bao nhiêu phần thưởng cuối cùng?" Giống như một kỳ thủ cờ có kinh nghiệm nhìn một thế cờ, không cần tính đến cuối, ước tính trực giác xác suất thắng. (Khi "chính sách hiện tại" được thay bằng "chính sách tối ưu," ta được hàm giá trị tối ưu, sẽ được sử dụng sau trong chương này khi thảo luận phương trình Bellman tối ưu.) Ranh giới giữa Agent và môi trường tuân theo nguyên tắc đơn giản: bất cứ thứ gì Agent không thể thay đổi tùy ý đều thuộc về môi trường.
Hai đặc điểm独特 phân biệt học tăng cường với học có giám sát (cần câu trả lời đúng có nhãn) và học không giám sát (khám phá mẫu ẩn trong dữ liệu): tìm kiếm thử-và-sai (Agent phải tự tìm ra hành động nào tốt, không có giáo viên trực tiếp cung cấp câu trả lời đúng) và phần thưởng trễ (tác động của hành động có thể chỉ显现 nhiều bước sau, ví dụ giá trị của một nước cờ tốt chỉ显现 ở cuối ván). Điều này cũng mang lại sự đánh đổi khám phá-khai thác独特: luôn đi đường quen意味着 không học được gì mới; luôn thử ngẫu nhiên意味着 không bao giờ đạt mục tiêu.
Một hệ thống học tăng cường gồm năm yếu tố cốt lõi:
Không gian hành động (Action Space): Định nghĩa tập hợp tất cả hành động có thể mà Agent có thể thực hiện. Hành động có thể rời rạc (ví dụ "đi nước nào" trong cờ, với số lựa chọn hữu hạn) hoặc liên tục (ví dụ "xoay khớp bao nhiêu độ" cho robot, giá trị liên tục).
Chính sách (Policy): Quy tắc hành vi của Agent, chỉ định phải làm gì trong trạng thái cho trước. Chính sách có thể đơn giản (bảng tra cứu: ở trạng thái A, thực hiện hành động X) hoặc phức tạp (mạng neural sâu).
Tín hiệu phần thưởng (Reward Signal): Phản hồi tức thì từ môi trường. Tuy nhiên, mục tiêu của Agent là tối đa hóa phần thưởng dài hạn, không phải tức thì—sự phân biệt này rất quan trọng, giống như đầu tư không nên đánh giá bằng lãi lỗ hôm nay mà bằng lợi nhuận dài hạn.
Hàm giá trị (Value Function): Ước tính tổng phần thưởng tích lũy có thể获得 từ trạng thái cho trước trong tương lai, giúp Agent đưa ra quyết định khôn ngoan ngay cả khi không có phản hồi tức thì. Một trong những hiểu biết quan trọng nhất từ 60 năm nghiên cứu RL là vai trò trung tâm của ước tính giá trị.
Mô hình môi trường (Environment Model) (tùy chọn): Dự đoán phản hồi của môi trường đối với hành động. Các phương pháp sử dụng mô hình môi trường được gọi là phương pháp dựa trên mô hình (model-based) (trước tiên học dự đoán cách môi trường thay đổi, rồi lập kế hoạch accordingly);那些 không có được gọi là phương pháp không mô hình (model-free) (không dự đoán môi trường, mà học trực tiếp từ kinh nghiệm).
Bảng 7-3 So sánh các yếu tố chính trong các hệ thống Agent khác nhau
Loại Agent
Môi trường
Không gian hành động
Tín hiệu phần thưởng
Hươu sơ sinh
Địa hình, trọng lực, tư thế cơ thể
Liên tục nhiều chiều (co cơ)
Thăng bằng (+), Ngã (-)
Robot hút bụi
Bố cục phòng, mức pin
Rời rạc (hướng, hút, sạc)
Diện tích đã lau (+), Pin hết (-)
Kỳ thủ cờ vua
Trạng thái bàn cờ, giới hạn thời gian
Rời rạc hữu hạn (nước đi hợp lệ)
Thắng (+1), Thua (-1)
Agent dịch vụ khách hàng
Lịch sử hội thoại, cơ sở kiến thức
Độ dài biến đổi kết hợp (suy nghĩ, nói, gọi API)
Vấn đề được giải quyết (+), Thời gian xử lý (-)
Agent trợ lý code
Tài liệu yêu cầu, codebase
Độ dài biến đổi kết hợp (suy nghĩ, tìm kiếm, chỉnh sửa, thực thi)
Kiểm tra passed (+), Bug引入 (-)
Bảng揭示 một sự phân biệt quan trọng. Các môi trường board-game và Atari代表性 sử dụng các hành động nguyên thủy rời rạc hữu hạn được định nghĩa trước, trong khi điều khiển robot sử dụng hành động liên tục với số chiều cố định và giới hạn vật lý. Các Agent dịch vụ khách hàng và coding dựa trên LLM hiện đại kết hợp các Token hữu hạn và lệnh gọi công cụ thành chuỗi hành động độ dài biến đổi, làm cho các chuỗi có thể很难 liệt kê cùng một lúc. Chúng cũng có thể sử dụng suy nghĩ nội bộ để cải thiện năng lực.
Hai biểu diễn hành động: Thiết lập RL cổ điển và chính sách LLM độ dài biến đổi
Sự khác biệt visible nhất giữa hai thiết lập là cách hành động được biểu diễn. Bản thân MDP có thể biểu diễn không gian hành động hữu hạn hoặc vô hạn, rời rạc hoặc liên tục. Các môi trường board-game và Atari代表性 ở đây sử dụng hành động nguyên thủy rời rạc hữu hạn, điều khiển robot sử dụng hành động liên tục có giới hạn, và chính sách LLM kết hợp từ điển Token hữu hạn và lược đồ công cụ thành chuỗi độ dài biến đổi. Biểu diễn kết hợp này có hậu quả lớn cho thiết kế thuật toán, hiệu quả mẫu và khái quát hóa. Mỗi thiết lập được thảo luận dưới đây.
Ví dụ nền tảng: MDP và Tabular Q-learning.
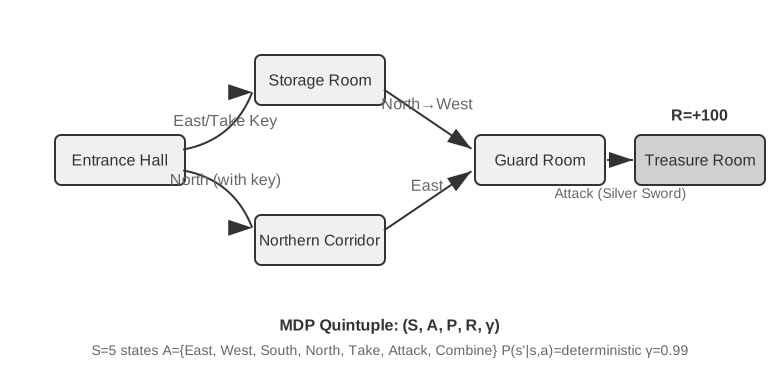
MDP (Markov Decision Process) là khung toán học cho học tăng cường, định nghĩa các yếu tố cốt lõi như trạng thái, hành động và phần thưởng. Giả định cốt lõi của nó là tính chất Markov: tương lai chỉ phụ thuộc vào trạng thái hiện tại, phải chứa tất cả lịch sử liên quan đến quyết định. Trong cờ vua, ví dụ, trạng thái bao gồm không chỉ vị trí quân cờ mà còn bên đi nước, quyền nhập thành và bắt tốt qua đường, và thông tin cần thiết cho quy tắc 50 nước và lặp lại. Với định nghĩa trạng thái đủ, toàn bộ bản ghi ván cờ không cần được đọc lại cho mỗi chuyển đổi. Nếu quan sát bỏ qua lịch sử cần thiết, lịch sử đó phải được thêm vào trạng thái hoặc xử lý bằng mô hình quan sát một phần.
Hình 7-2: Sơ đồ Markov Decision Process (MDP)
Các môi trường RL代表性 trong phần này sử dụng không gian hành động được định nghĩa trước. 361 vị trí nước đi trong Go lớn nhưng hữu hạn; hành động cờ vua vẫn có thể liệt kê; và các trò chơi Atari thường暴露 một vài đến vài chục hành động nguyên thủy rời rạc. Các Agent robot sử dụng không gian hành động liên tục nhưng có giới hạn: góc khớp, tốc độ và lực kẹp là giá trị liên tục, nhưng có giới hạn vật lý rõ ràng và số chiều cố định bởi bậc tự do của robot.
Hành động rời rạc hữu hạn làm cho từng ứng viên dễ đánh giá hơn. Nếu số lượng trạng thái và hành động đủ nhỏ, tabular Q-learning lưu trữ giá trị của chúng trực tiếp; các không gian trạng thái Atari và board-game lớn hơn kết hợp xấp xỉ hàm với tìm kiếm. Các MDP hành động liên tục không thể liệt kê mọi hành động, nên các phương pháp như gradient chính sách và actor-critic xấp xỉ chính sách và hàm giá trị. Ví dụ cổ điển trong phần này cũng khác với chính sách LLM vì nó bắt đầu học thử-và-sai mà không có kiến thức pre-training.
Trong khung này, một trong những thuật toán cơ bản và quan trọng nhất là Q-learning. Nó duy trì ước tính giá trị cho mỗi cặp "trạng thái-hành động": nếu bạn thực hiện hành động a ở trạng thái s và sau đó hành động tối ưu, bạn có thể期望 bao nhiêu phần thưởng tích lũy? Trực giác, liệu hành động có tốt hay không phụ thuộc vào phần thưởng tức thì nó mang lại, cộng với "trạng thái tiếp theo nó dẫn đến tốt như thế nào."
Viết trực giác này thành phương trình cho mối quan hệ đệ quy cốt lõi của phương trình Bellman nổi tiếng trong sách giáo khoa RL: Giá trị thực sự của hành động = phần thưởng tức thì获得 ở bước này + giá trị tương lai tối đa có thể获得 từ trạng thái tiếp theo:
$$Q^*(s, a) = r + \gamma \max_{a'} Q^*(s', a')$$
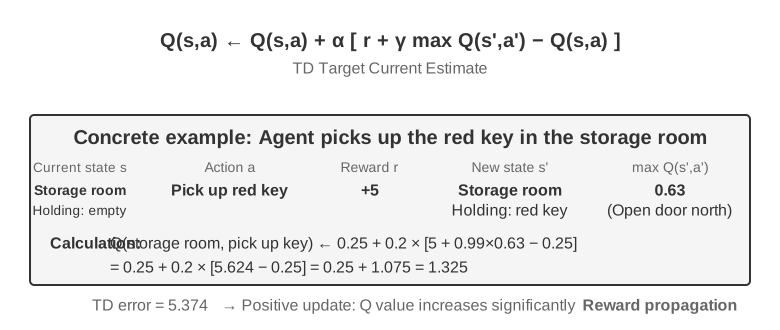
trong đó $r$ là phần thưởng tức thì, $s'$ là trạng thái tiếp theo到达 sau khi thực hiện hành động (viết ở dạng xác định cho trực giác; trong môi trường ngẫu nhiên, cần kỳ vọng trên trạng thái tiếp theo $s'$), và $\gamma \in [0, 1)$ là hệ số chiết khấu (discount factor)—nó xác định Agent đánh giá tương lai bao nhiêu: $\gamma$ càng gần 1, nó càng đánh giá lợi nhuận dài hạn; càng gần 0, nó càng tập trung vào tức thì. "Phần thưởng tích lũy" được nhắc đi nhắc lại trước đó恰好 là tổng phần thưởng ở mỗi bước, được chiết khấu bởi $\gamma$: $\sum_{t} \gamma^{t} r_t$. Sau mỗi hành động, thuật toán điều chỉnh nhẹ ước tính cũ theo hướng "kết quả thực tế quan sát được"—paradigm "sửa ước tính cũ bằng kết quả thực tế một bước" này được gọi là Temporal-Difference Learning (TD learning). Sau hàng nghìn lần thử, ước tính dần接近 giá trị thực.
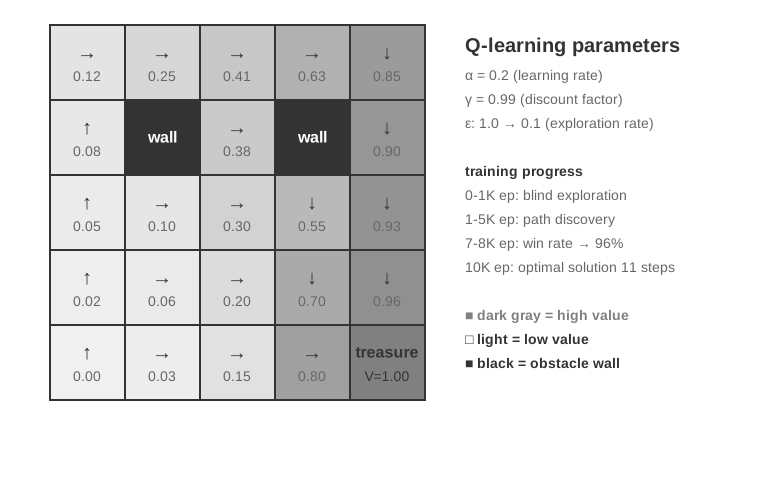
Hai hình sau cho thấy quá trình khám phá của Q-learning trong grid world và sự hội tụ dần của Q-values.
Hình 7-3: Q-learning Grid WorldHình 7-4: Trực quan hóa cập nhật Q-value
Q-learning là phương pháp off-policy: nó có thể học chính sách tối ưu từ dữ liệu được tạo bởi chính sách khám phá khác với chính sách mục tiêu. Nó vẫn yêu cầu độ phủ đầy đủ của các cặp trạng thái-hành động liên quan và tốc độ học và điều kiện hội tụ phù hợp; nó không tự động hội tụ trên phân phối dữ liệu任意. Định nghĩa chính thức của các phương pháp on-policy và off-policy, và cách chúng映射 đến post-training LLM, được thảo luận sau trong phần "So sánh các thuật toán học tăng cường."
Thí nghiệm 7-1 ★: Hiệu suất Q-learning trong trò chơi săn kho báu
Để xác minh đặc điểm và giới hạn của Q-learning, chúng tôi thiết kế môi trường trò chơi săn kho báu. Môi trường này bao gồm một số thách thức chính: cơ chế ẩn yêu cầu Agent tự发现 sự tương ứng giữa chìa khóa và cửa, hiệu ứng vũ khí, và quy tắc chế tạo vật phẩm; phụ thuộc đa bước意味着 hoàn thành nhiệm vụ yêu cầu chuỗi hành động đúng (giải pháp tối ưu: 11 bước); phần thưởng thưa意味着 chỉ hành động chính và chiến thắng cuối cùng tạo ra phần thưởng đáng kể, hầu hết các bước trung gian không nhận phản hồi.
Agent Q-learning sử dụng cài đặt tham số tiêu chuẩn và chiến lược khám phá ε-greedy: nó thường chọn hành động tối ưu hiện tại nhưng偶尔 chọn ngẫu nhiên, với tỷ lệ khám phá ngẫu nhiên giảm dần trong quá trình huấn luyện.
Đường cong học cho thấy đặc điểm điển hình (một episode là một trò chơi hoàn chỉnh, từ đầu đến hoàn thành hoặc thất bại):
1000 episode đầu: Tỷ lệ thắng 0%, bảng Q chỉ có 124 trạng thái, Agent khám phá mù
5000 episode đầu: Vẫn không thắng ổn định, bảng Q có 133 trạng thái
7.000–8.000 episode: Tỷ lệ thắng dần tăng từ 34% lên 96%
10.000 episode: Tỷ lệ thắng 100%, bảng Q có 145 trạng thái, tìm được giải pháp tối ưu 11 bước
Toàn bộ quá trình huấn luyện mất chưa到 10 giây (mô phỏng rất hiệu quả), nhưng cần gần 10.000 lần thử hoàn chỉnh. Điều này chứng minh hành vi của thiết lập tabular Q-learning ε-greedy không có prior được sử dụng trong thí nghiệm này: nó cần khám phá ngẫu nhiên substantial để hoàn thành đường dẫn tình cờ, và tín hiệu giá trị传播 đủ chậm để需要反复 củng cố.
Trong trình mô phỏng trò chơi, 10.000 lần thử chỉ mất 10 giây, chi phí có thể bỏ qua. Nhưng trong các kịch bản Agent thực tế—nơi mỗi cuộc gọi điện thoại có chi phí, mỗi thao tác trình duyệt có độ trễ, và mỗi quyết định sai có thể có hậu quả不可 đảo ngược—10.000 lần thử hoàn toàn不可 chấp nhận. Một lý do để sử dụng chính sách LLM pre-training là kiến thức tích lũy có thể hỗ trợ quyết định hiệu quả với số lần tương tác môi trường ít hơn nhiều.
Thí nghiệm tabular Q-learning không có prior này có ba giới hạn: ngay cả nhiệm vụ đơn giản也需要 tương tác rộng rãi, giá trị học trong môi trường này không chuyển trực tiếp sang môi trường khác, và mỗi nhiệm vụ mới phải được khám phá lại. Đây không phải giới hạn của bản thân khung MDP. Xấp xỉ hàm, học chuyển giao, và RL dựa trên mô hình có thể xử lý trạng thái phong phú hơn và chuyển giao kiến thức, mặc dù chúng vẫn có thể yêu cầu tương tác môi trường substantial so với LLM pre-training.
Các Agent dựa trên chính sách LLM pre-training.
Các mô hình ngôn ngữ lớn đã mang lại một thay đổi thực tế quan trọng cho cách biểu diễn và khởi tạo hành động của Agent.
RL cổ điển cũng có thể mô hình hóa tính toán nội bộ hoặc thu thập thông tin dưới dạng trạng thái và hành động. Thay đổi thực tế do LLM引入 không phải là suy nghĩ trở nên_possible lần đầu, mà là chính sách ngôn ngữ pre-training có thể biểu diễn tính toán nội bộ dưới dạng chuỗi Token độ dài biến đổi và tạo ra nó trong cùng chính sách với hành động bên ngoài. Các Token suy nghĩ không trực tiếp thay đổi thế giới bên ngoài, nhưng chúng có thể cải thiện hành động cuối cùng. Biểu diễn hành động bây giờ bao gồm không chỉ "làm gì," mà còn "suy nghĩ bao lâu và suy nghĩ gì."
Sáng kiến thực tế quan trọng nhất là kết hợp Token suy nghĩ như hành động đặc biệt trong không gian đầu ra chính sách. Các môi trường RL truyền thống代表性 nhấn mạnh các hành động nguyên thủy như di chuyển, tấn công và nhặt, mặc dù tính toán nội bộ cũng có thể được mô hình hóa trong MDP hoặc chính sách phân cấp. Trong các Agent LLM, suy nghĩ nội bộ trở thành phần cốt lõi của không gian hành động ngôn ngữ được học. Nó không trực tiếp thay đổi môi trường bên ngoài hoặc nhận phần thưởng tức thì từ môi trường, nhưng có thể biểu diễn nhiều đường dẫn tính toán trong giới hạn Token và Context.
Hành động kết hợp độ dài biến đổi tạo ra không gian tìm kiếm lớn hơn nhiều so với hành động nguyên thủy và很难 học từ đầu mà không có kiến thức prior. Agent học từ đầu giống như tìm kho báu trong sa mạc bị bịt mắt. LLM thay vào đó học các mẫu giải quyết vấn đề của con người từ pre-training văn bản khổng lồ: giải toán thường theo "xác định điều kiện → nhớ công thức → tính từng bước," trong khi coding theo "hiểu yêu cầu → thiết kế cấu trúc → triển khai chi tiết." Chính sách pre-training cho các đường dẫn có cấu trúc xác suất prior cao hơn,大大压缩 không gian tìm kiếm. Do đó, ngay cả không có RL bổ sung, LLM pre-training có thể tạo ra Chain of Thought (CoT) logic cơ bản, được học thông qua dự đoán Token tiếp theo trên các giải toán, bình luận code, thảo luận và các dấu vết suy nghĩ khác do con người viết.
Post-training RL sau đó sử dụng phần thưởng bên ngoài để dạy LLM áp dụng các mẫu này hiệu quả hơn cho nhiệm vụ cụ thể. Cấu trúc ngôn ngữ không phải là "phần thưởng nội bộ" riêng biệt; nó hoạt động như phân phối prior trong chính sách pre-training. Một mẫu liên tục có trong dữ liệu huấn luyện, như "chúng ta cần chuyển đổi tiền tệ, nên trước tiên tra tỷ giá," có thể bắt đầu với xác suất tạo ra cao hơn đường dẫn无关 như kiểm tra thời tiết. RL sử dụng phần thưởng nhiệm vụ thực tế để重塑 xác suất đường dẫn từ phân phối khởi đầu đó.
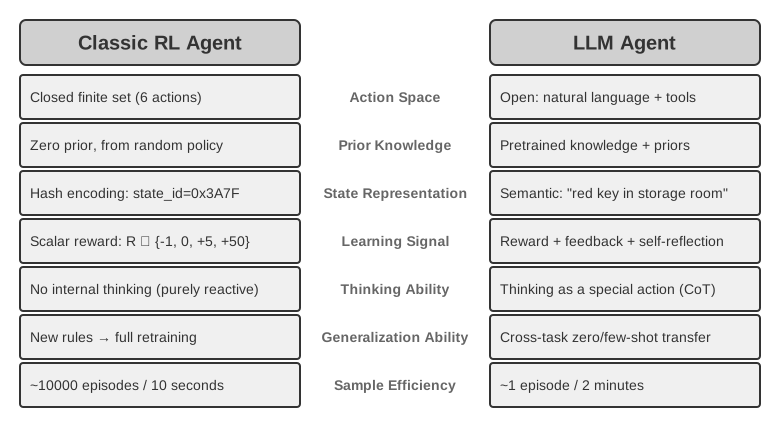
Hình 7-5: So sánh RL cổ điển và Agent LLM hiện đại
Chính sách ngôn ngữ pre-training cho phép các Agent LLM hiểu hướng dẫn chưa thấy (khái quát hóa zero-shot) và thích ứng với nhiệm vụ mới từ vài ví dụ (thích ứng few-shot), tương phản鲜明 với thiết lập tabular Q-learning không có prior ở trên. Nó cũng hỗ trợ khái quát hóa组合, học trong Context, và hiểu đa phương thức. Lưu ý rằng hiệu quả của học trong Context và cơ chế nội bộ của nó là các câu hỏi khác nhau—như phân tích trong Chương 2, attention hoạt động更像是 truy xuất hơn là suy luận, nhưng điều này không giảm hiệu quả thực tế trong thích ứng nhiệm vụ.
Mở rộng từ hành động nguyên thủy được định nghĩa trước sang hành động kết hợp độ dài biến đổi là sự dịch chuyển quan trọng trong paradigm Agent AI. Hành động LLM vẫn được định nghĩa bởi từ điển Token hữu hạn và lược đồ công cụ, nhưng suy nghĩ nội bộ, truy vấn ngôn ngữ tự nhiên, mã chương trình, JSON phức tạp và nội dung đa phương thức kết hợp thành số lượng lớn chuỗi độ dài biến đổi. Trình thông dịch code và công cụ tìm kiếm kết nối biểu diễn đó với phạm vi rộng các nhiệm vụ và thông tin thực tế. Điều này tạo ra cả cơ hội và thách thức: Agent có thể kết hợp công cụ cơ bản để xử lý nhiệm vụ chưa thấy, nhưng thiết kế phần thưởng và khám phá hiệu quả phải hoạt động trên không gian组合 khổng lồ.
Các mô hình như Kimi K3, được tối ưu hóa cho sử dụng công cụ và suy luận chuỗi dài, minh họa hướng điển hình của paradigm LLM+RL: pre-training ngôn ngữ quy mô lớn cung cấp nền tảng, và post-training tăng cường phân tích vấn đề, sử dụng công cụ và tự sửa lỗi. OpenVLA (chi tiết trong Chương 9)展示 paradigm kiến trúc VLA (Vision-Language-Action) của thời đại LLM: bộ mã hóa视觉 xử lý quan sát môi trường, mô hình ngôn ngữ hiểu hướng dẫn và suy luận, và bộ giải mã hành động tạo tín hiệu điều khiển, cho phép điều khiển theo điều kiện ngôn ngữ và khái quát hóa liên nhiệm vụ. Để rõ ràng, bản thân OpenVLA được huấn luyện thông qua học bắt chước trên gần một triệu đường dẫn trình diễn robot, khiến nó bản chất là SFT chứ không phải RL. SimpleVLA-RL, được giới thiệu trong Thí nghiệm 7-13 sau trong chương này, là ví dụ代表性 về đưa RL vào robotics bằng cách sử dụng phần thưởng để tối ưu hóa thêm kiến trúc VLA loại này.
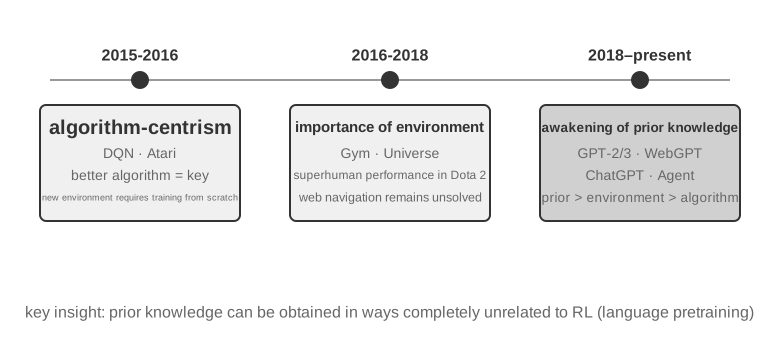
Hình 7-6: Tiến hóa các paradigm huấn luyện của OpenAI
Con đường探索 của OpenAI (được ghi lại bởi Shunyu Yao, Phó Giáo sư Đại học Princeton và tác giả bài báo ReAct, trong "The Second Half") truy vết sự tiến hóa trong tư duy của lĩnh vực. Giai đoạn 1 (2015-2016), Lấy thuật toán làm trung tâm: Niềm tin phổ biến là thuật toán tốt hơn là chìa khóa. Tiến bộ được thực hiện trong các môi trường tiêu chuẩn như Atari, nhưng mỗi môi trường mới yêu cầu huấn luyện lại từ đầu. Giai đoạn 2 (2016-2018), Tầm quan trọng của môi trường: Gym标准化 một loạt nhiệm vụ; Universe và World of Bits cố gắng biến整个 internet thành môi trường huấn luyện RL; và Dota 2 theo đuổi hiệu suất siêu nhân trong môi trường phức tạp cụ thể. Ý tưởng rõ ràng, nhưng sử dụng máy tính chung và điều hướng web vẫn nằm ngoài tầm với.
Giai đoạn 3 (2018-hiện tại), Sự thức tỉnh của Prior: GPT-2/GPT-3 chứng minh sức mạnh của pre-training ngôn ngữ; WebGPT và ChatGPT chứng minh các prior đó có thể biến thành Agent thực tế. Khám phá quan trọng nhất: prior có thể được获得 theo cách无关 với RL. Đây là sự thật counterintuitive—trong nhiều thập kỷ, các nhà nghiên cứu RL có thể đã có ưu tiên hoàn toàn ngược lại. Thứ tự thực sự không phải là thuật toán > môi trường > prior, mà là prior > môi trường > thuật toán.
Thí nghiệm 7-2 ★★: Nghiên cứu so sánh RL truyền thống và Agent LLM
Hình 7-7: So sánh kiến trúc Q-learning và Agent LLM trong trò chơi săn kho báu
Chúng tôi so sánh Q-learning với Agent LLM—Kimi K3, duy trì bộ nhớ đệm lên đến 50 kinh nghiệm—trong cùng trò chơi săn kho báu. Kết quả đáng kinh ngạc: Agent LLM hoàn thành trò chơi trong 18 bước ngay lần thử đầu tiên.
Giai đoạn đầu (Khám phá có mục đích): Nhặt kiếm gỉ ("Vũ khí tốt hơn tay không"), khám phá có hệ thống bản đồ, suy luận "cần tìm chìa khóa" sau khi发现 cửa bắc bị khóa, khám phá kho hàng,获得 chìa khóa đỏ và pha lê魔法. Giai đoạn giữa (Hiểu cơ chế và Tổng hợp chủ động): Hiểu quy tắc "chìa khóa tự sử dụng" và预期 kiếm gỉ不足以对付 lính canh, chủ động合成 kiếm bạc ở bước 8. Giai đoạn sau (Thực thi và Sửa lỗi): Đi bắc với kiếm bạc và đánh bại lính canh mạnh ở bước 13. Trên đường, nó thực hiện một hoặc hai lần thử không hiệu quả—vung kiếm反复 hoặc quay lại—và cuối cùng获得 kho báu rồng ở bước 18.
Điều này chứng minh sự khác biệt cơ bản giữa hiểu ngữ nghĩa và ánh xạ ký hiệu. Agent LLM hiểu cấu trúc khái niệm của trò chơi; mỗi bước có mục đích và hỗ trợ logic. Đối với Q-learning, "cửa," "chìa khóa," và "kiếm" chỉ là组合 ký hiệu vô nghĩa, và nó chỉ có thể缓慢发现 mối quan hệ của chúng thông qua học thống kê rộng rãi.
Chi phí tính toán呈現 một nghịch lý thú vị: Q-learning chạy 10.000 trò chơi trong 10 giây, trong khi Agent LLM mất 1-2 phút mỗi trò chơi. Tuy nhiên, trong các nhiệm vụ thực tế, chi phí thời gian, tiền bạc và rủi ro mỗi tương tác远远 vượt quá chi phí tính toán thuần túy, nên đánh giá chỉ bằng thời gian GPU là不公平. Một hiểu biết quan trọng hơn là: Thành công của Agent LLM không phải vì có "thuật toán học tập" tốt hơn, mà vì nó mang kiến thức prior khổng lồ. Khi quy tắc trò chơi thay đổi, Q-learning cần huấn luyện lại hoàn toàn, trong khi Agent LLM có thể thích ứng trực tiếp thông qua suy luận. Điều này dẫn đến nguyên tắc thiết kế thực tế: RL truyền thống vẫn有价值 trong các kịch bản có chi phí mô phỏng thấp và tính lặp lại cao; trong các kịch bản thực tế có chi phí tương tác cao và cần thích ứng nhanh, hiệu quả mẫu của Agent LLM有价值 hơn trong thực tế.
Chương 1 đã cung cấp bản đồ khái niệm về cách thích ứng Context, cập nhật hiện vật bên ngoài và cập nhật tham số hoạt động cùng nhau; phần "Toàn cảnh post-training hoàn chỉnh và mẹo thực tế" ở cuối chương này quay lại chủ đề. Mạch chủ đề chính của chương này là post-training: viết vào tham số mô hình các năng lực không thể được thể hiện đầy đủ thông qua quy tắc bên ngoài.
Cơ bản về Pre-training Model [Đọc thêm]
Để hiểu tại sao các kỹ thuật post-training lại hiệu quả, trước tiên cần hiểu pre-training đã thiết lập những gì. Post-training (SFT và RL) về bản chất là tối ưu hóa trong không gian biểu diễn được thiết lập bởi pre-training — cấu trúc tri thức do pre-training xây dựng quyết định giới hạn trên của post-training. Do đó, chúng ta kiểm tra các khía cạnh cốt lõi của pre-training thông qua ba thí nghiệm: huấn luyện một mô hình ngôn ngữ quy mô nhỏ từ đầu, mở rộng khả năng thị giác, và nhồi tri thức ngôn ngữ mới. Ba thí nghiệm trong phần này là phần bổ sung, nhằm xây dựng trực giác về pre-training — tức là huấn luyện ban đầu trên dữ liệu quy mô lớn giúp mô hình học các mẫu ngôn ngữ cơ bản và tri thức thế giới. Độc giả đã quen thuộc với quy trình pre-training có thể bỏ qua phần này.
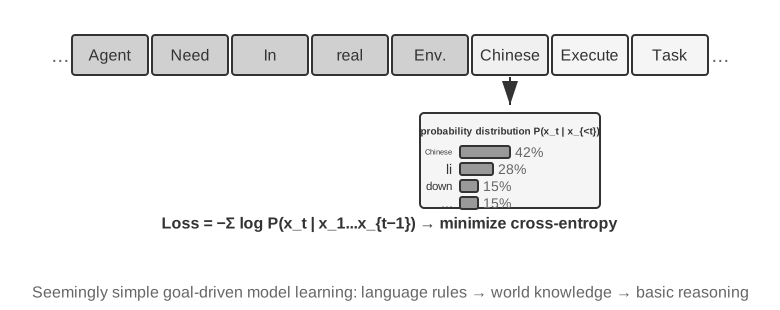
Hình 7-8: Pre-training dự đoán Token tiếp theo
Huấn luyện mô hình ngôn ngữ tuân theo quy trình ba bước: "tokenization — pre-training — post-training." Tokenization chia văn bản thành các đơn vị rời rạc. Ví dụ, "I like programming" có thể được tokenize thành "I," "like," "program," "ming." Các Token này là đơn vị văn bản nhỏ nhất được xử lý bởi mô hình. Nhiệm vụ của pre-training về mặt khái niệm rất đơn giản: cho mô hình xem phần đầu của một đoạn văn bản và yêu cầu nó dự đoán Token tiếp theo. Bằng cách so sánh dự đoán với câu trả lời đúng (sự khác biệt này được gọi là loss; loss càng nhỏ nghĩa là dự đoán càng chính xác), mô hình liên tục điều chỉnh các tham số. Sau khi huấn luyện lặp lại trên dữ liệu văn bản khổng lồ, mô hình dần học được quy tắc ngôn ngữ, tri thức thế giới và khả năng suy luận cơ bản. Sau pre-training, mô hình có thể tạo ra văn bản trôi chảy, nhưng đầu ra thiếu cấu trúc và khó tuân theo chỉ dẫn. Post-training sau đó biến mô hình thành trợ lý thực tế thông qua SFT — huấn luyện trên các cặp đầu vào-đầu ra được gán nhãn — và tối ưu hóa sở thích, chẳng hạn như DPO, giúp mô hình tạo ra các phản hồi mà con người ưa thích.
Thí nghiệm 7-3 ★★: Huấn luyện LLM từ đầu — Sức mạnh của cải tiến thuật toán
Sử dụng MiniMind 2, mô hình 100 triệu tham số, làm nghiên cứu điển hình, thí nghiệm hoàn thành toàn bộ quy trình huấn luyện trên GPU tiêu dùng. Hai tối ưu hóa thuật toán — QK Norm và Muon optimizer — giúp tốc độ hội tụ tăng gấp ba và cải thiện đáng kể chất lượng tạo văn bản, tất cả với chi phí rất thấp: khoảng 14 giờ huấn luyện và tổng cộng 34 đô la.
Hiệu quả của từng giai đoạn huấn luyện: Sau pre-training, mô hình có thể trả lời các câu hỏi thực tế như "Ngọn núi cao nhất thế giới là gì?" nhưng định dạng không chuẩn; sau SFT, việc tuân theo chỉ dẫn và định dạng đầu ra cải thiện đáng kể, cho phép mô hình tổ chức câu trả lời như mong đợi; tối ưu hóa sở thích进一步 giảm lỗi thực tế và biểu đạt không tự nhiên. Mô hình 100 triệu tham số vẫn có những hạn chế rõ ràng (dễ mắc lỗi trên các vấn đề phức tạp), nhưng bài học là: Với ngân sách cố định nhỏ, cải tiến thuật toán mang lại giá trị tốt hơn việc đơn thuần tăng kích thước.
Thí nghiệm 7-4 ★★: Huấn luyện VLM của riêng bạn
Hình 7-9: Kiến trúc Vision-Language Model (VLM)
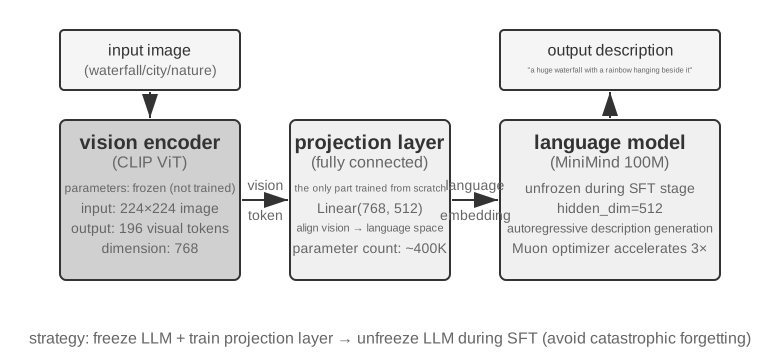
VLM thống nhất nhận thức thị giác và hiểu ngôn ngữ trong một mô hình duy nhất. Thách thức cốt lõi là căn chỉnh đa phương thức — làm cho "những gì được thấy" tương ứng với "những gì được nói." Kiến trúc gồm ba thành phần: Vision Encoder (ví dụ: CLIP, tham số đóng băng) trích xuất đặc trưng ngữ nghĩa từ hình ảnh; Projection Layer (nhẹ, phần duy nhất được huấn luyện từ đầu) đóng vai trò "phiên dịch" giữa đặc trưng thị giác và mô hình ngôn ngữ, ánh xạ đặc trưng thị giác vào không gian biểu diễn mà mô hình ngôn ngữ có thể hiểu; và Language Model tạo văn bản mô tả. Huấn luyện sử dụng chiến lược "đóng băng LLM + chỉ huấn luyện projection layer" để tránh thảm họa quên (quên kỹ năng cũ sau khi học cái mới); sau giai đoạn pre-training căn chỉnh, LLM được mở băng, và SFT được thực hiện trên các cặp hình ảnh-mô tả chất lượng cao, cải thiện đáng kể chi tiết và độ chính xác của mô tả.
Thí nghiệm này揭示 ra paradigm cơ bản cho huấn luyện mô hình đa phương thức: tái sử dụng kết quả pre-training đơn phương thức và đạt được căn chỉnh đa phương thức bằng cách huấn luyện một projection layer nhẹ — hiệu quả và có thể mở rộng, nhưng khả năng biểu đạt hạn chế của projection layer có thể trở thành nút thắt cho hiểu đa phương thức sâu. Mở rộng kiến trúc "vision encoder + projection layer + LLM" tương tự thêm một bước bằng cách yêu cầu mô hình xuất ra hành động sẽ tạo ra mô hình VLA (Vision-Language-Action) được trình bày chi tiết trong Chương 9.
Thí nghiệm 7-5 ★★: Continued Pre-training để học ngôn ngữ mới
Sử dụng Mistral 7B v0.3 làm mô hình nền — chủ yếu được pre-training trên tiếng Anh và几乎 không hiểu tiếng Hàn — thí nghiệm引入 khả năng tiếng Hàn thông qua continued pre-training trên Wikipedia tiếng Hàn. Thực hiện huấn luyện không giám sát trên dữ liệu ngôn ngữ mới bằng mô hình đã hoàn thành pre-training. Mô hình đã拥有 hữu khả năng lập mô hình ngôn ngữ chung và chỉ cần thích ứng với phân phối dữ liệu mới,使得 chi phí thấp hơn nhiều so với huấn luyện từ đầu. Một điểm kỹ thuật quan trọng là sử dụng dữ liệu hỗn hợp (~80% tiếng Hàn + 20% tiếng Anh) để giảm nhẹ thảm họa quên: tỷ lệ ngôn ngữ mục tiêu quá cao dẫn đến suy giảm ngôn ngữ gốc, trong khi tỷ lệ quá thấp导致 hiệu quả học tập không đủ. Cuối cùng, SFT được thực hiện với dữ liệu chỉ dẫn tiếng Hàn để获得 khả năng đối thoại tiếng Hàn thực tế. Kết luận của thí nghiệm này sẽ được sử dụng lại trong "Toàn cảnh Post-training và Mẹo thực tế" ở cuối chương: để mô hình ghi nhớ大量 tri thức lĩnh vực mới, hãy dựa vào continued pre-training, không phải SFT.
Ba thí nghiệm pre-training共同揭示一个模式: khi ngân sách bị giới hạn, cải tiến thuật toán và đổi mới kiến trúc mang lại giá trị tốt hơn việc đơn thuần tăng quy mô. Quan trọng hơn, pre-training赋予 mô hình tri thức mô tả và khả năng lập mô hình ngôn ngữ, nhưng缺乏 tuân theo chỉ dẫn có cấu trúc và hành động hướng tác vụ — đây恰恰 là khoảng trống mà SFT cần填补.
Với năng lực nền tảng từ pre-training, bước tiếp theo là biến đổi mô hình đa năng thành Agent thực tế thông qua post-training. Giai đoạn đầu tiên của post-training là Supervised Fine-Tuning (SFT).
SFT (Supervised Fine-Tuning)
Hình 7-10: Quy trình Supervised Fine-Tuning (SFT)
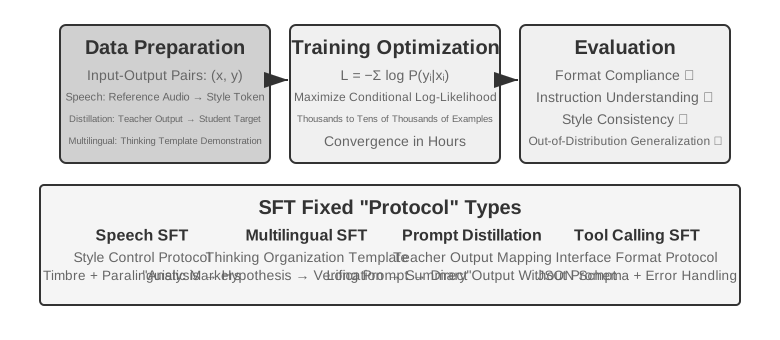
Mục 7.1 đã phơi bày bản chất của SFT ("dự đoán Token tiếp theo," với dữ liệu khác, loss chỉ tính trên phần trả lời). Phần này sử dụng bốn thí nghiệm để xem cơ chế này—việc ghi các ánh xạ và quy trình ổn định vào tham số—thực sự cố định hóa những gì across các nhiệm vụ khác nhau. Giá trị cốt lõi của SFT không phải là注入 kiến thức mới, mà là cố định hóa quy trình: viết các mối quan hệ ánh xạ, định dạng tương tác và chuẩn mực phong cách vào tham số, cho phép mô hình tạo ra đầu ra đáp ứng kỳ vọng trong quá trình suy luận mà không cần Prompt dài. Thông thường, chỉ cần vài nghìn đến hàng chục nghìn ví dụ chất lượng cao để thiết lập khả năng hội thoại cơ bản và tuân thủ hướng dẫn.
Hiệu quả này có thể đi kèm với sự phụ thuộc vào phân phối huấn luyện. Trong các nhiệm vụ yêu cầu khám phá các chiến lược đúng đa dạng, hoặc khi triển khai dịch chuyển khỏi trình diễn, SFT có thể倾向于 tái tạo các mẫu trình diễn và mất hiệu suất trong tình huống mới. Các thí nghiệm sau cho thấy quá trình "cố định hóa quy trình" từ các góc độ khác nhau; chúng không thiết lập xếp hạng phổ quát của SFT và RL.
Trước khi bắt tay vào SFT, có một câu hỏi thực tế bạn không thể tránh: dữ liệu SFT đến từ đâu? Câu trả lời của ngành tóm gọn trong ba lộ trình: trình diễn chuyên gia con người—trần chất lượng cao nhất, nhưng đắt và chậm, phù hợp nhất cho "dữ liệu hạt giống" định nghĩa định dạng và phong cách; tạo từ mô hình giáo viên—tức dữ liệu tổng hợp: để mô hình mạnh sản xuất hàng loạt cặp "đầu vào–đầu ra," lọc chúng, rồi chưng cất vào học sinh (Thí nghiệm 7-8 và 7-9 đều đi theo lộ trình này); tự khởi động từ mô hình—mô hình lấy mẫu nhiều ứng viên cho cùng một vấn đề, trình xác minh chọn các câu trả lời đúng, và các mẫu được chọn đó sau đó được sử dụng để huấn luyện chính mô hình. Đây là fine-tuning lấy mẫu loại bỏ (rejection sampling), được trình bày chi tiết trong Thí nghiệm 7-9. Ba lộ trình thường được kết hợp: trước tiên dùng một lượng nhỏ dữ liệu hạt giống con người để cố định định dạng, sau đó dùng mô hình giáo viên để mở rộng quy mô, và cuối cùng dùng lấy mẫu loại bỏ để nâng chất lượng lên tiêu chuẩn. Dù bạn đi lộ trình nào, pipeline xây dựng phần lớn giống nhau: xác định phân phối nhiệm vụ và lược đồ đầu ra, tạo ứng viên hàng loạt, lọc chất lượng với xác thực dựa trên quy tắc, kiểm tra định dạng và kiểm tra thủ công mẫu, rồi loại trùng, cân bằng tỷ lệ hỗn hợp và đảm bảo tính đa dạng. Không cần tham lam về quy mô—vài nghìn đến hàng chục nghìn ví dụ chất lượng cao thường đủ để cố định hóa quy trình. Thay vì chất đống một trăm nghìn ví dụ bẩn, hãy tinh chỉnh mười nghìn ví dụ sạch: SFT sẽ trung thành viết mọi bit nhiễu trong dữ liệu vào tham số của nó.
Thí nghiệm 7-6 ★★★: SFT Giọng nói—Từ "Nhân bản giọng nói" đến "Mô hình hóa Ngôn ngữ phụ trợ" [Thí nghiệm mở rộng]
Sử dụng Orpheus (nhân bản giọng nói theo ngữ cảnh) và Sesame (mô hình hóa token ngôn ngữ phụ trợ) làm nghiên cứu điển hình, thí nghiệm này cho thấy "phong cách giọng nói và thói quen biểu đạt" được ghi vào tham số như thế nào. Hai mô hình đi theo hai lộ trình khác nhau:
Orpheus: Nén sóng giọng nói thành chuỗi Token. Bằng cách nối âm thanh tham chiếu từ cùng một người nói, mô hình học được "nói bằng giọng của người này," đạt được tính nhất quán âm sắc liên câu.
Sesame: Trừu tượng hóa các hiện tượng ngôn ngữ phụ trợ như tiếng cười và tiếng thở dài thành các Token đặc biệt như <laugh>, <sigh>. Mô hình học "tạo ra âm thanh tương ứng khi thấy Token."
Trong các nhiệm vụ biểu đạt, SFT cố định hóa các quy trình điều khiển phong cách và thói quen biểu đạt có cấu trúc, chứ không phải kiến thức事实 hay lý luận phức tạp. Chìa khóa nằm ở tính đa dạng và chất lượng chú thích của dữ liệu huấn luyện. Các chế độ thất bại phổ biến bao gồm quá ít người nói trong dữ liệu huấn luyện, khiến mọi người nghe giống nhau, và quá khớp Token (mô hình ghi nhớ chi tiết mẫu huấn luyện và hoạt động kém hơn trên tình huống mới), dẫn đến "cười cơ học."
Thí nghiệm 7-7 ★★★: Suy nghĩ Đa ngôn ngữ—Cho phép Mô hình Suy nghĩ bằng Bất kỳ Ngôn ngữ nào [Thí nghiệm mở rộng]
Hầu hết các mô hình suy nghĩ chỉ "suy nghĩ" bằng tiếng Anh: bất kể bạn dùng ngôn ngữ nào để đặt câu hỏi, chuỗi suy nghĩ nội bộ của mô hình几乎 luôn bằng tiếng Anh, vì các trình diễn suy nghĩ chất lượng cao trong dữ liệu huấn luyện chủ yếu được viết bằng tiếng Anh. Mục tiêu của thí nghiệm này đơn giản—cho phép mô hình suuy nghĩ bằng ngôn ngữ được chỉ định.
Phương pháp là thực hiện SFT trên gpt-oss-20b: thêm một dòng reasoning language: German (hoặc ngôn ngữ khác) vào hướng dẫn hệ thống, sau đó huấn luyện với các ví dụ suy luận bằng tiếng Anh, tiếng Tây Ban Nha, tiếng Pháp, v.v. Dữ liệu huấn luyện không chứa tiếng Trung nào cả, nhưng sau khi huấn luyện, chỉ cần đặt ngôn ngữ suy luận sang tiếng Trung là mô hình có thể thực hiện suy luận chuỗi suy nghĩ hoàn chỉnh bằng tiếng Trung—sự khái quát hóa liên ngôn ngữ zero-shot này là phát hiện thú vị nhất của thí nghiệm. Lưu ý rằng đây không phải là năng lực khái quát hóa của bản thân SFT. Pre-training đa ngôn ngữ đã thiết lập không gian biểu diễn liên ngôn ngữ chung trong mô hình; SFT chỉ kích hoạt năng lực liên ngôn ngữ đã có sẵn này.
Thí nghiệm 7-8 ★★: Chưng cất Prompt—Nhân rộng Năng lực Có thể Sử dụng với Chi phí Thấp hơn
Trong ứng dụng thực tế, để mô hình thực hiện các nhiệm vụ phức tạp, thường yêu cầu các Prompt hệ thống dài (hàng nghìn甚至 hàng chục nghìn Token), tăng độ trễ và chi phí với mỗi lần gọi. Khi sử dụng các LLM suy luận, các Token suy nghĩ nội bộ进一步放大 chi phí. Ý tưởng đằng sau chưng cất Prompt là nén hành vi của "Prompt dài + giáo viên suy nghĩ" thành "Prompt ngắn/không Prompt + học sinh không suy nghĩ." Giáo viên tạo câu trả lời chất lượng cao dưới Prompt đầy đủ và chế độ suy nghĩ; dữ liệu huấn luyện chỉ保留 đầu vào người dùng và kết luận cuối cùng, loại bỏ Prompt dài và quá trình suy nghĩ trung gian. Học sinh học "trực tiếp đưa ra kết luận." Sau khi chưng cất, chất lượng đầu ra của học sinh trên cùng đầu vào接近 giáo viên, trong khi độ trễ và chi phí giảm显著 vì không cần xử lý Prompt dài và Token suy nghĩ.
Chưng cất có thể được thực hiện along hai chiều: "lớn sang nhỏ" (thay thế mô hình lớn bằng mô hình trung bình hoặc nhỏ để cân bằng chi phí và chất lượng) và "suy nghĩ sang không suy nghĩ" (gấp CoT tường minh thành kiến thức tham số ẩn cùng quy mô, đạt cải thiện tốc độ phản hồi 20-30 lần). Hai chiều này không loại trừ lẫn nhau và thường được sử dụng cùng nhau trong môi trường sản xuất. Điều quan trọng cần lưu ý là chưng cất kế thừa ranh giới của giáo viên—nếu giáo viên có lỗi hệ thống trên đuôi dài của phân phối, học sinh sẽ进一步 mã hóa cứng các lỗi này; nếu giáo viên依赖 Tools để đảm bảo tính chính xác, chưng cất đầu ra đơn giản sẽ mất tính mạnh mẽ do Tools cung cấp. Bài học kỹ thuật: khi thiết kế sản phẩm ổn định, phân phối đầu vào có thể dự đoán và ràng buộc chi phí显著, chưng cất Prompt là tối ưu hóa xuất sắc; trong quá trình khám phá hoặc trước khi nhiệm vụ ổn định, giữ lại suy nghĩ tường minh và Prompt có thể chỉnh sửa vẫn là trọng tâm của lặp lại nhanh.
Thí nghiệm 7-9 ★★★: Chưng cất Chain of Thought (CoT)
Chưng cất Prompt loại bỏ quá trình suy nghĩ; chưng cất CoT làm ngược lại: nó chuyển giao toàn bộ quỹ đạo suy nghĩ của mô hình giáo viên mạnh sang mô hình học sinh. Chưng cất CoT từ mô hình giáo viên mạnh có thể cho phép học sinh cùng số lượng tham số phục hồi 70%-80% năng lực của giáo viên. Đối với các nhóm không đặt mục tiêu đẩy giới hạn năng lực SOTA mà muốn mô hình họ có thể kiểm soát, đây là chiến lược người theo dõi thực dụng nhất. Loạt mô hình nhỏ chưng cất mã nguồn mở của DeepSeek-R1 (sử dụng các quỹ đạo suy nghĩ của R1 để thực hiện SFT trên loạt Qwen và Llama) là ví dụ代表性 của phương pháp này.
Bối cảnh: Hiện tượng "Tường Suy nghĩ." Một số mô hình suy luận mã nguồn đóng (ví dụ: loạt OpenAI o, loạt Gemini) tạo chuỗi suy nghĩ nội bộ trong quá trình suy luận, nhưng những gì người dùng thấy không phải là quá trình suy nghĩ gốc—vì lý do bao gồm ngăn chưng cất, an toàn và trải nghiệm sản phẩm, nhà cung cấp thường viết lại hoặc tóm tắt CoT trước khi xuất, ẩn quá trình suy nghĩ gốc có giá trị nhất đằng sau API. Đây chính là lý do thí nghiệm này chọn các mô hình suy luận mã nguồn mở làm giáo viên: các mô hình như DeepSeek V4, Kimi K3 và GLM 5.2 trực tiếp暴露 chuỗi suy nghĩ hoàn chỉnh, khiến việc chưng cất khả thi cả về kỹ thuật và theo giấy phép (mặc dù vẫn nên xác nhận điều khoản giấy phép về sản phẩm chưng cất trước khi sử dụng).
Từ phòng thí nghiệm: mô hình có thể viết code vẫn có thể từ chối giúp chưng cất mô hình khác. Khi triển khai thí nghiệm này, tác giả đầu tiên sử dụng OpenAI Codex chạy trên GPT-5.6-Sol để viết mã thí nghiệm. Khi nhiệm vụ明确涉及 chưng cất mô hình, Codex từ chối tiếp tục. Tác giả sau đó chuyển sang Claude Code chạy trên Claude Opus 5 và gặp cùng sự từ chối. Kimi K3 cuối cùng hoàn thành mã thí nghiệm và chạy tiếp theo.
Cả hai sự từ chối đều không liên quan đến lý luận toán học thông thường hoặc chỉ yêu cầu mô hình tiết lộ chuỗi suy nghĩ nội bộ. Yêu cầu là triển khai một thí nghiệm chưng cất hoàn chỉnh sử dụng dữ liệu từ giáo viên mạnh để huấn luyện học sinh. Chưng cất mô hình về kỹ thuật rất giống với fine-tuning có giám sát thông thường, nhưng chính sách an toàn và sản phẩm của nhà cung cấp cũng có thể liên hệ nó với trích xuất mô hình, nhân rộng năng lực và bảo vệ sở hữu trí tuệ, khiến nó成为一个 danh mục nhạy cảm.
Sự kiện này不应 được đơn giản hóa thành "Claude không cung cấp chuỗi suy nghĩ," cũng không chứng minh rằng "Kimi có hàng rào bảo vệ yếu hơn." Liệu Claude API trả về suy nghĩ tóm tắt, liệu Coding Agent sẽ triển khai pipeline chưng cất, và liệu điều khoản dịch vụ cho phép đầu ra mô hình được sử dụng cho huấn luyện là ba câu hỏi khác nhau. Thí nghiệm này không cố gắng绕过 bất kỳ cơ chế suy luận hoặc an toàn nào của mô hình; nó chỉ sử dụng năng lực được暴露 bởi sản phẩm để tiến hành quy trình nghiên cứu được授权.
Đây là một đánh giá thực tế hơn và quan trọng hơn: đối với đại đa số người làm post-training, không cần chưng cất chuỗi suy nghĩ của mô hình mã nguồn đóng. Khoảng cách giữa các mô hình mã nguồn mở tốt nhất hiện nay và SOTA mã nguồn đóng không lớn như người ta tưởng; mô hình giáo viên chỉ cần "mạnh hơn rõ ràng so với học sinh," chứ không phải "tốt nhất thế giới." Nếu mô hình bạn đang post-training có 200B tham số hoặc nhỏ hơn, mô hình SOTA mã nguồn mở hoàn toàn đủ làm giáo viên.
Thiết kế thí nghiệm: Quy trình ba bước. Bước 1, Thu thập Quỹ đạo: Lấy mẫu vấn đề từ phân phối nhiệm vụ mục tiêu (ví dụ: toán, code), sử dụng mô hình giáo viên mã nguồn mở để tạo các quỹ đạo "suy nghĩ + câu trả lời" hoàn chỉnh, và lọc ra các quỹ đạo có câu trả lời cuối cùng sai bằng trình xác minh dựa trên quy tắc—nếu không, học sinh sẽ bắt chước quá trình suy nghĩ sai. Bước này—"tạo ứng viên, xác minh và lọc, chỉ giữ lại quỹ đạo đúng"—có tên riêng: lấy mẫu loại bỏ (rejection sampling). Thực hiện SFT trên dữ liệu được xây dựng theo cách này là fine-tuning lấy mẫu loại bỏ (RFT). Nó nằm giữa SFT thuần túy và RL: không cần huấn luyện mô hình phần thưởng, không có gradient chính sách—chỉ "lấy mẫu nhiều, loại bỏ cái sai, giữ lại cái đúng" để cải thiện chất lượng dữ liệu, cách xây dựng dữ liệu cực kỳ hiệu quả cho các nhiệm vụ có thể xác minh. Bước 2, Huấn luyện SFT: Sử dụng "vấn đề → quỹ đạo suy nghĩ + câu trả lời cuối cùng" làm cặp huấn luyện để thực hiện SFT tiêu chuẩn trên mô hình nhỏ (ví dụ: quy mô 7B). Bước 3, Đánh giá So sánh: So sánh mô hình học sinh trước và sau chưng cất, cũng như mô hình giáo viên, trên cùng benchmark để đo tỷ lệ năng lực phục hồi.
Tiêu chí chấp nhận: Mô hình học sinh chưng cất cho thấy cải thiện显著 trên các benchmark toán và code so với hiệu suất trước chưng cất, và các quỹ đạo suy nghĩ của nó thể hiện các hành vi giống giáo viên như phản tư, quay lui và xác minh. Ngoài ra, hãy lưu ý chi phí chưng cất: học sinh sẽ kế thừa các lỗi hệ thống và thói quen suy nghĩ冗长 của giáo viên (phần sau có thể được tối ưu hóa thêm bằng phương pháp AdaptThink từ Thí nghiệm 7-10).
Bốn thí nghiệm này có đặc điểm chung—"việc ghi các ánh xạ và quy trình ổn định vào tham số": SFT giọng nói cố định hóa quy trình điều khiển phong cách, SFT đa ngôn ngữ cố định hóa mẫu tổ chức suy nghĩ, và SFT chưng cất cố định hóa ánh xạ trực tiếp từ đầu vào đến đầu ra. Mục tiêu, định dạng và tiêu chí đánh giá càng rõ ràng, SFT càng hiệu quả mẫu cải thiện hiệu suất. Liệu hiệu suất có suy giảm dưới dịch chuyển phân phối hay không vẫn cần được đánh giá cho nhiệm vụ, dữ liệu và mô hình cụ thể; riêng các ví dụ này không thiết lập giới hạn phổ quát cho khái quát hóa SFT.
Các trường hợp xấu từ Chương 6 cũng có thể trở thành dữ liệu huấn luyện. Đối với Agent coding kết thúc quá sớm, cắt tiền tố đường dẫn ngay trước khi nó tuyên bố hoàn thành; sử dụng tuyên bố sớm đó là hành động bị từ chối, và "chạy kiểm tra, kiểm tra từng điều kiện chấp nhận, sau đó kết luận" là hành động được chọn. Điều này phù hợp với DPO hoặc trình diễn ranh giới quyết định hơn là SFT thông thường. Giữ nguyên nguyên nhân thất bại, điều kiện áp dụng và trình xác minh với mỗi mẫu để có thể truy vết và kiểm tra lại. Tệp build_preference_data.py của Thí nghiệm 7-17 cung cấp các mẫu xác định và lộ trình mô hình giáo viên, đồng thời giữ tập huấn luyện và đánh giá tách biệt.
Cùng các nhiệm vụ có thể trở thành môi trường thực hành RL. SFT sử dụng các quỹ đạo đã được xác minh; RL để chính sách hiện tại thử nhiệm vụ lại và để trình xác minh bên ngoài đánh giá kết quả. Theo cách này, các trường hợp xấu xác định ranh giới quyết định mà mô hình phải cải thiện, chứ không chỉ trở thành ví dụ để ghi nhớ.
Khi nào chọn SFT và Khi nào chọn RL
Mục 7.1 đã làm rõ sự khác biệt cốt lõi giữa SFT và RL. Phần này trả lời câu hỏi thực tế hơn: Đối với một nhiệm vụ cụ thể, nên dùng cái nào? Một số kết luận từ khung quyết định dưới đây sẽ được xác nhận thêm trong các thí nghiệm RL tiếp theo (Thí nghiệm 7-10, Thí nghiệm 7-11). Người đọc có thể hình thành đánh giá sơ bộ trước, sau đó quay lại tham chiếu chéo sau khi đọc phần RL.
Hình 7-11: Pipeline huấn luyện hai giai đoạn SFT→RL
SFT phù hợp với các nhiệm vụ yêu cầu ổn định định dạng (như đầu ra JSON hoặc phong cách hội thoại nhất quán), có trình diễn chuyên gia chất lượng cao, và closely khớp môi trường triển khai. RL đáng xem xét khi triển khai khác biệt có hệ thống so với huấn luyện và phần thưởng đáng tin cậy có thể đại diện cho sự khác biệt đó (ví dụ: J/Q/K thay đổi từ 10 thành 11/12/13, hoặc chất đen thay thành chất đỏ), khi chiến lược tối ưu phải được khám phá vì trình diễn có thể không tối ưu, hoặc khi chi phí标注 quá cao để trình diễn mọi đường dẫn.
Khi đầu ra có cấu trúc不稳定, chiến lược mạnh mẽ nhất là pipeline hai giai đoạn "SFT trước, rồi RL." Ở đây, mục tiêu chính của SFT không phải tối đa hóa hiệu suất nhiệm vụ mà là thiết lập ổn định định dạng cho đầu ra—đảm bảo mô hình có thể tạo ra JSON có thể phân tích và lệnh gọi giao diện công cụ đúng. Chỉ sau khi định dạng đầu ra ổn định, tín hiệu phần thưởng RL mới có thể được tính toán đáng tin cậy. Thực hiện RL trực tiếp trên mô hình gốc mà không có SFT thường dẫn đến thất bại huấn luyện do định dạng đầu ra hỗn loạn và phần thưởng không tính được—mặc dù kết luận này có điều kiện ranh giới: nó đến từ thiết lập "mô hình gốc nhỏ hơn + yêu cầu đầu ra có cấu trúc nghiêm ngặt" (như trong Thí nghiệm 7-11 sau). DeepSeek-R1-Zero đã chứng minh rằng mô hình gốc đủ mạnh có thể bỏ qua SFT và thành công với RL trực tiếp, xuất hiện khả năng phản tư và suy luận chuỗi dài—với chi phí là khả năng đọc đầu ra kém và ngôn ngữ hỗn hợp, đó chính là lý do cuối cùng DeepSeek đã thêm lại "SFT khởi động lạnh" trong R1. Vòng đi về của R1 từ Zero đến khởi động lạnh cho thấy, khi đầu ra có cấu trúc不稳定, SFT có thể nhanh chóng thiết lập "hình thức" (định dạng và khả năng đọc), sau đó RL có thể phát triển "tinh thần" (chiến lược và năng lực suy luận) khi có phần thưởng đáng tin cậy.
Mỗi phương pháp có chi phí riêng: SFT hiệu quả mẫu và hội tụ nhanh, trong khi khái quát hóa phụ thuộc nhiều vào độ phủ và tính đa dạng của dữ liệu. RL có thể khám phá các chiến lược không có trong trình diễn, nhưng tốn mẫu và不稳定 khi huấn luyện. Nếu thêm các trình diễn đa dạng, chất lượng cao không còn cải thiện hiệu suất kịch bản mới, và các kịch bản đó có thể được đánh giá bằng phần thưởng và môi trường đáng tin cậy, RL đáng xem xét.
Trong thực tế, quyết định có thể được đưa ra theo thứ tự sau:
Trước tiên hỏi: Có cần post-training không? Nếu vấn đề có thể giải quyết thông qua kỹ thuật Harness (tối ưu hóa Prompt, thiết kế công cụ, quản lý Context), không cần huấn luyện mô hình. Hầu hết ứng dụng Agent thuộc loại này.
Nếu cần huấn luyện: Thử SFT trước. Phù hợp cho cố định hóa định dạng đầu ra (lược đồ JSON, định dạng gọi API), cố định hóa kiến thức quy trình (sử dụng thuật ngữ, định dạng đầu ra, thói quen quy trình, tức "cách nói và làm"), và thống nhất phong cách (giọng điệu, độ dài). Nhưng lưu ý rằng SFT không phù hợp cho注入 lượng lớn kiến thức事实 ("biết gì")—điều đó yêu cầu pre-training tiếp tục hoặc RAG (xem "Toàn cảnh post-training hoàn chỉnh và mẹo thực tế" ở cuối chương). SFT chi phí thấp và nhanh thấy kết quả.
Khi SFT không đủ: Thêm RL. Phù hợp khi nhiệm vụ yêu cầu khái quát hóa sang tình huống mới, khám phá chiến lược tối ưu, hoặc khi chi phí标注 quá cao. Nếu đầu ra chưa đáp ứng đáng tin cậy định dạng hàm phần thưởng, ổn định hóa trước bằng SFT hoặc giải mã bị ràng buộc; mô hình gốc mạnh đã đáp ứng định dạng cũng có thể huấn luyện RL trực tiếp.
Reinforcement Learning Một Lượt: So sánh Ghi nhớ và Khái quát hóa
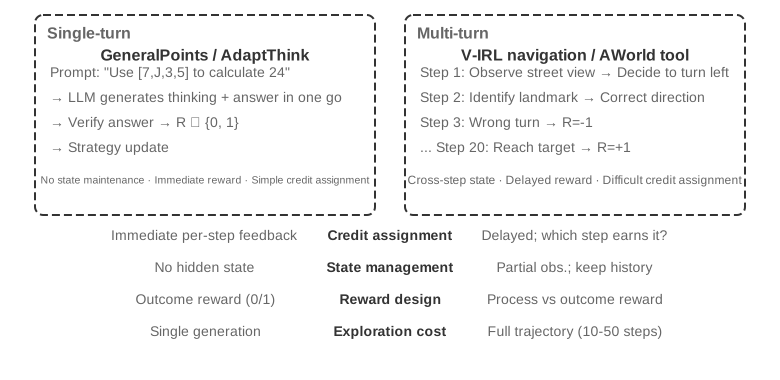
"Một lượt" nghĩa là nhiệm vụ hoàn thành trong một lần tương tác: mô hình nhận đầu vào, tạo đầu ra, và nhận phần thưởng, không cần duy trì trạng thái across các bước. Thiết lập đơn giản hóa này cho phép chúng ta tập trung vào sự khác biệt cơ bản trong cơ chế học giữa SFT và RL, mà không có sự phức tạp của tương tác đa lượt. Kịch bản một lượt cung cấp điều kiện thí nghiệm có kiểm soát rõ ràng: cùng nhiệm vụ, cùng mô hình gốc, cùng ngân sách tính toán, với biến số duy nhất là phương pháp huấn luyện. Thí nghiệm đầu tiên chứng minh cách RL học siêu chiến lược "khi nào nên suy nghĩ"; thí nghiệm thứ hai sử dụng trò chơi thẻ suy luận số học để định lượng có hệ thống "SFT ghi nhớ, RL khái quát hóa."
Trước các thí nghiệm, hãy xây dựng một số trực giác tối thiểu về thuật toán RL, đủ để theo dõi các thuật ngữ xuất hiện (công thức đầy đủ và so sánh đợi đến phần "So sánh các thuật toán học tăng cường" sau trong chương này). Huấn luyện RL trong chương này chủ yếu dựa trên gradient chính sách: mô hình tạo nhiều phản hồi cho cùng vấn đề, tăng xác suất của các phản hồi phần thưởng cao và giảm xác suất của các phản hồi phần thưởng thấp—di chuyển xa hơn theo hướng có thưởng và ít hơn theo hướng không thưởng. Để ngăn một cập nhật lớn duy nhất làm hỏng mô hình, PPO mainstream cắt bớt lợi nhuận bổ sung trong mục tiêu thay thế khi tỷ lệ xác suất nằm ngoài phạm vi xác định; điều này ngăn thay đổi lớn nhưng không đặt ràng buộc cứng trên khoảng cách chính sách (các thí nghiệm sau sử dụng "PPO với mạng giá trị," mạng giá trị ước tính đường cơ sở cho lợi thế chi tiết hơn). Phương pháp còn lại, GRPO, không huấn luyện mạng giá trị; thay vào đó nó so sánh nhiều phản hồi cho cùng vấn đề để đánh giá chất lượng tương đối của mỗi phản hồi. Trực giác đó là tất cả những gì bạn cần cho hai thí nghiệm tiếp theo.
Thí nghiệm 7-10 ★★: AdaptThink—Học "Khi nào Không nên Suy nghĩ"
Các mô hình suy luận lớn (ví dụ: OpenAI o1, DeepSeek-R1) tạo chuỗi suy nghĩ dài cho tất cả vấn đề, gây ra overhead không cần thiết trên vấn đề đơn giản. Thí nghiệm trước tiên xác minh một trực giác: chế độ NoThinking (bỏ qua suy nghĩ qua ) hoạt động tương đương hoặc thậm chí tốt hơn trên vấn đề đơn giản; chỉ khi đối mặt vấn đề khó, ưu thế của chế độ Thinking mới显现 rõ.
AdaptThink sử dụng RL để huấn luyện mô hình thích ứng chọn chế độ. Hai thành phần cốt lõi:
Mục tiêu tối ưu hóa bị ràng buộc: Khuyến khích NoThinking trong khi đảm bảo hiệu suất tổng thể không suy giảm.
Chiến lược lấy mẫu quan trọng: Cân bằng mẫu Thinking và NoThinking để giải quyết vấn đề khởi động lạnh (ở đây, khởi động lạnh cụ thể đề cập đến mô hình ban đầu几乎 luôn chọn Thinking, để nhánh NoThinking quá ít mẫu để học hiệu quả; điều này khác với việc sử dụng "SFT khởi động lạnh" trước đó cho DeepSeek-R1, liên quan đến một số lượng nhỏ ví dụ trình diễn).
"Lấy mẫu quan trọng" được đề cập ở đây là phương pháp thống kê phổ biến—khi phân phối lấy mẫu偏 về một lớp mẫu nào đó, trọng số được áp dụng cho các mẫu để "sửa" phân phối, đảm bảo rằng tín hiệu học tập công bằng覆盖 tất cả các lớp. Ý tưởng này được sử dụng反复 trong các thuật toán RL như PPO và DAPO được thảo luận sau trong cuốn sách này.
Bản ghi chính thức của lần chạy huấn luyện lịch sử này là báo cáo huấn luyện không checkpoint. W&B chạy chính công khai wubbn5tj sử dụng 8×NVIDIA H100 80GB GPU. Từ bước 0→300, MATH500 accuracy thay đổi từ 0.8100→0.8180 (+0.80 pp) trong khi độ dài phản hồi thay đổi từ 4911.46→1576.62 (-67.90%); GSM8K thay đổi từ 0.796816→0.818802 (+2.20 pp) và 1025.24→477.33 (-53.44%); và AIME mean@16 thay đổi từ 0.314583→0.310417 (-0.42 pp) và 12119.51→6402.23 (-47.17%). Các tỷ lệ NoThinking tương ứng là 83.80%, 84.15% và 56.25%. Các kết quả này cho thấy tín hiệu định tuyến aligned với độ khó ở cấp tập dữ liệu tổng hợp, nhưng chúng không biện minh cho việc gọi nó là "nhận thức độ khó hoàn hảo" trên mọi vấn đề hoặc tuyên bố rằng accuracy cải thiện phổ quát.
Sau điểm đo lường được chọn trong báo cáo, lần chạy tiếp tục đến bước 410 và 36.92 giờ tích lũy trước khi W&B đánh dấu là crashed; 10 epoch / 3.140 bước đã cấu hình chưa hoàn thành. Mặc dù bước 300 chứa sự kiện thời gian checkpoint, checkpoint không được phân phối cùng cuốn sách, và không có biên nhận独立 chứng minh nó được đánh giá thành công với run_eval_verl_hf.sh hoặc được sử dụng để chạy lại MMLU. Commit nguồn lịch sử là 9e588202…; các lần tái tạo tương lai được ghim vào commit con trực tiếp 0033ad172…. Ba tệp điểm vào không thay đổi, nhưng đường dẫn -fl- được tạo bởi script huấn luyện không tương thích với đường dẫn -fl4096 được mã hóa cứng trong script đánh giá và phải được sửa thủ công.
Cùng với chưng cất Prompt, AdaptThink tạo thành "hệ thống kép nhanh-chậm": chưng cất giảm tỷ lệ nhiệm vụ yêu cầu suy nghĩ, trong khi AdaptThink tối ưu hóa chiến lược kích hoạt cho các nhiệm vụ còn lại, cùng tối đa hóa hiệu quả suy nghĩ.
Thí nghiệm 7-11 ★★: GeneralPoints—So sánh "Ghi nhớ và Khái quát hóa" trong RL Một Lượt
Hình 7-12: Kiến trúc thí nghiệm GeneralPoints
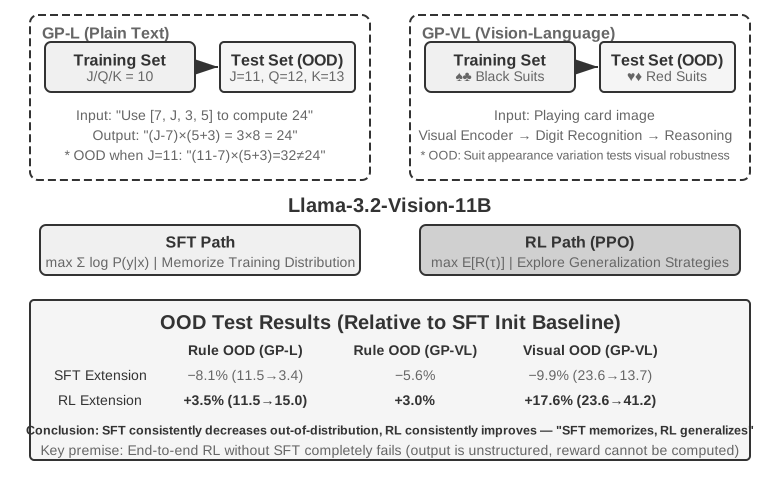
GeneralPoints là trò chơi thẻ suy luận số học được đề xuất bởi Chu và cộng sự (2025, "SFT Memorizes, RL Generalizes," arXiv:2501.17161), được thiết kế đặc biệt để đánh giá khái quát hóa mô hình. Mục tiêu tương tự "Trò chơi 24": sử dụng mỗi trong bốn số hiện trên thẻ đúng một lần, kết hợp chúng với cộng, trừ, nhân và chia để đạt số mục tiêu 24. Thí nghiệm thiết kế hai biến thể: GP-L chỉ văn bản và GP-VL dựa trên hình ảnh, cho phép chúng ta kiểm tra khái quát hóa quy tắc và khái quát hóa thị giác trong cùng khung.
Biến thể Quy tắc: Trong huấn luyện, J/Q/K đều được tính là 10; trong kiểm tra, chúng được tính là 11/12/13 tương ứng, đảm bảo tập kiểm tra chứa các组合 số chưa thấy (thao tác liên quan đến 11, 12, 13) để đánh giá严格 khái quát hóa. Biến thể Thị giác: Huấn luyện sử dụng chất đen (♠♣), kiểm tra sử dụng chất đỏ (♥♦), để đánh giá tính mạnh mẽ với thay đổi外表 thị giác. Sử dụng Llama-3.2-Vision-11B, thí nghiệm theo pipeline post-training tiêu chuẩn: trước tiên, khởi tạo SFT cho mô hình khả năng tuân thủ hướng dẫn cơ bản; sau đó, dưới cùng ngân sách tính toán, mô hình trải qua huấn luyện SFT và RL bổ sung trong các nhánh riêng biệt, với PPO và mạng giá trị được sử dụng cho RL. Cả hai nhánh được huấn luyện trên dữ liệu sử dụng quy tắc đơn J/Q/K=10 và đánh giá trên tập kiểm tra trong phân phối (ID) và ngoài phân phối (OOD).
Kết quả cho thấy sự khác biệt rõ ràng trong thiết lập có kiểm soát này. Quy tắc OOD: RL cải thiện +3.5 phần trăm trên GP-L (11.5%→15.0%), trong khi SFT giảm 8.1 phần trăm (11.5%→3.4%); trên GP-VL, RL cải thiện +3.0 phần trăm, trong khi SFT giảm 5.6 phần trăm. Thị giác OOD: RL cải thiện +17.6 phần trăm trên GP-VL (23.6%→41.2%), trong khi SFT giảm 9.9 phần trăm (23.6%→13.7%).
Theo dõi accuracy nhận diện thị giác cho thấy RL cải thiện bộ mã hóa thị giác底层 thông qua tối ưu hóa hướng kết quả, và sự cải thiện này tương quan cao với lợi nhuận hiệu suất tổng thể; ngược lại, SFT quá khớp với các mẫu Token trong quá trình suy nghĩ, bỏ qua học Token thị giác, dẫn đến giảm accuracy nhận diện.
Thí nghiệm cũng cho thấy RL yêu cầu khởi tạo SFT trong thiết lập này: với mô hình gốc ở quy mô Llama-3.2-Vision-11B và yêu cầu đầu ra có cấu trúc nghiêm ngặt, RL đầu-cuối mà không có SFT thất bại hoàn toàn vì mô hình gốc không thể tạo ra đầu ra có cấu trúc có thể chấm điểm. Đây là cụ thể cho thiết lập, không phải quy luật phổ quát; mô hình gốc đủ mạnh có thể bỏ qua SFT và thành công với RL trực tiếp (xem thảo luận trước về DeepSeek-R1-Zero). Một phát hiện值得注意 khác là, trong thí nghiệm này, nhiều vòng lặp xác minh tạo ra khái quát hóa đo được tốt hơn: 10 vòng lặp cho +5.99% so với +0.48% cho một vòng lặp, khiến thời gian tính toán kiểm tra成为 nhân tố quan trọng trong lợi nhuận quan sát.
Tại sao SFT suy giảm dưới dịch chuyển phân phối của thí nghiệm này trong khi RL hoạt động tốt hơn? Một giải pháp nhất quán với các quan sát là dữ liệu SFT有限 đã củng cố mẫu cố định "coi J/Q/K là 10," mẫu này vẫn hoạt động khi J thay đổi thành 11. Nhánh RL được huấn luyện kết quả có nhiều khả năng củng cố chiến lược tính lại cho đến khi đạt kết quả đúng, cho phép cùng quy trình áp dụng sau khi quy tắc thay đổi. Điều này giải thích sự tương phản ghi nhớ-khái quát hóa của thí nghiệm; nó không意味着 SFT chỉ có thể ghi nhớ hoặc RL phải học thuật toán phổ quát.
Đóng góp cốt lõi của thí nghiệm này là định lượng có hệ thống, trong thiết lập GeneralPoints有限, xu hướng quá khớp của SFT và hiệu suất ngoài phân phối tốt hơn của RL, với cùng mẫu được quan sát trong cả biến thể chỉ văn bản và thị giác-ngôn ngữ. Trong thiết lập này, SFT ổn định định dạng và RL khám phá chiến lược trên nền tảng đó, khiến hai phương pháp bổ sung cho nhau. Mượn từ hội họa Trung Quốc, cấu hình huấn luyện "hình thức trước, tinh thần sau" này thiết lập hình thức bên ngoài (định dạng và cấu trúc) trước khi tinh chỉnh chiến lược bên trong, cung cấp tham chiếu phương pháp luận cho các nhiệm vụ đa lượt và đa phương thức sau.
RLHF: Từ Preference Con người đến Mô hình Phần thưởng
Các thí nghiệm trước có tiền đề chung: các nhiệm vụ có tính chính xác có thể xác minh—dù công thức đúng hay định dạng tuân thủ, trình xác minh dựa trên quy tắc có thể chấm điểm. Tuy nhiên, các mô hình hội thoại được triển khai hôm nay hoạt động như "trợ lý decent, an toàn" nhờ một dòng công việc khác đã trưởng thành sớm hơn: RLHF (Reinforcement Learning from Human Feedback). Hiểu RLHF là chìa khóa để hiểu chất lượng hội thoại và liên kết an toàn của các sản phẩm như ChatGPT đến từ đâu, cũng như điều kiện tiên quyết để hiểu các khái niệm như hình phạt KL và reward hacking trong các thuật toán được thảo luận sau.
Pipeline Ba Giai đoạn của InstructGPT. InstructGPT của OpenAI đã thiết lập quy trình tiêu chuẩn vẫn được sử dụng至今:
SFT: Fine-tune mô hình pre-training trên các cặp "hướng dẫn-phản hồi" do con người trình diễn để thiết lập khả năng tuân thủ hướng dẫn cơ bản—đây là nội dung đã thảo luận trong phần "SFT (Supervised Fine-Tuning)" trước đó.
Huấn luyện Mô hình Phần thưởng (RM): Đối với cùng Prompt, để mô hình tạo nhiều phản hồi, và người标注 so sánh chúng theo cặp, chỉ ra phản hồi nào họ偏好 hơn. Huấn luyện mô hình chấm điểm bằng các cặp preference này, với mục tiêu huấn luyện dựa trên mô hình Bradley-Terry:
trong đó $y_w$ là phản hồi được偏好, $y_l$ là phản hồi bị từ chối, và $sigma$ là hàm sigmoid. Trực giác rất đơn giản: làm cho RM cho điểm cao hơn cho phản hồi được偏好. Lý do thu thập so sánh thay vì điểm số là con người很难 consistently cho điểm tuyệt đối ("phản hồi này được 7.3"几乎 không thể标注 consistently), nhưng đánh giá "cái nào tốt hơn, A hay B" đáng tin cậy hơn nhiều. Hãy ghi nhớ vai trò của "mô hình phần thưởng"—nó là chủ đề贯穿 xuyên suốt chương này: ở đây, nó là trình chấm điểm học từ preference con người; khi chúng ta đến Mục 7.10 về thiết kế phần thưởng, bạn sẽ thấy các dạng khác nhau của nó (ORM chỉ xem kết quả cuối cùng, PRM chấm điểm từng bước, mô hình phần thưởng sinh tạo cung cấp lý luận bằng ngôn ngữ tự nhiên), và một trường hợp đặc biệt—khi tính chính xác có thể được xác định trực tiếp bằng quy tắc, "mô hình phần thưởng" đơn giản thoái hóa thành một đoạn mã xác định (đây là những gì RLVR, được thảo luận dưới đây, là). Chúng đều trả lời cùng một câu hỏi: phần thưởng đến từ đâu?
Sử dụng điểm RM cho PPO: Sử dụng điểm RM làm tín hiệu phần thưởng, thực hiện huấn luyện PPO trên mô hình SFT (cơ chế PPO được giải thích trong phần tiếp theo), cho phép mô hình học tạo ra phản hồi mà RM tin rằng "con người sẽ偏好."
Hình phạt KL: Đừng đi quá xa khỏi Điểm xuất phát (Giải thích KL Divergence kỹ lưỡng). Trong RLHF, phần thưởng mà mô hình thực sự tối ưu hóa thường không phải là điểm RM本身, mà là một khoản trừ hình phạt:
Công thức đơn giản này đặt ra bốn câu hỏi phổ biến từ người mới, chúng tôi sẽ giải quyết từng cái một.
(1) KL divergence là gì, và hình phạt được áp dụng ở đâu? KL divergence (Kullback-Leibler Divergence) đo sự khác biệt giữa hai phân phối xác suất: hai phân phối càng giống nhau, KL càng nhỏ, đạt 0 khi giống hệt; càng khác, KL càng lớn. Ở đây các phân phối là phản hồi được tạo bởi chính sách hiện tại $\pi_\theta$ (mô hình đang được huấn luyện) và chính sách tham chiếu $\pi_{\text{ref}}$ (điểm bắt đầu huấn luyện, thường là mô hình SFT) dưới cùng ngữ cảnh phía trước. $\beta$ kiểm soát độ mạnh hình phạt—siêu tham số kl_coef thường thấy trong script huấn luyện. Đối với chính sách tự hồi quy, KL cấp phản hồi có thể được viết dưới dạng kỳ vọng, dưới chính sách hiện tại, của tổng tỷ lệ log-xác suất Token:
Trong thực tế, huấn luyện thường tính tỷ lệ log này tại mỗi Token được lấy mẫu dưới dạng $y_t\sim\pi_\theta(\cdot\mid x,y_{
(2) Tại sao hướng là "chính sách hiện tại trước, chính sách tham chiếu sau"? KL divergence là bất đối xứng, $\mathrm{KL}(P\|Q)\neq\mathrm{KL}(Q\|P)$, nên hướng không tùy tiện. Ở đây nó được viết là $\mathrm{KL}(\pi_\theta\|\pi_{\text{ref}})$—chính sách hiện tại trước. Theo quy ước coi phân phối tham chiếu là mục tiêu và chính sách hiện tại là xấp xỉ, đây được gọi là reverse KL. Vì nó đo tỷ lệ log-xác suất trên các phản hồi mà chính sách hiện tại có khả năng tạo ra, nó trực tiếp ngăn chính sách tìm kiếm phần thưởng di chuyển quá xa khỏi mô hình khởi đầu. Chính sách tham chiếu không inherently an toàn, nhưng nó hoạt động như neo cho phân phối ngôn ngữ và định dạng mà huấn luyện bắt đầu. Hướng ngược lại, $\mathrm{KL}(\pi_{\text{ref}}\|\pi_\theta)$, gây áp lực mạnh hơn lên chính sách hiện tại để覆盖 các vùng mà tham chiếu gán xác suất. Hướng nào phù hợp phụ thuộc vào mục tiêu và xấp xỉ; ở đây chúng tôi mô tả hướng thường được sử dụng để regularization các chính sách RLHF.
(3) Khi nào tìm kiếm chế độ xuất hiện? Khi một họ phân phối bị giới hạn xấp xỉ mục tiêu đa chế độ, reverse KL có thể thể hiện xu hướng tìm kiếm chế độ vì nó gán chi phí cao cho việc đặt khối lượng trong các vùng xác suất thấp. Nhưng chính sách RLHF jointly tối ưu hóa thuật ngữ phần thưởng và regularization KL, nên riêng reverse KL không đảm bảo chỉ chọn một vài chế độ hoặc giảm多样性. Tính đa dạng thực tế cũng phụ thuộc vào mô hình phần thưởng, hệ số KL, quy trình lấy mẫu và tính biểu đạt của chính sách. Mục đích chính của thuật ngữ KL ở đây không phải là ép buộc một kiểu phản hồi cụ thể, mà là giới hạn dịch chuyển quá xa khỏi phân phối tham chiếu trong quá trình tối ưu hóa phần thưởng.
(4) Điều gì xảy ra nếu không có nó? Trực giác đơn giản: Đừng đi quá xa khỏi điểm xuất phát, nếu không điểm số của mô hình phần thưởng trở nên không đáng tin cậy. RM được huấn luyện trên phân phối đầu ra gần chính sách tham chiếu. Khi mô hình được tối ưu hóa đến phân phối mà RM chưa từng thấy, điểm số RM trở thành ngoại suy không có cơ sở, và điểm cao không còn bằng chất lượng cao. Do đó, hình phạt KL ngăn hai thứ cùng lúc: reward hacking (mô hình khai thác lỗ hổng trong phần thưởng để được điểm cao mà không thực sự hoàn thành nhiệm vụ tốt, xem đoạn tiếp theo) và sụp đổ phân phối (thoái hóa đầu ra thành dạng极端 như lặp lại hoặc vô nghĩa). Ngay cả trong huấn luyện RLVR với phần thưởng có thể xác minh, regularization KL thường được保留 để ổn định huấn luyện (một số công trình như DAPO và Open-Reasoner-Zero cố tình loại bỏ nó—lưu ý rằng GRPO của DeepSeek-R1-Zero本身 vẫn bao gồm thuật ngữ KL một cách tường minh).
Mô hình Phần thưởng có thể "Quá Tối ưu hóa." RM rốt cuộc chỉ là chỉ số代理 của preference con người. Định luật Goodhart phát biểu: khi một chỉ số trở thành mục tiêu tối ưu hóa, nó ngừng là chỉ số tốt—đẩy proxy đến cực đoan làm méo mối tương quan với mục tiêu thực sự. Nghiên cứu của OpenAI đã đo lường có hệ thống hiện tượng quá tối ưu hóa mô hình phần thưởng này: khi huấn luyện RL tiến triển, phần thưởng proxy (điểm RM) tăng đơn điệu, trong khi chất lượng thực sự (đánh giá con người) đầu tiên tăng rồi giảm. Điều mô hình dần học không phải là trả lời tốt hơn mà là làm cho RM chấm điểm cao—lời nói dài dòng, nịnh bợ, nghe nghiêm túc nhưng rỗng. Đây là dạng cụ thể của reward hacking trong bối cảnh RLHF, và hình phạt KL và dừng sớm là các phương pháp giảm thiểu phổ biến nhất; vấn đề reward hacking trong phần "Cạm bẫy phổ biến" ở cuối chương có cùng nguồn gốc.
DPO: Bỏ qua Mô hình Phần thưởng tường minh. DPO (Direct Preference Optimization) bắt đầu từ tiền đề: vì sự kết hợp "huấn luyện RM + PPO" cuối cùng dẫn đến "tăng xác suất của phản hồi được偏好 và giảm xác suất của phản hồi bị từ chối, trong khi không đi quá xa khỏi mô hình tham chiếu," tại sao không bỏ qua RM tường minh và trực tiếp biến các cặp preference thành hàm phân loại với phần thưởng ẩn? Về mặt toán học, có thể chứng minh rằng điều này tương đương với tối ưu hóa preference ngoại tuyến với ràng buộc KL, trong đó mô hình phần thưởng được nhúng ẩn trong chính bản thân chính sách. Huấn luyện DPO đơn giản như SFT: không lấy mẫu trực tuyến, không mạng giá trị, không cần duy trì RM riêng. Chi phí là nó hoàn toàn ngoại tuyến—nó không thể khám phá hành vi mới ngoài dữ liệu preference, và trần hiệu suất được xác định bởi chất lượng và độ phủ của dữ liệu preference.
Mối quan hệ giữa RLHF và RLVR. Tóm lại, sự khác biệt giữa hai phương pháp nằm ở nơi phần thưởng đến từ đâu: phần thưởng của RLHF đến từ RM đã học (được hỗ trợ bởi dữ liệu preference con người), trong khi RLVR (Reinforcement Learning with Verifiable Rewards) sử dụng trình xác minh dựa trên quy tắc (liệu kiểm tra có passed, câu trả lời có đúng). Các nhiệm vụ Agent恰好大部分 có thể xác minh—đây chính là lý do chương này tập trung vào RLVR làm chủ đề chính. Tuy nhiên, không phải là vấn đề chọn cái này hay cái kia; các mô hình được triển khai trong thực tế sử dụng kết hợp cả hai: RLHF xử lý chất lượng hội thoại và liên kết an toàn, trong khi RLVR xử lý năng lực suy luận và Agent. Phần "Tiến hóa của Paradigm Phần thưởng" sau thảo luận các mô hình phần thưởng sinh tạo, có thể được xem là giao điểm của hai dòng này—sử dụng mô hình phần thưởng có thể huấn luyện để xử lý các nhiệm vụ mở mà quy tắc không thể覆盖.
Từ Single-Turn đến Multi-Turn: Credit Assignment và Thiết kế Phần thưởng
Thách thức Cốt lõi của Nhiệm vụ Multi-Turn
Hình 7-14: So sánh Single-Turn RL và Multi-Turn RLHình 7-15: Credit Assignment trong Tương tác Multi-Turn
Chuyển từ single-turn sang multi-turn liên quan đến một bước nhảy định tính về độ phức tạp. Chính sách không chỉ phải chọn hành động tối ưu cho bước hiện tại mà còn phải xem xét giá trị trạng thái tương lai; nó không chỉ phải xử lý phản hồi tức thì mà còn phải thực hiện Credit Assignment dưới phần thưởng bị trễ—xác định bước nào trong chuỗi nhiều bước đóng góp nhiều nhất vào kết quả cuối cùng. Ví dụ, một Agent dịch vụ khách hàng giải quyết vấn đề của người dùng sau 10 lượt đối thoại và nhận được đánh giá tích cực—nhưng đánh giá tích cực này nên được quy cho việc đặt câu hỏi chính xác ở lượt 2 hay giải thích kiên nhẫn ở lượt 7?
Tương tác multi-turn được thảo luận ở đây có dạng vòng lặp ReAct được mô tả trong Chương 1 và 4: mỗi lượt là một lần lặp của Think → Act → Observe, và sự trễ phần thưởng phát sinh từ ràng buộc cấu trúc rằng "kết quả cuối cùng chỉ có thể được đánh giá sau nhiều lượt."
Mật độ và Paradigm của Tín hiệu Phần thưởng
Thiết kế phần thưởng được thảo luận trong phần này cũng áp dụng cho các nhiệm vụ single-turn; nó được đặt trong phần multi-turn vì độ khó của credit assignment trong các kịch bản multi-turn nâng "mật độ phản hồi dày đặc như thế nào và ở dạng gì" từ một lựa chọn thành yếu tố quyết định thành công. Tín hiệu phần thưởng có hai chiều thiết kế: Density (tần suất phản hồi được đưa ra—binary/sparse/process reward) và Representation Form (dạng phản hồi trông như thế nào—scalar/vector/generative).
Trước khi thảo luận thiết kế phần thưởng multi-turn, hãy phác thảo có hệ thống không gian thiết kế cho tín hiệu phần thưởng. Đây là một chủ đề cốt lõi cho training RL và closely liên quan đến đánh giá tự động được thảo luận trong Chương 6—một môi trường đánh giá được thiết kế cẩn thận thường có thể được chuyển đổi thành một môi trường training chất lượng cao. Tuy nhiên, điều quan trọng là phân biệt hai thứ: "Môi trường đánh giá có thể được tái sử dụng" không có nghĩa là "dữ liệu đánh giá cụ thể này có thể được sử dụng trực tiếp cho training."
Hãy xem ba ví dụ. SWE-bench cung cấp một điển hình cho sự chuyển đổi này: SWE-Gym được xây dựng dựa trên nó để tạo một tập nhiệm vụ có thể train được (mô tả vấn đề làm input, patch làm tín hiệu giám sát, test case cung cấp tín hiệu phần thưởng)—nhưng dữ liệu sử dụng cho training là tập nhiệm vụ mới được xây dựng, trong khi tập đánh giá 500 câu hỏi SWE-Bench Verified, được tuyển chọn thủ công bởi OpenAI, phải được cách ly nghiêm ngặt khỏi dữ liệu training. Khi trộn vào tập training, đánh giá trở nên vô nghĩa (đây là sự căng thẳng được thảo luận trong Câu hỏi Tư duy 10 ở cuối chương này). Bản ghi trajectory hoàn chỉnh của τ²-bench (lịch sử đối thoại, gọi công cụ, thay đổi trạng thái) cung cấp dữ liệu có giá trị cho imitation learning—các trajectory thành công làm mẫu dương, và các trajectory thất bại, sau khi gán nhãn, làm mẫu âm. Các template được tham số hóa của AndroidWorld có thể tạo vô số biến thể theo lô, tự nhiên hỗ trợ curriculum learning—tiến trình từ các thao tác đơn bước đơn giản đến các workflow phức tạpcross-ứng dụng.
Những ví dụ này chỉ ra cùng một kết luận: Chất lượng tín hiệu phần thưởng được cung cấp bởi môi trường đánh giá trực tiếp quyết định hiệu quả của training RL—với điều kiện dữ liệu sử dụng cho training được tách biệt khỏi dữ liệu sử dụng cho đánh giá.
Hình 7-16: Phổ Mật độ Phần thưởng
Kịch bản Áp dụng cho Binary Reward.
Đối với nhiều nhiệm vụ, binary reward đơn giản nhất (success=1, failure=0) là đủ. Ví dụ, trong "trả lời bài toán toán học," câu trả lờihoặc đúnghoặc sai, không có vùng xám; trong "thực thi truy vấn SQL," kết quả trả vềhoặc khớp kỳ vọnghoặc không. Đối với các nhiệm vụ có câu trả lời đúng rõ ràng, binary reward đơn giản và đáng tin cậy, không cần thiết kế phức tạp hơn.
Vấn đề phát sinh với các nhiệm vụ mở không có câu trả lời đúng rõ ràng.
Thế tiến thoưỡng lưỡng nan của Sparse Reward.
Xem xét Agent gọi điện thoại của Pine AI. Khi nó được train với binary reward (success = 1, failure = 0) để gọi Xfinity và đổi gói cước, nó quên thu thập số tài khoản trong lần thử đầu tiên—thất bại, reward 0; quên bốn chữ số cuối thẻ tín dụng lần thứ hai—thất bại, reward 0; bỏ sót địa chỉ thanh toán lần thứ ba—thất bại, reward 0... Chỉ sau 100 lần thử nó mới tình cờ đạt được thành công.
Gốc rễ của vấn đề, như Silver và Sutton chỉ ra trong "Welcome to the Era of Experience"[^ch7-8], là các phương pháp RL hiện tại chỉ có thể học từ kết quả cuối cùng của thành công hay thất bại nhưng không thể học từ phản hồi phong phú được cung cấp bởi môi trường. Nhân viên dịch vụ khách hàng nói rõ ràng, "Tôi cần bốn chữ số cuối thẻ tín dụng của bạn." Con người nghe một lần và nhớ; RL chỉ thấy "thất bại" cuối cùng và không bao giờ học tại sao. Tệ hơn: trong quy trình 10 bước, ngay cả khi chín bước đầu hoàn hảo và chỉ bước thứ mười sai, tín hiệu vẫn chỉ là "toàn bộ nhiệm vụ thất bại"—không có cách nào biết bước nào có lỗi. Các kỹ thuật nâng cao sau trong chương này—On-Policy Distillation và verified path penalty (RLVP)—được thiết kế để giảm bớt thế tiến thoưỡng lưỡng nan này.
"Hoàn thành sớm" là một ví dụ cụ thể. Khi model nói nhiệm vụ đã xong, Harness chạy acceptance test trong một workspace biệt lập mà model không thể thấy. Chỉ có pass mới nhận được phần thưởng dương; failure nhận phần thưởng âm. Test phải kiểm tra tệp hoặc trạng thái môi trường thực, không chỉ cụm từ "hoàn thành," nếu không model có thể học cách hứa xác minh mà không thực hiện. Giữ các trường hợp biên của nhiệm vụ chưa hoàn thành tách biệt với các trường hợp holdout thực sự đã hoàn thành:cái trước đo lường kết thúc sớm, trong khicái sau kiểm tra rằng model vẫn có thể đóng một nhiệm vụ bình thường thay vì học cách không bao giờ dừng.
Process Reward cung cấp phản hồi tức thì cho mỗi bước quan trọng trong quá trình thực thi, chuyển đổi đánh giá từ hộp đen sang hộp trắng. Ví dụ, trong tạo code, nó có thể đánh giá riêng các giai đoạn như hiểu yêu cầu, tìm kiếm code, thiết kế giải pháp, viết code, và chạy test; trong kịch bản dịch vụ khách hàng, nó có thể kiểm tra liệu các bước như xác minh danh tính, truy vấn thông tin, xác nhận, và thanh toán có đúng không. Tuy nhiên, process reward đối mặt với các thách thức như chi phí gán nhãn cao và khả năng quá hạn chế sự đổi mới, và trong thực tế chúng cần được kết hợp với outcome reward.
Sự Tiến hóa của các Paradigm Phần thưởng.
Hình 7-17: Sự Tiến hóa của các Paradigm Phần thưởng
Nghiên cứu của DeepSeek (Liu et al., 2025) phân tích có hệ thống sự khác biệt trong tín hiệu học tập trên các paradigm phần thưởng dọc theo phổ scalar-semi-scalar-generative. Xây dựng trên cơ sở đó, cuốn sách này thêm một chiều vector (đa chiều). Để làm cho sự khác biệt giữa các paradigm này trực quan, chúng ta quay lại kịch bản trước đó trong đó Pine AI gọi Xfinity để đổi gói cước. Lần này, Agent hoàn thành nhiệm vụ nhưng có khuyết điểm: nó bỏ sót địa chỉ thanh toán, phải được thêm vào, và nói sai tên gói cước là "Performance Plus" thay vì "Performance Pro" (các điểm số sau đây mang tính minh họa):
Paradigm Scalar: Cho điểm 7.2—không có khả năng chẩn đoán, không có insight vào việclàm tốt hay kém. Paradigm Semi-Scalar: Phân tích trước điểm mạnh và yếu, sau đó cho điểm 6.5—cung cấp cơ sở, nhưng thông tin vẫn còn hạn chế. Paradigm Vector (chiều được thêm bởi cuốn sách này): Chấm điểm riêng nhiều chiều—Độ chính xác Truy vấn Thông tin 9/10, Tính đầy đủ Thu thập Thông tin 6/10, Độ trôi chảy Giao tiếp 8/10, Độ chính xác Giao tiếp 7/10, Độ chính xác Giao tiếp Người dùng 10/10, Hoàn thành Nhiệm vụ Tổng thể 8/10. Giống như báo cáo kiểm tra y tế, chính xác xác định vấn đề ("Thu thập Thông tin" chỉ đạt 6, cho thấy prompt cho giai đoạn thu thập nên được tối ưu hóa).
Paradigm Generative: Cung cấp mô tả chi tiết bằng ngôn ngữ tự nhiên và hỗ trợ sample lặp lại để phân tích cùng một thực thi từ các góc độ khác nhau. Để minh họa, đánh giá cùng một thực thi nhiều lần có thể tạo ra các phân tích bao gồm các khía cạnh khác nhau; sử dụng các chẩn đoán này cùng nhau để hướng dẫn cải tiến có giá trị hơn nhiều so với nhận một điểm số duy nhất. Kết luận thực tế của bài báo DeepSeek là các reward model generative có thể liên tục cải thiện chất lượng đánh giá thông qua inference-time scaling—sample nhiều đánh giá và sau đó tổng hợp chúng—vượt trội các phương pháp scalar chỉ dựa vào tăng kích thước model trên nhiều benchmark reward model. Giá trị cốt lõi của phần thưởng generative nằm trong việc chuyển đổi phản hồi môi trường phong phú thành kiến thức có thể học được, cho phép Agent học hướng cải thiện từ một lần thất bại duy nhất, thay vì yêu cầu hàng trăm lần thử sai mù quáng.
Từ góc độ RLHF, reward model generative có thể được xem là sự tiến hóa của reward model discriminative Bradley-Terry đã thảo luận trước đó: RM discriminative chỉ xuất ra một điểm số scalar (phản hồi nào được xếp hạng cao hơn), trong khi RM generative tạo ra một đánh giá với reasoning bằng ngôn ngữ tự nhiên, giải thích "tại sao tốt, tại sao xấu." Điều này làm cho nó inherently minh bạch hơn và dễ mở rộng hơn đến các nhiệm vụ mở khó bao phủ bằng quy tắc và điểm số scalar.
Lựa chọn hàm phần thưởng phụ thuộc vào cách nhiệm vụ có thể được xác minh. Nếu câu trả lời có thể được xác minh tự động bằng code (ví dụ: bài toán toán, unit test), binary reward là đơn giản và trực tiếp nhất. Nếu nhiệm vụ có nhiều chiều chất lượng độc lập (ví dụ: độ chính xác thông tin, lịch sự giao tiếp, tỷ lệ giải quyết vấn đề trong kịch bản dịch vụ khách hàng), sử dụng vector reward cho đánh giá theo chiều. Nếu nhiệm vụ rất mở và khó chia thành các chiều (ví dụ: viết sáng tạo, đối thoại phức tạp), sử dụng generative reward để model đánh giá cung cấp phân tích định tính.
Training Reward Model Generative.
Làm thế nào để train một reward model generative? Con đường truyền thống có các chuyên gia con người đánh giá một lượng lớn case để model bắt chước—tốn kém, và con người thường khó diễn đạt tại sao A tốt hơn B. Phương pháp của DeepSeek để model tự học đánh giá, trong ba bước:
Bước 1: Model tự động tạo nguyên tắc đánh giá cho các nhiệm vụ cụ thể. Ví dụ, khi đánh giá "giúp người dùng gọi để đổi gói cước Xfinity," model tóm tắt: "Một Agent tốt nên: 1) Tìm đúng kênh dịch vụ khách hàng chính thức; 2) Thu thập đầy đủ thông tin xác minh danh tính; 3) Truyền đạt chính xác nhu cầu người dùng trong cuộc gọi; 4) Tránh bịa đặt hoặc nói sai thông tin; 5) Phản hồi kịp thời các yêu cầu dịch vụ khách hàng."
Bước 2: Đánh giá quá trình thực thi dựa trên mỗi nguyên tắc. Tiếp tục ví dụ: Số điện thoại đúng đã được tìm chưa? Có, 1-800-XFINITY là dịch vụ khách hàng chính thức. Thu thập thông tin có đầy đủ không? Không, địa chỉ thanh toán bị bỏ sót. Mọi thứ có được truyền đạt chính xác không? Có một lỗi: tên gói cước bị nói sai.
Bước 3: Hệ thống tự động kiểm tra độ chính xác của đánh giá. Ví dụ, nếu model nói "tên gói cước đã được truyền đạt chính xác," nhưng trajectory thực tế cho thấy tên bị sai, hệ thống đưa ra phản hồi âm. Nếu model chính xác xác định địa chỉ thanh toán bị bỏ sót, nó đưa ra phản hồi dương. Thông qua thực hành lặp lại trên hàng nghìn case, model dần học cách xây dựng nguyên tắc hợp lý cho các nhiệm vụ khác nhau và đưa ra chẩn đoán chính xác.
Phương pháp này có một số ưu điểm chính: nó khái quát hóa tốt vì nó học siêu năng lực "tiêu chuẩn đặt ra và đánh giá đưa ra" thay vì một rubric chấm điểm cố định; quá trình đánh giá minh bạch làm cho thiên lệch dễ review hơn—ví dụ, nếu model liên tục coi "câu trả lời dài" là điểm mạnh, rõ ràng nó đã nhầm lẫn dài với chất lượng; và nó cho phép reward model và policy model đồng tiến hóa, không giống như các phương pháp truyền thống trong đó reward model vẫn cố định.
Process Reward vs. Outcome Reward: Lựa chọn Quan trọng cho Nhiệm vụ Multi-Turn
Beyond credit assignment, các nhiệm vụ multi-turn cũng đối mặt với vấn đề long-range dependency—tác động của các quyết định sớm, như thiết lập sub-goal hoặc lựa chọn công cụ, có thể chỉ trở nên rõ ràng hàng chục bước sau. Điều này đặt ra một lựa chọn quan trọng trong thiết kế phần thưởng: Process Reward cung cấp phản hồi tại mỗi bước, giảmđộ khó credit assignment nhưnggiới thiệu thiên lệch thiết kế của con người, có thể hạn chế không gian khám phá. Outcome Reward cung cấp phản hồi chỉ ở cuối, cho tự do khám phá tối đa nhưng yêu cầuđộ khó training cao hơn và nhu cầu mẫu nhiều hơn. Theo analogy, process reward giống như giáo viên chấm bài từng câu hỏi, cho phép học sinh nhanh chóng biết mình sai ở đâu; outcome reward giống như chỉ nhìn điểm thi cuối cùng, cho học sinh nhiều tự do hơn để khám phá phương pháp học tập, nhưng phản hồi đến rất muộn. Thiết kế hàm phần thưởng closely liên quan đến xây dựng môi trường đánh giá được thảo luận trong Chương 6—một môi trường đánh giá tự động chất lượng cao là điều kiện tiên quyết cho training RL.
Về thuật ngữ, hai phần thưởng này tương ứng với hai loại reward model: Process Reward Model (PRM) chấm điểm mỗi bước trung gian của reasoning hoặc thực thi. Một tác phẩm đại diện là "Let's Verify Step by Step"[^ch7-7] của OpenAI—trên các nhiệm vụ reasoning toán học, PRM được train với gán nhãn từng bước của con người vượt trội đáng kể so với giám sát chỉ nhìn vào câu trả lời cuối cùng. Outcome Reward Model (ORM) chỉ đánh giá kết quả cuối cùng. Verifier dựa trên rule trong RLVR được thảo luận trước đó có thể được xem là một trường hợp đặc biệt của ORM—thay thế "model chấm điểm đã học" bằng các quy tắc deterministic.
Credit Assignment trong Thực tế. Về mặt kỹ thuật, credit assignment được xử lý bởi một số cơ chế cụ thể. Hệ số chiết khấu $\gamma$ thường được đặt trực tiếplà 1 trong multi-turn LLM RL: các nhiệm vụ chỉ kéo dài vài đến vài chục lượt, và mục tiêu tối ưu hóa là thành công hay thất bại cuối cùng; không cần chiết khấu phần thưởng cho "thành công sớm hơn." PPO dựa vào GAE (Generalized Advantage Estimation), trực giác sử dụng một value network để ước tính "bước này tốt hơn kỳ vọng bao nhiêu" cho mỗi bước trong trajectory, tạo ra sự đánh đổi có trọng số giữa bias và variance. GRPO đi đến cực đoan khác: nó coi toàn bộ phản hồi như một hành động duy nhất, và advantage cấp trajectory được phân phối đều trên tất cả token—một câu hỏi chính xác ở lượt 2 và một câu xã giao không hiệu quả ở lượt 7 nhận credit giống hệt nhau. Credit assignment thô này ít vấn đề trong các nhiệm vụ ngắn, single-turn nhưng làm loãng tín hiệu học tập trong các nhiệm vụ multi-turn dài hạn—đó là lý do tại sao PPO với value network vẫn có giá trị trong các kịch bản multi-turn. Một cách tiếp cận trung gian là credit assignment cấp lượt: tính advantage ở cấp "lượt" (ví dụ: sử dụng phản hồi môi trường hoặc process reward sau mỗi lượt), rẻ hơn cấp token và chi tiết hơn cấp trajectory, đại diện cho một thỏa hiệp phổ biến trong các framework Agent RL multi-turn hiện tại.
Thí nghiệm 7-12 ★★★: V-IRL-VL Reasoning Không gian—Process Reward
V-IRL (Yang et al., 2024; thí nghiệm này theo nghiên cứu Chu et al. 2025 aforementioned, với thuật toán RL cũng là PPO với value network) là một môi trường điều hướng hình ảnh thế giới mở sử dụng quang cảnh đường phố thành phố thực. V-IRL-L sử dụng mô tả văn bản thuần túy, trong khi V-IRL-VL cung cấp lưới 2×2 hình ảnh quang cảnh (trước, sau, trái, phải). Training sử dụng 1000 tuyến đường ở New York, testing sử dụng 18 tuyến đường across chín thành phố (Milan, New Delhi, London, Hong Kong, v.v.) từ benchmark chính thức V-IRL—với kiểu kiến trúc, bố cục đường phố, và điều kiện ánh sáng rất khác nhau.
Biến thể Quy tắc: Training sử dụng hướng tuyệt đối (north/east), testing sử dụng hướng tương đối (left/right). Biến thể Hình ảnh: Kiểm tra cross-city.
Trên các distribution shift V-IRL này, kết quả một lần nữa cho thấy pattern "SFT ghi nhớ, RL khái quát hóa" của chương. Rule OOD: RL cải thiện +11.0 phần trăm trên V-IRL-L, trong khi SFT giảm 79.5 phần trăm; trên V-IRL-VL, RL cải thiện +9.3 phần trăm, trong khi SFT giảm 33.2 phần trăm. Visual OOD: RL trên V-IRL-VL cải thiện từ 16.7% lên 77.8% (+61.1 phần trăm), với end-to-end RL sử dụng model mã nguồn mở vượt trội baseline mạnh dựa vào kỹ thuật prompt engineering cẩn thận với model mã nguồn đóng; SFT giảm xuống 11.1% (-5.6 phần trăm). Những kết quả này hỗ trợ sự tương phản trong thiết lập thí nghiệm này thay vì thiết lập một quy tắc phổ quát cho tất cả training SFT và RL.
Process reward đóng vai trò quan trọng trong thí nghiệm này. Không giống như nhiệm vụ single-turn GeneralPoints, điều hướng yêu cầu phản hồi tại mỗi bước: hành động đúng được +1, hành động sai nhận -1, và lỗi nhận dạng mốc nhận thêm -1.5. Phản hồi dày đặc này giảmđộ khó credit assignment chuỗi dài—khi Agent rẽ sai ở bước 5, nó nhận phản hồi tiêu cực tức thì, mà không phải đợi đến khi nhiệm vụ kết thúc ở bước 20 đểphát hiện. Kết hợp với cơ chế xác minh thử lại (verify_iter=2, cho phép hai lần thử tại một điểm quyết định duy nhất), nóhơn nữa cải thiện hiệu quả mẫu và sự ổn định training.
Theo dõi mối quan hệ giữa độ chính xác nhận dạng hình ảnh và hiệu suất tổng thể reveals: RL không chỉ tối ưu hóa "ra quyết định dựa trên kết quả nhận dạng" mà còn cải thiện "chính nhận dạng hình ảnh"—tín hiệu tối ưu hóa theo kết quả backpropagate đến lớp tri giác,khiến encoder hình ảnh học các biểu diễnđặc trưng liên quan đến nhiệm vụ. Ngược lại, SFT có xu hướng overfitting trong lớp reasoning, bỏ bê học tập trong lớp tri giác, dẫn đến thất bại khi hình ảnh thay đổi.
Sự hiệp đồng giữa SFT và RL thậm chí còn nổi bật hơn trong các nhiệm vụ multi-turn. Không có khởi tạo SFT, RL không thể được train hiệu quả (base model không thể tạo output JSON có cấu trúc). Tuy nhiên, nếu SFT được over-trained, dẫn đến overfitting nghiêm trọng, RL cũng không thể phục hồi hiệu suất out-of-distribution (OOD). Đây là sự cân bằng tinh tế: SFT nên được train vừa đủ để đạt "định dạng ổn định và năng lực cơ bản," mà không ở lại quá lâu.
VLA (Vision-Language-Action) model thống nhất tri giác hình ảnh, hiểu ngôn ngữ, và tạo hành động, đại diện cho một paradigm nổi lên trong thao tác robot. Các model này đối mặt với hai thách thức lớn: scaling SFT yêu cầu các trajectory demonstration của con người quy mô lớn, tốn kém để thu thập và hạn chế vềtính đa dạng, trong khi các model được train trên kịch bảnhạn chế hoạt động kém khi gặp nhiệm vụ, môi trường, hoặc vật thể chưa thấy. Được truyền cảm hứng bởi cải thiện đáng kể của DeepSeek-R1 trong reasoning từng bước thông qua RL, thí nghiệm này khám phá liệu RL có thể tương tự nâng cao tạo hành động từng bước của VLA. SimpleVLA-RL được xây dựng trên veRL, chỉ sử dụng binary outcome reward (success/failure), vàgiới thiệu ba biện pháp tăng cường khám phá: Dynamic Sampling lọc ra các nhóm có tất cả thành công hoặc tất cả thất bại để đảm bảo gradient ổn định; Higher Clipping Bounds [0.8, 1.28] khuyến khích khám phá; Higher Temperature 1.6 tạo trajectory đa dạng. Sự kết hợp của ba biện pháp cải thiện hiệu suất khoảng 30% trong vòng 300 bước.
Trên LIBERO, benchmark thao tác robot, kết quả báo cáo là 97.6% mạnh mẽ. Trong thí nghiệm cold start, SFT với chỉ một trajectory mỗi nhiệm vụ đạt 17.3%; thêm RL nâng lên 91.7%—tăng 74.4 phần trăm, hoặc khoảng 430% về mặt tương đối—mạnh mẽ chứng minh sức mạnh của RL trong điều kiện khan hiếm dữ liệu.
Trong quá trình training, một hành động "pushcut" đã xuất hiện—một mẫu hành động mới được RL tự khám phá, chưa từng thấy trong demonstration của con người. Đường dẫn demonstration tiêu chuẩn là "tiếp cận → nắm → nâng thẳng đứng → di chuyển ngang → thả," trong khi RL khám phá một đường dẫn hiệu quả hơn: "tiếp cận → nắm → giữ thấp → đẩy ngang → hoàn thành." Điều này loại bỏ bước nâng, tăng tốc độ, và giảm yêu cầu độ chính xác. Nó mạnh mẽ chứng minh rằng RL có thể vượt qua imitation learning và khám phá các chiến lượcvượt trội mà con người chưa nghĩ ra.
Framework sử dụng thuật toán GRPO với chiến lược dynamic sampling—chỉ giữ lại các nhiệm vụ có tỷ lệ thành công vừa phải cho training, tự nhiênhình thành curriculum (từ dễ đến khó). Hiệu suất thời gian thực dựa vào action chunking: model tạo nhiều hành động tương lai trong một lần inference, được thực thi tuần tự bởi một thread điều khiển trong khi GPUtạo bất đồng bộ batch tiếp theo trong nền. Miễn là thời gian inference nhỏ hơn thời gian thực thi, robot duy trì chuyển động liên tục, mượt mà (thảo luận đầy đủ về action chunking nằm trong Chương 9, VLA Control Layer).
Cải thiện năng lực khái quát hóa được thấy across nhiều chiều: khái quát hóa không gian (chiến lược train trên bố cục cụ thể transfer sang cấu hình khác nhau), khái quát hóa đối tượng (xử lý hình dạng và kết cấu đối tượng chưa thấy), và khái quát hóa mục tiêu (thích ứng với mô tả mục tiêu nhiệm vụ mới).
So sánh với V-IRL-VL reveals sự đánh đổi của hai thiết kế phần thưởng: Outcome reward cung cấp tín hiệu thưa hơn nhưng cho model tự do khám phá lớn hơn (đây là cách "pushcut" được khám phá); process reward tăng tốc hội tụ thông qua phản hồi dày đặc nhưng có thể giữ chiến lược không vượt ra ngoài không gian demonstration. Đơn giản nói, khi tính đúng đắn của các bước trung gian dễ xác định, process reward hiệu quả hơn; khi đường dẫn tối ưu chưa biết, outcome reward có tiềm năng hơn.
Thưởng Kết quả, Ràng buộc Quá trình: RLVP và Partial Credit
Process reward và outcome reward giải quyết câu hỏi phản hồi nên dày đặc như thế nào. Nhưng một vấn đề vẫn còn mà không có phương pháp RL nào được thảo luận cho đến nay đã giải quyết: outcome reward đơn giản không thểbiểu đạt yêu cầu rằng quá trình phải tuân thủ quy tắc—và đó chính xác là thứ quyết định liệu một Agent thế giới thực có thể được deploy hay không. Phần này giải thích vấn đề một cách sâu sắc bằng phương pháp từ bài báo RLVP[^ch7-9] (Reinforcement Learning with Verified Penalty). Công thức trong một câu: thưởng kết quả, phạt đường dẫn.
Vấn đề: có một lớp ràng buộc mà outcome reward không những không thể dạy, mà còn chủ động khuyến khích vi phạm. Ngoài việc hoàn thành công việc, Agent thế giới thực phải tuân thủ một lớp ràng buộc outcome-neutral—các quy tắc mà việc tuân thủ không có liên hệ tất nhiên với thành công nhiệm vụ: không gọi lại người dùng đã từ chối cuộc gọi, không hành động tự động ngoài giờ làm việc, không bỏ qua xác minh danh tính, không chạy lệnh phá hủy như rm -rf, không chỉnh sửa tệp test chỉ để làm test pass, không ghi đè tệp bạn chưa từng đọc. Rắc rối là vi phạm các ràng buộc này thường nâng "tỷ lệ thành côngbề ngoài"—cắt góc pays: chỉnh sửa tệp test pass nhanh hơn thực sự sửa lỗi; bỏ qua xác minh có kết quả nhanh hơn làm đúng cách. Vì vậy pure outcome reward không chỉ không dạy được các ràng buộc này—chúng chủ động đẩy Agent phá vỡ chúng. Trong bài báo, Agent được train chỉ với outcome reward vi phạm ranh giới trong gần như mọi episode.
Insight Cốt lõi: Môi trường thực là "trình xác minh bất đối xứng." Đây là chìa khóa để hiểu toàn bộ phương pháp. Trong một môi trường có thể xác minh bằng máy (terminal, codebase, trình chứng minh định lý), một thứ dễ xác minh—liệu một hành động có phải là hành động xấu (chạy lệnh phá hủy, gọi trước khi điều kiện tiên quyết đượcđáp ứng), vì các hành động xấu có đặc điểm rõ ràng, deterministic. Nhưng một thứ khác khó xác minh—liệu Agent có đang tiến bộcó ý nghĩa toward mục tiêu (điều này gần như khó như "giải quyết nhiệm vụ" bản thân nó). Vì "phát hiện hành động xấu" rẻ và đáng tin cậy, trong khi "đánh giá tiến bộ" tốn kém và dễ lỗi, tín hiệu dày đặc mà môi trường có thể cung cấp đáng tin cậy về cơ bản là "phạt trên đường dẫn," không phải "thưởng cho tiến bộ." Sự bất đối xứng này xác định hình dạng của phương pháp.
Cách tiếp cận: Ngoài outcome reward, thêm một "tín hiệu đường dẫn" có thể xác minh. Tổng phần thưởng được viết thành hai phần:
$$R = O + \beta\cdot\Phi$$
O là outcome reward gốc (thưa và vẫn là mục tiêu thực sự); Φ là tín hiệu đường dẫn, được gán hành động theo hành động bởi một rule engine deterministic. Nó được tính là một hàm thuần túy của hành động và trạng thái ngay trước hành động đó, thay vì bởi một model đánh giá đã học. Φ có haicông dụng, tương ứng với dấu trừ và dấu cộng:
Phạt (−λ): Với mỗi lần xuất hiện của một hành động vi phạm có thể xác minh bằng máy (lệnh phá hủy, sửa đổi tệp test) trong trajectory, trừ λ điểm từ các token của hành động đó.
Thưởng Tuân thủ / Partial Credit (+μ): Mỗi khi một hành động tốt có thể xác minh xảy ra—đáp ứng điều kiện tiên quyết, đạt sub-goal, tăng số test pass, hoặc giảm số mục tiêu cần chứng minh—thêm μ điểm.
Hai tín hiệu được chuẩn hóa riêng biệt trước khi kết hợp, ngăn tín hiệu đường dẫn dày đặc lấn át tín hiệu outcome thưa (hoặc ngược lại). Cơ chế này được cắm trực tiếp vào vòng lặp training PPO/GRPO: nó không thay đổi thuật toán tối ưu hóa, chỉđịnh hình lại phần thưởng tại mỗi bước, cho phép tính advantage thấy đúng và sai dọc đường đi.
Tại sao nó hoạt động—một giải thích thống nhất: within-group variance. Nhớ lại Mục 7.8: GRPO không train value network. Thay vào đó nó sample một nhóm G rollout cho cùng một prompt và sử dụng vị trí tương đối so với trung bình nhóm của mỗi rollout làm advantage của nó. Đây là sự thật toán học: advantage của GRPO về cơ bản là within-group variancenếu mọi rollout trong một nhóm nhận chính xác cùng một phần thưởng, variance bằng 0, mọi advantage bằng 0, và nhóm đóng góp không gradient nào. Toàn bộ nhóm mẫu đó được tạo ra vô ích.
Với chỉ outcome reward, "bế tắc zero-variance" nàykhông thể tránh khỏi xảy ra trong hai kịch bản,đúng lúc là phổ biến nhất ở đầu và cuối training:
Nhóm all-fail (đầu training): Nhiệm vụ quá khó; tất cả rollout trong một nhóm thất bại, O đều là 0 → within-group variance bằng 0 → không gradient. Đầu traininghầu như hoàn toàn gồm các nhóm này, lãng phí một lượng lớn mẫu tốn kém.
Nhóm all-pass (cuối training): Nhiệm vụ gần như đã học được; tất cả rollout trong một nhóm thành công, O đều là 1 → variance cũng bằng 0 → không gradient.
Nói cách khác, pure outcome reward bị mù ở cả hai cực của tỷ lệ thành công. Câu trả lời của cộng đồng đã là loại bỏ hoàn toàn các nhóm zero-variance này (dynamic sampling của DAPO loại bỏ các prompt mà tất cả rollout đều đúng hoặc đều sai). RLVP đảo ngược câu hỏi: thay vì loại bỏ chúng, tín hiệu dày đặc nào có thể khôi phục variance bị thiếu? Đặt theo cách đó, câu trả lời là tức thì:
Một hình phạt có thể xác minh luôn có thể khôi phục variance. Ngay cả khi mọi rollout trong một nhóm thất bại, chúng thường khác nhau về cách thất bại—một số chạy lệnh phá hủy, số khác không. Thêm hình phạt và nhóm all-fail ngay lập tức có sự khác biệt nội bộ (variance); gradient sống lại. Vì hành động xấu rẻ để kiểm tra, hình phạt là "nửa luôn có thể đạt được" của giải pháp.
Một phần thưởng tiến bộ có thể xác minh (Partial Credit) chỉ có thể khôi phục variance khi tiến bộ có thể đạt được. Nếu một số rollout trong một nhóm pass thêm hai test hoặc chứng minh thêm một định lý, chúng khác nhau về tiến bộ, và +μ có thể tạo variance. Nhưng nếu nhiệm vụ quá khó và tiến bộ của mọi rollout đều kẹt ở 0 (ví dụ: trong sửa chữa phần mềm, không ai có thể làm bất kỳ test ẩn nào pass), tín hiệu tiến bộ ở khắp nơi bằng 0, dẫn đến variance bằng 0—thì nó không thểgiúp đỡ. Vì vậy phần thưởng tiến bộ là "nửa có điều kiện" của giải pháp: trong chứng minh định lý, nơi "số mục tiêu cần chứng minh" dần giảm, nó có thể đạt được và hữu ích; trong sửa chữa phần mềm, nơi "tỷ lệ test pass" thường không thể đạt được, nó vô dụng.
Tóm lại: Tín hiệu dày đặc chỉ hữu ích khi chúng có thể khôi phục within-group variance bị thiếu từ outcome reward—hình phạt luônđáp ứng điều kiện này (hành động xấu có thể kiểm tra được), trong khi phần thưởng tiến bộ chỉđáp ứng khi partial success có thể đạt được. Do đó bài báo gọi hình phạt là "nửa universally available" và phần thưởng tiến bộ là "nửa conditional."
Use Case 1: Phạt đường dẫn cho khả năng deploy—bốn nguyên tắc thiết kế. Khi Φ được sử dụng như hình phạt để dạy Agent tuân thủ ràng buộc, bốn nguyên tắc được xác minh thông qua ablation giải quyết bốn cạm bẫy cụ thể:
Chỉ phạt các "hành động" có thể xác minh, không bao giờ "thiếu tiến bộ." Mục tiêu của hình phạt phải là một hành động xấu cụ thể, có thể phát hiện bằng máy (ví dụ: chạy rm -rf, gọi người mà khôngđáp ứng điều kiện tiên quyết), không phải "không tiến bộ ở bước này." Vì "không làm gì" là cách dễ nhất để tránh hình phạt "không tiến bộ"—điều này trực tiếp dạy Agent không làm gì cả.
Outcome reward luôn là động lực chính; hình phạt không thể được tối ưu hóariêng biệt. Có một cạm bẫy bất động chí mạng: chỉ có hình phạt mà không có outcome reward, chiến lược tối ưu là "không làm gì"—zero vi phạm, nhưng cũng zero thành công. Ablation của bài báo cho thấy pure hình phạt khiến tỷ lệ thành công sụp đổ về 0 trên mọi random seed. Outcome reward phải cung cấp "lực kéo" để hoàn thành nhiệm vụ, trong khi hình phạt chỉ hướng dẫn cách làm.
Ghép nối mỗi hình phạt (−λ) với phần thưởng tuân thủ tương ứng (+μ). Trừ điểm cho "sửa đổi tệp test," nhưng cũng thưởng hành động tuân thủ "thực sự sửa lỗi để nó pass tự nhiên"—cho Agent một lối thoát, không chỉ phong tỏa. Ablation cho thấy việc loại bỏ phần thưởng tuân thủ ghép nối nàyđáng kể làm chậm vàkhông ổn định việc học hành vi tuân thủ.
Đường dẫn tuân thủ phải có thể đạt được, và mục tiêu hình phạt phải không thể gian lận. Sử dụng một vài demonstration có script để trước tiên chỉ cho Agent "cách tuân thủ quy tắc" (nếu không nó có thể không bao giờ khám phá hành động tuân thủ, và +μ sẽ không bao giờ được sử dụng). Đồng thời, đánh giá "cái gì counts là vi phạm" phải sử dụng các kiểm tra cụ thể, deterministic, không phải một model "điểm tuân thủ" đã học—nếu không, vấn đề gian lận chỉ chuyển từ policy sang judge.
Use Case 2: Thưởng tiến bộ có thể đạt được cho hiệu quả mẫu (Partial Credit). Tái sử dụng cùng +μ từ phần thưởng tuân thủ thành phần thưởng tiến bộ, và nó chuyển từ ràng buộc quá trình sang tăng tốc học tập: trong các nhóm all-fail, miễn là tiến bộ có thể đạt được, +μ biến bế tắc zero-gradient thành gradient có thể sử dụng, để model đạt cùng năng lực với ít tương tác tốn kém hơn. Bài báo so sánh chứng minh định lý (miniF2F) với sửa chữa phần mềm và kết luận rằng biến số quan trọng là khả năng đạt được, không phải mật độ tín hiệu bản thân nó: trong chứng minh định lý, mỗi bước được chứng minh thực sự giảm số mục tiêu còn lại, vì vậy tiến bộ có thể đạt được; phần thưởng tiến bộ dày đặc do đóđáng kể tăng tốc hội tụ và làm training ổn định hơn, với ít divergence hơn. Trong sửa chữa phần mềm, một lô rollout thường không thể pass một test nào—tiến bộ không thể đạt được, và bạn nên dùng plain outcome reward. Khả năng đạt được có thể được chẩn đoán trước training bằng cách đo within-group variance trên một vài rollout từ base model.
Mối quan hệ với RLVR (làm rõ một điểm thường bị nhầm lẫn). RLVP và RLVR (Reinforcement Learning with Verifiable Rewards), được đề cập repeatedly trong chương này, chỉ khác nhau một chữ cái, neatly highlights tính bổ sung của chúng: RLVR xác minh kết quả; RLVP bổ sung xác minh quá trình. Kết hợp cả hai yields một tín hiệu training vừa tập trung vào "hoàn thành công việc" vừa "làm đúng cách"—chính xác là những gì cần thiết cho một Agent có thể được deploy an toàn.
Thí nghiệm 7-16 ★★★: RLVP—Thưởng Kết quả, Phạt Đường dẫn [Thí nghiệm Mở rộng]
Mục tiêu Thí nghiệm: Xác định liệu "outcome reward + tín hiệu đường dẫn có thể xác minh" có thể vừa giảm vi phạm ràng buộc thông qua hình phạt vừa cải thiện hiệu quả mẫu thông qua partial credit, mà không hy sinh tỷ lệ thành công nhiệm vụ.
Cách tiếp cận Kỹ thuật: Trên nền GRPO, thêm hai tín hiệu—outcome reward O (nhiệm vụ có hoàn thành không) và tín hiệu đường dẫn Φ (trừ điểm cho mỗi hành động vi phạm có thể phát hiện bằng máy trong trajectory, thêm điểm cho mỗi hành động tuân thủ/tiến bộ tương ứng). Chuẩn hóa riêng biệt mỗi cái và kết hợp thành R = O + β·Φ. Môi trường test bao gồm Terminal-Bench (thao tác terminal, vi phạm nhưthực thi lệnh phá hủy) và miniF2F (chứng minh định lý hình thức, kiểm tra hiệu quả mẫu).
Nhóm Kiểm soát: GRPO tiêu chuẩn chỉ sử dụng outcome reward.
Quan sát Dự kiến: Trên Terminal-Bench (Qwen3-4B, 5 random seed), vi phạm mỗi episode giảm từ 3.71 với pure outcome reward xuống 0.66 (khoảng 6 lần ít hơn), trong khi tỷ lệ thành công nhiệm vụ nằm trong nhiễu—tuân thủhầu như miễn phí, và Agent thực sự thực hiện hành động hiệu quả, không phải ít hơn; nó không đơn giản là "làm ít hơn để phá ít hơn." Trên các bài toán đại số miniF2F (tiến bộ có thể đạt được), số lần lặp cần thiết để đạt tỷ lệ thành công 0.9 giảm từ 7.0 xuống 4.4 (model 4B), với khoảng cách thậm chí lớn hơn trên model lớn hơn (30B: 8.5 → 5.4, và pure outcome reward diverge trên một số seed). Trên một nhiệm vụ thao tác tệp chuỗi, tỷ lệ "nhóm all-fail" (mẫu lãng phí khônghọc được gì) giảm từ 65% xuống 8%. Như một counterexample, trong thiết lập sửa chữa phần mềm nơi tiến bộ không thể đạt được, một lô rollout thường không thể pass một test nào; phần thưởng tiến bộ dày đặc do đó ở khắp nơi bằng 0 và không cung cấp lợi ích, xác nhận rằng "khả năng đạt được là ngưỡng."
RL cho Học Gọi Công cụ
Trong các thí nghiệm multi-turn trước đó, không gian hành động của Agent bị giới hạn trong các thao tácbuilt-in như di chuyển và quan sát. Agent thế giới thực cũng cần gọi nhiều công cụ bên ngoài—công cụ tìm kiếm, trình giải thích code, trình phân tích tài liệu, v.v.—giới thiệu các thách thức mới cho training RL.
Hình 7-18: Vòng lặp Phần thưởng RL cho Gọi Công cụ
Sử dụng công cụ mở rộng ranh giới năng lực của Agent từ "reasoning của chính model" sang "gọi các hệ thống bên ngoài để cộng tác," làm cho nótrở thành một bước quan trọng toward Agent thực tế. Từ góc độgradientđộ khó, training RL cho sử dụng công cụ đối mặt với ba cấp độ thách thức. Cấp độ đầu tiên là học cách sử dụng một công cụ duy nhất—hiểu thông số input/output, nắm vững thời điểm gọi, và xử lý phản hồi lỗi. Cấp độ thứ hai là đưa ra lựa chọn trong hệ sinh thái đa công cụ—đối mặt với hàng chục công cụ, quyết định khi nào tìm kiếm, khi nào thực thi code, và khi nào phân tích tài liệu. Cấp độ thứ ba là điều phối chuỗi công cụ—khám phá phụ thuộc giữa các công cụ, xác định ràng buộc loại trừ lẫn nhau, và tối ưu hóa hiệu quả chi phí.
Hiện có hai hướng nghiên cứu tích cực xung quanh RL Agent cho gọi công cụ. Một là retrieval augmentation: đại diện bởi Search-R1 (Jin et al., 2025), sử dụng RL để train model tự quyết định khi nào bắt đầu tìm kiếm trong quá trình reasoning và sử dụng kết quả trả về để tiếp tục reasoning, thay vì tuân theo một pipeline RAG cố định. Hướng còn lại là kỹ thuật phần mềm, đại diện bởi các môi trường training như SWE-Gym, hỗ trợ RL multi-turn cho Agent coding trong codebase thực, cho phép model lặp lại chỉnh sửa, chạy, và sửa code. Cả hai hướng chia sẻ cùng hai thách thức: credit assignment dài hạn (quy một thành công cuối cùng cho một quyết định được đưa ra hàng chục bước trước) và kỹ thuật môi trường (xây dựng môi trường training ổn định, có thể tái tạo, và có thể parallelize quy mô lớn).
Tool RL cũng có một chi tiết kỹ thuậtkhông thể tránh khỏi: loss masking cho token phản hồi môi trường. Một trajectory gọi công cụ chứa cả token được tạo bởi chính model (thinking, tham số gọi công cụ) và token được trả về bởi môi trường (output trình giải thích code, kết quả tìm kiếm, phản hồi dịch vụ khách hàng).cái sau không được tạo bởi policy mà được cung cấp bởi môi trường—nếu chúng được đưa vào policy gradient, model sẽ được train để "dự đoán sandbox sẽ output gì," đi lệch mục tiêu tối ưu hóa và làm trainingkhông ổn định. Thực hành tiêu chuẩn là mask các token phản hồi môi trường khi tính loss, backpropagate gradient chỉ cho các token được tạo bởi model. Đây là một trong những điểm kỹ thuật cốt lõi của ReTool (masking gradient cho token phản hồi bên trong thẻ <interpreter>), và đó là điều Search-R1 gọi là "masking retrieved tokens để ổn định training." Các framework training lớn như veRL và AWorld có cơ chế này built in.
Thí nghiệm 7-14 ★★★: ReTool—Code Interpreter Nâng cao Giải quyết Bài toán Toán
Hình 7-19: ReTool Đan xen Tư duy Văn bản-Code và Vòng lặp Phản hồi Thực thi Sandbox
Tư duy văn bản thuần túy dễ bị lỗi tích lũy trong tính toán số chính xác, thao tác ký hiệu, hoặc giải phương trình phức tạp (ví dụ: mười bước nhân liên tiếp, mỗi bước có thể sai). Code interpreter cung cấp xác minh chính xác thông qua giao diện có thể thực thi. ReTool tích hợp việc thực thi thời gian thực của code interpreter vào vòng lặp thinking RL, cho phép model tự chủ họckhi nào vànhư thế nào sử dụng công cụ dưới hướng dẫn của phản hồi kết quả.
Training được chia thành hai giai đoạn. SFT warm-up (khoảng 1 giờ) chuyển đổi dữ liệu reasoning văn bản thuần túy thành trajectory được tăng cường bằng code, thiết lập mẫu gọi công cụ cơ bản. Training RL (PPO dựa trên triển khai veRL đã sửa đổi, dữ liệu training từ DAPO-Math-17k, khoảng 9 ngày cho 400 bước) tối ưu hóa chính sách thông qua các rollout đan xen với thực thi code thời gian thực: model tạo code chứa thẻ <code>, sandbox thực thi nó và bọc kết quả trong thẻ <interpreter> để phản hồi, model tiếp tục tạo,hình thành chuỗi reasoning hỗn hợp "text 1 + code 1 + feedback 1 + ... + answer." Mỗi bước training tạo 512 phản hồi (32 câu hỏi × 16 ứng viên), với trung bình 7–9 vòng tương tác mỗi phản hồi, và tổng token xử lý tăng từ 25M ban đầu lên 40M.
ReTool bản thân sử dụng PPO tiêu chuẩn và không sửa đổi thuật toán tối ưu hóa. Tuy nhiên, dữ liệu training của nó đến từ DAPO-Math-17k của nhóm DAPO, vì vậy chúng ta nhân cơ hội này giới thiệu thuật toán DAPO gần đây phổ biến (Yu et al., 2025). Nó thực hiện bốn cải tiến so với PPO tiêu chuẩn, với mục tiêu cốt lõi là ngăn model hội tụ sớm sang một chiến lược duy nhất (chỉ giải quyết vấn đề theo một cách):
Clip-Higher (Nới lỏng trần khám phá): Clipping PPO tiêu chuẩn cắt bớt lợi ích surrogate-objective bổ sung khi tỷ lệ probability rơi ra ngoài khoảng của nó, discourage thay đổi chính sách lớn mà không impose ranh giới cứng. Trần quá thấp có thể hạn chế việc củng cố các hành động low-probability triển vọng. Clip-Higher nâng trần cho advantage dương, cho phép model tăng probability của một lộ trình mới rõ ràng tốt hơn một cách tích cực hơn và tiếp tục khám phá nó.
Token-Level Policy Gradient Loss (Trọng số bằng nhau cho mỗi token): GRPO gốc chuẩn hóa loss ở cấp mẫu—trước tiên trung bình bên trong mỗi phản hồi theo số token, sau đó trung bình across samples—làm loãng mỗi token trong phản hồi dài bởi 1/|o_i|: chuỗi thinking dài chất lượng cao nhận insufficient reward, và lặp lại lan man nhận insufficient penalty. Token-Level Policy Gradient Loss của DAPO loại bỏ trung bình cấp mẫu này và thay vào đó chuẩn hóa uniformly across tất cả token trong toàn bộ batch, cho mỗi token trọng số bằng nhau; hậu quả trực tiếp là phản hồi dài nhận đóng góp gradient tương xứng với độ dài.
Dynamic Sampling (Phân bổ tính toán thông minh): Điều chỉnh động số mẫu mỗi câu hỏi trong training—giảm sampling cho các câu hỏi đơn giản model đã có thể giải ổn định (training thêm yields ít lợi ích), và tăng sampling cho các câu hỏi trong "phạm vi có thể học" với tỷ lệ thành công từ 20% đến 80% (đây là những câu informative nhất), tập trung tính toán vào dữ liệu có giá trị nhất.
Overlong Reward Shaping (Phạt phản hồi lan man): Áp dụng hình phạt mềm cho phản hồi quá dài. Khi model tạo một quá trình thinking rất dài mà không trả lời tốt hơn, hệ thống giảm điểm phần thưởng, hướng dẫn nó học thinking ngắn gọn và hiệu quả hơn.
Quay lại ReTool. Trên AIME 2024, training Qwen2.5-32B-Instruct nâng độ chính xác từ khoảng 25% ban đầu lên 52% tại checkpoint trung gian sau 110 bước, với Best-of-30 đạt 85%; kết quả cuối cùng của bài báo sau 400 bước là 67.0%, trong khi pure text RL baseline sau 1080 bước chỉ là 40.0%. Các số training dynamics trong box thí nghiệm này đều dựa trên cấu hình model 32B này.
Năng lực emerging: tự sửa code (xác định lỗi thực thi và tự tạo phiên bản đã sửa), sử dụng công cụ chuyển từ xác minh giai đoạn cuối sang khám phá giai đoạn đầu, và cải thiện hiệu quả thinking (độ dài giảm 40% trong khi độ chính xác tăng).
Training dynamics cho 110 bước đầu cho thấy pattern ba pha: đầu (0-20 bước) học nhanh sử dụng công cụ cơ bản, độ chính xác cải thiện 0.5% mỗi bước; giữa (20-70 bước) khám phá dao động, độ dài phản hồi tăng từ 2500 lên đỉnh 4700 token, với sự gia tăng đột biến trong diversity policy; cuối (70-110 bước) hội tụ ổn định, độ dài giảm xuống 4400 token, hiệu suất tiếp tục cải thiện nhưng với dao động giảm.
Sự khác biệt cơ bản về thời gian giữa SFT và RL phát sinh từ mật độ thông tin khác nhau: SFT cung cấp tín hiệu giám sát cho mọi token, trong khi RL chỉ đưa ra tín hiệu success/failure mỗi episode. Trong thực tế, thời gian mỗi bước tăng theo độ dài phản hồi, và một vài phản hồi cực dài có thểđáng kể kéo dài toàn bộ chu kỳ training.
Thí nghiệm 7-15 ★★★: AWorld-train—Học cách Sử dụng Công cụ trong Sandbox
Hình 7-20: Kiến trúc Training AWorld-train MCP Sandbox và Hệ sinh thái Công cụ
GAIA là một trong những benchmark đánh giá Agent thử thách nhất. Ngay cả model tham số lớn được train ở quy mô lớn cũng có thể chỉ đạt khoảng 32%, vẫnđáng kểchậm hơn các hệ thống ghi điểm cao nhất. Thí nghiệm này sử dụng model nhỏ hơn (Qwen3-4B), với mục tiêu chính là chứng minh một pipeline "học từ thực hành" hoàn chỉnh.
Môi trường training AWorld là một MCP server sandbox, cung cấp 26 server và 126 hàm công cụ. Chúng bao gồm tương tác Web (Google Search, Smart Browser, Playwright), xử lý tài liệu (CSV/DOCX/PPTX/PDF), xử lý đa phương tiện (transcription audio, OCR, tóm tắt video), thực thi code (lệnh terminal, E2B sandbox), xử lý Excel (29 thao tác cấp doanh nghiệp), và truy xuất kiến thức (Wikipedia, arXiv, Wayback Machine). Rate limit, dao động dịch vụ, và khóa tài khoản từ API thực làm cho training trực tiếp trong môi trường production không khả thi—xây dựng một môi trường mô phỏng ổn định,có thể kiểm soát, và có thể phát lại là điều kiện tiên quyết kỹ thuật cho training RL đa công cụ.
Bước nhảy định tính từ sử dụng đơn công cụ sang đa công cụ là một công cụ duy nhất chỉ yêu cầu quyết định về "khi nào" và "cách" gọi nó, trong khi kịch bản đa công cụ cũng yêu cầu quyết định "gọi công cụ nào" và "kết hợp công cụ như thế nào,"giới thiệu sự bùng nổ tổ hợp và độ phức tạp của quản lý phụ thuộc—công cụ có phụ thuộc điều kiện tiên quyết (phải tìm kiếm trước khi duyệt một trang cụ thể), ràng buộc loại trừ lẫn nhau (một số công cụ không thể gọi đồng thời), và khác biệt chi phí (các API khác nhau có quota và độ trễ khác nhau). Chính sách phải lập kế hoạch toàn diện dưới các ràng buộc này, thay vì tham lam chọn hành động tối ưu cục bộ.
Lưu ý rằng đây là một thí nghiệm training mở không có kết quả baseline—một model ở quy mô Qwen3-4B sẽ không ghi điểm GAIA ấn tượng. Giá trị của nó nằm ở việc chạy pipeline "học từ thực hành" hoàn chỉnh end to end, không phải ở việc phá kỷ lục. Tiêu chíxác minh chấp nhận được và quan sát dự kiến là: vòng lặp reset và episode của môi trường (gọi công cụ, phản hồi, cập nhật trạng thái) chạy ổn định mà không crash; đường cong phần thưởng trung bình cho thấy xu hướng tăng trong training; tỷ lệ gọi công cụ cải thiện với training, và model dần học cách đưa ra lựa chọn và kết hợp hợp lý hơn trong nhiều công cụ.
Khám phá Tiên tiến để Cải thiện Hiệu quả Mẫu
Những thí nghiệm trước đó đã chứng minh, có hệ thống, giá trị cốt lõi của RL trong training Agent—nhưng mỗi thí nghiệm đều trả một chi phí mẫu đắt đỏ. Chạy RL của ReTool mất hơn 200 lần thời gian chạy SFT tương ứng—chín ngày so với một giờ—một mức giá mà các đội ngũ hạn chế tài nguyên hoặclặp lại nhanh có thể không thể trả.
Hiệu quả mẫu thấp của RL có nhiều nguyên nhân (variance cao, sparse reward, khó tái sử dụng dữ liệu on-policy). Một nguyên nhân gốc quan trọng nằm ở bản chất model-free của các phương pháp policy gradient chính thống—chúng không mô hình hóa động lực môi trường (world model, "thế giới sẽ trông như thế nào sau khi một hành động được thực hiện"), cũng không dễ dàng tận dụng thông tin phong phú chứa trong một tín hiệu phản hồi duy nhất (hai điểm này có liên quan nhưng không giống hệt nhau). Phản hồi phong phú được trả về bởi môi trường sau mỗi tương tác (lý do lỗi, trường thiếu, gợi ý quy trình đúng) phần lớn bị lãng phí—phần trước "Thế tiến thoưỡng lưỡng nan của Sparse Reward" đã phân tích vấn đề này chi tiết. Xem xét kịch bản gọi dịch vụ khách hàng: Agent được nói rõ ràng, "Tôi cần bốn chữ số cuối thẻ tín dụng để xác minh danh tính," nhưng model-free RL chỉ có thể học từ tín hiệu success/failure cuối cùng (reward 0 hoặc 1). Nó không thể trực tiếptận dụng phản hồi rõ ràng này và phải dựa vào hàng trăm khám phá ngẫu nhiên để tình cờ thử cung cấp thông tin thẻ tín dụng. Con người, khi nghe phản hồi này, sẽ ngay lập tức nhớ và chủ động chuẩn bị lần sau.
Chương này thực tế đã cung cấp hai cách bổ sung đểgiải quyết nút thắt này. Một là chuyển đổi thông tin lãng phí trong phản hồi môi trường thành phần thưởng có thể học được bằng cách viết các tín hiệu rõ ràng, có thể xác minh bằng máy—như "dịch vụ khách hàng yêu cầu xác minh danh tính trước," "lệnh này là phá hủy," hoặc "một bước chứng minh khác đã được hoàn thành"—trực tiếp vào hàm phần thưởng. Đây là phương pháp RLVP được thảo luận trong Mục 7.10 (especially partial-credit "thưởng tiến bộ có thể đạt được," khôi phục các mẫu lãng phí trong nhóm all-fail). Cách tiếp cận khác, mà phần này sẽ phát triển chính thức, là làm tín hiệu training dày đặc hơn tại mỗi bước: thay vì chỉ nhận một scalar success/failure duy nhất ở cuối nhiệm vụ, cung cấp hướng dẫn tại mọi điểm dọc trajectory. Đây là On-Policy Distillation.
Từ Bad Case Đến Post-Training
Phần này quay trở lại câu hỏi mà Chương 6 để lại: làm thế nào dữ liệu đánh giá được xây dựng từ các bad case trong sản xuất có thể trở thành đầu vào cho post-training? Các bản ghi phân bổ lỗi, các nhiệm vụ kiểm thử hồi quy end-to-end, các nhiệm vụ kiểm thử hồi quy trajectory-prefix và điểm rubric mỗi loại ánh xạ đến một mục đích huấn luyện khác nhau.
Bảng 7-4. Ánh xạ dữ liệu đánh giá từ Chương 6 sang các mục đích huấn luyện Chương 7
Dữ liệu đánh giá Chương 6
Mục đích huấn luyện Chương 7
Nhiệm vụ kiểm thử hồi quy end-to-end với trình xác minh
Nhiệm vụ rollout RL và phần thưởng có thể xác minh (RLVR); pool mẫu cho rejection-sampling fine-tuning (RFT)
Nhiệm vụ kiểm thử hồi quy trajectory-prefix
Các cặp ưu tiên DPO, các mẫu SFT cho ranh giới quyết định và các trạng thái giáo viên cho On-Policy Distillation
Bản ghi phân bổ lỗi (bước sai đầu tiên và loại lỗi)
Nhãn âm cho giám sát quá trình (PRM); các quy tắc cho hình phạt đường dẫn RLVP
Điểm rubric đa chiều và tập vàng của con người
Các chiều của phần thưởng vector; dữ liệu huấn luyện và hiệu chuẩn cho các mô hình phần thưởng sinh (GRM)
Case 1: Coding Agent hoàn thành sớm
Từ bad case đến phân bổ lỗi. Một Coding Agent có thể tuyên bố "xong" trước khi chạy test, đóng một nhiệm vụ đa mục tiêu sau khi chỉ hoàn thành một phần, hoặc tuyên bố nhiệm vụ bất khả thi sau vài lần thất bại. Lỗi đầu tiên là ranh giới quyết định nơi nó chuẩn bị kết luận mà không có bằng chứng; các test thất bại và lần thử lại sau đó là hậu quả. Sự sửa chữa của người dùng, phản hồi tiêu cực và kiểm tra hậu kỳ đều có thể phát hiện loại lỗi này.
Dữ liệu huấn luyện. Một nhiệm vụ kiểm thử hồi quy end-to-end chạy các bài kiểm tra chấp nhận ẩn khi Agent tuyên bố hoàn thành: vượt qua cho phần thưởng dương và thất bại cho phần thưởng âm. Một nhiệm vụ trajectory-prefix chuyển tuyên bố thành sớm thành rejected và "chạy test, kiểm tra mọi điều kiện chấp nhận, sau đó kết luận" thành chosen. Các ứng viên do giáo viên tạo ra được lọc bởi một trình xác minh deterministic, và các loại nhiệm vụ, điều kiện thiếu và cách diễn đạt hoàn thành được thay đổi trước khi trộn một tỷ lệ nhỏ vào dữ liệu hướng dẫn chung cho LoRA.
Đánh giá. Tập ranh giới nhiệm vụ chưa hoàn thành phải được đánh giá cùng với một tập giữ lại gồm các nhiệm vụ thực sự đã hoàn thành. Phần đầu kiểm tra xem mô hình có xác minh thay vì dừng sớm hay không; phần thứ hai kiểm tra xem nó vẫn có thể kết luận bình thường. Nếu không, mô hình có thể trở nên quá thận trọng và không bao giờ dừng.
Thí nghiệm 7-17 ★★: Từ Bad Case "Hoàn Thành Sớm" Đến DPO
Mục tiêu thí nghiệm: Chạy pipeline hoàn chỉnh từ phân bổ lỗi đến dữ liệu kiểm thử hồi quy trajectory-prefix, các cặp ưu tiên DPO, huấn luyện LoRA 7B và đánh giá ranh giới/giữ lại riêng biệt.
Xây dựng dữ liệu: Dự án đi kèm cung cấp 24 trường hợp thực tế bao gồm bốn loại lỗi và một tập held-out không giao nhau (12 trường hợp ranh giới và 8 trường hợp giữ lại). Thí nghiệm có mục đích giáo dục; dữ liệu sản xuất nên bao gồm nhiều nhóm nhiệm vụ hơn và sử dụng các bài kiểm tra ẩn mà mô hình không thể chỉnh sửa hoặc chỉ tuyên bố đã chạy.
Case 2: Dấu ngoặc kép tiếng Trung
Yêu cầu "chuyển đổi dấu ngoặc kép thẳng trong các bài viết tiếng Trung thành dấu ngoặc kép cong" không phải là một quy tắc thay thế toàn cục. Cùng một dấu ngoặc ASCII có vai trò khác nhau trong văn xuôi tiếng Trung, trích dẫn tiếng Anh, Markdown code, khối code, bình luận, JSON và đường dẫn. Văn xuôi tiếng Trung và bình luận tiếng Trung có thể được chuyển đổi; code thực thi, văn bản gốc tiếng Anh, JSON/schema, đường dẫn, định danh và các vùng không rõ ràng phải được giữ nguyên.
Từ bad case đến phân bổ lỗi. Harness nên phân đoạn tài liệu theo phạm vi, so sánh đầu ra mô hình với các vùng cho phép và được bảo vệ, và chạy kiểm tra cú pháp Markdown, JSON và ngôn ngữ nguồn. Nếu kết xuất hoặc tuần tự hóa thay đổi đầu vào trước, vấn đề thuộc về Harness. Nếu mô hình thấy các byte gốc nhưng chỉnh sửa một dấu ngoặc được bảo vệ hoặc bỏ lỡ một dấu ngoặc tiếng Trung được cho phép, sự khác biệt đầu tiên là lỗi chọn phạm vi phù hợp cho post-training.
Dữ liệu huấn luyện. Một Skill định nghĩa các quy tắc phạm vi dương và âm. Các mẫu ghép cặp văn bản nguồn và đích, bao gồm văn xuôi tiếng Trung, dấu ngoặc lồng nhau và bình luận tiếng Trung là các chỉnh sửa dương, và bao gồm văn bản tiếng Anh, literal, JSON, đường dẫn, inline code và khối code là các phần âm được bảo vệ. Tập huấn luyện, tập giữ lại và tập ranh giới được tách theo template, thể loại, tổ hợp biến và ngôn ngữ; cổng máy và kiểm tra thủ công phân tầng chạy trước SFT.
Đánh giá. Báo cáo chuyển đổi dấu ngoặc đích, bảo tồn vùng được bảo vệ, chỉnh sửa ngoài mục tiêu, tính hợp lệ cú pháp và khớp chính xác toàn văn. Một tập giữ lại gồm các tài liệu đã đúng sẵn cần có trong sản xuất để phát hiện chỉnh sửa quá mức.
Thí nghiệm 7-18 ★★: SFT Dấu Ngoặc Kép Cong Nhạy Cảm Phạm Vi
Mục tiêu thí nghiệm: Kiểm tra xem LoRA SFT có dạy mô hình chỉ chuyển đổi các dấu ngoặc được phép và bảo tồn cú pháp được bảo vệ trên các tổ hợp ngữ cảnh chưa thấy.
Thiết lập và dữ liệu: Qwen3-8B bf16 LoRA, hai epoch và 256 lần cập nhật; 16 loại fragment, 10 thể loại bài viết và 9 ngôn ngữ lập trình; 1.024 mẫu huấn luyện, 256 mẫu giữ lại và 256 mẫu ranh giới. Skill được sử dụng như đặc tả gán nhãn, cổng chất lượng và hồi quy, với 48 lần kiểm tra thủ công phân tầng.
Kết quả: Độ chính xác chính xác trên tập giữ lại tăng từ 0% của mô hình cơ sở lên 96,9%, ranh giới chính xác đạt 97,7% và bảo tồn vùng được bảo vệ đạt 100%. Python, JavaScript, Java, Go, Rust, SQL, Shell, YAML và Markdown đạt 100%; JSON vẫn ở mức 68,8% và cần một track dữ liệu có cấu trúc độc lập.
Case 3: Thất bại chỉnh sửa file thường xuyên
Coding Agents thường sử dụng edit_file(path, old_string, new_string). Công cụ khớp old_string chính xác, vì vậy một byte thay đổi—dấu cách, dòng mới, dấu gạch chéo ngược, tổ hợp Unicode hoặc token tần suất thấp—gây ra "old_string not found." Thử lại lặp đi lặp lại là triệu chứng, không nhất thiết là nguyên nhân gốc.
Từ bad case đến phân bổ lỗi. So sánh sự khác biệt đầu tiên dọc theo chuỗi này:
original file bytes → tool return → Harness serialization → model context
→ model token output → decoded string → JSON/tool-call parsing → tool matching
Quy cho các thay đổi trước khi tạo mô hình cho trình đọc file, trình tuần tự hóa hoặc Harness. Kiểm tra tokenizer encode→decode riêng biệt. Chỉ khi mô hình nhận được các byte gốc và đầu ra của nó là điểm phân kỳ đầu tiên, trường hợp mới được phân loại là lỗi sao chép của mô hình và gửi đến post-training.
Dữ liệu huấn luyện. Sử dụng ba nhiệm vụ có thể xác minh: sao chép nguyên văn, chọn mục tiêu được đánh dấu trong số các hard negative tương tự, và đặt mục tiêu chính xác vào trường JSON old_string của công cụ. Ngẫu nhiên hóa độ dài, tổ hợp token và ngữ cảnh, bao gồm dấu cách, dòng mới thực, escape literal, dấu gạch chéo ngược, ký tự tổ hợp Unicode, tiếng Trung và ký tự không chiều rộng. Chia theo seed, độ dài, thành phần token và ngữ cảnh bao bọc.
Đánh giá. Tách các chỉ số byte-chính xác, code-point-chính xác, token-chính xác, vị trí khác biệt đầu tiên và tokenizer round-trip của mô hình khỏi thành công end-to-end của công cụ. Nếu sao chép trực tiếp đúng nhưng edit_file vẫn thất bại, hãy sửa trình tuần tự hóa hoặc giao thức công cụ thay vì huấn luyện mô hình.
Thí nghiệm 7-19 ★★: SFT Sao Chép Chính Xác Cho Chuỗi Đặc Biệt
Mục tiêu thí nghiệm: Sau khi xác nhận rằng đầu ra mô hình là lớp phân kỳ đầu tiên, kiểm tra LoRA SFT trên các chuỗi ngẫu nhiên chưa thấy và sử dụng kiểm tra tokenizer riêng để loại bỏ các artifact phân tích từ.
Thiết lập và dữ liệu: Qwen3-8B bf16 LoRA trong hai epoch; 1.024 mẫu huấn luyện, 256 mẫu giữ lại và 256 mẫu ranh giới trên verbatim, decoy_copy và tool_json. Trình tạo sử dụng các chuỗi ngẫu nhiên có thể tái tạo, hard negative, 10 ngữ cảnh ngôn ngữ, 8 thể loại bài viết và khoảng trắng đặc biệt, escape, Unicode, tiếng Trung và ký tự không chiều rộng.
Kết quả: Độ chính xác byte-chính xác trên tập giữ lại cải thiện từ 37,5% lên 78,9%, ranh giới đạt 80,1% và khác biệt byte đầu tiên trung bình là 54,0 và 54,2. Trên 512 probe, tokenizer round-trip của Qwen3/Qwen2.5 là 80,1% so với 100% của Mistral; lỗi tokenizer và Harness phải được tách biệt khỏi kết quả sao chép mô hình.
Toàn Cảnh Post-Training Hoàn Chỉnh và Mẹo Thực Tiễn
Bắt đầu từ mục tiêu "dự đoán token tiếp theo" của pre-training, chương này đã đi qua một chặng đường dài: SFT có thể học hiệu quả các định dạng và giao thức; trong các so sánh của chương này, RL dựa trên kết quả cải thiện khả năng tổng quát ngoài phân phối; các nhiệm vụ đa lượt giới thiệu vấn đề phân bổ tín dụng; thiết kế phần thưởng mở rộng từ phần thưởng kết quả đến các tín hiệu đường dẫn thưởng kết quả đồng thời ràng buộc quá trình; và sử dụng công cụ mang đến sự bùng nổ tổ hợp. Một sợi chỉ xuyên qua tất cả các thí nghiệm này—mô hình học được gì phụ thuộc vào tín hiệu huấn luyện dạy gì, và chất lượng của tín hiệu đó được xác định chủ yếu bởi dữ liệu và môi trường, không phải thuật toán.
Paradigm cộng hưởng: Tóm tắt GeneralPoints trước đó đã sử dụng nguyên lý hội họa Trung Quốc "hình trước, thần sau" để mô tả cấu hình này. Khi đầu ra có cấu trúc chưa ổn định, SFT có thể trước tiên thiết lập định dạng và khả năng cơ bản; sau đó RL có thể khám phá chiến lược khi có phần thưởng đáng tin cậy và môi trường. Trong các thí nghiệm này, SFT ổn định các giao thức và cấu trúc (định dạng JSON, template hội thoại, giao diện công cụ), trong khi RL cải thiện hiệu suất ngoài phân phối trên các quy tắc số học, lý luận không gian và chuỗi hành động. Dữ liệu và mô hình khác có thể tạo ra kết quả khác, và tối ưu hóa quá mức SFT hoặc RL đều có thể overfit phân phối hiện tại.
Những cạm bẫy thường gặp sau đây đáng lưu ý; nhận biết những vấn đề này thường có giá trị hơn trong việc tránh lãng phí tài nguyên so với nắm vững chi tiết kỹ thuật:
Dựa quá nhiều vào post-training để ghi nhớ sự kiện—Sử dụng RAG để quản lý kiến thức sự kiện vì nó có thể được cập nhật động, nguồn có thể được truy vết và nội dung không bị mất qua huấn luyện. Post-training nên tập trung vào "cách sử dụng kiến thức."
Gi thiệu RL trước khi định dạng ổn định—Nếu mô hình không thể tạo ra đáng tin cậy JSON cần thiết để tính toán phần thưởng, tín hiệu huấn luyện trở nên thưa hoặc méo. Tỷ lệ phân tích lỗi chấp nhận được phụ thuộc vào nhiệm vụ và thiết kế phần thưởng, vì vậy không nên áp dụng một ngưỡng cố định cho tất cả. Đặt một cổng ổn định định dạng với một đánh giá nhỏ trước, sau đó sử dụng SFT hoặc giải mã có ràng buộc nếu cần trước khi áp dụng RL.
Hàm phần thưởng thiết kế kém dẫn đến reward hacking—Mô hình học cách khai thác lỗ hổng trong phần thưởng để đạt điểm cao mà không thực sự hoàn thành nhiệm vụ (ví dụ: nếu phần thưởng chỉ xem xét độ dài phản hồi, mô hình tạo văn bản dài vô nghĩa). Đánh giá mục tiêu cuối cùng, không phải các chỉ số trung gian.
Bỏ qua độ trung thực của mô phỏng—Nếu mô phỏng quá đơn giản (dịch vụ khách hàng luôn phản hồi theo mẫu cố định) hoặc phản hồi của môi trường không thực tế (thông báo lỗi khác với môi trường sản xuất), chính sách được huấn luyện sẽ hoàn toàn thất bại trong kịch bản thực tế. Chi phí xây dựng môi trường mô phỏng có độ trung thực cao có thể vượt quá chi phí huấn luyện.
Huấn luyện quá mức dẫn đến giảm khả năng tổng quát—Khi mất mát huấn luyện tiếp tục giảm nhưng hiệu suất tập validation xấu đi, mô hình đang ghi nhớ chi tiết huấn luyện. SFT đặc biệt dễ gặp vấn đề này; dừng sớm vẫn rất quan trọng. Tối ưu hóa quá mức trong RL cũng có thể dẫn đến overfitting chính sách cho phân phối nhiệm vụ hiện tại.
Sụp đổ hàm giá trị và khám phá không đủ—Ước tính giá trị không chính xác trong PPO có thể thiên lệch tính toán lợi thế, biểu hiện dưới dạng dao động nghiêm trọng trong đường cong huấn luyện. Nhiệt độ quá thấp hoặc tính ngẫu nhiên không đủ có thể khiến Agent mắc kẹt trong cực trị cục bộ.
Đánh giá thấp chi phí tính toán của RL—Các nhiệm vụ hoạt động tốt với SFT có thể yêu cầu 10-100 lần thời gian huấn luyện khi chuyển sang RL. Nếu phân phối kiểm tra nhất quán cao với phân phối huấn luyện, SFT có thể là đủ.
Dữ liệu huấn luyện chất lượng thấp—SFT sẽ trực tiếp học nhiễu và thiên lệch trong dữ liệu, cố định lỗi vào tham số. Mặc dù RL có thể khám phá chiến lược tốt hơn thông qua khám phá, nhưng nếu mô hình phần thưởng có thiên lệch có hệ thống, nó sẽ tối ưu hóa sai hướng.
Nguyên tắc cốt lõi: Trước khi cam kết tài nguyên quy mô lớn, hãy xác nhận các giả định chính với các thí nghiệm quy mô nhỏ—kiểm tra xem SFT có thể ổn định định dạng trên tập dữ liệu nhỏ hay không, RL có thể hội tụ trong môi trường đơn giản hóa hay không, và hàm phần thưởng có phản ánh mục tiêu thực sự trên mẫu nhỏ hay không. Thà thất bại nhanh còn hơn thất bại ở quy mô lớn.
Cộng hưởng với RAG/ICL: Các phương pháp này không loại trừ lẫn nhau; chúng hoạt động ở các vị trí khác nhau. ICL sử dụng các ví dụ, quy tắc và trạng thái hiện tại để cung cấp thích ứng tức thì mà không thay đổi tham số, nhưng độ trễ và chi phí tăng lên khi ngữ cảnh lớn. RAG đặt sự kiện và bằng chứng vào kiến thức bên ngoài có thể cập nhật động, có thể truy vết. Post-training ghi nhận thức cao chiều, phong cách sinh và các chính sách quyết định ẩn vào tham số. Lựa chọn không chỉ phụ thuộc vào nhiệm vụ có ổn định theo thời gian hay không, mà quan trọng hơn, vào khả năng có thể được biểu đạt đầy đủ qua các ký hiệu bên ngoài. Các khả năng như nhận dạng hình ảnh y khoa và giọng điệu tự nhiên thường yêu cầu cập nhật tham số ngay cả trong các lĩnh vực liên tục thay đổi. Ngược lại, một quy tắc phê duyệt chuyển khoản ổn định lâu dài nên vẫn được bảo vệ deterministic bằng code thay vì chỉ dựa vào trí nhớ mô hình.
Các hệ thống mạnh mẽ thường kết hợp các phương pháp này: sử dụng RAG để quản lý sự kiện và bằng chứng, ICL để thử nghiệm nhanh các chiến lược có thể biểu đạt bằng ngôn ngữ, chương trình để cố định các quy trình deterministic và ràng buộc cứng, và post-training để ghi vào tham số các khả năng khó biểu đạt rõ ràng và yêu cầu tổng quát rộng. Post-training cũng có thể thực hiện chưng cất mô hình, chuyển các khả năng của mô hình lớn có năng lực hơn sang mô hình nhỏ hơn, chi phí thấp hơn.
Tóm Tắt Chương
Bản chất của post-training mô hình là ghi các chiến lược tương tác vào tham số.
SFT và RL không phải là các phương pháp cạnh tranh thay thế mà thường được kết hợp theo thứ tự. Khi đầu ra có cấu trúc chưa ổn định, SFT có thể trước tiên ổn định định dạng để tín hiệu phần thưởng RL có thể được tính toán đáng tin cậy; sau đó RL có thể khám phá chiến lược và cải thiện hiệu suất ngoài phân phối. "SFT ghi nhớ, RL tổng quát hóa" tóm tắt một xu hướng được quan sát trong các thí nghiệm có kiểm soát của chương này, không phải một quy luật luôn đúng bất kể dữ liệu, mô hình, phần thưởng và môi trường.
Hai phán đoán xuyên suốt chương này và đáng nhớ hơn bất kỳ thuật toán nào. Đầu tiên, dữ liệu và môi trường quan trọng hơn thuật toán: chỉ cần biết cách sử dụng các thuật toán RL có sẵn; điều thực sự phân biệt các nhóm là độ trung thực của môi trường mô phỏng và chất lượng dữ liệu huấn luyện. Khi không thể xây dựng môi trường thực, sử dụng mô hình để mô phỏng môi trường (tổng hợp giá trị trả về của công cụ, mô phỏng động lực môi trường) cũng là một lộ trình khả thi—nhưng hãy nhớ rằng thiên lệch của trình mô phỏng là trần của huấn luyện. Không chỉ câu trả lời có thể được lọc; phân phối nhiệm vụ của dữ liệu huấn luyện bản thân nó có thể trở thành mục tiêu tối ưu hóa. Trong nhiều kịch bản, nếu dữ liệu SFT có chất lượng đủ cao, RL có thể không cần thiết. Thứ hai, nút thắt chính của RL ngày nay là hiệu quả mẫu: hai hướng hiện có vẻ hứa hẹn nhất là On-Policy Distillation, làm dày tín hiệu tại mỗi bước, và hình phạt đường dẫn được xác minh RLVP, chuyển phản hồi môi trường bị lãng phí thành tín hiệu có thể học được ("thưởng kết quả, phạt đường dẫn," với tín dụng một phần cho tiến bộ có thể đạt được để cứu các mẫu trong nhóm toàn thất bại). Điều chúng chia sẻ vẫn là cùng một ý tưởng—lấy thông tin đã tồn tại trong môi trường và dữ liệu, nhưng mà phần thưởng kết quả thuần túy lãng phí, và biến nó thành thứ mô hình có thể học. Khi không có giáo viên mạnh hơn, dòng suy nghĩ này cũng có một biến thể tự chưng cất: OPSD để cùng một mô hình giám sát chính nó trong hai vai—"giáo viên đọc đáp án" và "học sinh chỉ thấy bài toán"—mang đến tín hiệu dày token-đến-token cho các nhiệm vụ mà phần thưởng không thể xác minh.
Chương này trả lời câu hỏi làm thế nào cập nhật tham số có thể cho phép tiến hóa Agent liên tục. Trong chương tiếp theo, chúng ta sẽ thấy rằng tham số chỉ là một trong bốn vật mang của tự tiến hóa Agent: kiến thức, hướng dẫn, chương trình và tham số.
Chương này đã trả lời câu hỏi cập nhật tham số "làm thế nào để huấn luyện." Chương tiếp theo đặt tham số mô hình trở lại trong hệ thống Agent hoàn chỉnh: tham số chỉ là một trong bốn vật mang cập nhật, cùng với kiến thức, hướng dẫn và chương trình. Thách thức đặc trưng của chúng là làm thế nào để rút ra tín hiệu học tập đáng tin cậy từ các trajectory triển khai, chọn đúng vị trí cập nhật, và quản trị xác nhận, phát hành và rollback của mỗi phiên bản ứng viên. Đối với các thuật toán huấn luyện cụ thể, Chương 8 tham chiếu trực tiếp đến chương này thay vì lặp lại nội dung.
Câu Hỏi Tư Duy
★★ Quên thảm khốc—nơi fine-tuning cho một nhiệm vụ cụ thể phá hủy khả năng chung ban đầu của mô hình, như gọi công cụ chung—đặc biệt phiền toái trong kịch bản Agent. So với fine-tuning toàn bộ tham số, LoRA đóng băng trọng số cơ sở và mang rủi ro quên thấp hơn, nhưng không miễn nhiễm. Những chiến lược nào có thể giảm thiểu thêm việc quên khả năng trong quá trình fine-tuning?
★★ Post-training cố định khả năng vào trọng số mô hình, hay "trí nhớ cơ bắp," trong khi in-context learning đặt kiến thức vào đầu vào tại thời điểm suy luận. Một số khả năng, như kiến thức lĩnh vực, có thể học qua post-training hoặc cung cấp qua few-shot examples. Tiêu chí nào bạn sẽ sử dụng để quyết định khả năng nên đi theo con đường nào?
★★ Chưng cất mô hình cho phép mô hình nhỏ học hành vi của mô hình lớn. Theo cấp độ khả năng, các mô hình được chưng cất có thể được chia thành ba tầng roughly—mô hình Chat (hội thoại đơn lượt và trả lời trực tiếp), mô hình Reasoning (chuỗi suy nghĩ dài trước khi trả lời) và mô hình Agentic (gọi công cụ đa lượt và tương tác với môi trường). Những thách thức khác nhau nào phát sinh trong việc chưng cất mỗi loại? (Gợi ý: Bắt đầu với "chính xác cái gì đang được chưng cất"—phong cách đầu ra, trajectory suy luận hoàn chỉnh, hay chính sách tương tác với môi trường; token nào trong trajectory nên học và phản hồi môi trường nào không nên; và tín hiệu thành công/thất bại bị trễ và thưa đến mức nào.)
★★★ Trong các tương tác Agent đa lượt, vấn đề phân bổ tín dụng nghiêm trọng hơn so với kịch bản đơn lượt—một thành công hoặc thất bại cuối cùng khó quy cho một quyết định được đưa ra ở lượt 3 thay vì lượt 7. Bạn sẽ thiết kế một chiến lược phân bổ phần thưởng như thế nào?
★★★ Nếu bạn có một ngân sách cố định, chẳng hạn $10.000, để cải thiện một Agent dịch vụ khách hàng, bạn sẽ phân bổ nó giữa ngữ cảnh và kiến thức, Prompt/Skills, ràng buộc chương trình và huấn luyện tham số như thế nào? Những yếu tố nào sẽ quyết định lựa chọn của bạn?
★★★ Học mô hình tự trị dưới mẫu khan hiếm và không có hàm phần thưởng rõ ràng được coi là mục tiêu cuối cùng của post-training bởi một số người. Các phương pháp huấn luyện RL hiện tại cách mục tiêu này bao xa? Đột phá tiếp theo có nhiều khả năng đến từ đâu?
★★ Chương này lưu ý rằng fine-tuning LoRA không đắt đỏ. Do đó một LoRA chuyên dụng có thể được huấn luyện cho mỗi người dùng hoặc công ty khách hàng, ghi nhớ người dùng hoặc kiến thức doanh nghiệp vào tham số thay vì lưu trữ trong cơ sở kiến thức bên ngoài như trong Chương 3? Khi nào "ghi nhớ vào tham số" có lợi thế so với "lưu trữ trong cơ sở kiến thức," và khi nào nó sẽ phản tác dụng?
★★★ On-Policy Distillation dựa vào mô hình giáo viên mạnh hơn để giám sát học sinh. Tuy nhiên, nghiên cứu Weak-to-Strong Generalization của OpenAI đã đưa ra một phát hiện phản trực giác: giám sát từ mô hình yếu đôi khi có thể mở khóa khả năng tiềm ẩn nhưng không hoạt động trong mô hình mạnh hơn. Nếu áp dụng cho huấn luyện Agent, điều này có thể cho phép chưng cất ngược trong đó "mô hình nhỏ dạy mô hình lớn"?
★★ Mô hình Phần Thưởng Quá Trình (PRM) đánh giá mỗi bước suy luận, trong khi Mô hình Phần Thưởng Kết Quả (ORM) chỉ xem xét kết quả cuối cùng. Cái nào xứng đáng được thưởng nhiều hơn: "một quá trình đúng dẫn đến kết quả sai," hay "một quá trình sai tình cờ tạo ra kết quả đúng"? Bạn sẽ cân bằng hai điều này trong kịch bản gọi công cụ Agent đa bước như thế nào?
★★★ Các tập dữ liệu đánh giá được thảo luận trong chương này, như SWE-Bench Verified, τ²-bench và AndroidWorld, có thể được sử dụng cho cả đánh giá và post-training. Nhưng khi một tập đánh giá được sử dụng cho huấn luyện, nó không còn độc lập. Điều này có vi phạm nguyên tắc cơ bản rằng tập huấn luyện và tập kiểm tra phải được tách biệt? Tạo tham số động trong τ²-bench và template tham số hóa trong AndroidWorld giảm thiểu vấn đề ở một mức độ nào đó, nhưng cấu trúc template của chúng vẫn cố định. Làm thế nào để khai thác đầy đủ giá trị huấn luyện của dữ liệu đánh giá trong khi bảo tồn tính độc lập của đánh giá?
★★★ Chương này đề xuất một paradigm huấn luyện "hình trước, thần sau": dừng SFT khi "định dạng ổn định và khả năng cơ bản đã có," sau đó chuyển sang RL. Trong thực tế, làm thế nào để xác định khi nào SFT là "đủ" và đã đến lúc chuyển đổi?
★★★ Động lực huấn luyện của ReTool cho thấy (xem Thí nghiệm 7-15) rằng một vài phản hồi cực dài có thể kéo dài đáng kể toàn bộ chu kỳ huấn luyện—hầu hết các rollout trong một batch đã được tạo xong, nhưng hệ thống phải đợi các phản hồi dài nhất hoàn thành, để lại利用率 GPU cụm thấp. Làm thế nào để cải thiện利用率 tài nguyên trong cụm huấn luyện dưới điều kiện phản hồi đuôi dài?
★★★ Khi huấn luyện Agent chống lại các môi trường mô phỏng bởi LLM—như công cụ tìm kiếm mô phỏng hoặc người dùng mô phỏng—mục tiêu khai thác của Agent chuyển từ "các quy tắc của môi trường thực" sang "thiên lệch và lỗ hổng của chính trình mô phỏng." Những hành vi reward hacking cụ thể nào có thể phát sinh trong loại huấn luyện này, và chúng nên được ngăn chặn như thế nào?